

Computer Network
Computer Network_Learn
一、概述
1.因特网概述
网络、互联网、因特网的区别和关系
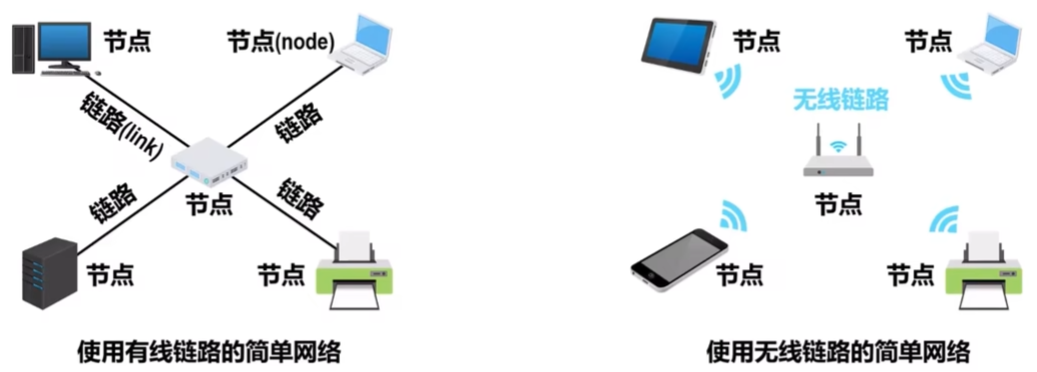
网络
多个设备(结点)互联形成网络
互联网
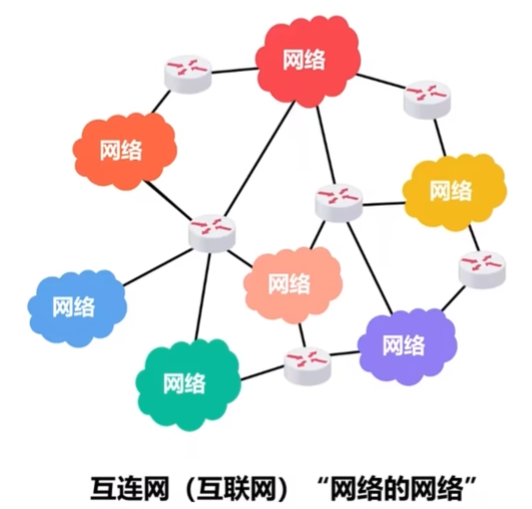
将多个网络通过路由器连接起来称为互联网
因特网
当今世界上最大的互联网
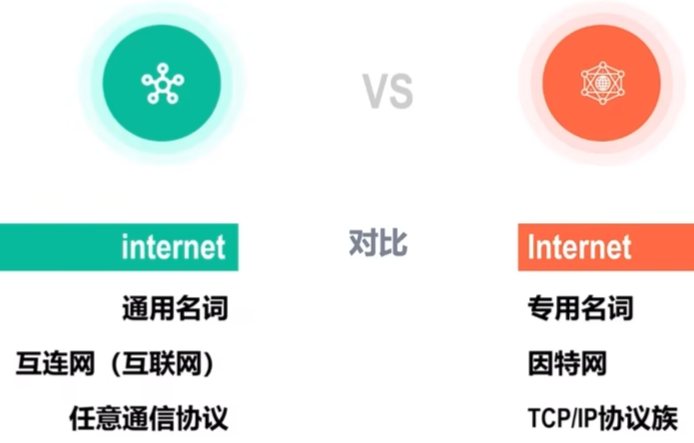
日常生活中并无特地区分因特网和互联网,但二者并不相同,见上图,最为核心的区别在于其中的通信协议
因特网简介
因特网发展的三个阶段
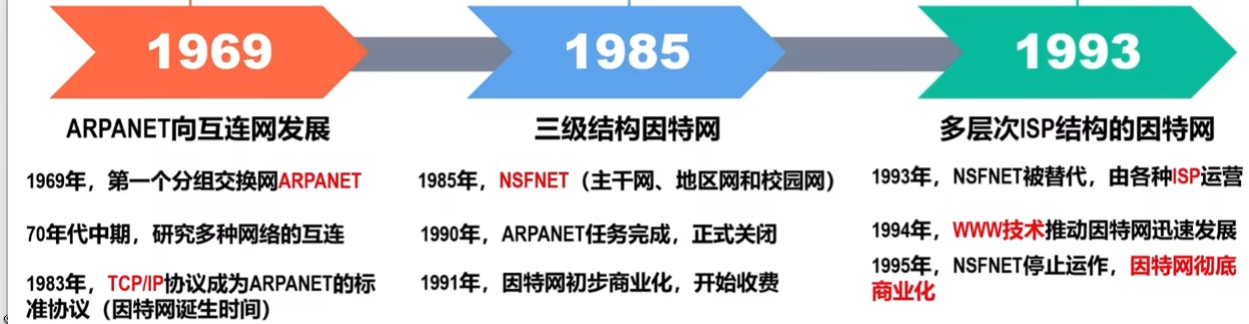
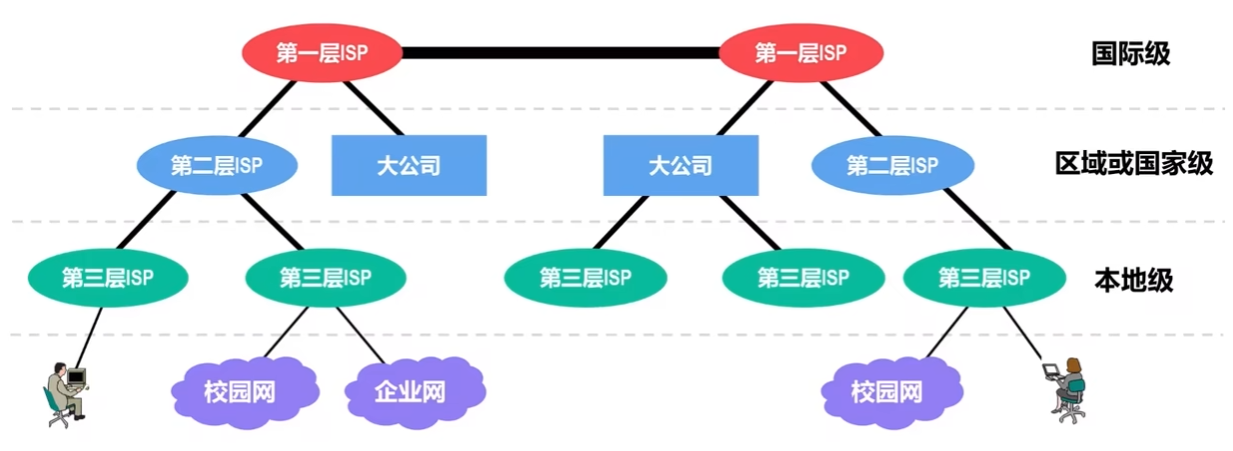
因特网服务提供者(Internet Service Provider ISP)
普通用户需要通过ISP访问互联网,我国的ISP主要有移动、电信、联通 等
因特网已经发展成为基于ISP的多层次结构的互联网络
因特网标准化工作
公众可以对RFC(Request For Comments)文档发表意见和建议
因特网组成
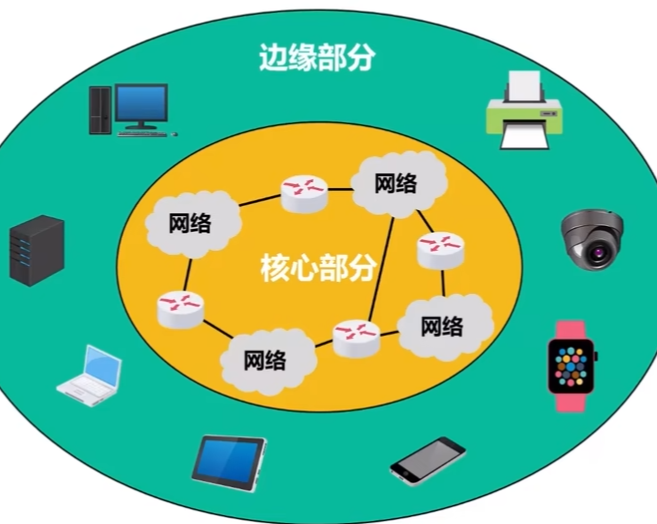
核心部分中的路由器(一种专用计算机)转发收到的分组,为边缘部分提供连通性和数据交换等服务
2.数据交换的三种方式
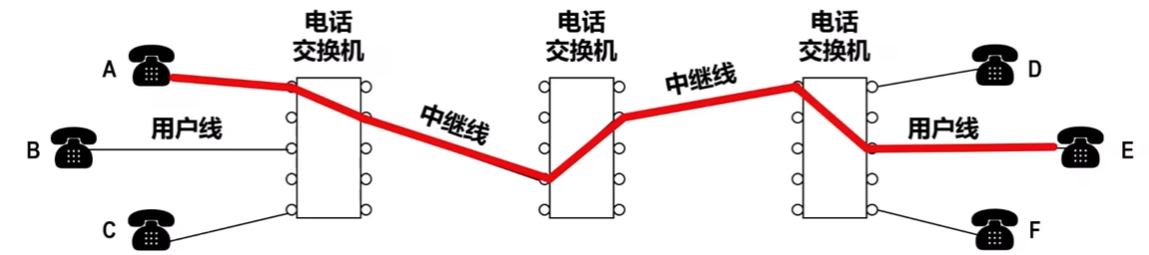
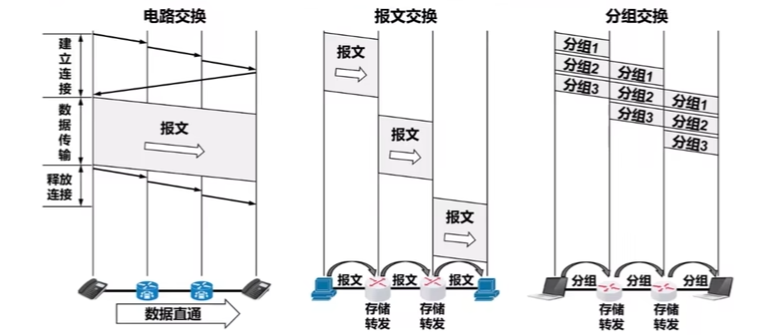
电路交换
电路交换:拨号电话的通信方式
- 示意图
- 过程
- 建立连接 (分配通信资源)
- 通信 (占用通信资源)
- 释放连接 (归还通信资源)
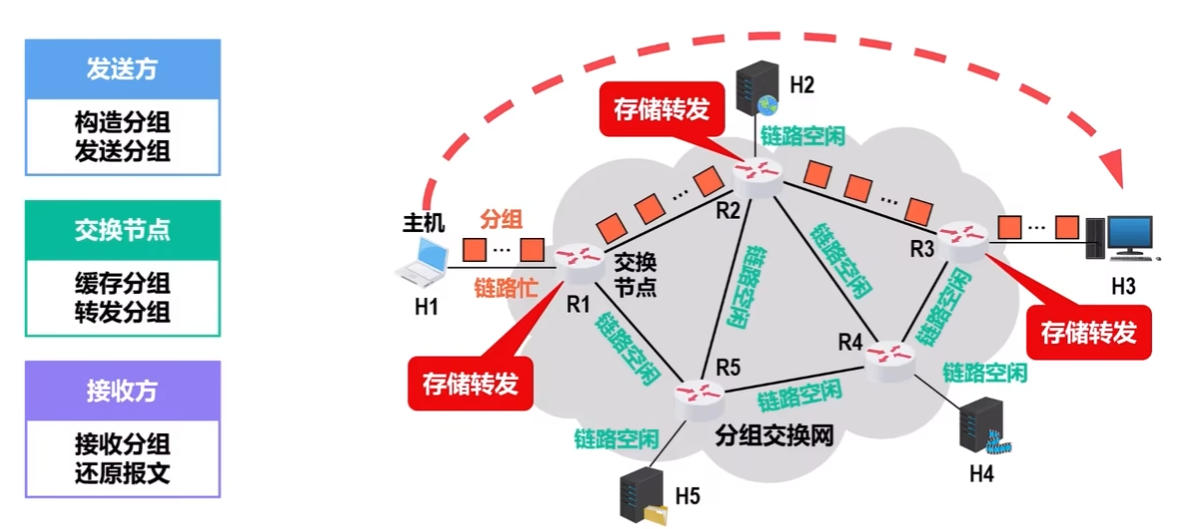
:star<分组交换>
分组交换:当前计算机通信的方式
- 示意图
- :star<过程>
- 由于报文信息过长,可能会引起缓存溢出的问题,所以发送前发送方要对报文数据进行预处理,即:将数据切割成等长小段,并对每一段加上一个首部(首部存储了一些额外信息 如:发送目的地)
–>
- 预处理(分组)完后,主机将数据发给路由器,路由器将数据存储于缓存中,并解析首部查转发表找到发送的目的主机
- 找到转发主机后就如此循环不断的存储转发数据(上图:R1–>R2–>R3) 直到目的主机收到数据
- 目的主机收到数据后再将首部拆除,重新将分组数据拼接为原先的报文
- 优缺点
- 优点
- 没有建立连接和释放连接的过程。
- 分组传输过程中逐段占用通信链路,有较高的通信线路利用率。
- 交换节点可以为每一个分组独立选择转发路由,使得网络有很好的生存性。
- 缺点
- 分组首部带来了额外的传输开销。
- 交换节点存储转发分组会造成一定的时延。
- 无法确保通信时端到端通信资源全部可用,在通信量较大时可能造成网络拥塞。
报文交换
分组交换的前身,不同于分组交换,报文不被拆分,而是被完整地传送。即:交换结点(路由器)需要完整接收报文才能查表转发,这需要较高的缓存空间和较高的时延
三者对比
- 示意图
- 解析
- 若要连续传送大量的数据,并且数据传送时间远大于建立连接的时间,则使用电路交换可以有较高的传输效率。然而计算机的数据传送往往是突发式的,采用电路交换时通信线路的利用率会很低。
- 报文交换和分组交换都不需要建立连接(即预先分配通信资源),在传送计算机的突发数据时可以提高通信线路的利用率。
- 将报文构造成若干个更小的分组进行分组交换,比将整个报文进行报文交换的时延要小,并且还可以避免太长的报文长时间占用链路,有利于差错控制,同时具有更好的灵活性。
3.计算机网络分类
此处只对范围覆盖、拓扑结构进行分类
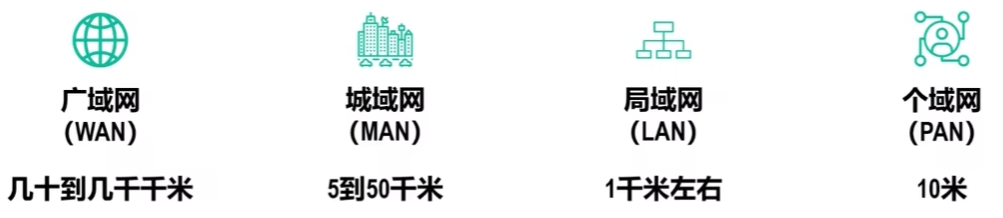
覆盖范围分类
广域网
通常为一个国家的主干网络
城域网
通常作为一个城市的主干网络
局域网
通常为一栋寝室、一个校园 (tip:当前校园、企业一般将多个局域网互连起来)
个域网
蓝牙、热点、WIFI等 常称为无线个域网
拓扑结构分类
总线型
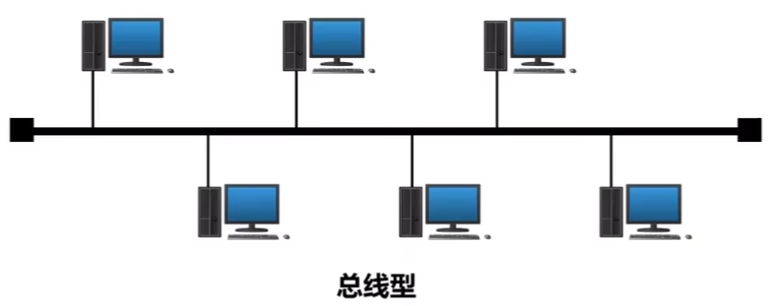
方便搭建,但高负载时传输效率不高且一处坏处处坏
星型
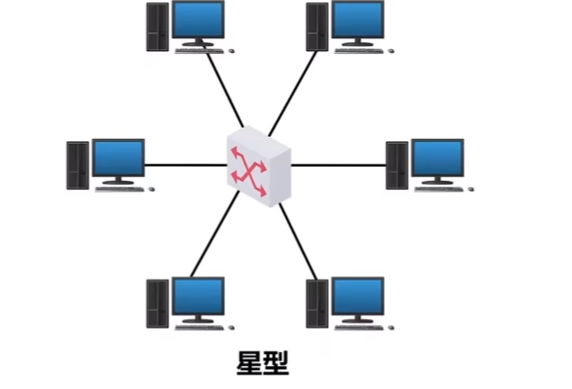
便于网络的集中控制管理,但成本高,中央设备对故障敏感
环型
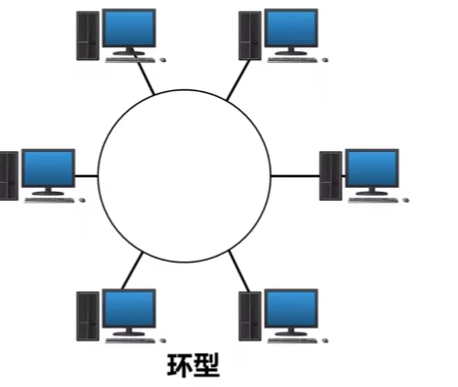
网状型
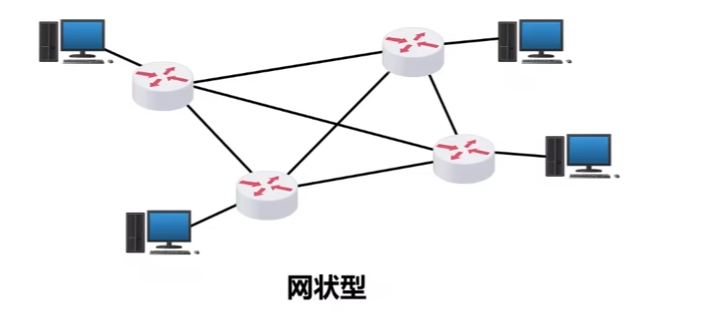
可靠性高,控制复杂,成本高
4.计算机网络的八个性能指标
速率
连接在计算机网络上的主机在数字信道上传送比特的速率,也称为比特率或数据率
常见数据率单位
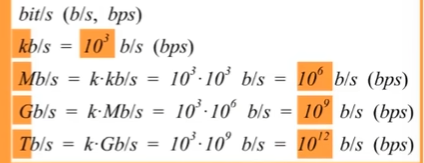
注意:与存储单位不同,数据传输速率以1000为进制,而非1024
此图为数据存储单位,以1024计
补充
上述差距就可以说明,带宽为500Mb/s的宽带在Steam下载时,若切换为MB/s的话为大约可以达到59.60MB/s (500*10^6^ /8 /2^20^ ) 先除以8将bit换算为Byte,再除以2^20^(即1024 * 1024) 换算为M (Mb/s和MB/s的M不同 详见上方) ,为了简单起见 两个M相差很小可以视为相同,则结果也可以约为 62.5MB/s
带宽
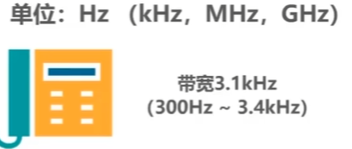
带宽在模拟信号系统中的意义
信号所包含的不同频率成分所占据的频率范围
带宽在计算机网络中的意义
用来表示网络的通信线路能传送数据的能力,为单位时间内网络中两点能通过的最高数据量
吞吐量
- 吞吐量表示单位时间内通过某个网络(信道、接口)的数据量,与带宽不同的是:带宽是最高数据量是理想情况下的,而吞吐量是现实情况下的 通常1Gb/s的带宽的吞吐量只有700Mb/s
:star<时延>
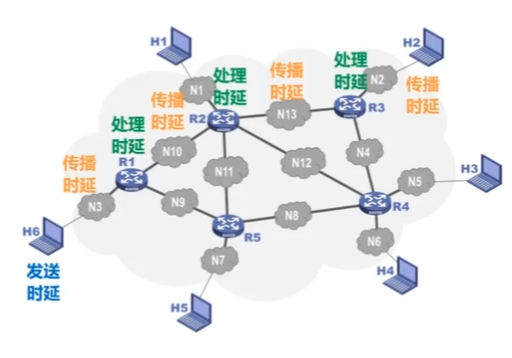
时延分为发送时延、传播时延、处理时延
发送时延
即主机将分组数据发送给第一个路由器产生的时延
计算公式
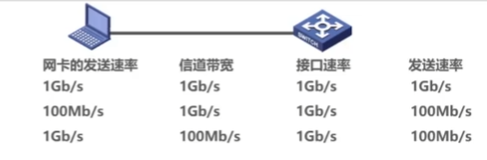
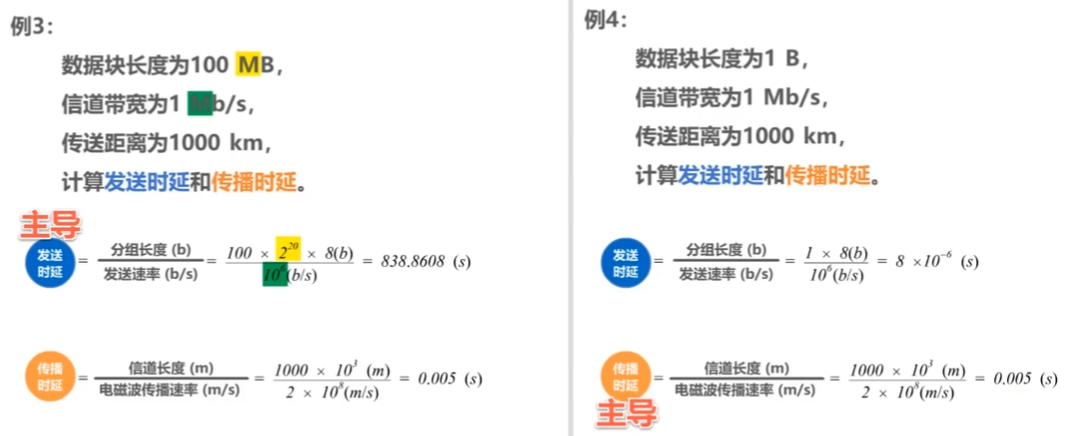
发送时延=分组长度(b)/发送速率(b/s)
tip:其中发送速率受 网卡发送速率、信道带宽、接口速率 三个因素共同影响。遵从短板效应
传播时延
即传播过程中产生的时延
计算公式
传播时延=信道长度(m)/电磁波传播速率(m/s)
tip:不同的传播介质当中的电磁波速率不同
处理时延
即路由器存储转发过程中产生的时延,处理时延一般不方便计算,所以一般会忽略
在处理时延忽略时,传播时延和发送时延谁占主导不一定,需计算
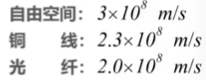
:star2<时延习题>
原理
- 示意图
tip:上图忽略了处理时延
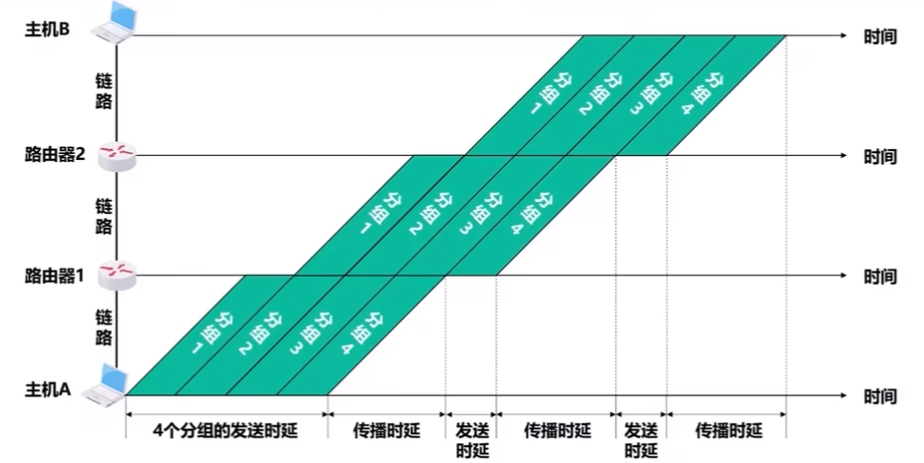
可见,主机A通过n个路由转发m个分组所需时间为 **:star:(m+n)发送时延+(n+1) 传播时延:star:
:star2::star2::传播时延只和结点数量有关!!!
:star2::star2<原因>:分组发送过程中,当某组数据在传播时其他数据正在被发送,发送时延覆盖了传播时延,只有在离开某个结点去往另一个节点时才会有一个传播时延,所以传播时延的个数又可以看作传播过程中的总结点数-1 , 例如:不通过路由传播,两个电脑之间直接互传时 传播时延个数=2-1=1
习题1
注意:题目忽略传播时延
路由个数:2 (选最短路径) 分组个数:980000/(1000-20)=1000
发送时延:(1000+2)* (1000B/100Mbps)= 1002 * 1000 * 8 * 10^-8^=80.16ms
注意:
- 分组大小为1000B,意为分组后加上分组头后的大小为1000B,那么去除分组头的大小就为980B,要求分组个数需要的是去掉分组头后的大小
- 1000B/100Mbps 要注意单位转换 (8bit=1Byte,1M=10^6^)
习题2
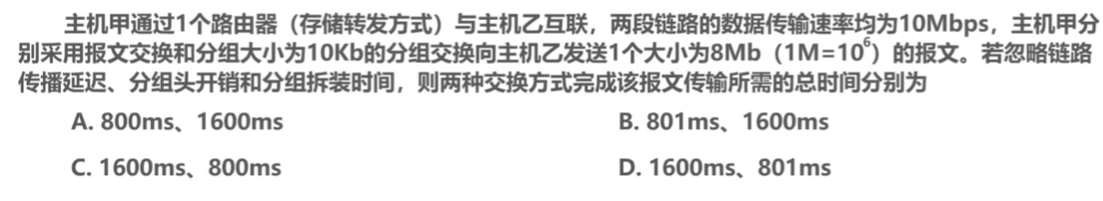
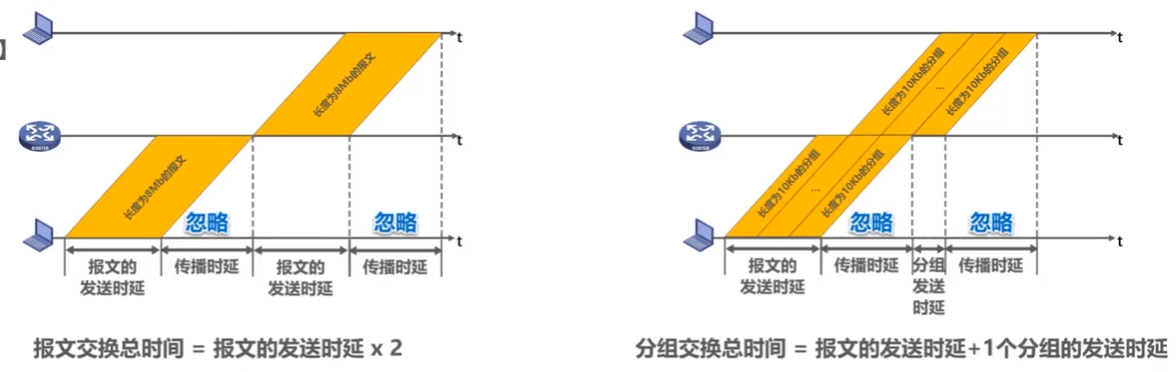
报文传输:2*(8Mb/10Mbps)= 1.6s = 1600ms
分组传输:数据被分为了 8Mb/10Kb=800 份 ,传输一份的时间为:800ms/800=1ms
总时延=800ms+1ms =801ms
两种传输方式的对比
分组传输在第一次发送时要把全部数据发出去,所以所需时间即为800ms ,而在第一部分传输的同时,第二部分链路就已经开始传输,当第一部分传输结束后 第二部分就只有一个分组没传输 所+1ms
而报文传输无法做到在第一部分链路传输过程中同步传输第二部分链路,需要等待整体传输完毕才可以传输第二部分链路,所以耗时约等于分组传输的两倍
示意图
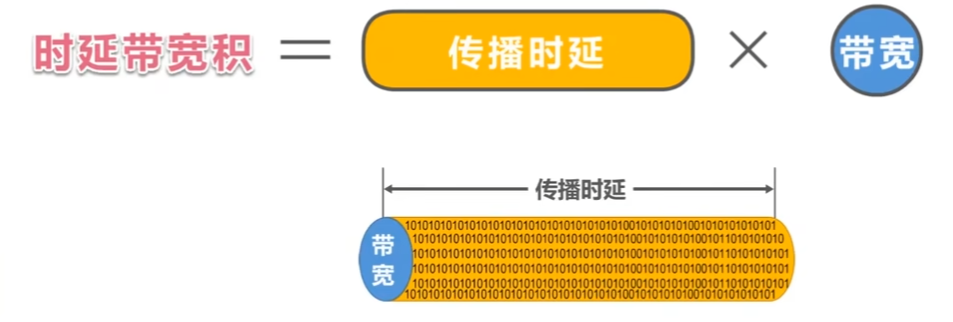
时延带宽积
即传播时延和带宽的乘积 可以用来表示传输管道的传输体量
- 性质
- 若发送端连续发送数据,则在所发送的第一个比特即将到达终点时,发送端就已经发送了时延带宽积个比特
- 链路的时延带宽积又称为以比特为单位的链路长度。
往返时间
由于因特网上的信息通常都是双向交互的,所以往返时间RTT(Round-Trip-Time )也是一个重要指标
通常往返时延由卫星链路的时延为主导(距离过远)
:star<利用率>
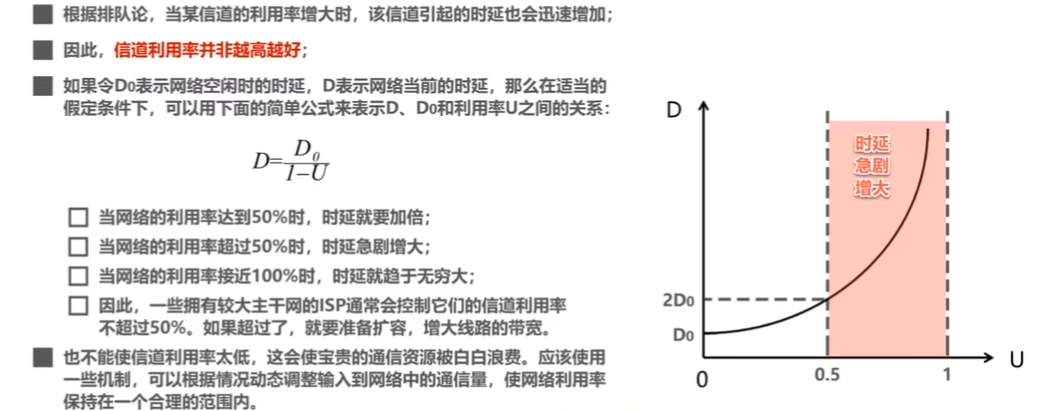
信道利用率
某信道有百分之几的时间是被利用的
网络利用率
全网络的信道利用率的加权平均
可以简单理解为:当信道利用率过大时,即大多数时间都在被占用时,例如100%利用率,这样子想要传输数据就会一直在排队,无法传输,时延无穷大
丢包率
即分组丢失率,指的是一定时间内,传输过程中丢失的分组数量和总分组数量的比率
丢包率的分类
按照观测维度,可细分为:
- 接口丢包率
- 结点丢包率
- 链路丢包率
- 路径丢包率
- 网络整体丢包率
运维人员会重点关注该指标,普通用户通常难以直接感知轻微丢包的存在。
造成丢包率的原因
传输误码
分组在链路传输中产生比特错误,被中间网络结点直接丢弃。
网络拥塞
分组到达缓存队列已满的分组交换机 / 路由器,因没有存储空间被强制丢弃;通信流量峰值大时极易触发全网拥塞。
综上,丢包率可以用来反应网络拥塞程度
拥塞等级 路径丢包率区间 无拥塞 0% 轻度拥塞 1% ~ 4% 严重拥塞 5% ~ 15%
5.:star<计算机网络体系结构>
常见的计算机网络体系结构
OSI体系结构(失败)
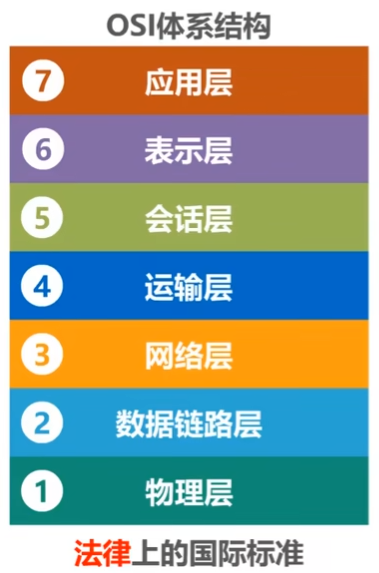
协议过分复杂、运行效率低、层次划分不合理
TCP/IP体系结构(成功)
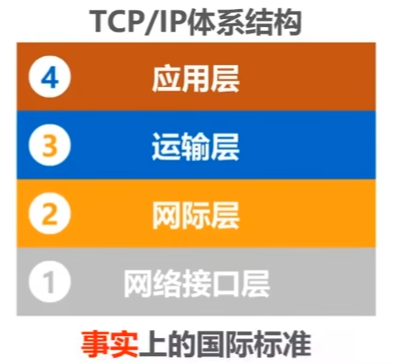
由上两图可知,TCP/IP体系结构相当于将OSI的物理层和数据链路层合并为了网络接口层,并去掉了会话层与表示层 且由于TCP/IP使用的是IP协议(网际协议) 所以网络层一般称为网际层
:star
/IP具体运行示意图 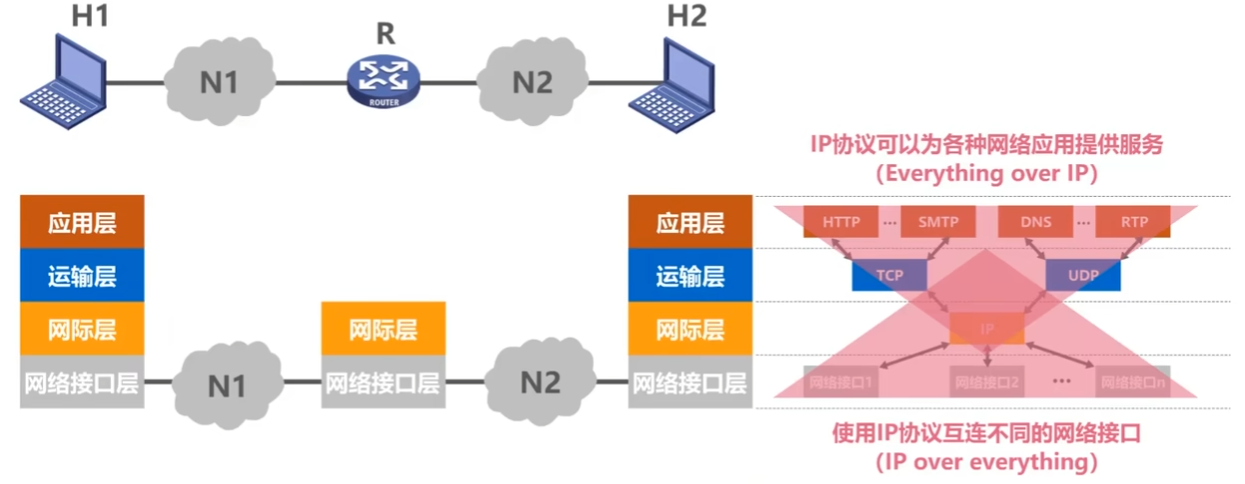
- :star
- TCP/IP协议中的网络接口层并没有规定具体内容,是为了让不同的接口(有线/无线等)都可以接入
- IP起到的核心作用,在互连不同网络接口的同时向各种应用提供服务
- 运输层涉及两种传输协议,即:TCP(可靠、速度慢) UDP(不可靠、速度快),其中TCP作用较为核心 所以该体系结构中有TCP
补充说明
由于TCP/IP协议的网络接口层是无具体约束内容的,不利于我们学习,所以学习的理论模型为下图
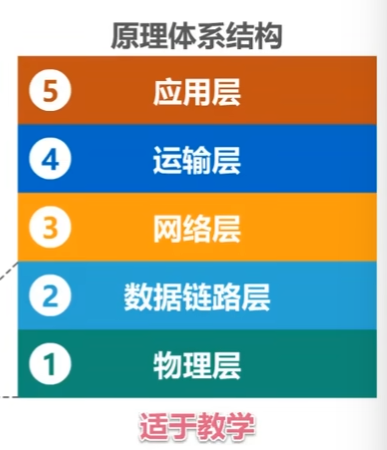
计算机网络分层的必要性
计算机网络过于庞大,分层利于层层处理问题
物理层所解决的问题
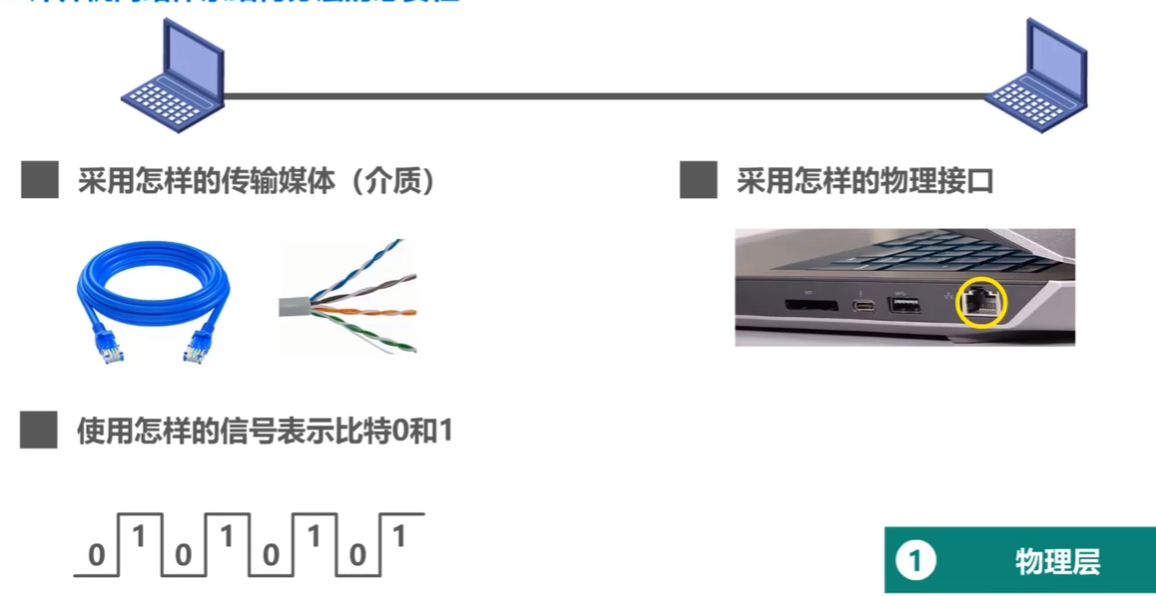
tip:实际传输0/1并不是方波信号,图示是为了易理解
数据链路层所解决的问题
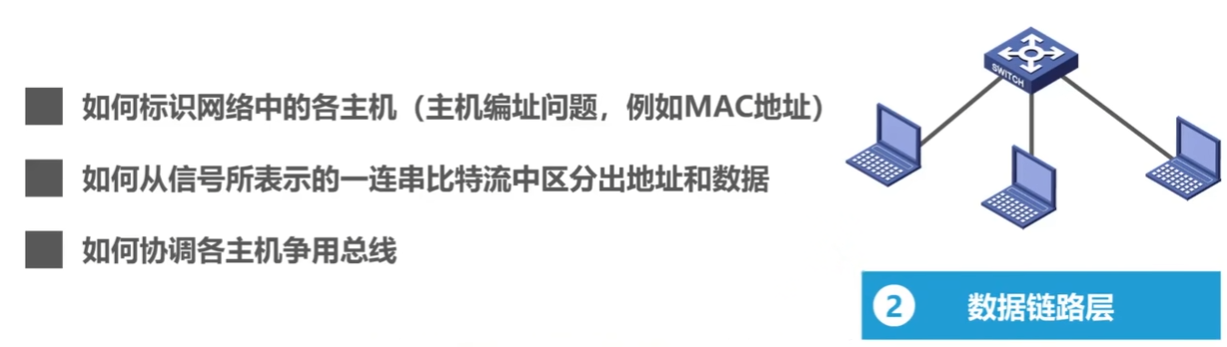
例子:
每台电脑的网卡都有全世界独一份的MAC 物理身份证(比如
00-1A-2B-3C-4D-5E)。发消息时靠 MAC 精准找到目标电脑,不会发错人。网线里只有一串 01 比特乱流。
数据链路层提前规定好帧格式:开头固定位置放收发双方 MAC(地址),中间放聊天 / 文件内容(真正数据),结尾加校验码。
使得接收的设备可以区分出地址和数据
对于总线型的拓扑连接结构,只有一条主线,会发生数据碰撞的情况,这时就需要用一些协议约束,以防止数据碰撞的产生
网络层所解决的问题
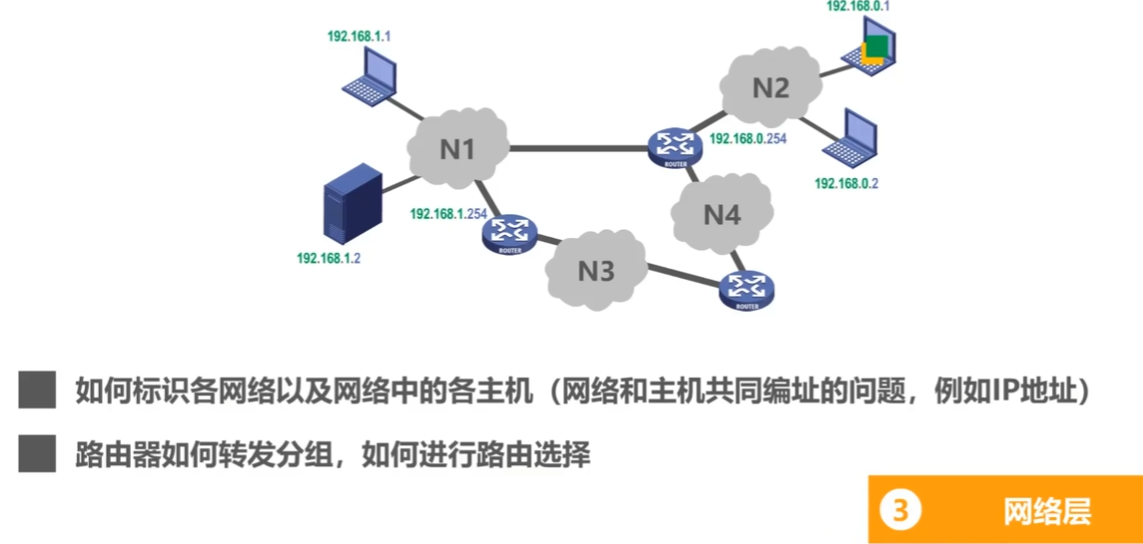
- tip
- IP地址的前三位用于确定网段,最后一位确定设备
- 传输数据可以有不同的线路选择,如何选择线路就成了一个问题
运输层所解决的问题
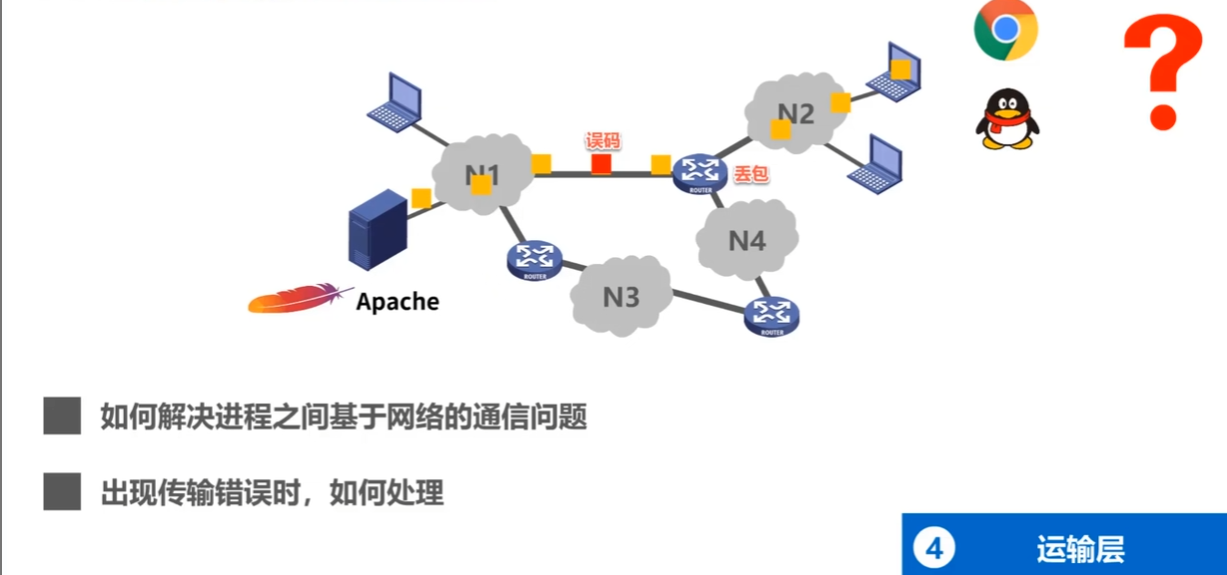
- tip
- 当主机上有多个进程时,如何区分数据应该交给哪个进程 (通过端口解决)
- 数据丢失时如何处理的问题(TCP:重传 UDP:不处理)
应用层所解决问题
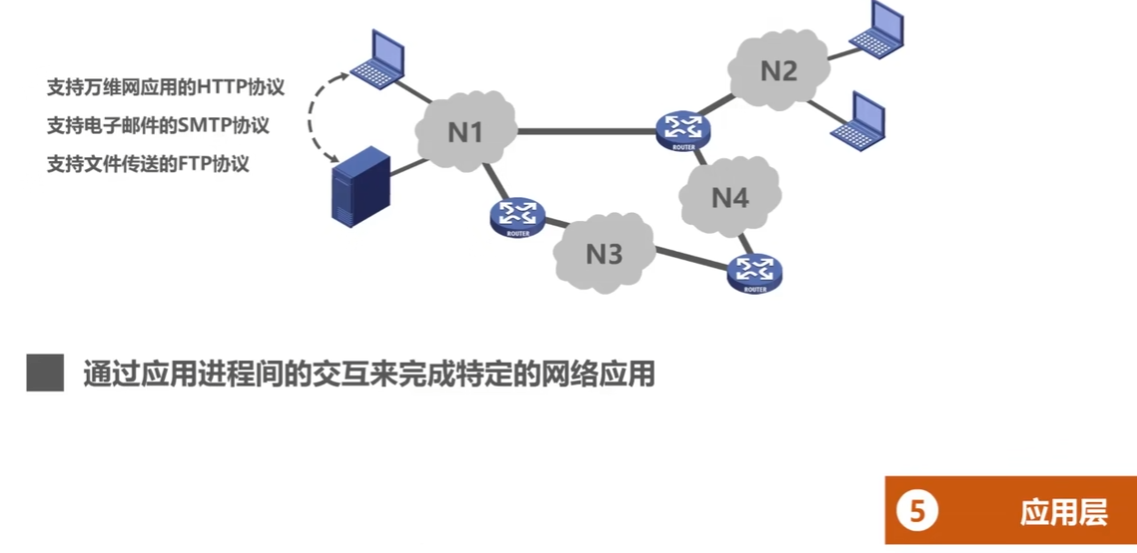
tip
前面几层只管把数据从 A 设备送到 B 设备,应用层决定这次通信的实际用途,是整个网络和用户的直接接口。
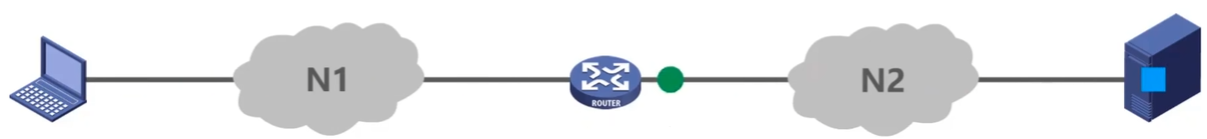
分层思想实例
通过网址访问网站的全过程
假设拓扑结构如图所示
主机所作操作
请求阶段
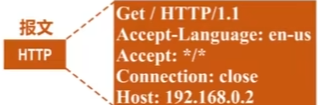
当我们输入网址后 应用层会根据HTTP协议生成一个请求报文
生成HTTP报文后交付给运输层,运输层为其添加一个TCP首部,使其成为一个TCP报文段
TCP首部是为了区分应用进程、并实现可靠传输
生成TCP报文段后将内容交由网络层,网络层为TCP报文段添加一个IP首部,使其成为IP数据报
IP首部是为了IP数据报可以被路由器转发
生成IP数据报后交由数据链路层为其添加一个首部和一个尾部使之成为帧
帧的首部是为了帧可以在网络上被传输,尾部是用于判定传输过程中是否有误码
生成帧后将帧交由物理层,物理层会将帧视为比特流,并加上一段前导码,加上前导码后将比特流传输给路由器中的物理层
响应解析阶段
在收到服务器的响应数据后再对数据进行层层拆分直到剩下HTTP响应报文,解析报文后显示网页内容
路由器所作操作
- 物理层接收到比特流后去掉前导码,将帧交给数据链路层
- 数据链路层接收到帧后,去掉首部尾部,将IP数据报交付给网络层
- 网络层解析IP数据包的首部,从中提取目标网络地址,随后查找自身路由表,确定转发端口
- 确定转发端口后,再由网络层到物理层,加上原先去掉的东西 成为比特流后再转发,如此一直重复直到到达服务器
服务器所作操作
- 数据库的物理层收到信号后,不断地去掉所添加的首部,到达应用层,此时只剩下了HTTP的请求报文
- 解析请求报文后生成响应报文,并复刻上述步骤对报文进行封装、传输
专业术语
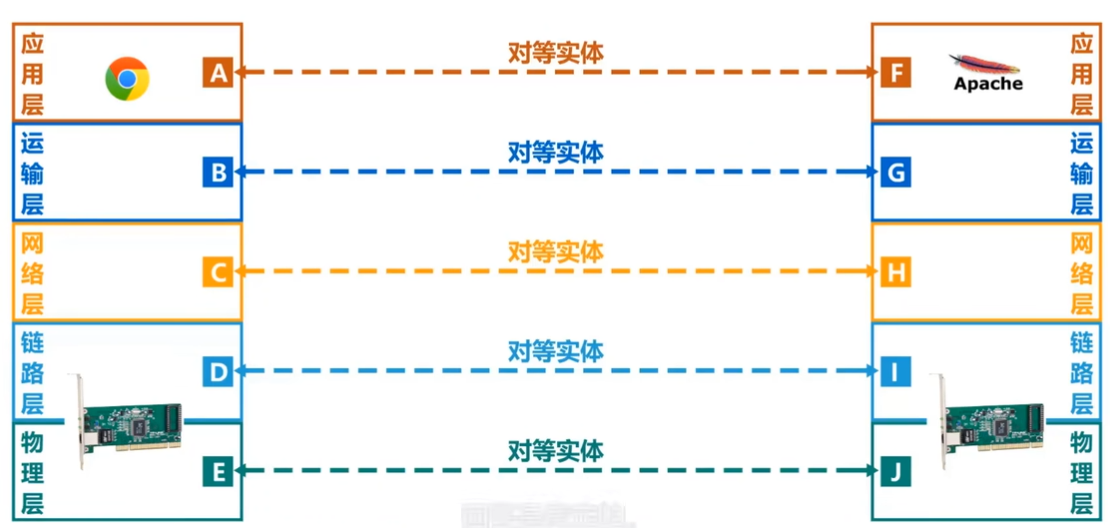
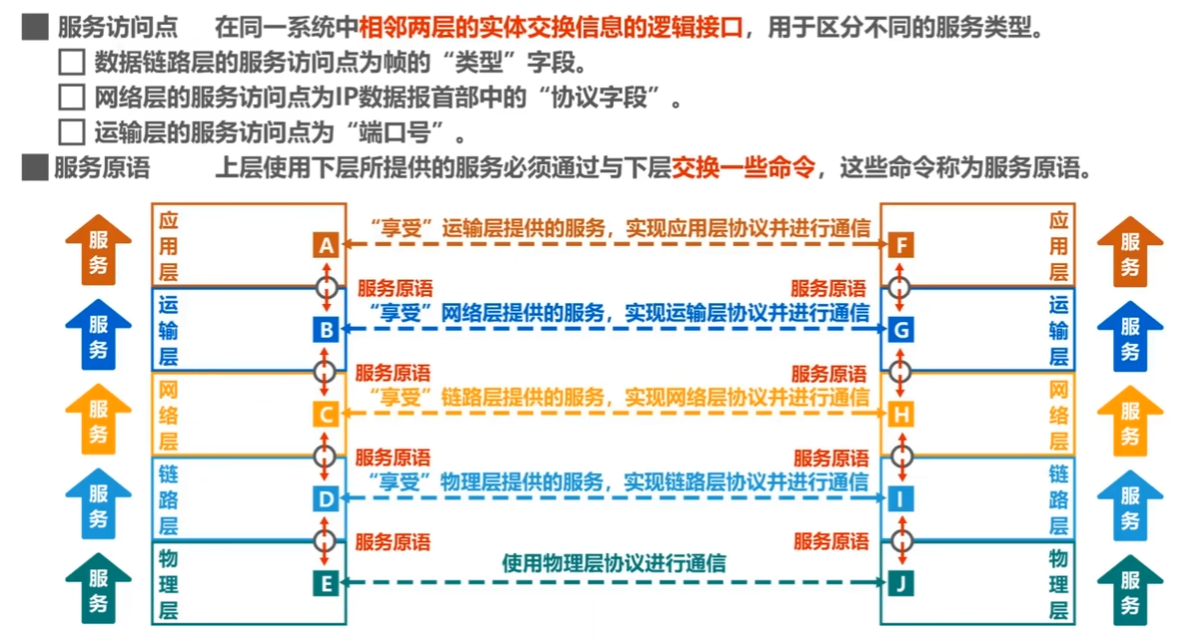
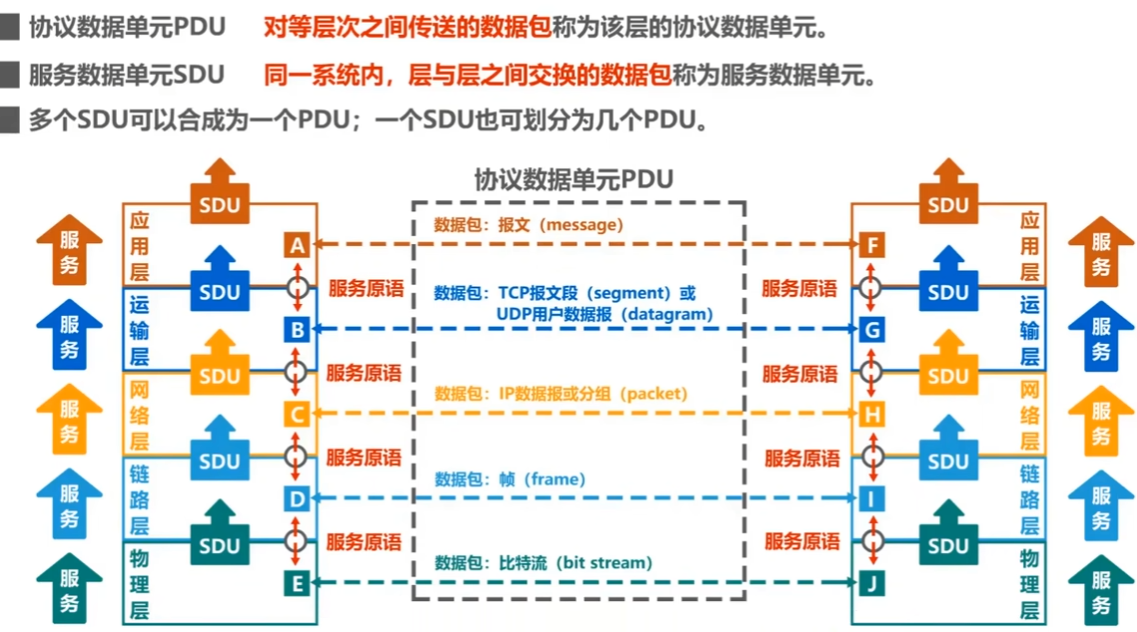
实体
- 实体:任何可以发送或接收信息的硬件或软件进程
- 对等实体:收发双方相同层次中的实体
协议
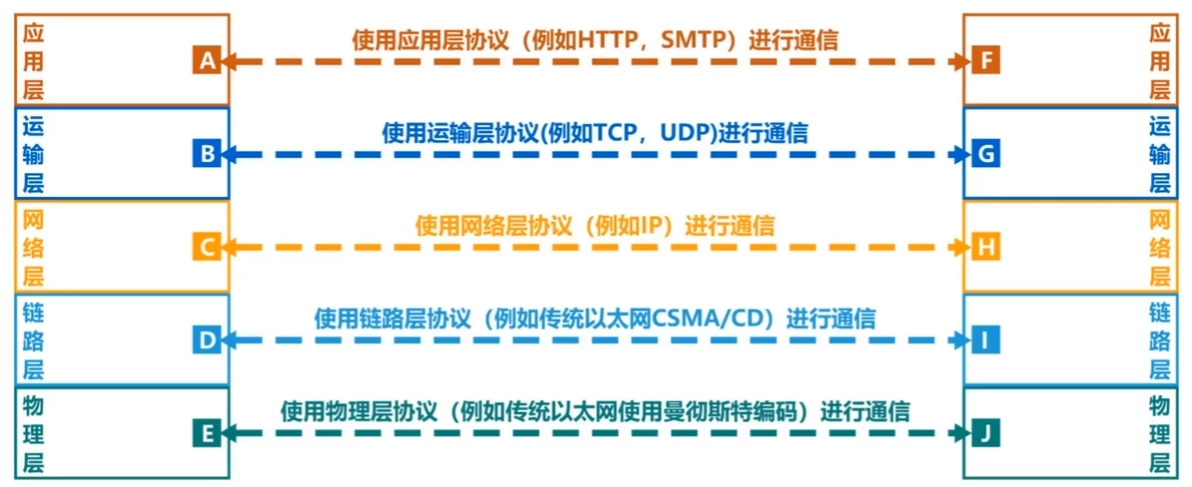
控制两个对等实体进行逻辑通信的规则集合
实际过程中并不是这样一对一的通信的,但是在研究时,我们可以这样一对一的研究,排除其他实体的干扰
协议三要素
语法:定义交换信息的格式
语义:定义收发双方所要完成的操作(请求/响应报文)
同步:定义收发双发的时序关系
例子:tcp三次握手建立同步
服务
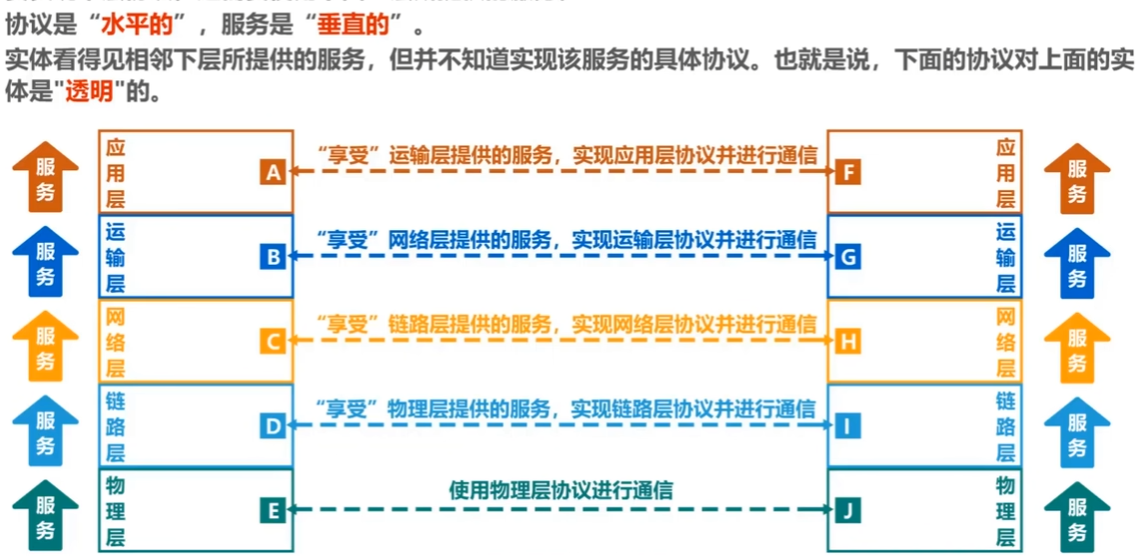
在协议的控制下,两个对等实体的逻辑通信使得本层能向上一层提供服务
简而言之:要实现本层协议,需要下一层提供的服务
二、物理层
1.物理层基本概念
传输媒体
传输媒体是计算机网络设备之间的物理通路,也被称为传输介质/媒介
传输媒体并不包含在计算机网络体系结构中
导引型传输媒体
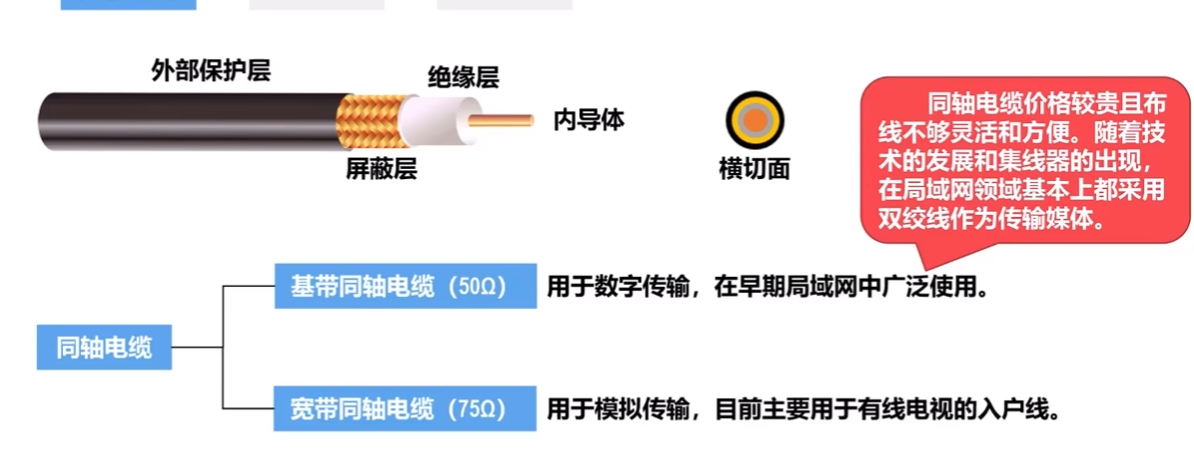
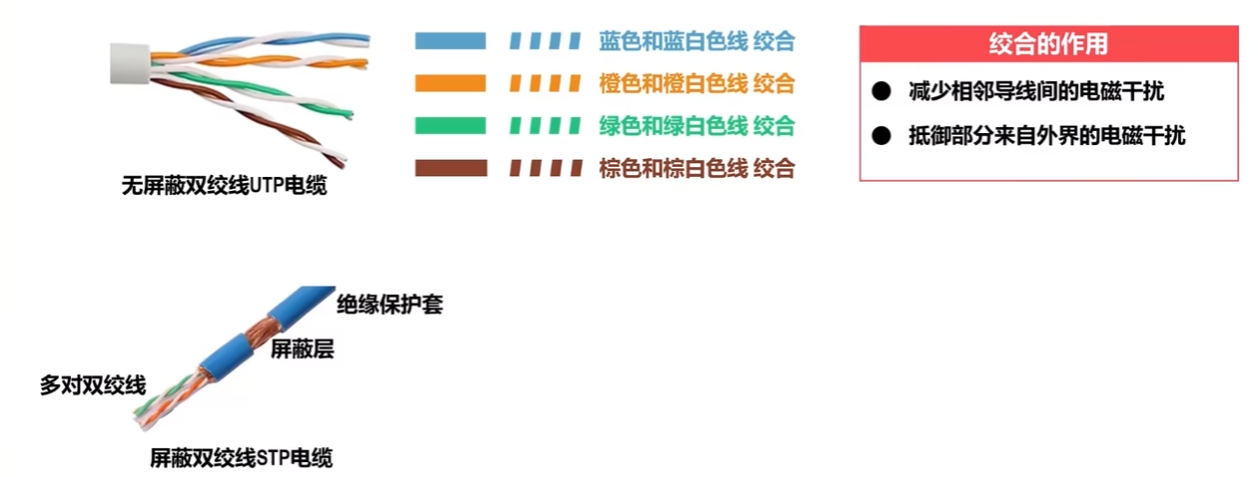
双绞线、同轴电缆、光纤
同轴电缆
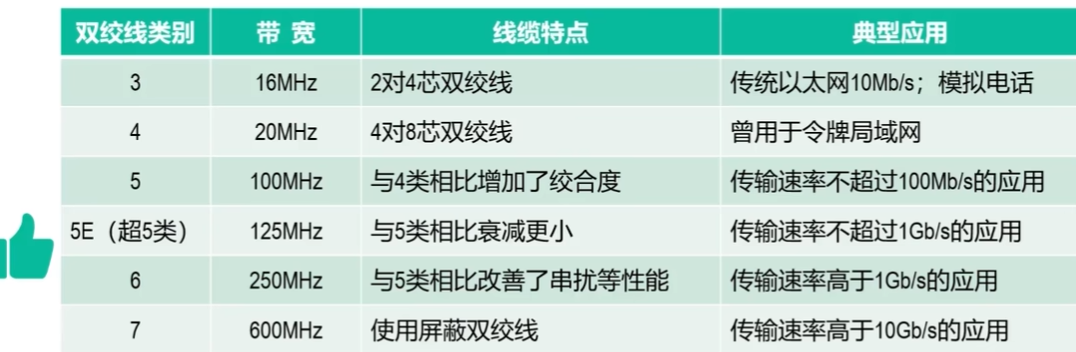
双绞线
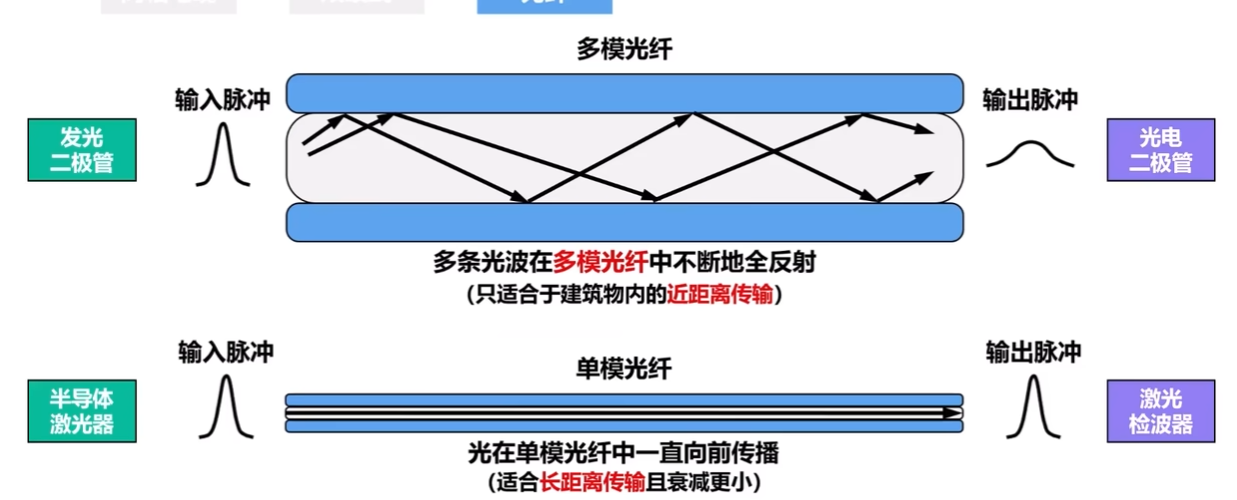
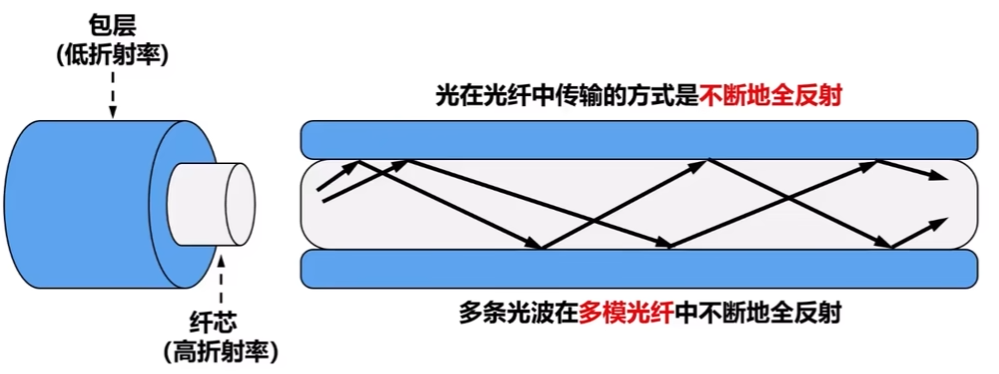
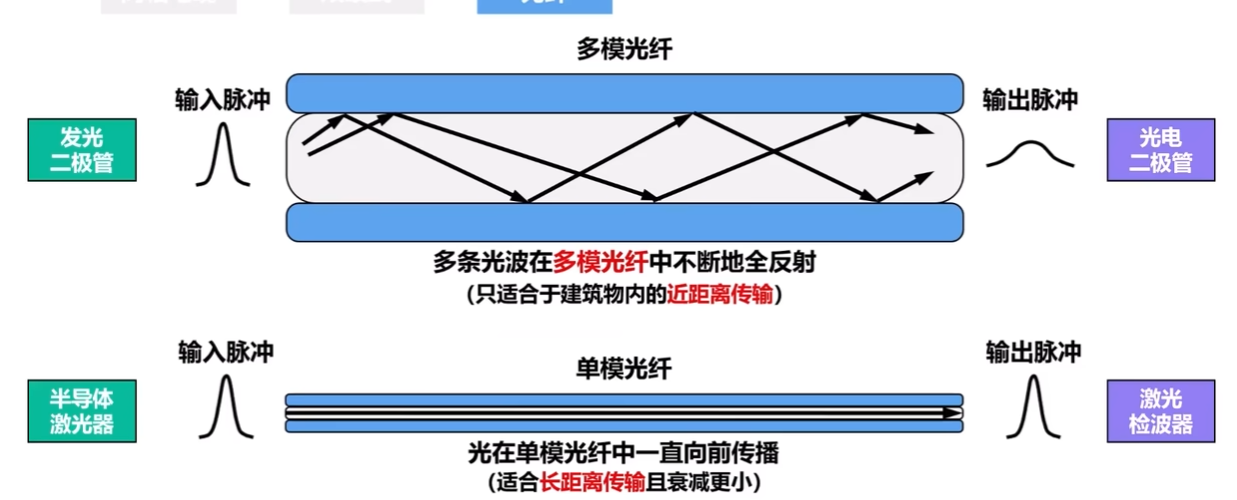
光纤
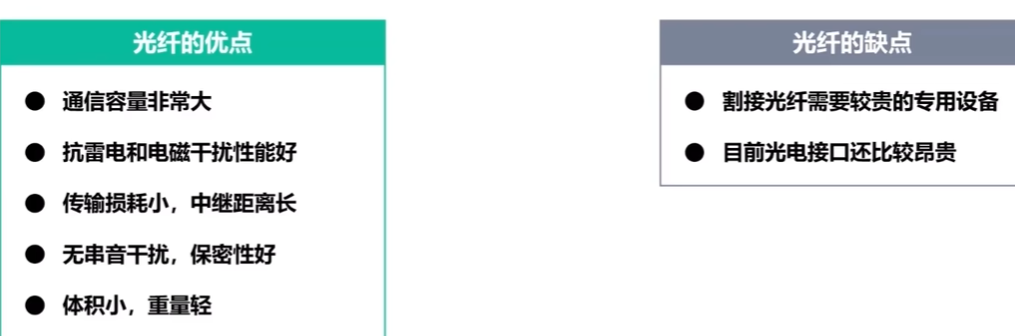
光纤通信利用光脉冲在光纤中的传递来进行通信,由于可见光频率很高(约10^8^MHz),因此光纤传输带宽远大于其他传输方式
非导引型传输媒体
无线电波、微波、红外线、大气激光、可见光
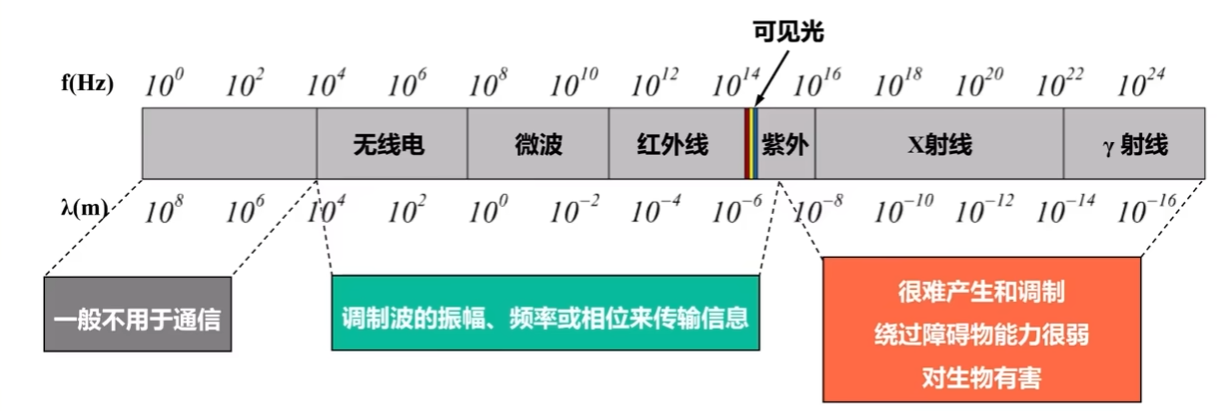
无线电波
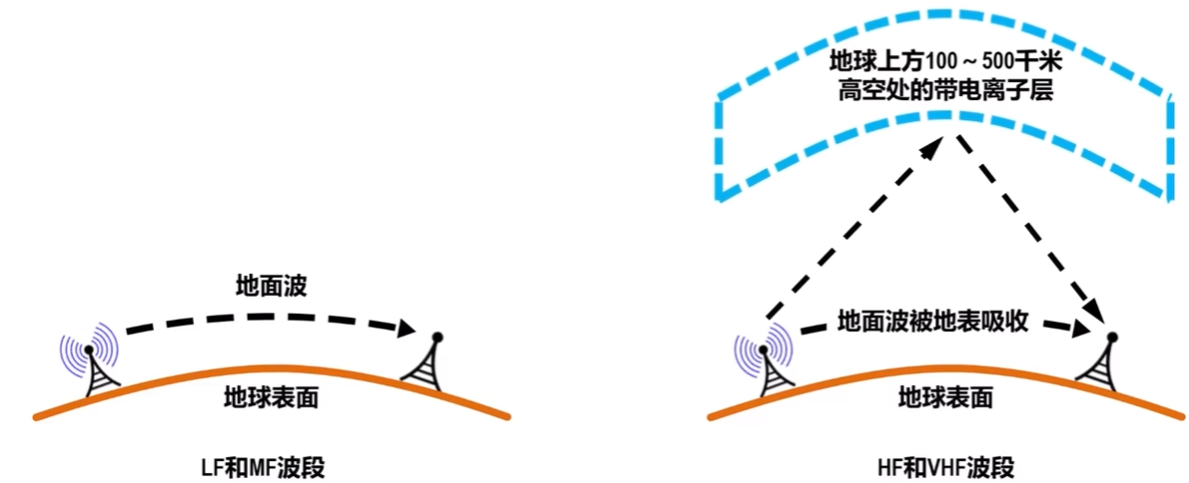
高频波容易被地面吸收所以需要用电离层反射
微波
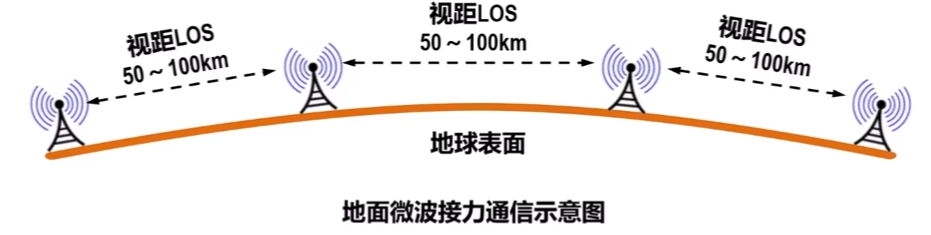
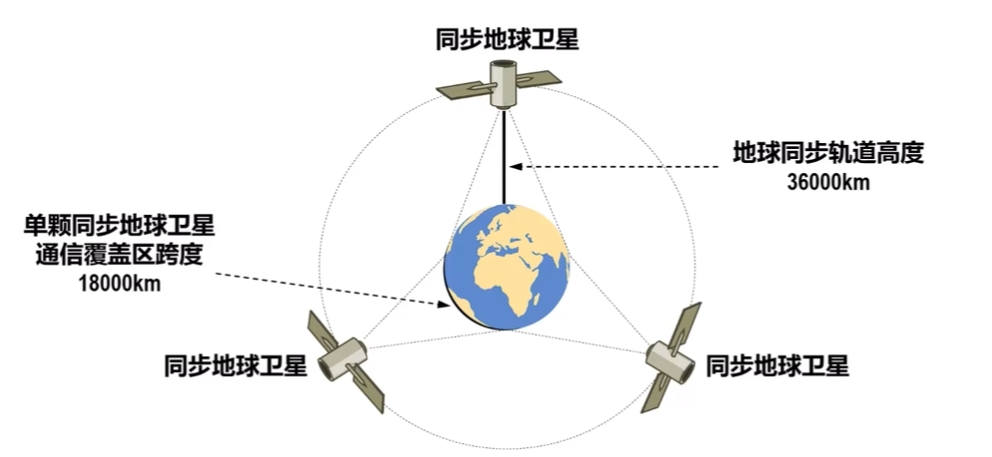
卫星通信也是一种微波通信,将卫星作为微波中继器
红外
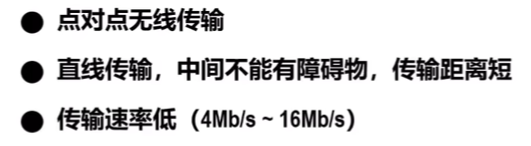

:star<物理层协议主要任务与接口特性>
总任务
在传输媒体上解决0/1比特流传输问题,并为上层(数据链路层)提供透明传输比特流服务
接口特性
机械特性
规定接口形状尺寸、引脚数目和排列、固定和锁定装置
电气特性
规定信号电压范围、阻抗匹配情况、传输速率、距离限制等
功能特性
规定接口电缆各条信号线的作用
过程特性
规定在信号线上传输比特流的一组操作过程,包括各信号间的时序关系
接口特性习题
习题1
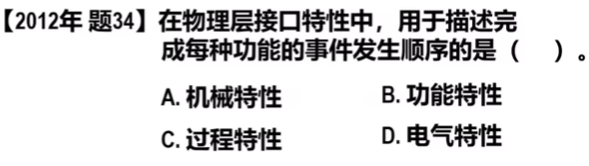
发生顺序–>C
习题2
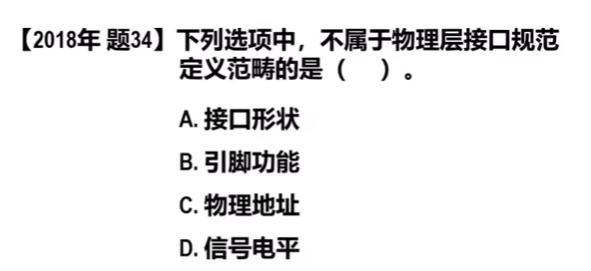
C (物理地址即MAC地址 是 数据链路层的)
2.传输方式
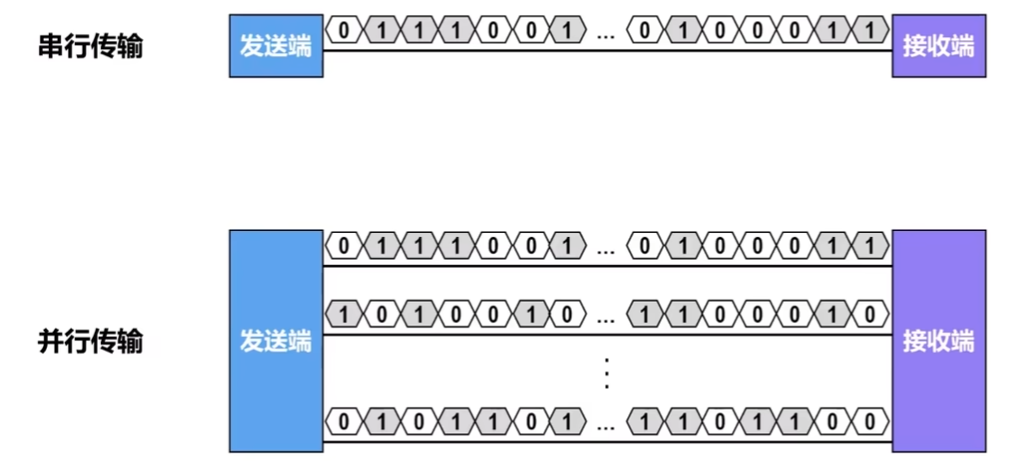
:star<串行传输和并行传输>
并行传输成本较高 一般只用于短距离传输
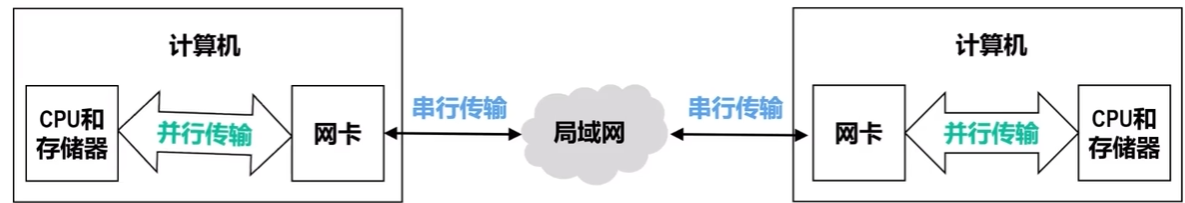
计算机内部的网卡同时具有串/并行传输的能力
:star<同步传输和异步传输>
同步传输
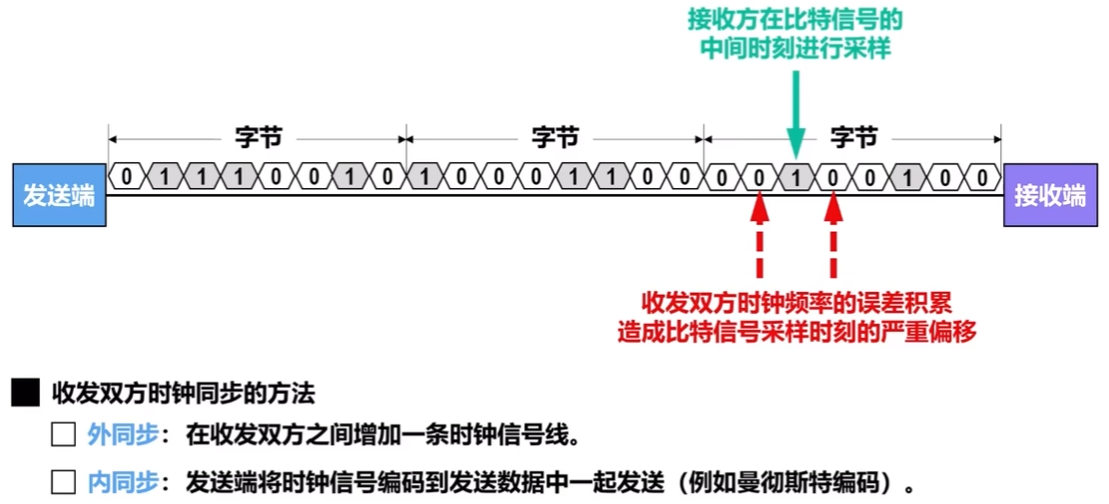
传输时各字节之间无间隔,容易因为设备频率不同而出现读取偏移的现象
异步传输
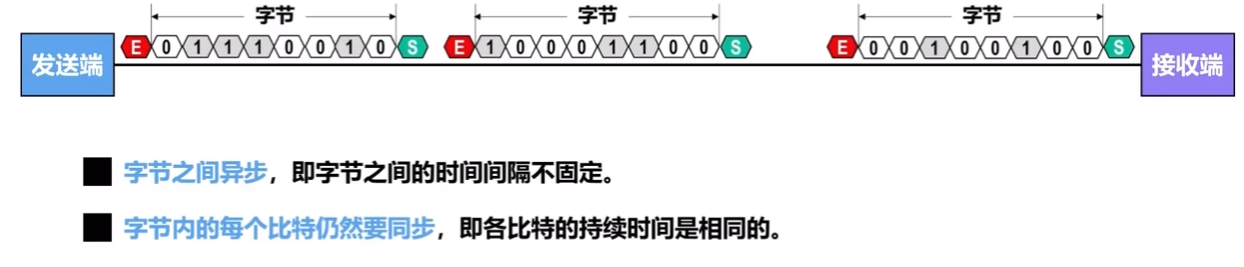
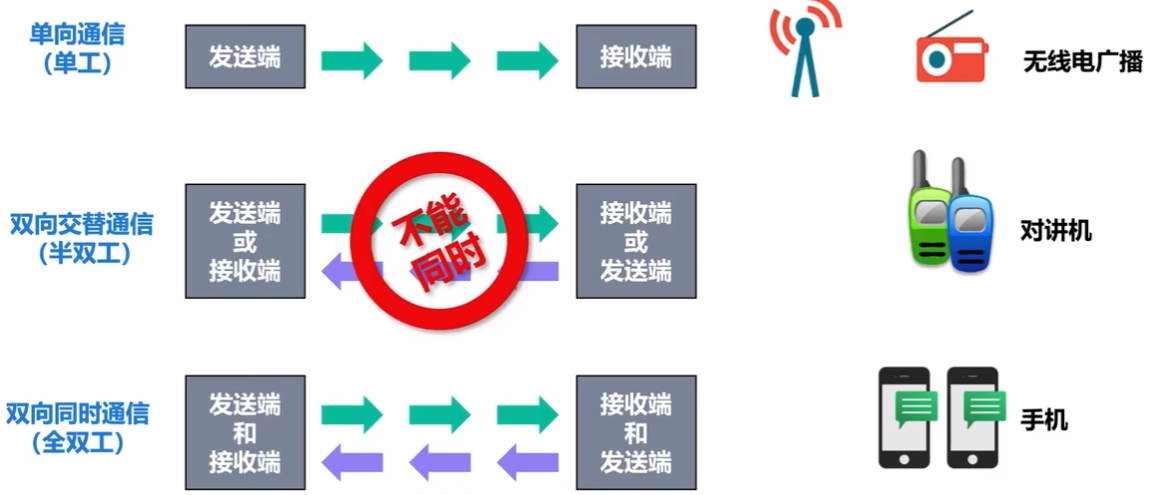
单向通信、双向交替通信、双向同时通信
:star<3>.编码与调制
编码调制基本概念
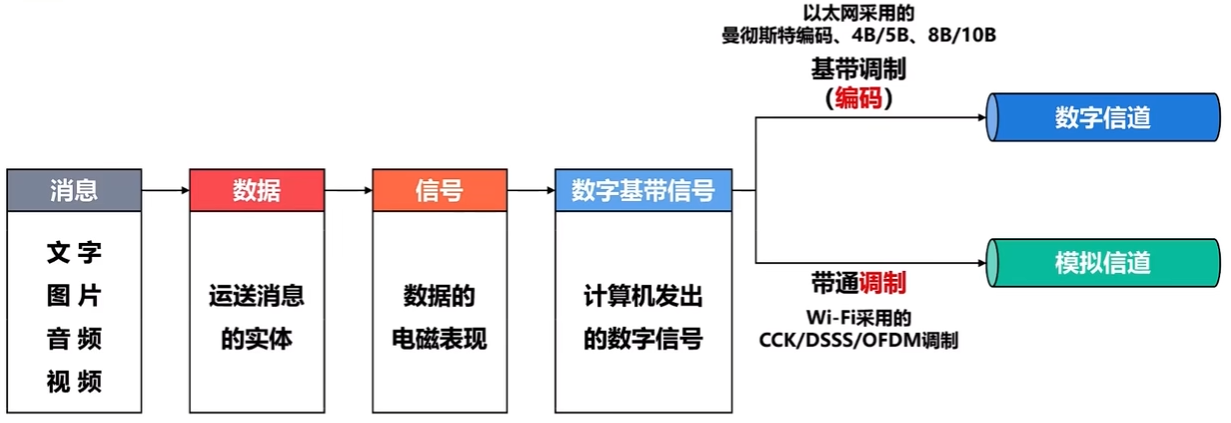
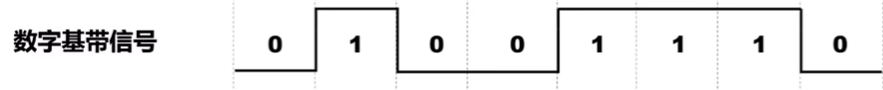
消息转换为二进制数据可以被表示为0/1数字信号,但数字基带信号的频率过低,无法直接在信道中传输
有以下两种调制方法
基带调制**(编码)**
改变数字基带信号波形 使其能够在数字信道中传播,调制后的信号仍然是数字信号
带通调制**(调制)**
改变数字基带信号的频段,使其能够在模拟信道中传输
码元
即:表示离散数值(0/1)的基本波形
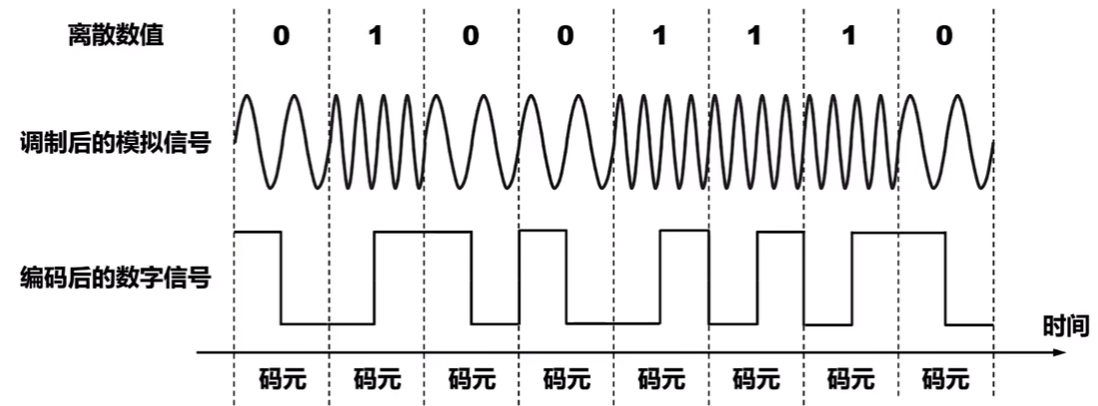
常用编码方式
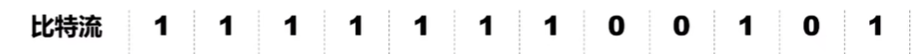
注意<后面所有的图示都是对这个比特流的编码>
双极性不归零编码
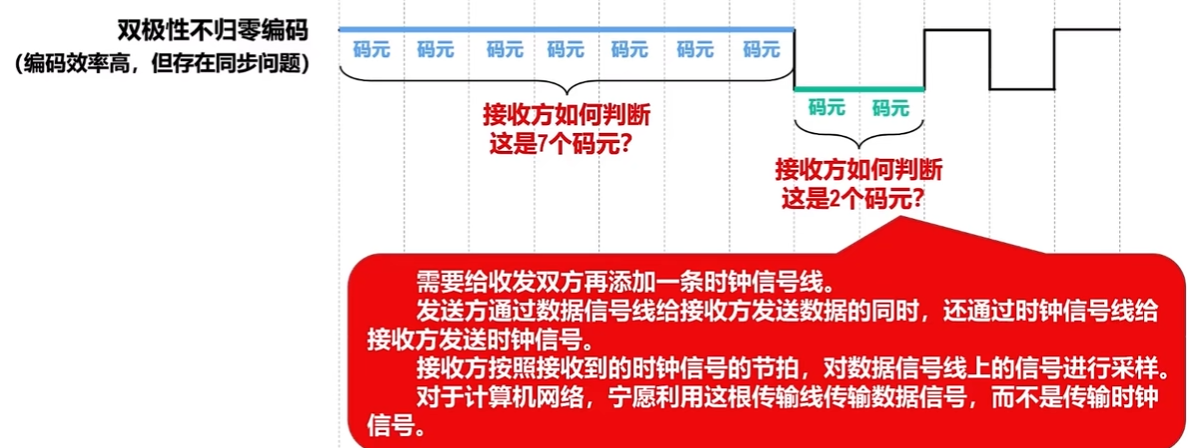
用正电表示1 负电表示0 这就会导致当多个0/1连在一起的时候无法判断码元的个数,因此需要额外加一条时钟信号线(外同步)用于确定采样频率,确定频率后就可以区分码元个数了。
双极性归零编码
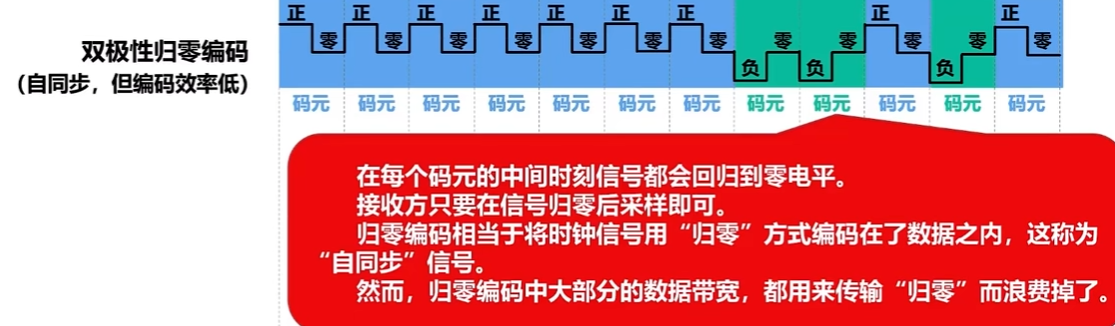
在进入下一个码元前先归零(内同步),这样就不会出现不同码元连在一起的情况,用以区分不同码元。
曼切斯特编码
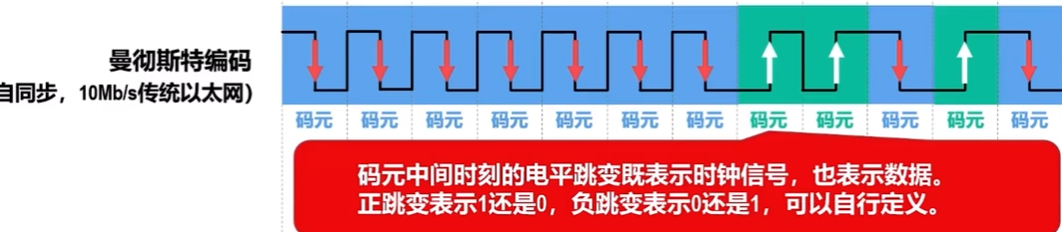
在每个码元的中间时刻进行跳变(内同步),用以区分不同码元,并且通过变化表示0/1电信号 如:正–>负表示1 负–>正表示0
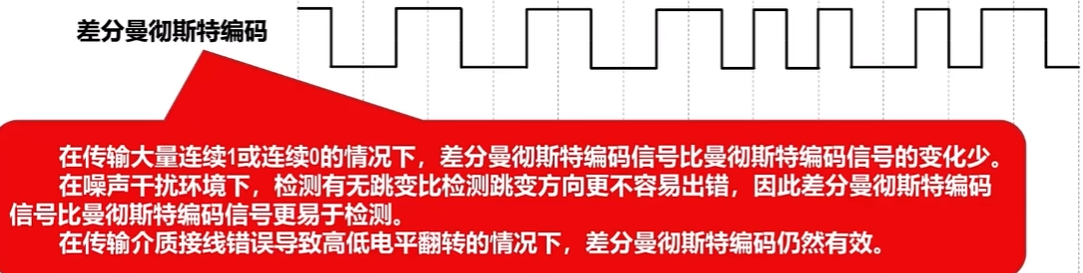
差分曼切斯特编码
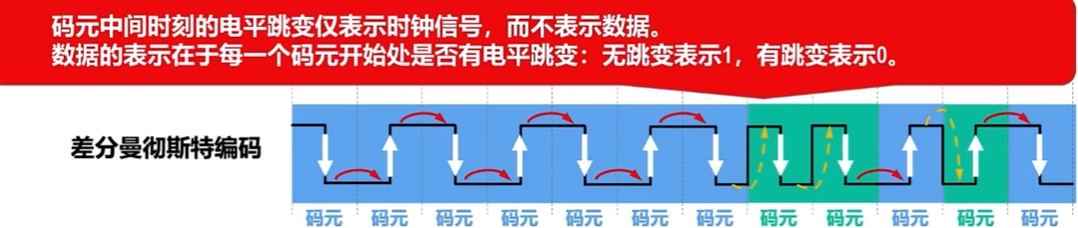
观察每个码元开始处有无跳变,有为0,无为1 中间时刻的跳变不用管 是时钟频率
编码习题
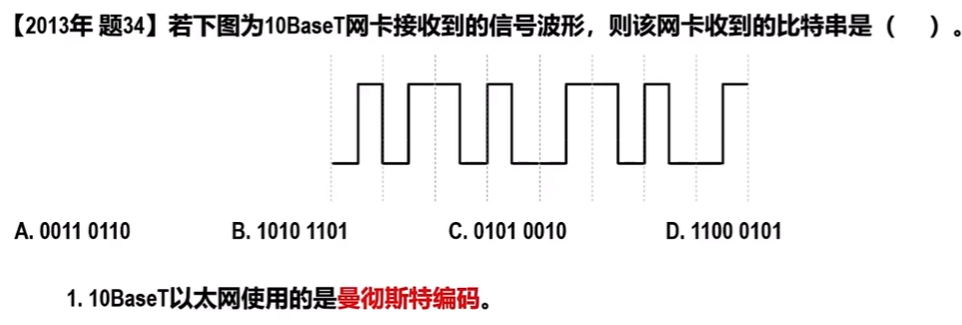
- 习题一
曼切斯特编码上/下跳变代表0还是1是可以自定义的 所以我们只要数中间时刻上下顺序即可
顺序为:上上下下 上下下上 –> 1100 1001 或 0011 0110 A
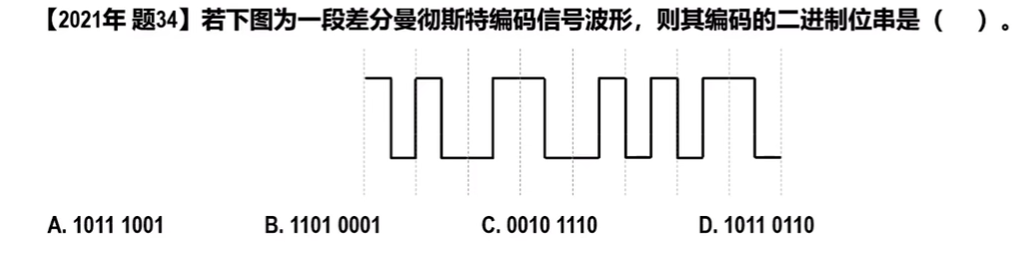
- 习题2
差分曼切斯特编码只看每个码元开始处(即虚线处) 有跳变为0 无为1
X011 1001 (第一个码元是无法确定的) A
基本的带通调制和混合调制方法
基本带通调制方法
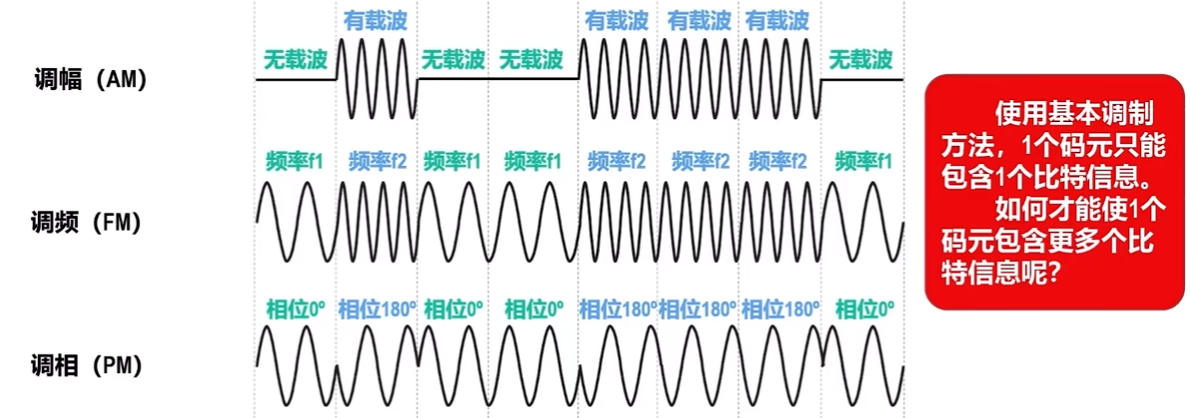
混合调制方法
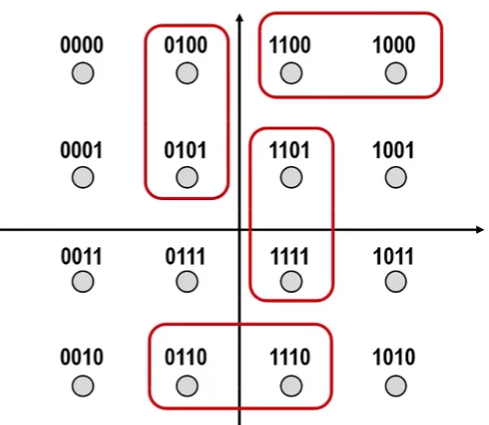
QAM16混合调制
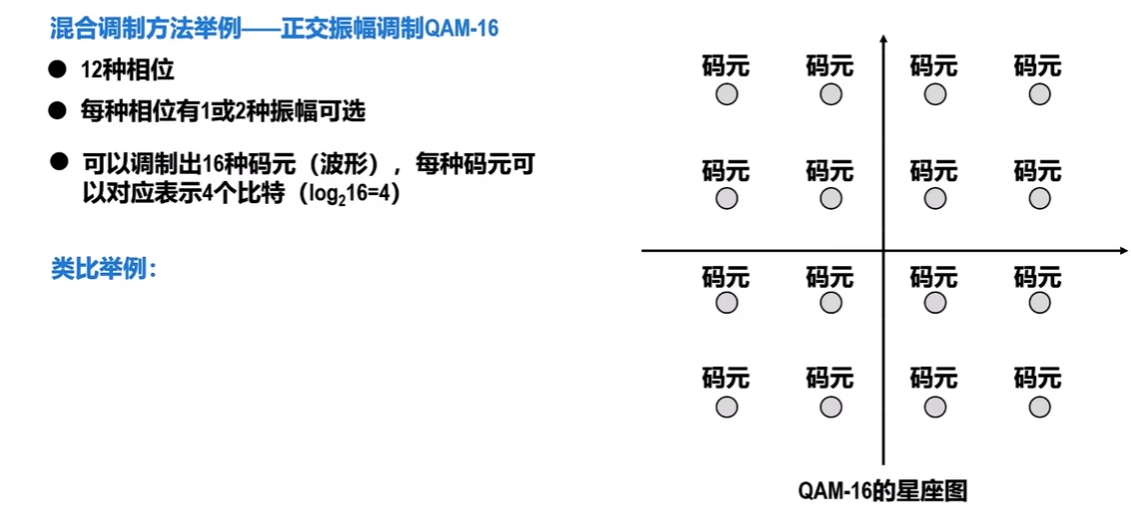
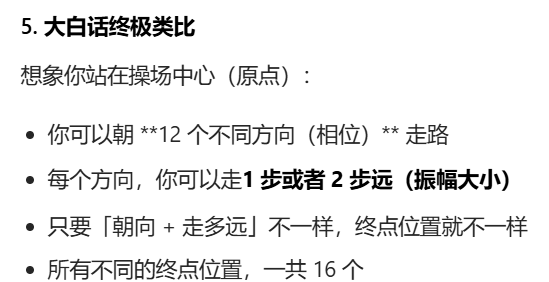
通过QAM混合调制可以调制出16个唯一的码元,那么一个码元就可以存储4个比特位
原因:4个比特位 每个比特位有两个状态(0/1) 那么四个比特位可以组成的状态数总和就是2^4^=16
所以我们只需要对每一种唯一的码元规定好其存储的是哪四个比特位(如:0000 0001 …)就可以根据这个规定进行调制和解析
如何规定?
由于传输过程中会产生数据的丢失或失真,导致最后接收到的码元的位置并不会正好落在理想位置**(会有所偏差),此时接收方就会选取最近的那个理想码元位置**进行解读。所以我们规定的相邻码元存储数据之间最好只有一个比特位不同(格雷码) 以减少数据的偏差

4.信道极限容量
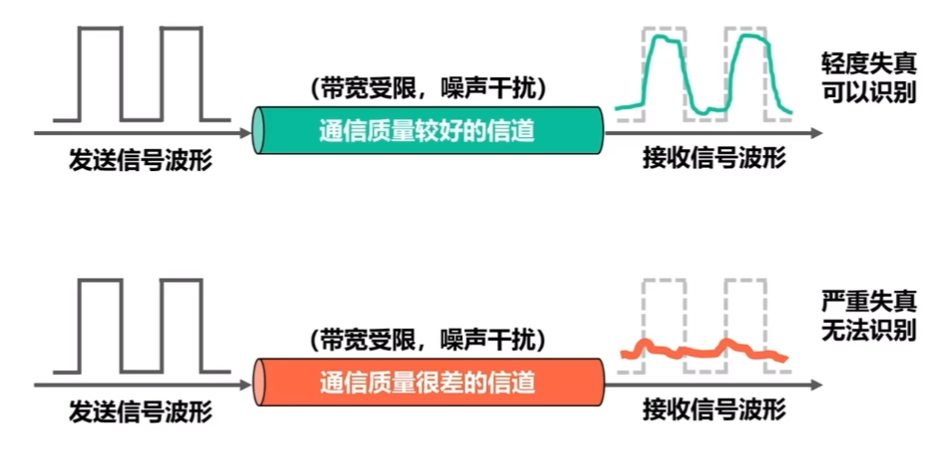
信号失真的主要因素
信号失真示意图
失真因素
码元传输速率
码元传输速率越高,失真越严重
信号传输距离
信号传输距离越远,失真越严重
噪声干扰
噪声干扰越严重,失真越严重
传输媒体质量
传输媒体质量越差,失真越严重
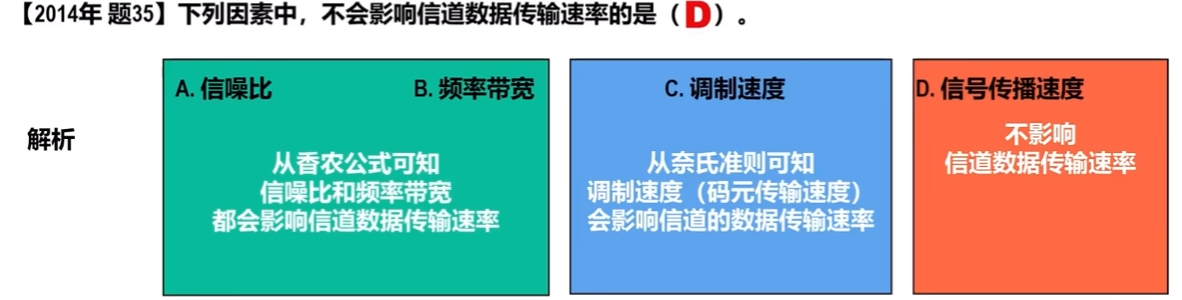
:star<奈式准则>
奈式准则用于计算码元的最高传输速率
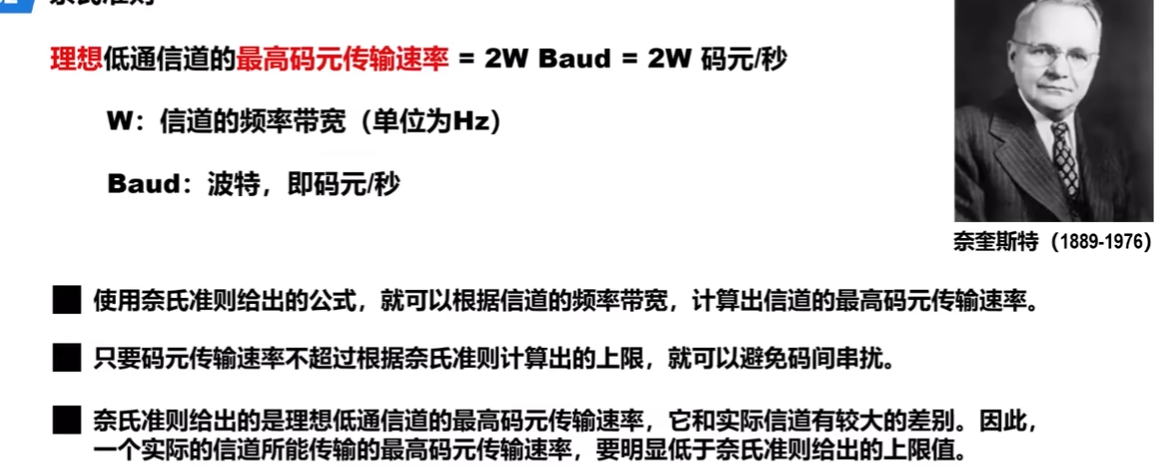
码元传输速率又称为波特率、调制速率、波形速率或符号速率。
波特率与比特率有一定的关系:
- 当1个码元只携带1比特的信息量时,波特率(码元/秒)与比特率(比特/秒)在数值上是相等的。
- 当1个码元携带n比特的信息量时,波特率(码元/秒)转换成比特率(比特/秒)时,数值要乘以n。
:star<香农公式>
由上述关系会抛出一个疑问 我们可以用调制技术增大一个码元存储的数据量,那只要我们调制的够多,岂不是可以无限提高信号传输速率(比特率)?
由此引出了香农公式
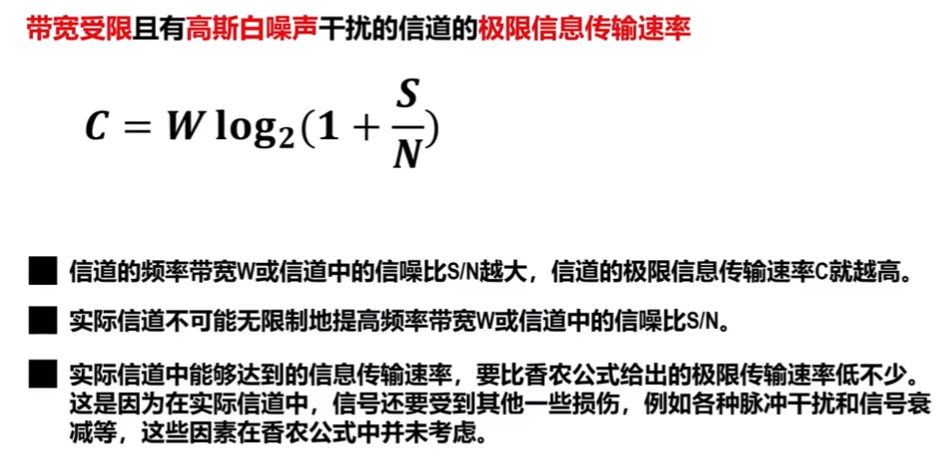
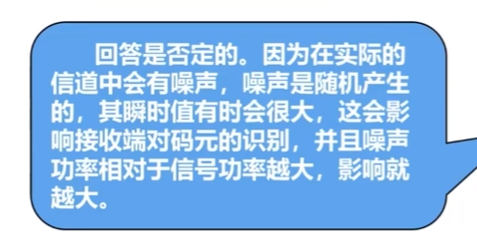
结论
在信道的频率带宽W一定的情况下,根据奈氏准则和香农公式,要想提高信息的传输速率,就必须采用多元制(更复杂的调制技术),并努力提高信道中的信噪比。 自从香农公式发表后,各种新的信号处理和调制方法就不断出现,其目的都是为了使码元可以携带更多个比特,进而可以尽可能地接近香农公式给出的传输速率极限。
:star<信道极限习题>
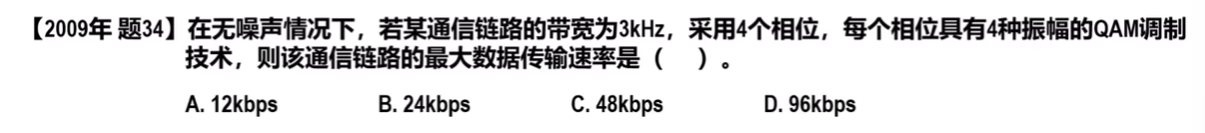
习题1
最高码元传输速率:2 * 3=6(码元/s) 一个码元可携带的比特: log
2(4*4)=4 6 * 4=24 B习题2
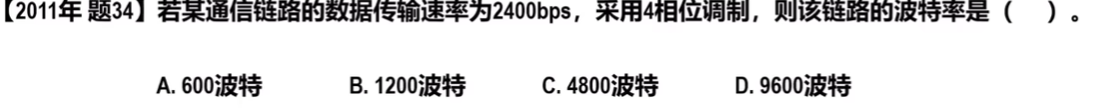
一个码元可携带的比特: log
2(4)=2 2400/2=1200 B习题3
习题4
习题5
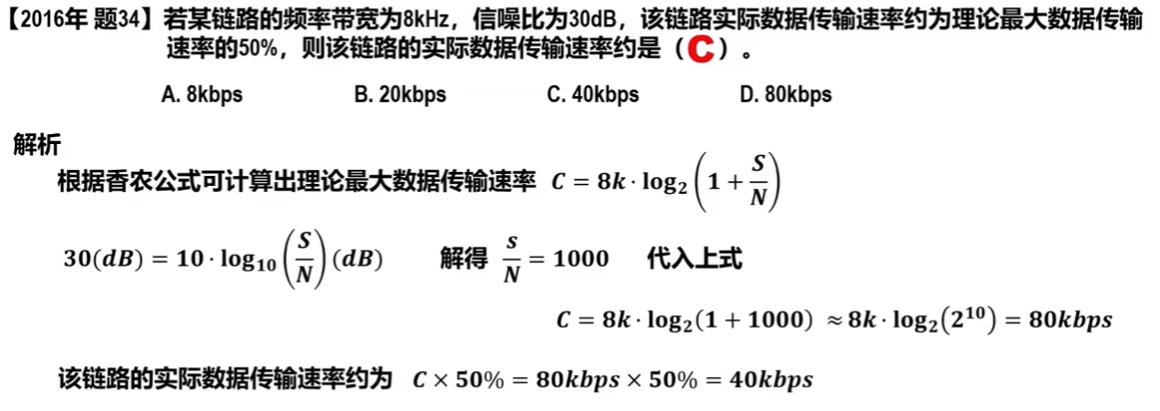
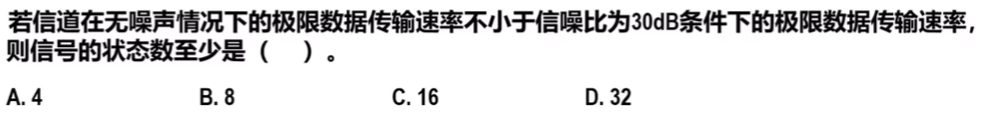
仿效上题 信噪比30db时: S/N=1000 C=W*log
2(1001)≈ 10W 无噪音时:2W*n=10W n=5 状态数=2^5^=32 D
5.信道复用技术
复用技术简介
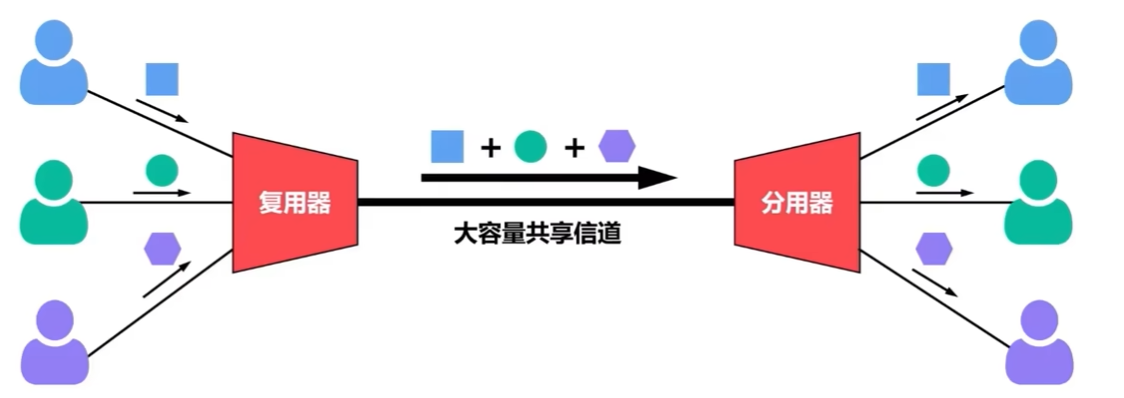
复用就是在一条传输媒体上同时传输多路用户的信号
当一条传输媒体的传输容量大于多条信道传输的总容量时,就可以通过复用技术,在该条传输媒体建立多条通信信道,以便充分利用传输媒体的带宽。
常用的信道复用技术
频分复用FDM
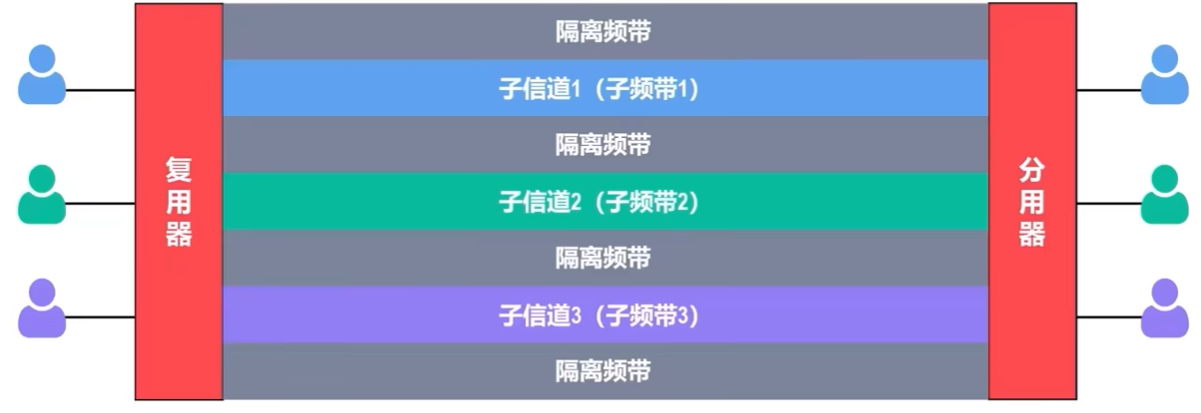
频分复用的所有用户同时占用不同的频带发送数据
时分复用TDM
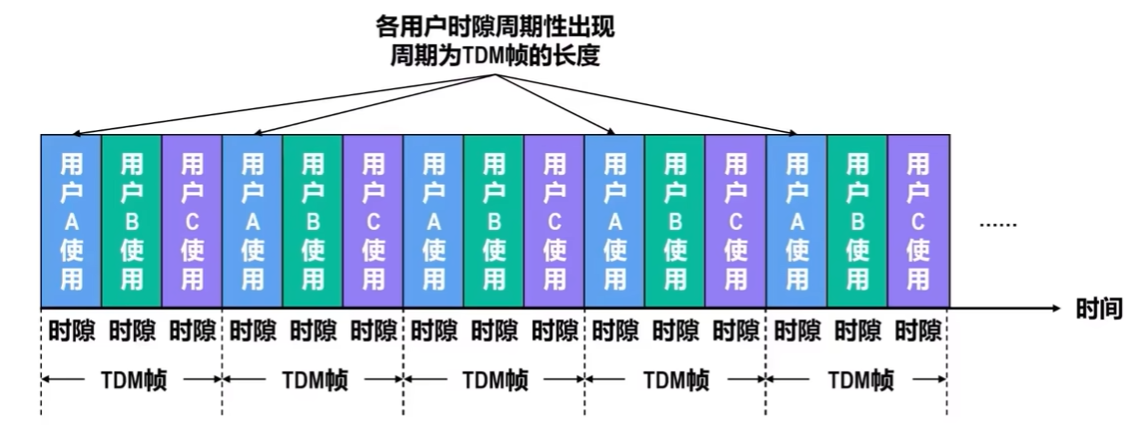
注意:TDM帧指的是固定的一个周期的时间,与数据链路层中的“帧”完全不同
时分复用的所有用户在不同的时间占用同样的频带发送数据
波分复用WDM
波分复用即为光的频分复用,根据频分复用的思想,在一根光纤上同时传输多个频率(波长)相近的光载波信号
原理 — 三棱镜作为复合器和分用器
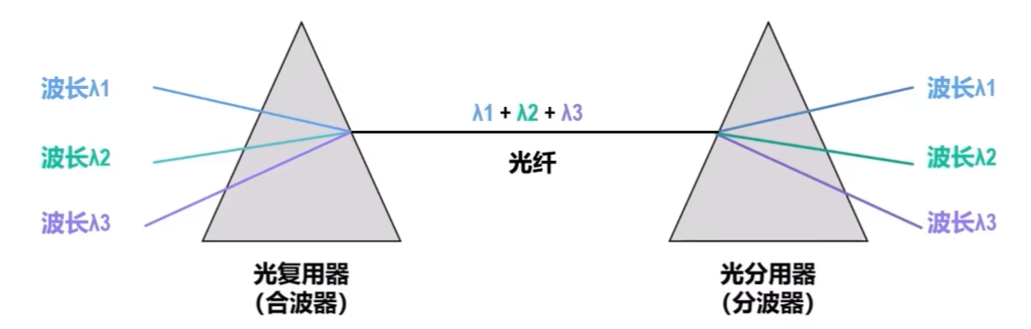
目前可以在一根光纤上复用80路或更多路的光载波信号。因此,这种复用技术也称为密集波分复用DWDM。
铺设光缆的工程耗资巨大,应尽量在一根光缆中放入尽可能多的光纤,然后对每一根光纤使用密集波分复用技术。
例如,在一根光缆中放入100根速率为2.5Gb/s的光纤,对每根光纤采用40倍的密集波分复用,则这根光缆的总数据速率为 。
码分复用CDM
码分复用(Code Division Multiplexing, CDM)常称为码分多址(Code Division Multiple Access, CDMA),它是在扩频通信技术的基础上发展起来的一种无线通信技术。
与FDM和TDM不同,CDMA的每个用户可以在相同的时间使用相同的频带进行通信。
CDMA最初用于军事通信,这种系统发送的信号有很强的抗干扰能力,其频谱类似于白噪声,不易被敌人发现。
原理
CDMA 会把原本1 个比特(0 或 1) 的时间,切分成
m个更小的时间片段,每一小段就叫码片(Chip)。即:每个站给基础的 0/1,套上了独一份、别人解不开的专属身份编码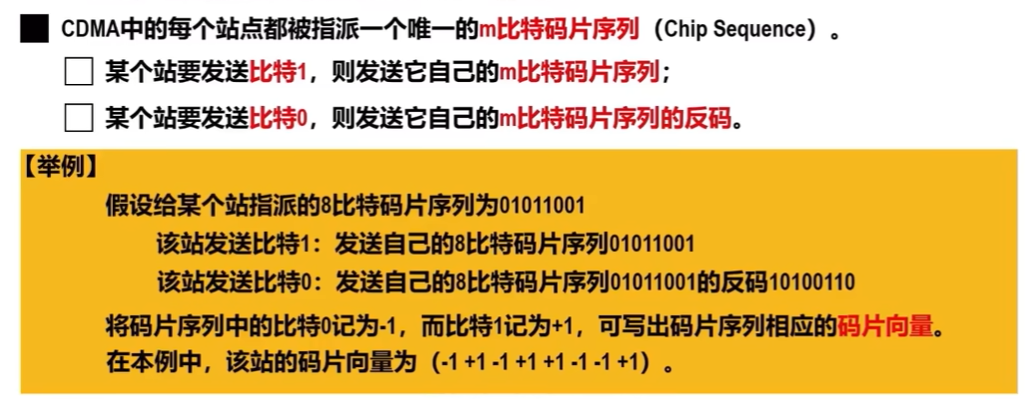
解码的原理
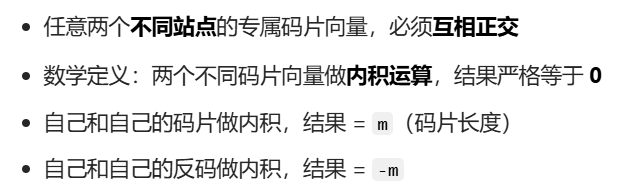
总而言之:接收端解码自己要的信号时,其他所有用户的信号直接归零、彻底抵消,完全不会造成干扰。
具体见视频 8min-16min
三、数据链路层
1.数据链路概述
数据链路层地位
实际过程中需要经过不同层的层层封装、解封、传输等步骤。 此处我们只研究数据链路层,所以可以看为在数据链路层中进行传输
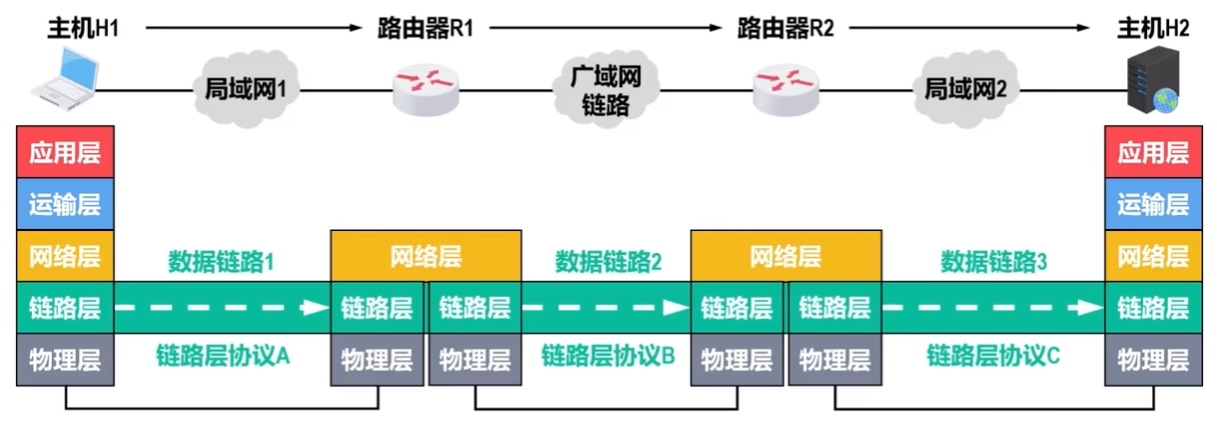
链路、数据链路和帧
链路
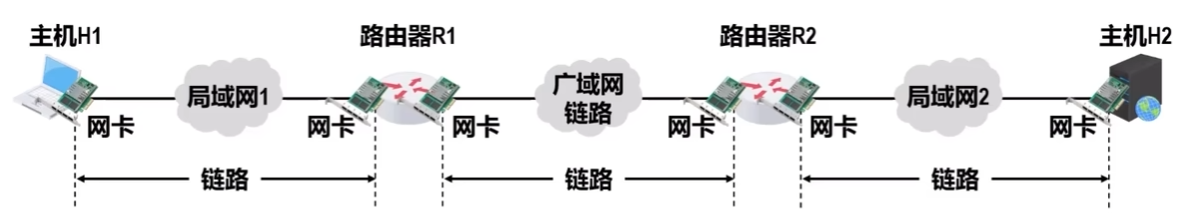
链路(Link)指的是从一个节点到相邻节点的一段物理线路(有线或无线),且中间没有任何其他交换节点
数据链路
数据链路(Data Link)是基于链路的。当在一条链路上传送数据时,除需要链路本身,还需要一些必要的通信协议来控制这些数据的传输,把实现这些协议的硬件和软件加到链路上,就构成了数据链路。
- 计算机中的网络适配器(俗称网卡)和其相应的软件驱动程序就实现了这些协议。一般的网络适配器都包含了物理层和数据链路层这两层的功能。
帧
帧(Frame)是数据链路层对等实体之间在水平方向进行逻辑通信的协议数据单元PDU

只研究数据链路层,排除其他层干扰,所以可以认为是在对等实体间传输帧
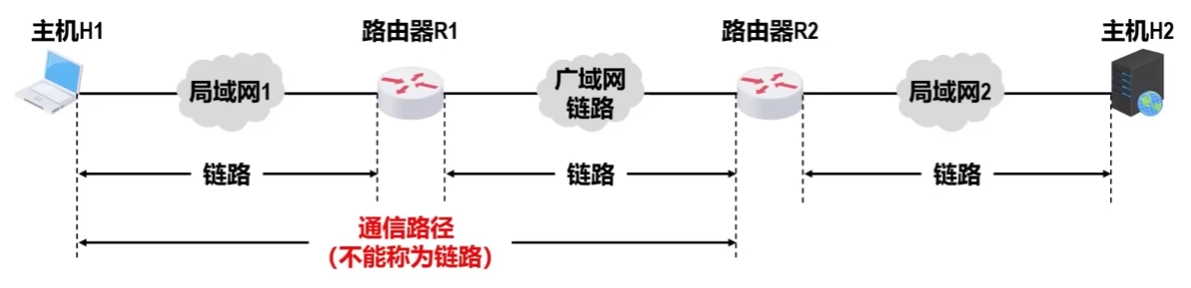
2.数据链路层的三个重要问题
封装成帧和透明传输
封装成帧
概念
在数据链路层会为网络层封装后的IP数据报添加一个首部一个尾部封装为帧
一、以太网版本2的MAC帧
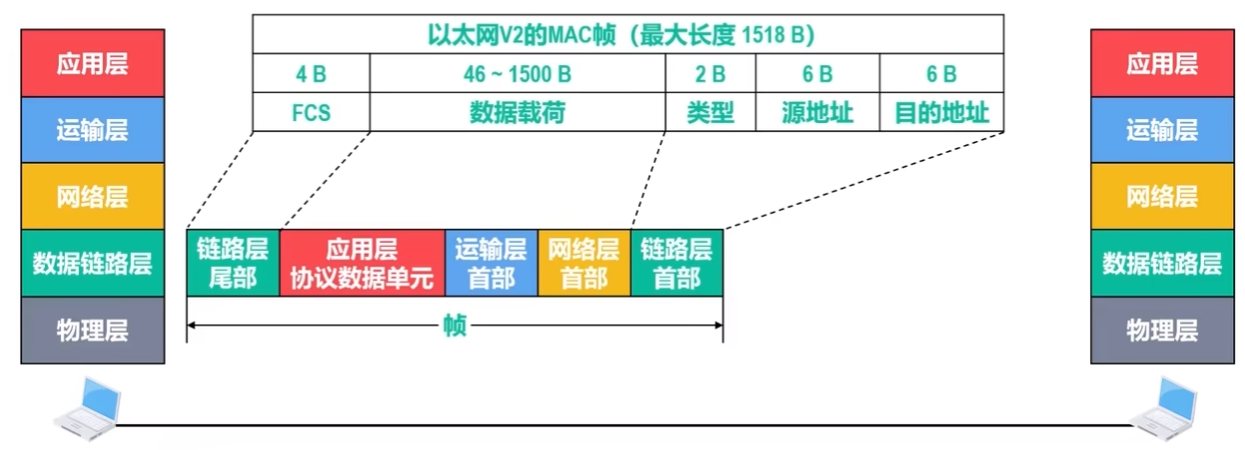
首部包含数据类型、数据源地址、数据目标地址
尾部包含FCS(用于判断传输过程中是否有误码)
tip:此类帧并没有定界标志,此帧的定界通过物理层中所加的前导码实现
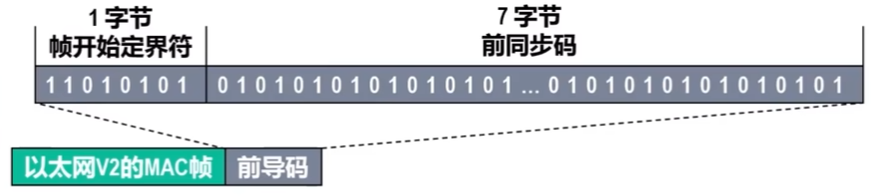
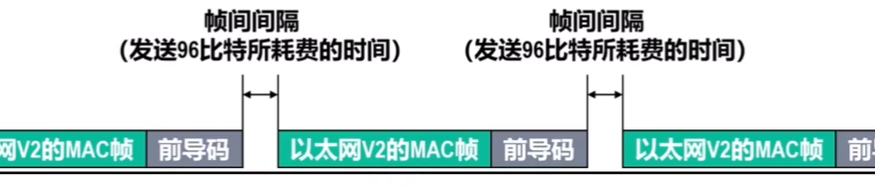
- 前导码中的前同步码用于使接收方的时钟同步
- 前导码中包含帧开始的定界符,并且由于MAC帧发送时并不是紧挨在一起的 帧与帧之间有帧间间隔 所以不需要结束定界符
二、点对点PPP协议帧
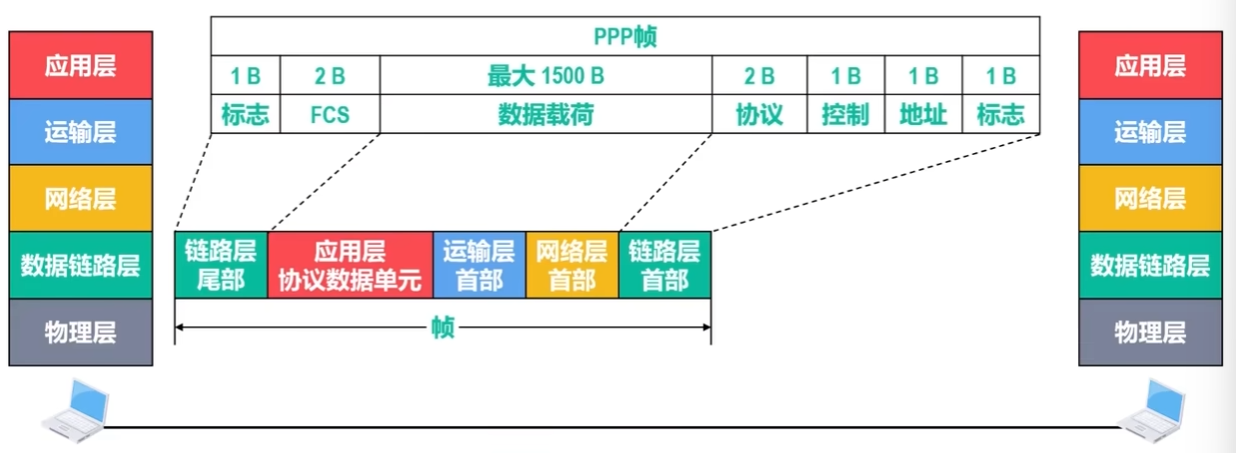
首尾部都有一个标志,分别用来标定帧的开始和结束 用于帧定界
当其他设备接收到物理层的比特流并解析为帧传入数据链路层时,可以根据标志判别帧的范围
示意图
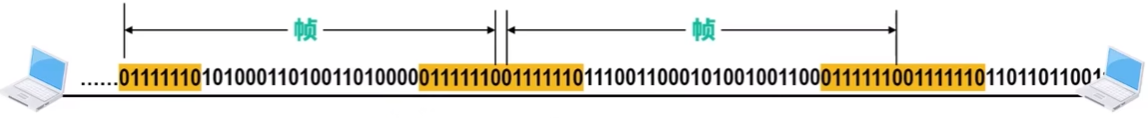
其中01111110 为标志
相关优化和限制
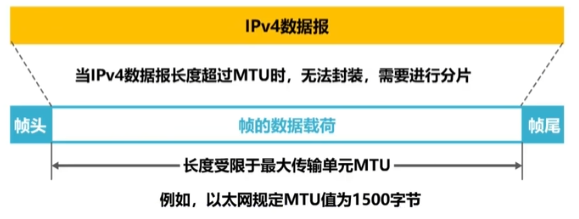
为了提高数据链路层传输帧的效率,应当使帧的数据载荷的长度尽可能地大于首部和尾部的长度。
考虑到对缓存空间的需求以及差错控制等诸多因素,每一种数据链路层协议都规定了帧的数据载荷的长度上限,即最大传送单元(Maximum Transfer Unit, MTU)。例如,以太网的 MTU 为 1500 个字节。
透明传输
概念
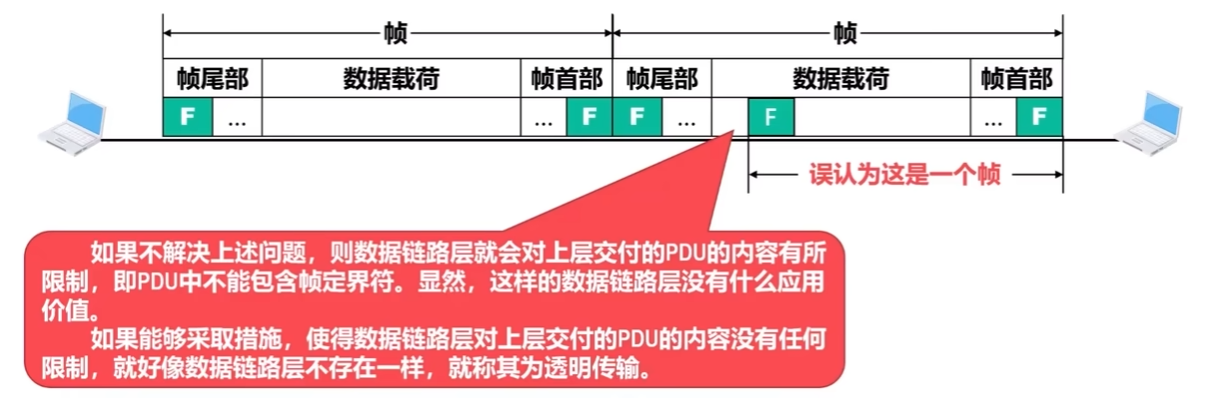
由封装成帧可知,帧的首尾部会有一个标志用于帧定界,而若是数据中出现了同样的标志就会导致帧的定界出错。若是不使用透明传输技术,相当于对上层数据内容做了严苛限制(即:上层传下来的数据不能有定界标志),这会很多数据没法正常传输。
综上所述,如果想要所有的数据可以正常传输(不受定界符的限制),就需要透明传输技术
实现方法
字节填充:扫描数据载荷,在每一个与定界符相同的数据前放入一个特殊的转义字符(ASCII 27),这样接收方读取到转义字符时就知道这并不是帧的结束
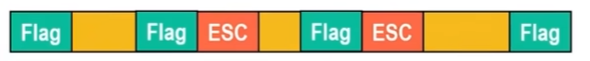
特殊情况的补充处理
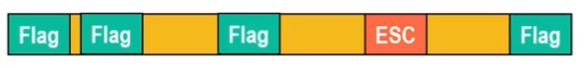
即:原始数据中即出现了转义字符又出现了定界符
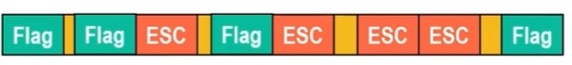
只需要将转义字符再转义一次即可
比特填充:发送发扫描数据载荷,每遇到5个连续的1就插入一个0,接收方扫描数据载荷,每发现5个连续的1+一个0就把0删除 恢复数据
- tip:HDLC、PPP 协议里,帧定界标志字段 Flag 统一规定:
01111110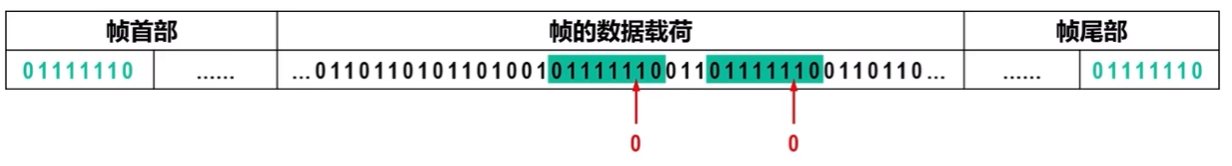

封装成帧和透明传输例题
习题1
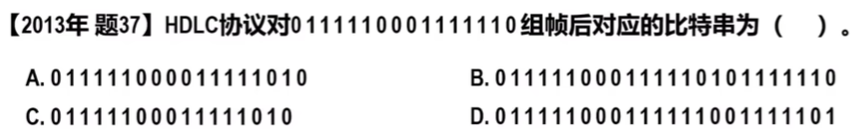
比特填充法:011111000011111010 标红的为填充的比特0 A
习题2
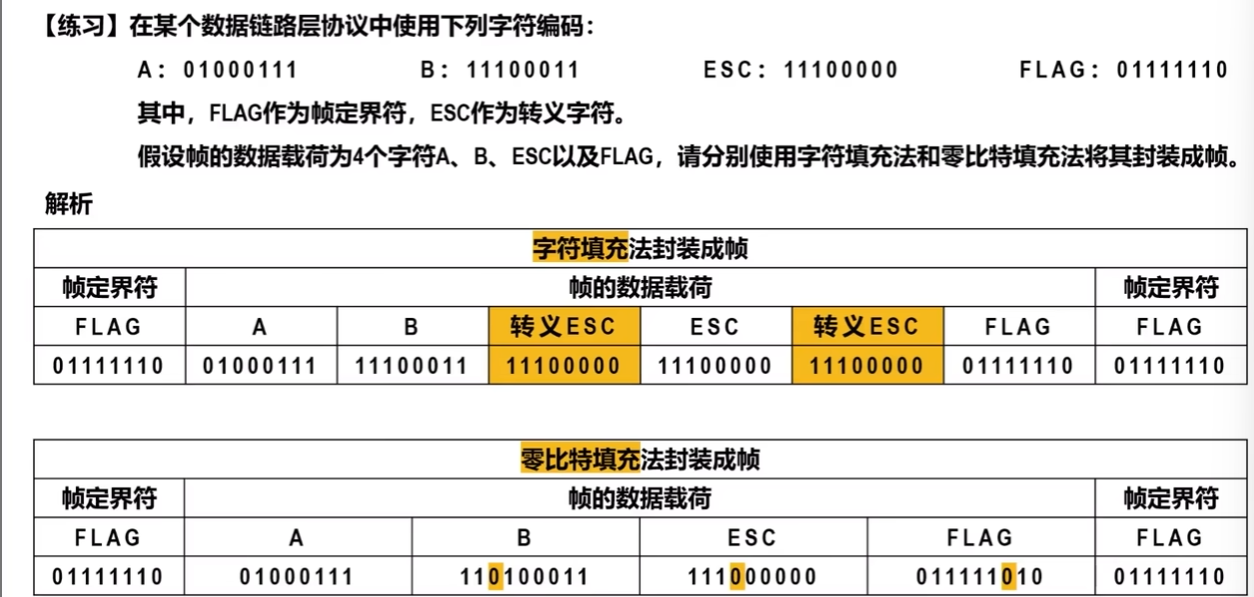
差错检测
概念
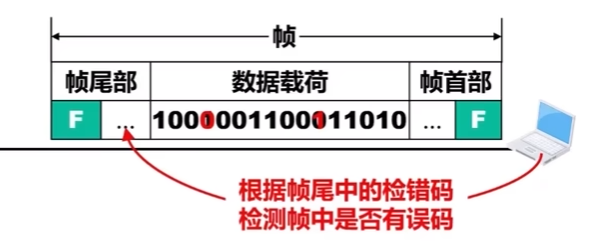
发送方先根据某种运算规则对传输的数据进行运算并生成检错码 接收方接收到后再根据相同规则算一遍,若是传输过程中出现了误码则算出来的结果会和帧内封装的原始检错码不同
误码的相关概念
实际通信电路不理想,传输过程中会出现比特差错(0变成1,1变成0)
在一段时间内,传输错误的比特数量占所传输比特总数的比率称为误码率(Bit Error Rate, BER)
提高链路的信噪比,可以降低误码率。但在实际的通信链路上,不可能使误码率下降为零。
使用差错检测技术来检测数据在传输过程中是否产生了比特差错,是数据链路层要解决的重要问题之一。
两种检测技术
奇偶校验
奇校验
在待发送的数据后面添加 1 个校验位,使得添加该校验位后的整个数据中比特1的个数为奇数
偶校验
在待发送的数据后面添加 1 个校验位,使得添加该校验位后的整个数据中比特1的个数为偶数
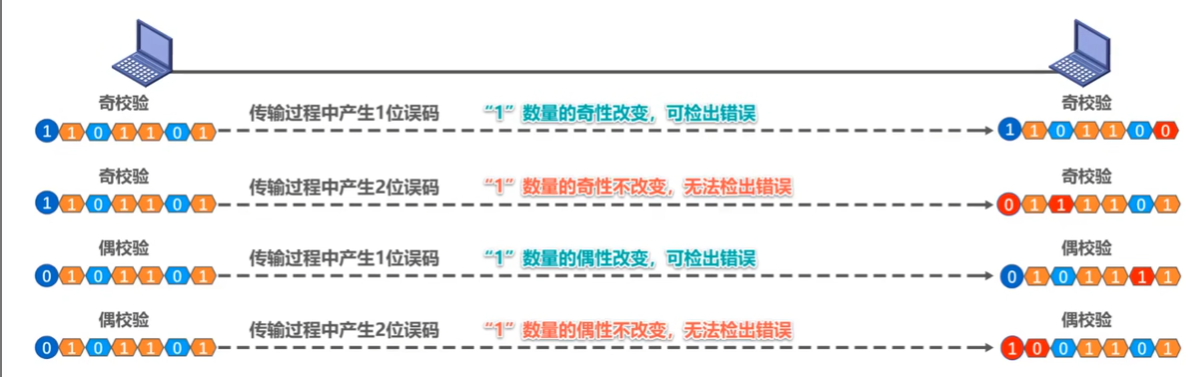
- 特点:只能检测奇数个比特错误,偶数个错误无法检出
循环冗余(Cyclic Redundancy Check,CRC)校验(使用多、漏检率低)
循环冗余校验 CRC 的基本思想
☐ 收发双方约定好一个生成多项式 G (X)。
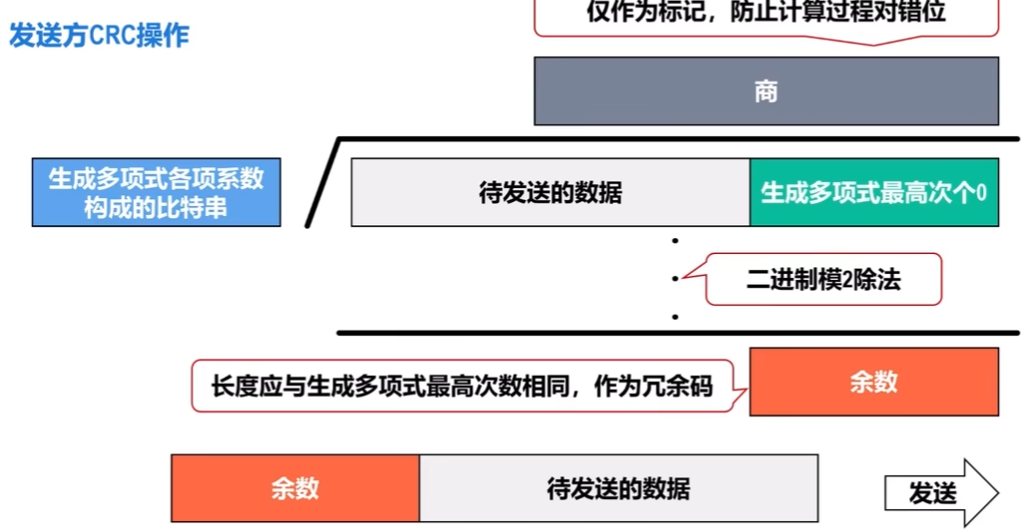
☐ 发送方基于待发送的数据和生成多项式 G (X),计算出差错检测码(冗余码),将冗余码添加到待发送数据的后面一起传输。
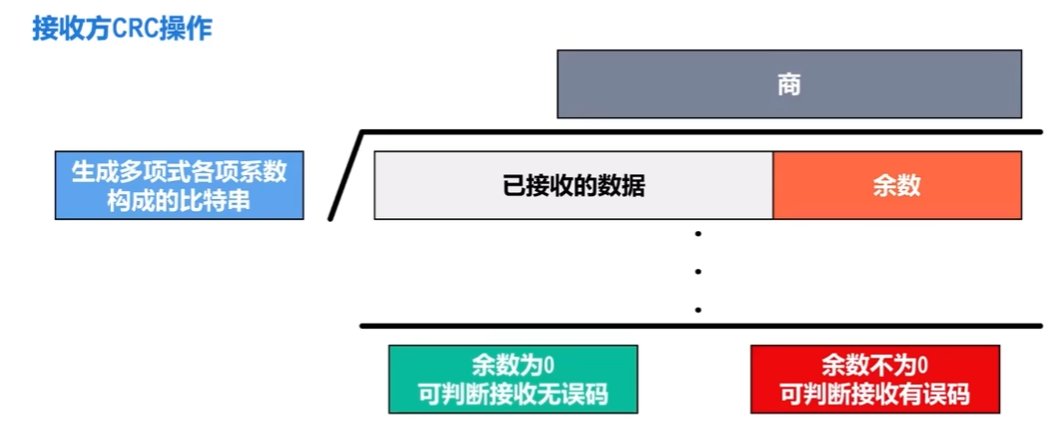
☐ 接收方收到数据和冗余码后,通过生成多项式 G (X) 来计算收到的数据和冗余码是否产生了误码。
示意图
发送方
接收方
生成多项式
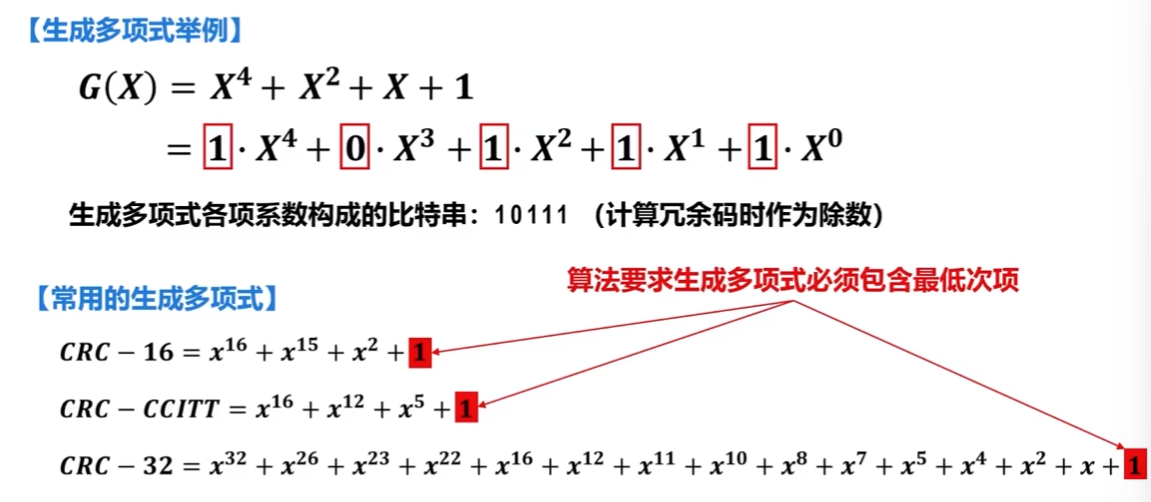
:star<例子>
待发送数据101001 生成多项式G(x) = x^3^+x^2^+1 –> 1100
由于生成多项式最高位是三次方 所以101001后加三个0 –> 101001000
二进制模2除法计算
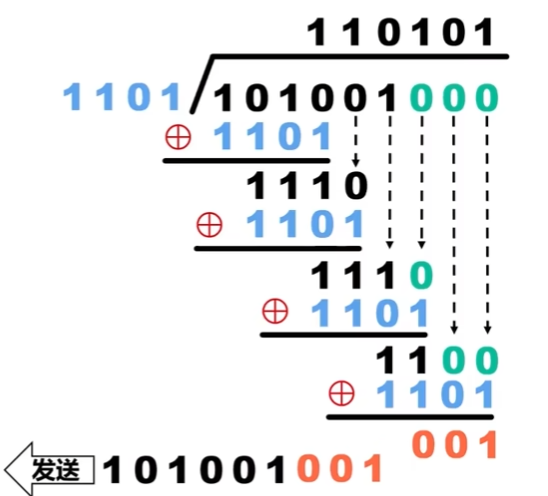
tip:冗余码长度也应当和生成多项式最高次相同 所以最后前面要补2个0
接收方接收到的数据是101101001 是否出现误码?
计算
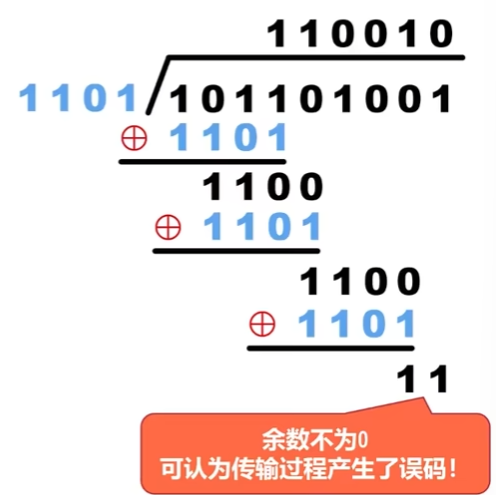
差错检测总结
奇偶校验、循环冗余校验等差错检测技术,只能检测出传输过程中出现了差错,但不能定位错误,因此无法纠正错误。
要想纠正传输中的差错,可以使用冗余信息更多的纠错码(例如海明码)进行前向纠错。但纠错码的开销比较大,在计算机网络中较少使用。
在计算机网络中,通常采用我们后续课程中将要介绍的检错重传方式来纠正传输中的差错,或者仅仅丢弃检测到差错的帧,这取决于数据链路层向其上层提供的是可靠传输服务还是不可靠传输服务。
循环冗余校验 CRC 具有很好的检错能力(漏检率极低),虽然计算比较复杂,但非常易于用硬件实现,因此被广泛应用于数据链路层。
可靠传输
可靠传输概念
不可靠传输:直接丢弃有误码的帧
可靠传输:当出现误码时接收方会发生一段否认帧给发送方请求发送方重新传输。
一般情况下,有线链路的误码率比较低。为了减小开销,并不要求数据链路层向其上层提供可靠传输服务。即使出现了误码,可靠传输的问题由其上层(TCP)处理。
无线链路易受干扰,误码率比较高,因此要求数据链路层必须向其上层提供可靠传输服务。
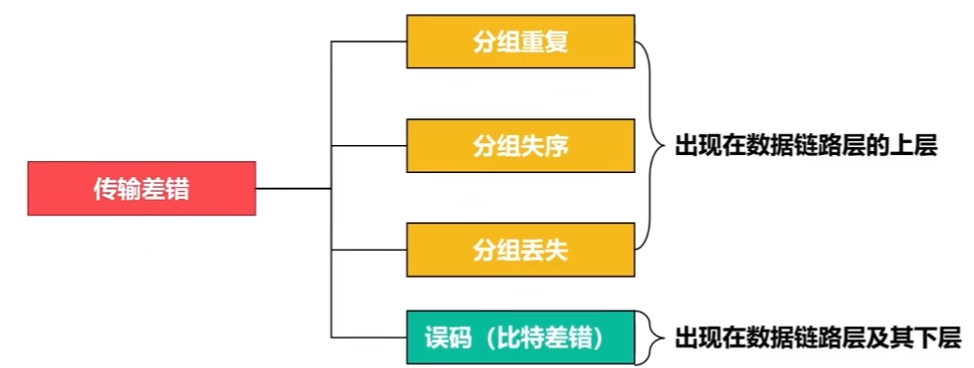
由上图可见,传输差错并不局限于数据链路层
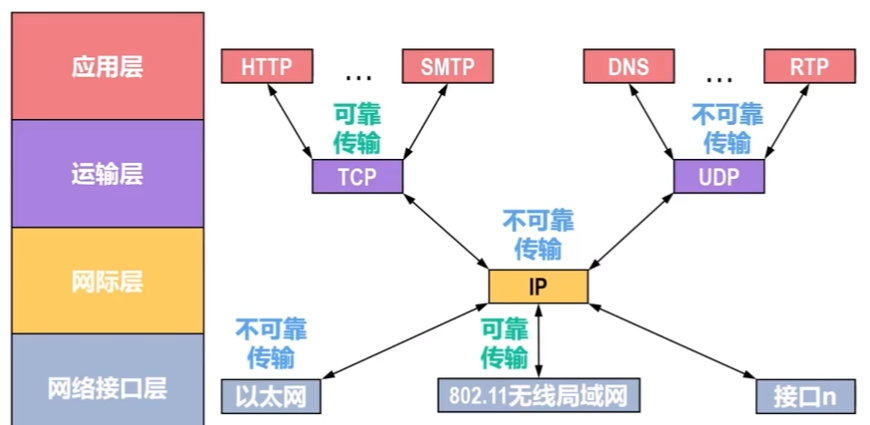
各个层的传输方式
实现可靠传输的三种协议
以下三种协议并不局限于数据链路层,只要是可靠传输都可以涉及这些协议
停止-等待协议(Stop-and-Wait , SW)
概念
发送方在发送完一个数据分组后会停止发送,等待接收方的反馈(确认分组/否认分组),若为确认分组则继续发送数据分组,若为否认分组则重新发送。所以发送方发送一个数据分组后不能立即将其从缓存中删除,需要在收到确认分组后才可删除
SW协议的各种情况即解决方法
正常情况
ACK是确认分组 NAK是否认分组
超时重传
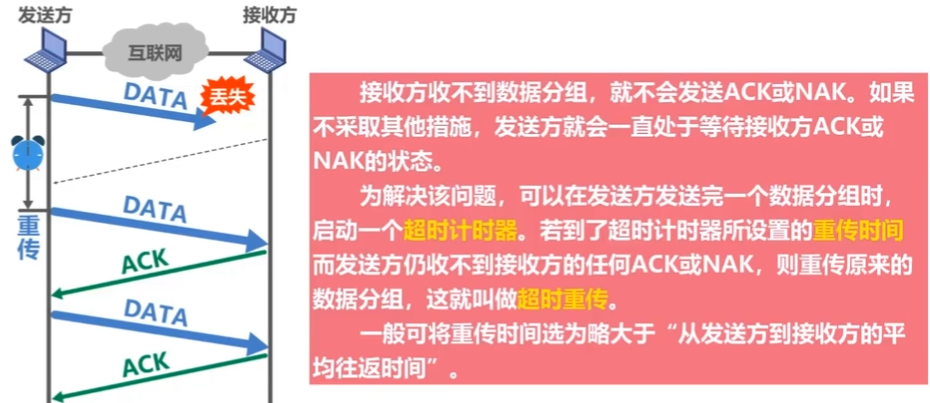
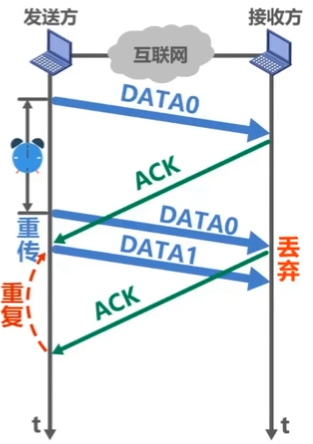
确认丢失,分组重复
即:接收方发送的确认分组丢失 –> 会导致发送方触发超时重传 重复传了两份数据
:star<解决方法>:提前对每个分组进行0/1编号 第一个为0第二个就是1… 如此间隔编号,如此编号后,若正常传输接收方收到的会是0101…这样间隔的编号 只要收到00 11这样的重复编号就说明分组重复了 此时只要丢弃即可
注意:丢弃重复数据后重传ACK
确认迟到,重复确认(不会在数据链路层出现)
确认没有丢失,但是迟到了(一次确认) –> 触发超时重传,重传数据被丢弃,再次发送确认(二次确认),如此就会导致重复确认,第二次确认会被认为是其他分组的确认
解决方法:对确认分组也进行0/1间隔编号即可
由图一可见,若不编号,出现重复确认时会将第二个确认认为是DATA1的确认(但实际上DATA1的确认还没到),这样会导致确认的顺序乱掉;由图二可见 为确认0/1间隔编号后即可知重复确认并丢弃
SW协议的信道利用率
信道利用率概念
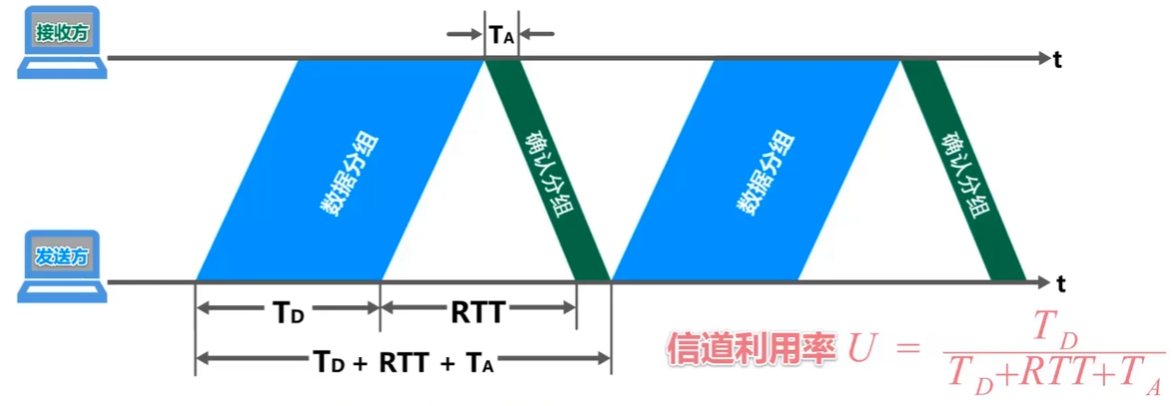
发送一个分组到下一个分组所用时间=数据发送时间+传输时间+确认发送时间+传输时间
其中传输时间可以表示为往返时间RTT
T
总=TD+RTT+TA其中只有TD用于发送所需传输数据 信道利用率U= TD/T总信道利用率分析
T
A一般远小于其他两者可以忽略,所以当RTT>>TD时信道利用率会低 反之则高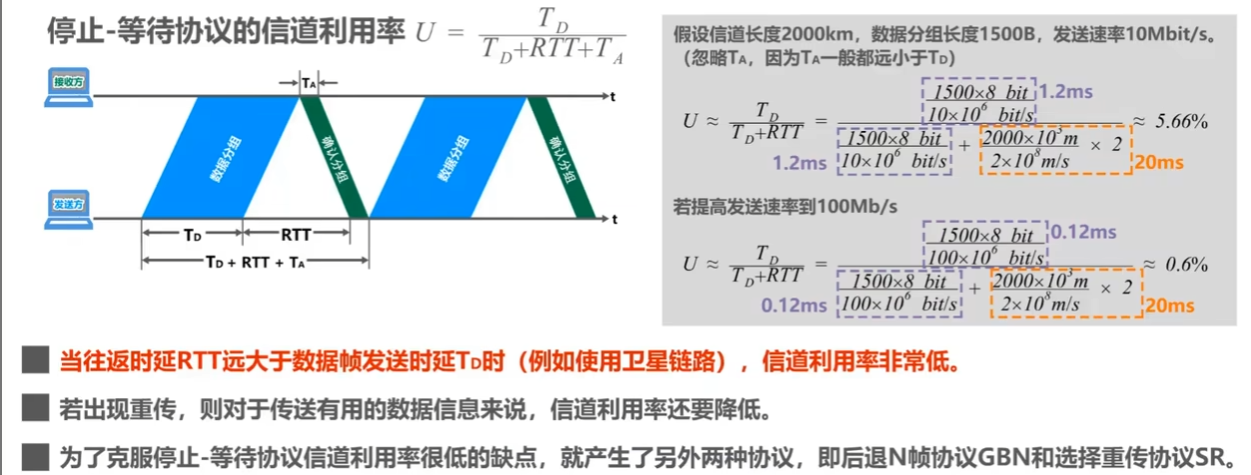
tip:传输是在传输媒体内传输,其速度恒等于电磁波在传输媒体内的速度。而发送时间T
D的速度与带宽大小有关
SW习题
习题
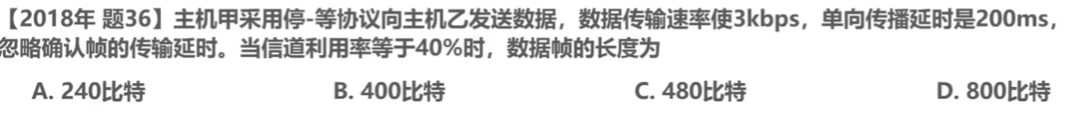
U=T
D/TD+RTT RTT=2*200=400ms U=0.4 –> TD=160/0.6=n/3 –> n=800bit D
回退N帧协议 (Go-back_N , GBN)
在等待接收方的确认分组前发送多个数据分组,GBN协议中会有一个发送窗口来控制一次最多发送几个分组,接收方也会有一个接收窗口,但接收窗口一次只能接收一个
示意图
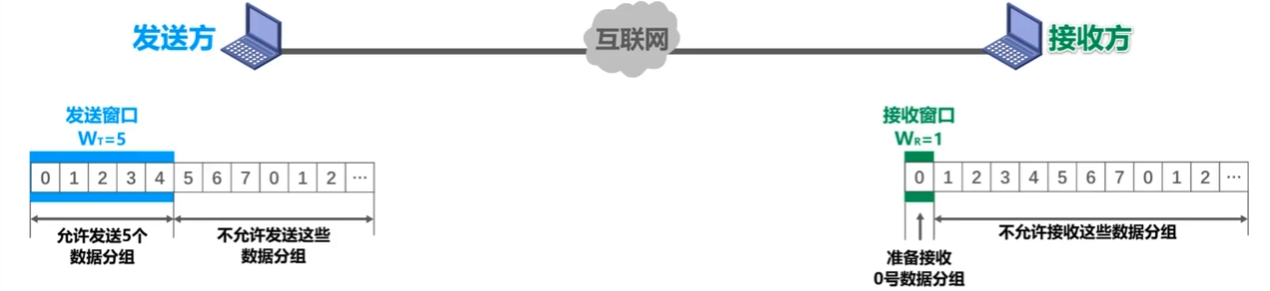
- :star2<规则>
- 采用3个比特给分组编序号,即序号0~7;(n也可以取其他值)
- **发送窗口的尺寸**的取值:,本例取 (若W
T超过上限会导致接收方无法分辨新旧分组)- **接收窗口的尺寸**的取值:;
GBN协议的各种情况及解决方法
正常情况
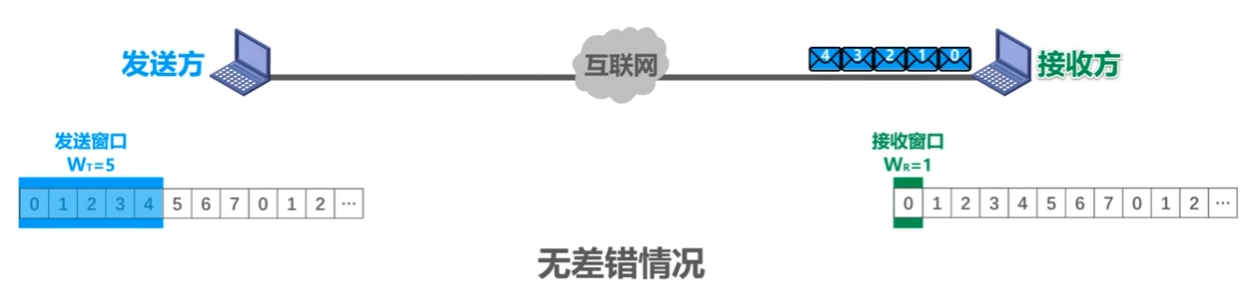
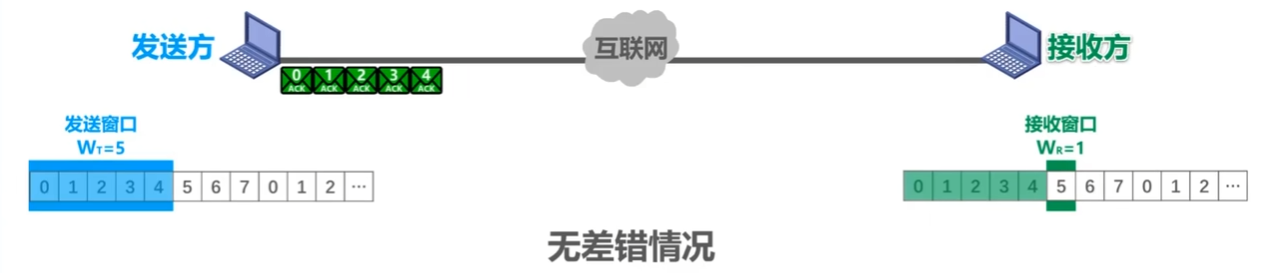
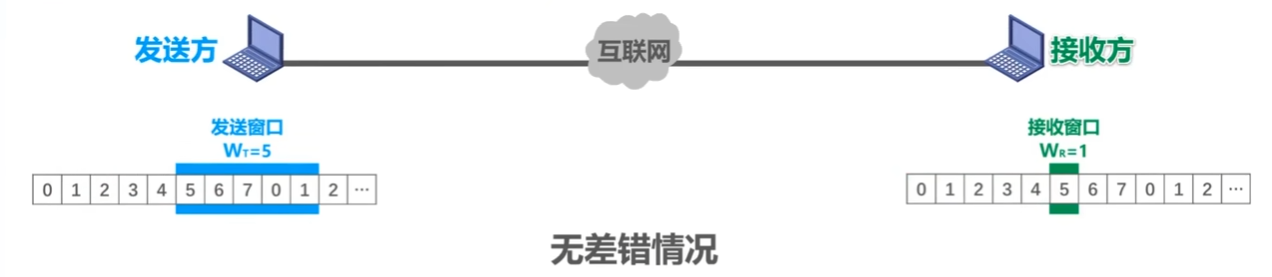
过程
- 发送方依次将窗口内的分组发送出去
- 接收方依次接收分组,每接收一个分组窗口向后滑动一个并向发送方依次传输每个分组的确认分组
- 发送方每接收到一个分组后窗口就向后滑动一格,使新分组进入窗口,当接收完后就可以将出窗口的分组从缓存中删除 tip:接收方择机将接收到的数据分组传输给上层
累积确认
累积确认是对于接收方发送确认分组的优化,即:当接收方接收到连续的分组数据时,只需要发送最后一组数据的确认分组即可 如:接收到1,2,3 只需要ACK3,代表3之前的分组都已经被正确接收了
累积确认的优点
即使部分分组确认丢失,发送方也可能不必重传
如:发送方发送0
4五组分组数据,接收方接收到0,1后发送一个ACK1 接收2,3,4后发送一个ACK4 若在传输过程中ACK1丢失 ACK4没丢失,也可以正确地表示04号分组都成功接收差错情况
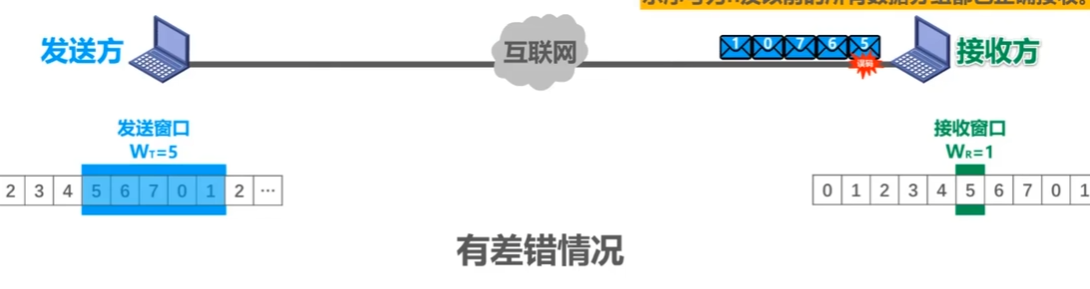
如上图,56701这五个数据分组,5出现了误码会被接收方丢弃,由于后面的6701都无法和接收窗口中的5对上,所以6701都会被丢弃掉。由于有4个分组没有匹配上,所以接收方会发送4个ACK4(即当前窗口前的那个分组序号)
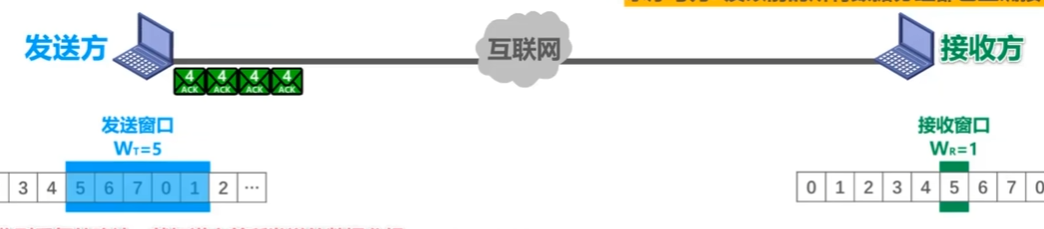
发送方收到重复的确认,就知道之前所发送的数据分组出现了差错,于是可以不等超时计时器超时就立刻重传!
至于收到几个重复确认就立刻重传,由具体实现决定。
总结
本例中6701因为5的误码被牵连,导致发送方需要重传5个分组,这就被称为回退n帧
W
T<=最大序号的原因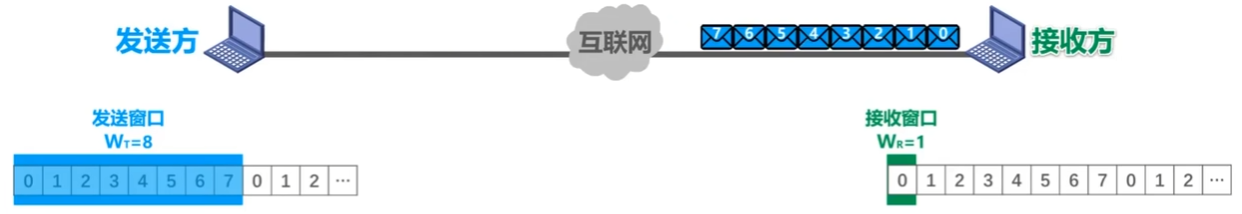
假设最大序号为7 W
T为8 若接收方成功接收0 ~ 7的序号,但是ACK丢失,这会导致发送方的重传,由于序号是0 ~ 7的重复复用 ,发送方重传后的序号刚好和接收方窗口的值还是一一对应的,这就导致了接收方无法分辨新旧数据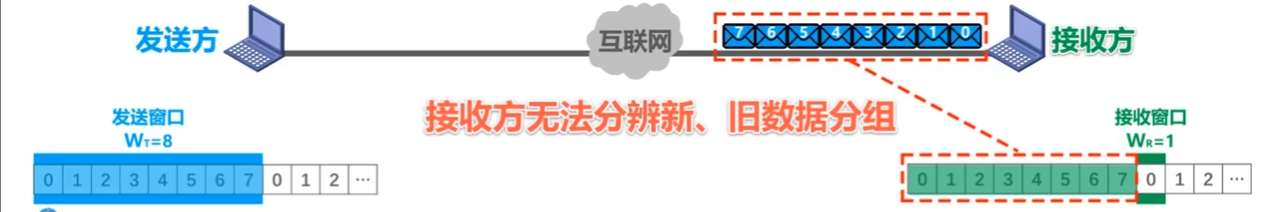
GBN习题
习题1

接收到3号帧的确认就意味着0 ~ 3都已经成功接收 重发4~7 四个分组 C
选择重传协议 (Selective Repeat , SR)
SR协议是对GBN协议的优化。GBN协议中接收窗口的尺寸恒为1,这样子一个分组误码,其后分组也会被牵连丢弃。为了进一步提高性能,可设法只重传出现误码的数据分组。因此,接收窗口的尺寸Wₙ不应再等于1(而应大于1),以便接收方先收下失序到达但无误码并且序号落在接收窗口内的那些数据分组,等到所缺分组收齐后再一并送交上层。这就是选择重传协议。
注意: 选择重传协议为了使发送方仅重传出现差错的分组,接收方不能再采用累积确认,而需要对每个正确接收到的数据分组进行逐一确认!
工作原理
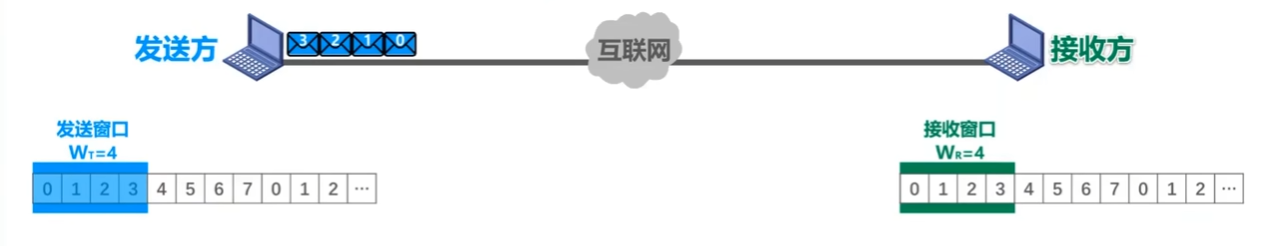
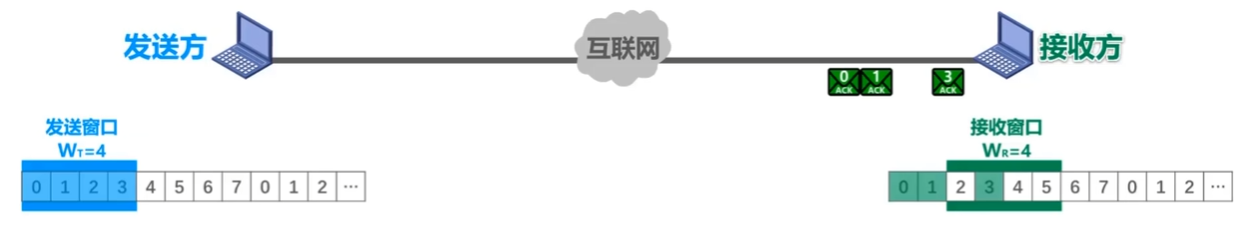
如图所示,发送方发送0123分组 其中2分组丢失(或因误码被丢弃**【tip:GBN/SR中没有NAK】**),那么接收方会接收3 01 传回ACK0/1/3 并向前滑动两格 (此时01可以被传输给上层了)
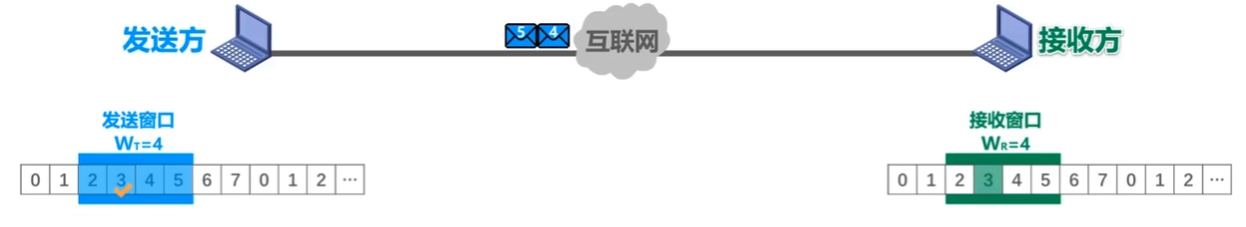
当发送方接收到ACK0/1/3后会向前滑动两格 此时01出了窗口 45进了窗口**(此时01就可以从换从中删除了)** 但此时ACK2还没有接收到(假设还未超时) 发送方会将45分组发送出去
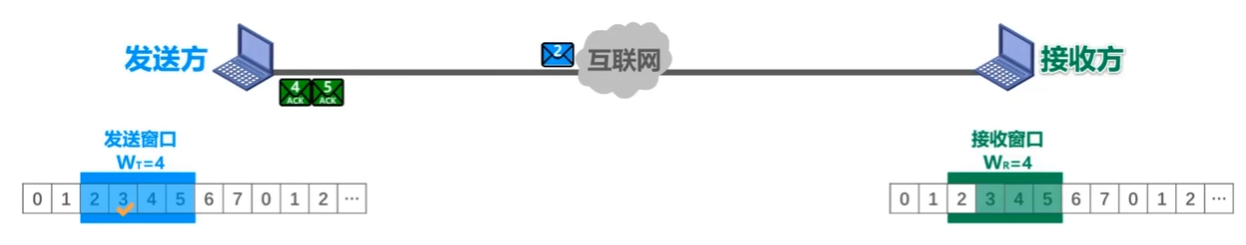
接收方成功收到45分组并传回ACK4/5 假设此时分组2超时,发送方进行重传
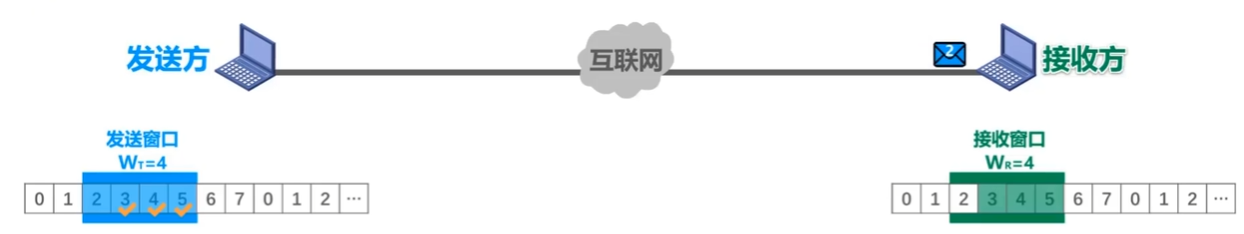
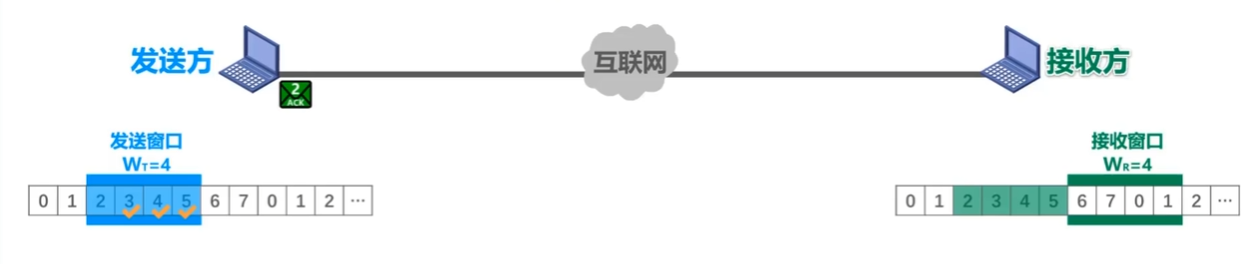
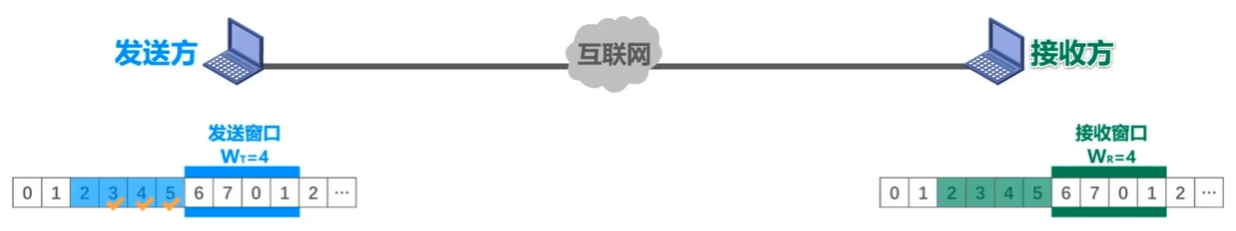
ACK4/5先到达了发送方,先对45进行标记,当分组2到达接收方时接收方窗口内都接收到了 向前滑动4格并传回ACK2 等到发送方接收到ACK2后即可向前滑动
- 视频详解2-7min
窗口尺寸要求
发送窗口W
T若W
T= 1:则与SW协议相同若W
T> 2^n-1^:会造成接收方无法分辨新旧数据 详见接收窗口W
R若W
R=1:则与回退N帧协议相同若W
R>WT<会造成接收方无法分辨新旧数据>为何W
R>WT也会造成新旧数据无法分辨的情况?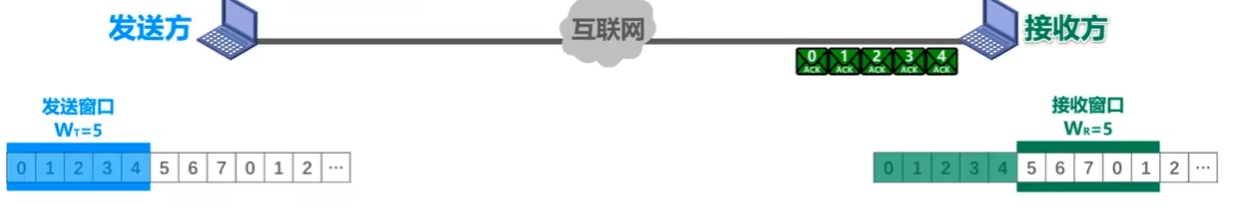
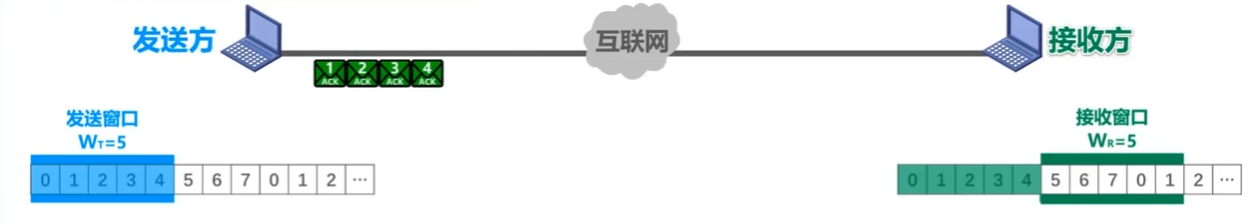
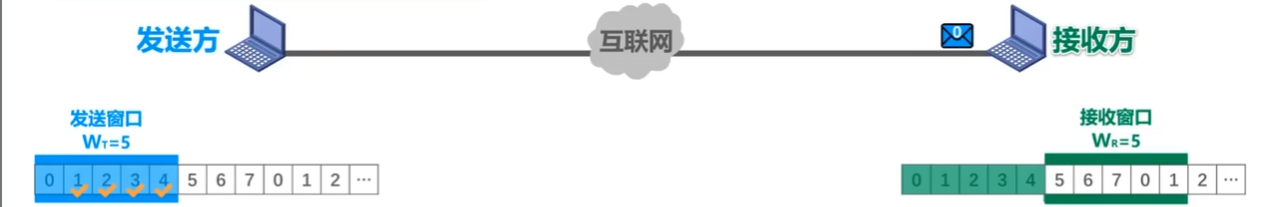
由上三图可知,当01234成功被接受后接收窗口会滑动,把新一轮的0包括进来。假设ACK0在传输过程中丢失,触发超时重传后会重新发送分组0,此时传的数据0是旧数据,但是接收方滑动窗口内的0是新一轮的0
SR习题
习题
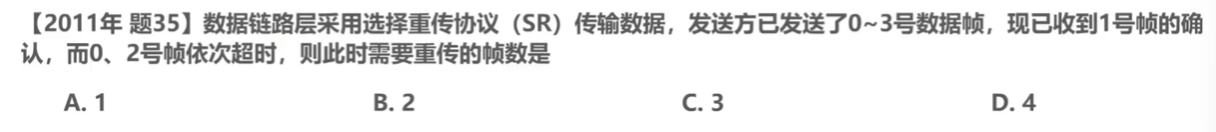
SR协议逐个检查,不能使用累积计数 发送了0123 只收到ACK1 0、2超时 所以**此时(3号帧的状态不明确,可能ACK3还没有收到)**只需要重传0、2 B
3.点对点PPP协议
简介
点对点PPP(Point to Point Protocol)协议
作用
PPP协议为点对点链路传输各种协议数据报提供了一个标准方法,主要分为以下三部分
- 对各种协议数据报的封装方法**(封装成帧)**
- 链路控制协议LCP — 用于建立、配置以及测试数据链路的连接
- 一套网络控制协议NCPs — 其中的每一个协议支持不同的网络层协议
PPP协议的帧格式
- 标志(Flag)字段:PPP帧的**定界符**,取值为**0x7E(01111110)** - 地址(Address)字段:取值为0xFF,**预留**(目前没有什么作用) - 控制(Control)字段:取值为0x03,**预留**(目前没有什么作用) - 协议(Protocol)字段:**指明**帧的**数据部分送交哪个协议处理** - 取值0x0021表示:帧的数据部分为**IP**数据报 - 取值0xC021表示:帧的数据部分为**LCP**分组 - 取值0x8021表示:帧的数据部分为**NCP**分组 - 帧检验序列(**F**rame **C**heck **S**equence)字段:CRC计算出的校验位
PPP帧的透明传输
面向字节的异步链路1:采用字节填充法(转义字符)
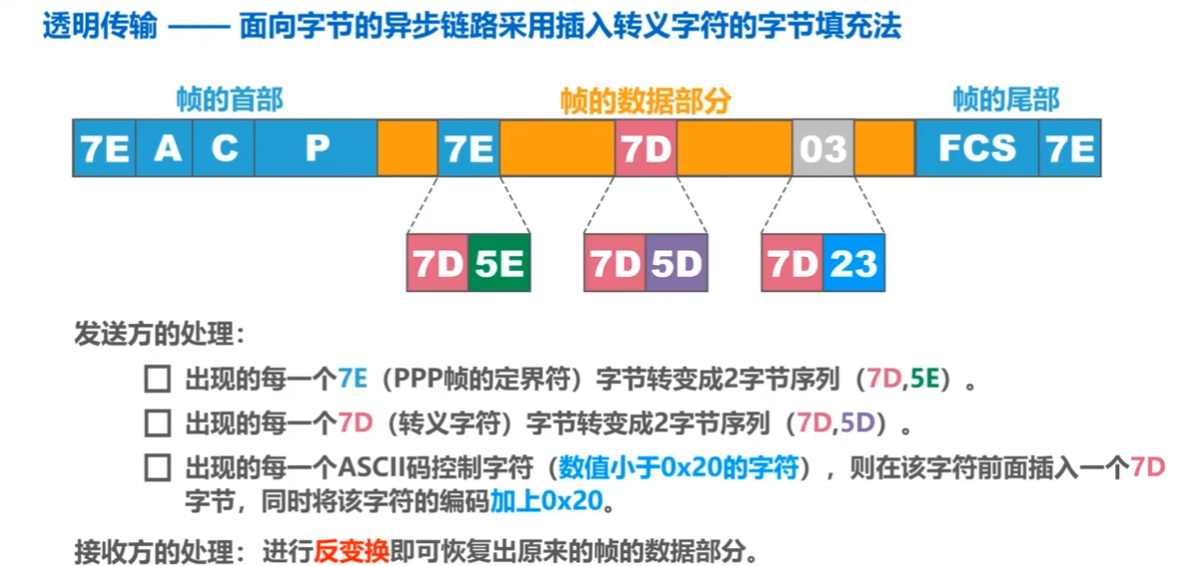
- 标志的转义
- 在标志前加转义字符(7D)
- 标志字符-0x20(7E-20=5E)
- 转义的转义
- 转义前加转义(7D)
- 转义字符-0x20(7D-20=5D)
- 转义控制字符(十六进制小于0x20的字符)
- 控制字符前加转义(7D)
- 转义字符+0x20
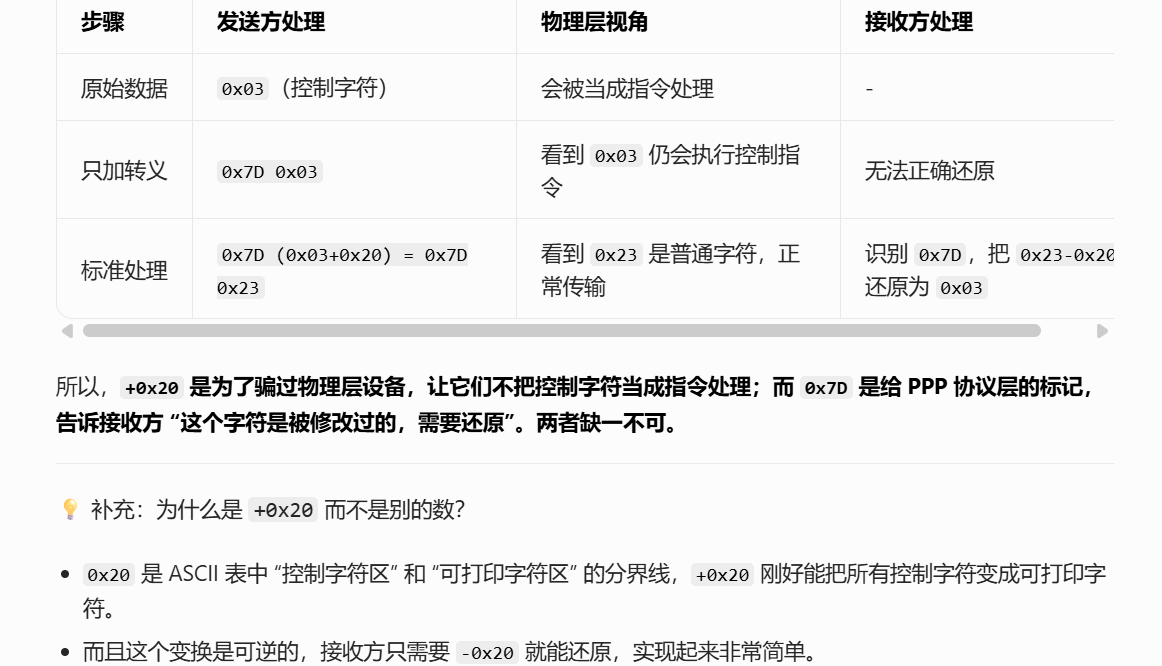
由此图可知,加转义是为了防止数据链路层的误认,对数据进行+/-0x20的操作是为了“骗过”物理层
面向比特的同步链路2:采用比特填充法(在连续5个1后填0)
比特填充法无补充,详见 透明传输中的比特填充法。
tip:比特填充法既实现了不引起歧义,又可以通过物理层,所以不需要进行额外操作
补充:两种透明传输方法详见
对于同步异步传输 详见
PPP帧的差错检测
采用循环冗余(Cyclic Redundancy Check,CRC)校验,详见 差错检测中的CRC部分
补充
使用的生成多项式
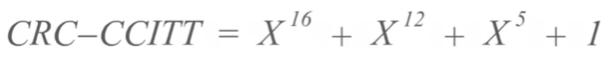
为节省CRC检验的时间开支,PPP协议中使用了查表法,传统方法计算时要一个比特位一个比特位计算,查表法预先计算好一个字节(8个比特位)对应的CRC余数,共256个可能,数据传过来后直接查表 再一个字节一个字节运算 快了8倍
PPP协议使用的是不可靠传输协议,数据误码直接丢弃
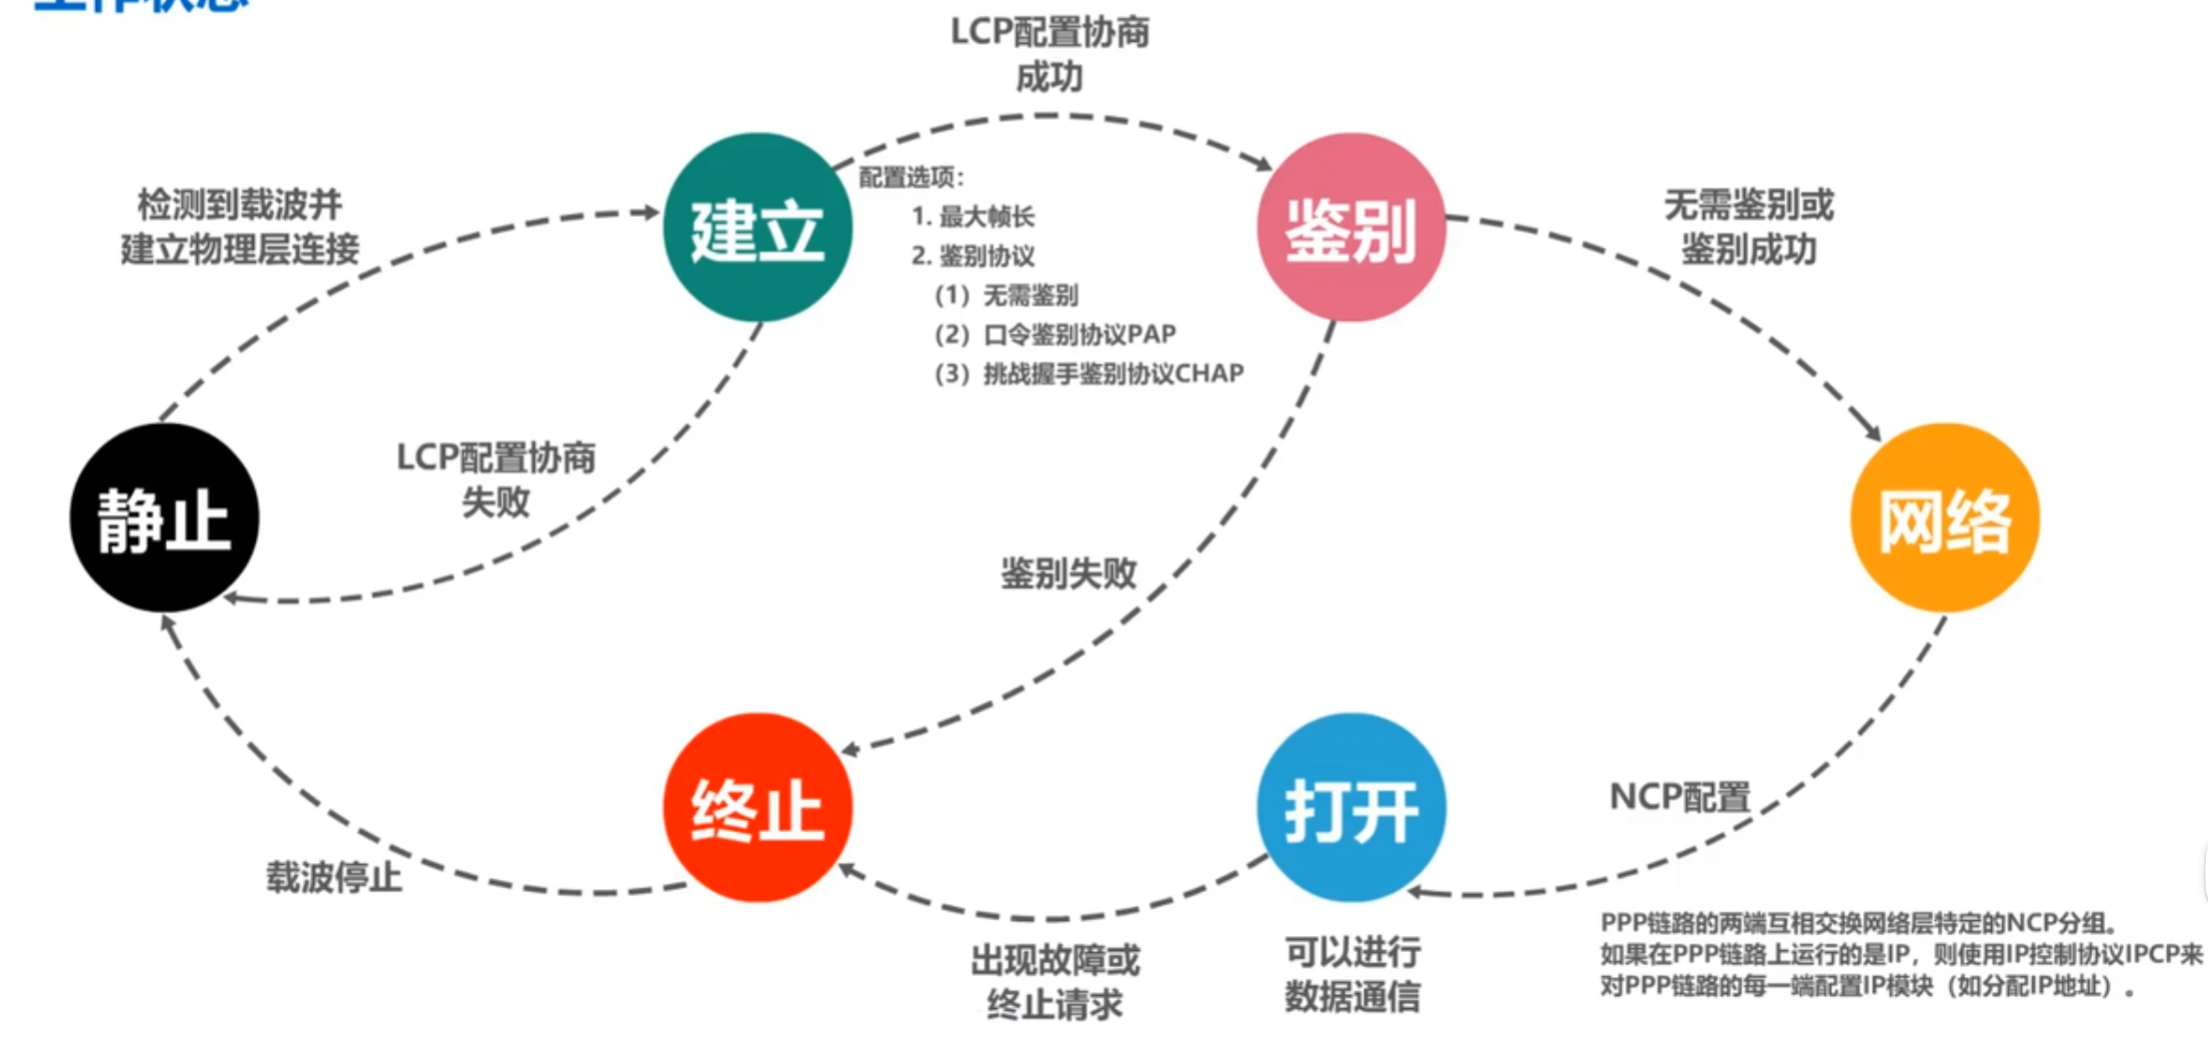
PPP协议的工作状态
- 示意图
- 解释
- PPP协议的始末状态都是静止
- 当收到物理层信号后进行**LCP配置协商(确定PPP所携带的参数)**以建立PPP协议
- 创立PPP协议后发送至目标主机,发送到后双方主机会进行鉴别,鉴别依靠的是建立阶段所确立的鉴别协议, 口令鉴别/握手鉴别
- 鉴别失败进入终止状态,鉴别成功后需要NCP配置与网络层连接。(NCP 与网络层交互,协商网络层所需参数,让网络层可以正确识别、接收、处理从 PPP 链路上交上来的数据。)
- 成功进行NCP配置后进入打开状态,使得两端主机可以进行数据通信。 当出现故障/终止请求后进入终止状态
- 当物理层的信号停止后重新进入静止状态
4.共享式以太网
不同于PPP的远距离传输,以太网用于局域网内部通信
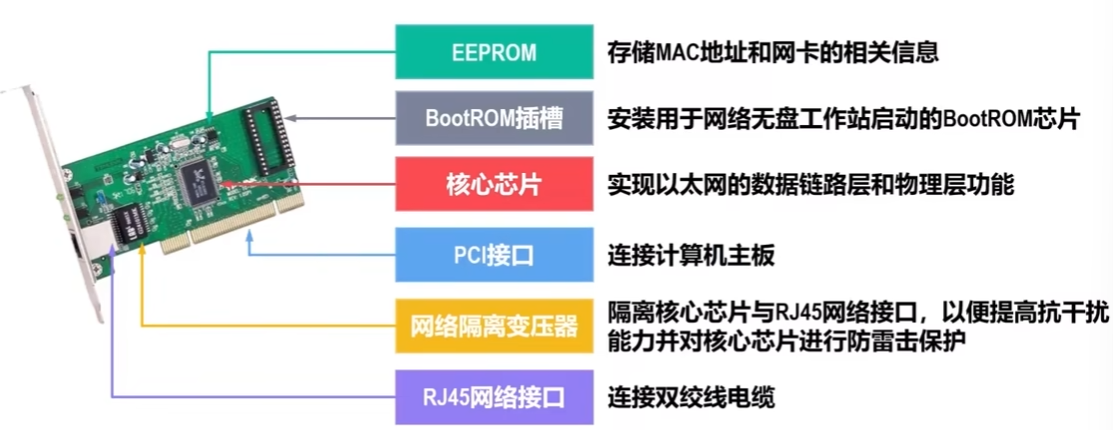
网络适配器(网卡)
要将计算机接入**以太网(局域网)**需要用到相应的网卡。
在计算机内部,网卡与CPU之间的通信,一般是通过计算机主板上的I/O总线以并行传输方式进行。
网卡与外部以太网(局域网)之间的通信,一般是通过传输媒体(同轴电缆、双绞线电缆、光纤)以串行方式进行的。
网卡除要实现物理层和数据链路层功能,其另外一个重要功能就是要进行并行传输和串行传输的转换。由于网络的传输速率和计算机内部总线上的传输速率并不相同,因此在网卡的核心芯片中都会包含用于缓存数据的存储器。
在确保网卡硬件正确的情况下,为了使网卡正常工作,还必须要在计算机的操作系统中为网卡安装相应的**设备驱动程序。**驱动程序负责驱动网卡发送和接收帧。
MAC地址
简介
对于点对点的PPP协议而言,只有两个设备在信道两端进行信息交流所以不需要地址
而对于以太网(局域网),在总线上连接了多个站点,需要用MAC地址来辨别是谁发给谁的信息
示意图
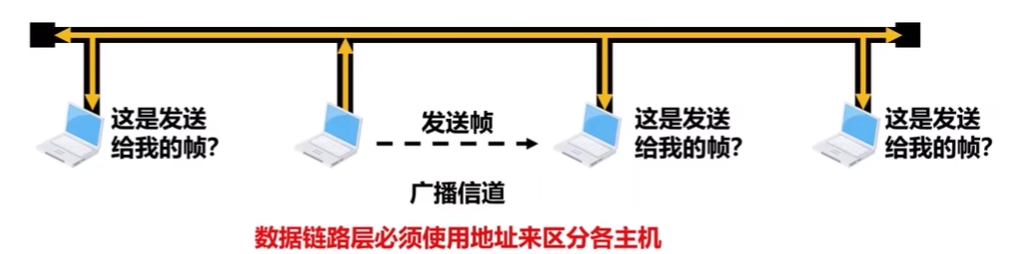
当多个主机连接在同一个广播信道上,要想实现两个主机之间的通信,则每个主机都必须有一个唯一的标识,即一个数据链路层地址。
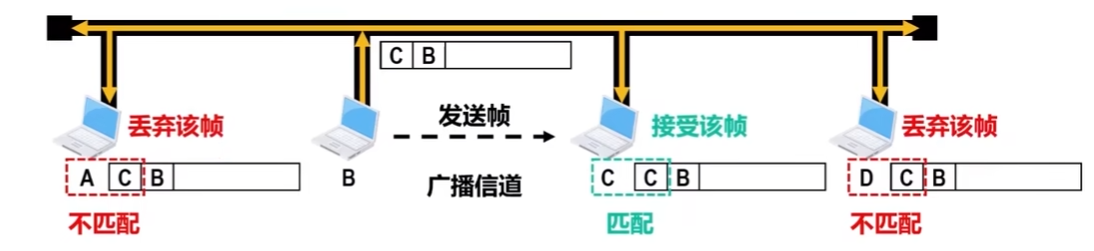
在每个主机发送的帧的首部中,都携带有发送主机(源主机)和接收主机(目的主机)的数据链路层地址。由于这类地址是用于媒体接入控制(Medium Access Control, MAC)的,因此被称为 MAC 地址(又称物理地址)。
简述
一般情况下,普通用户计算机中往往会包含两块网卡:
- 一块是用于接入有线局域网的以太网卡
- 另一块是用于接入无线局域网的Wi-Fi网卡
每块网卡都有一个全球唯一的MAC地址。
交换机和路由器往往具有更多的网络接口,所以会拥有更多的MAC地址。 综上所述,严格来说,MAC地址是对网络上各接口的唯一标识,而不是对网络上各设备的唯一标识。
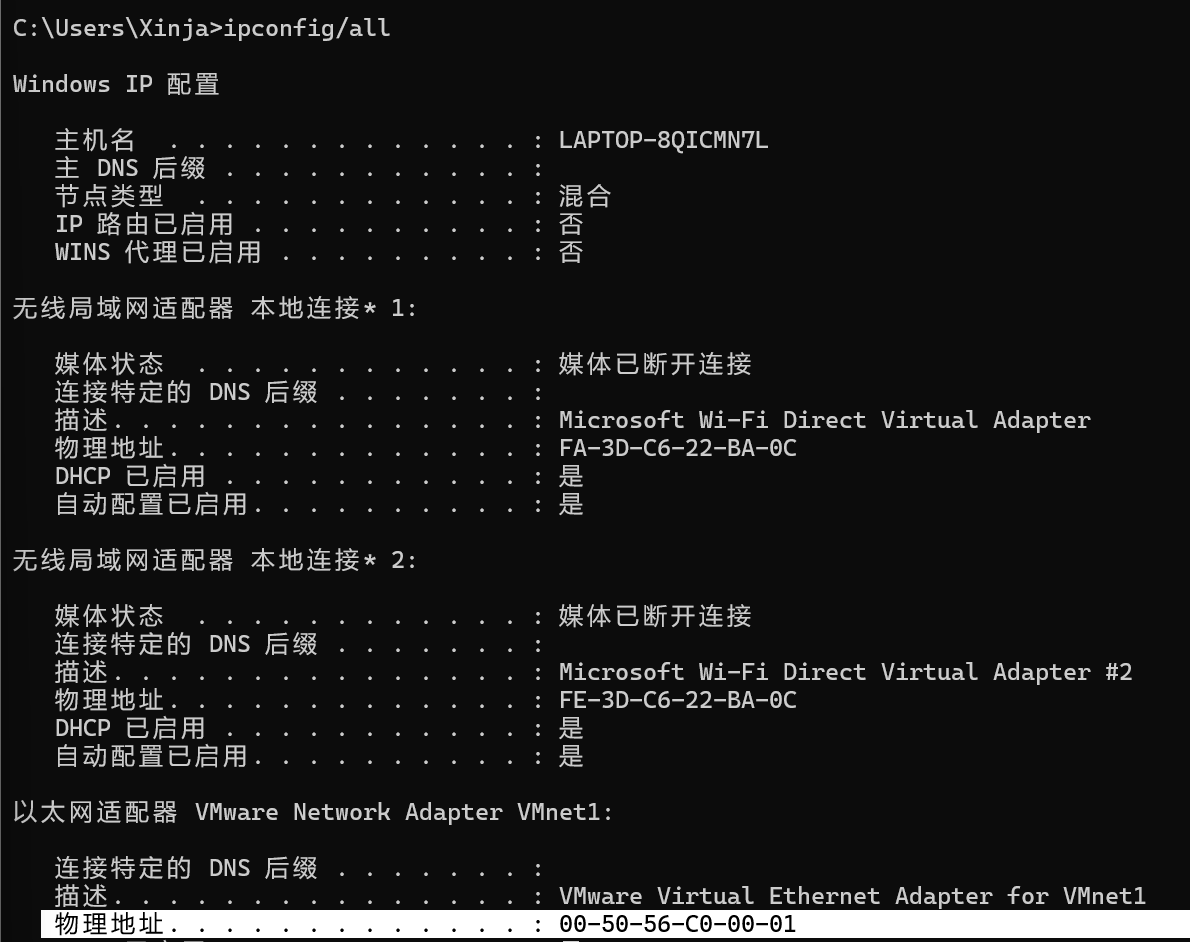
IEEE标准的MAC格式
MAC地址的分配
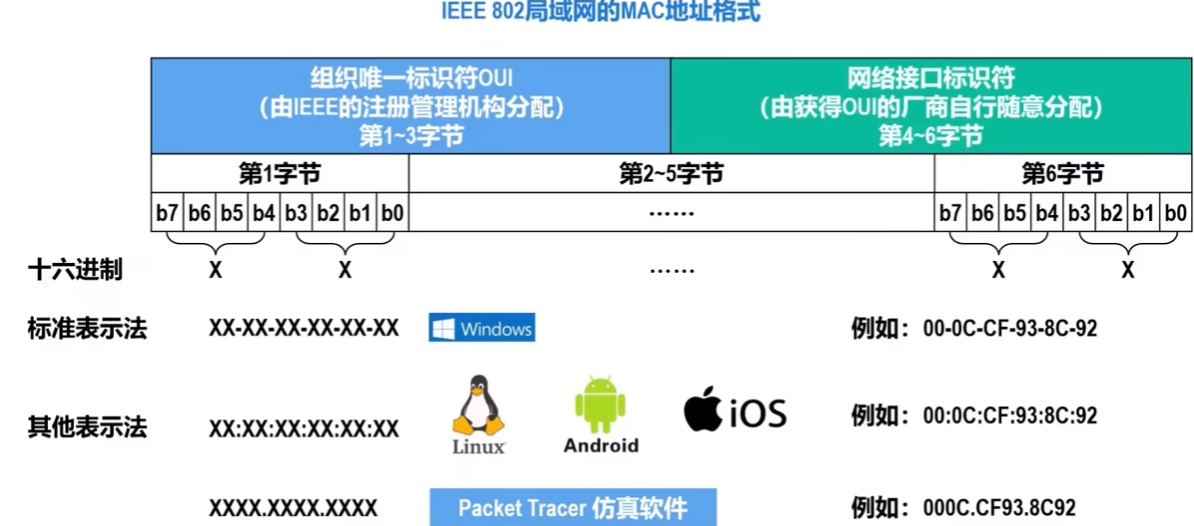
1-3为由IEEE管理机构分配给各公司/组织
MAC地址细解
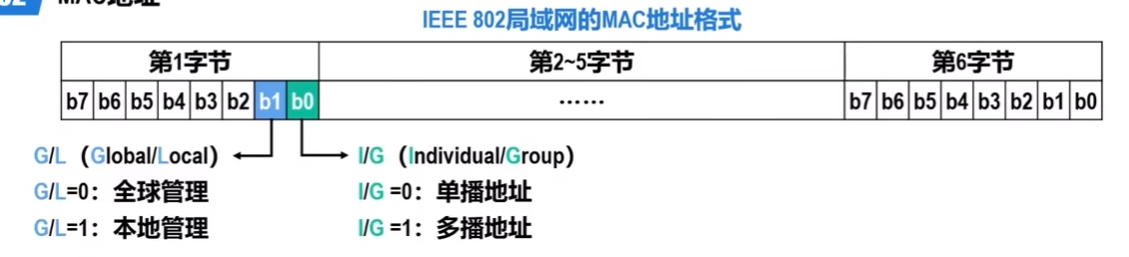
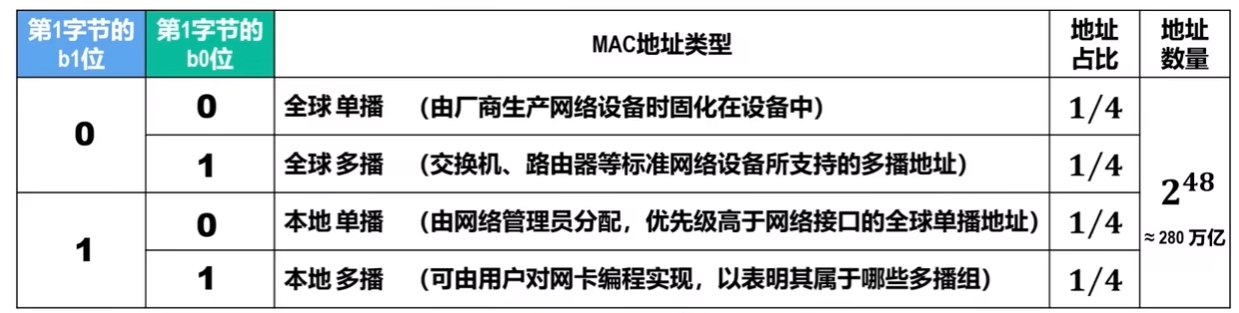
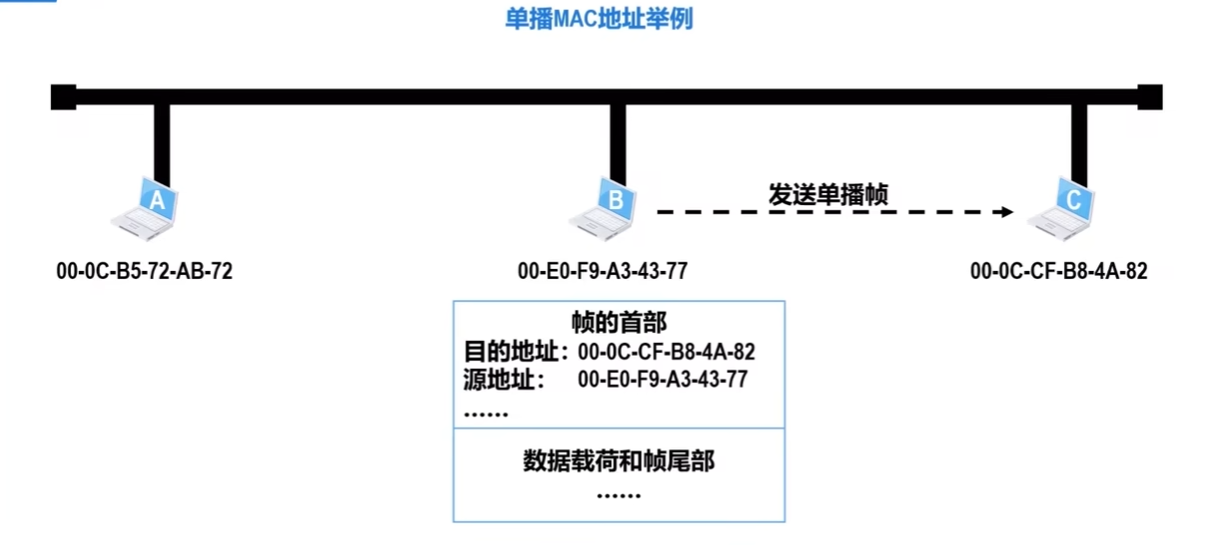
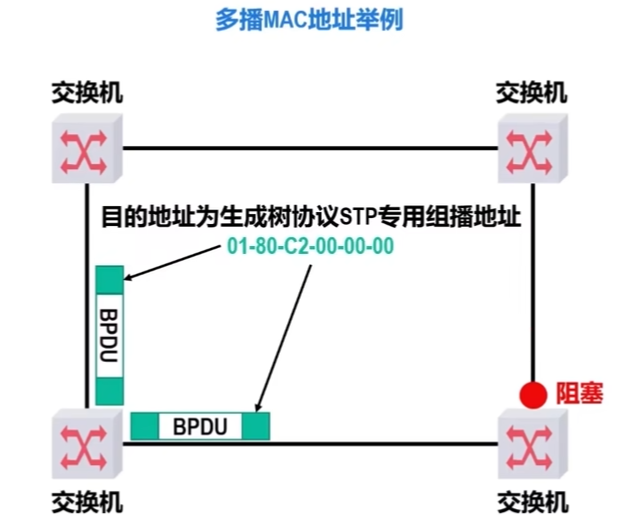
单播表示数据只发给某个特定的设备(一对一传输文件)
多播表示数据会发送给多播组内的所有设备(直播)
全球管理的OUI由IEEE统一发布
本地管理的OUI由局域网内的管理者自由分配
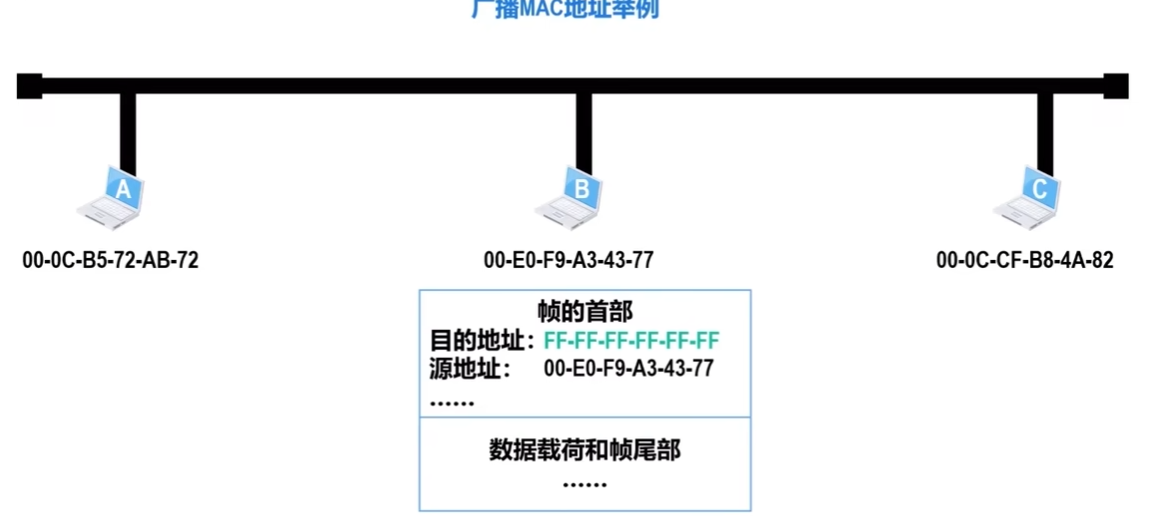
广播是本地多播的特例,目标 MAC 地址是
FF:FF:FF:FF:FF:FF,I/G位也是 1,会发给局域网内所有设备。单播MAC地址举例
广播MAC地址举例
多播MAC地址举例


CSMA CD协议基本原理
简介
问题
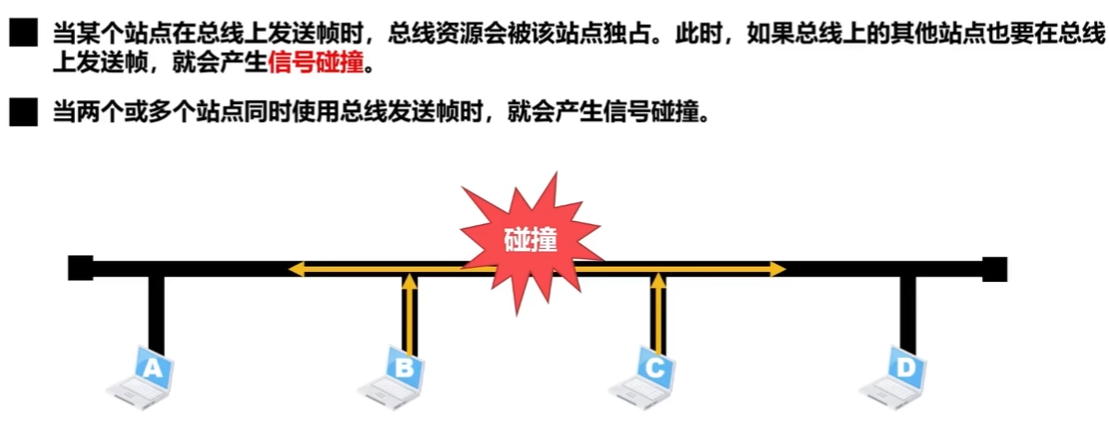
为了解决各站点争用总线的问题,共享总线以太网使用了一种专用协议CSMA/CD,即载波监听多路访问/碰撞检测(Carrier Sense Multiple Access Collision Detection)
多址接入MA
多址接入即为上述问题的概述
载波监听CS
每个站点在发送帧之前,先要检测一下总线上是否有其他站点在发送帧(“先听后说“)
- 若检测到总线空闲96比特时间(发送96比特所耗费的时间,也称为帧间最小间隔),则发送这个帧
- 若检测到总线忙,则继续检测并等待总线转为空闲96比特时间,然后发送这个帧。
碰撞检测CD
每个正在发送帧的站点边发边检测碰撞(”边听边说“)
- 一旦发现总线上出现碰撞,立即停止发送,避退一段随机时间后再次从载波监听(CS)开始发送(“在说的过程中检测,一旦冲突立即听说,等待时机,重新再说”)
演示
示例
MA
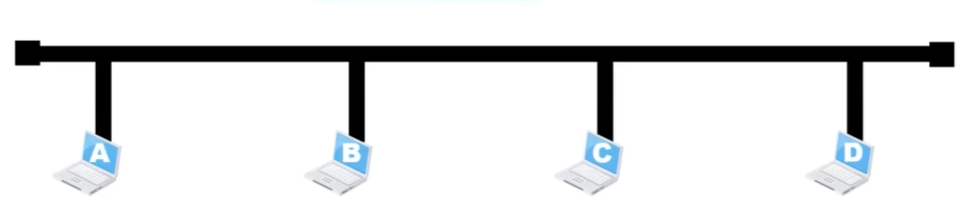
CS
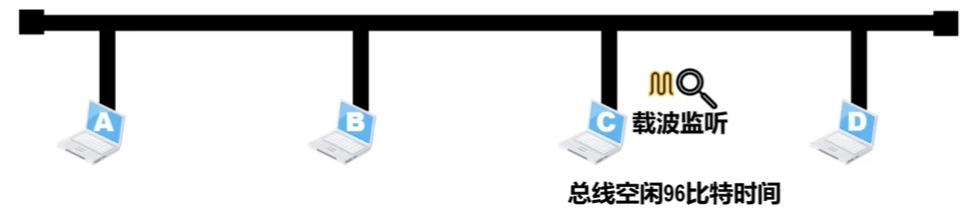
C进行载波监听,检测到总线空闲96bit时间,发送帧
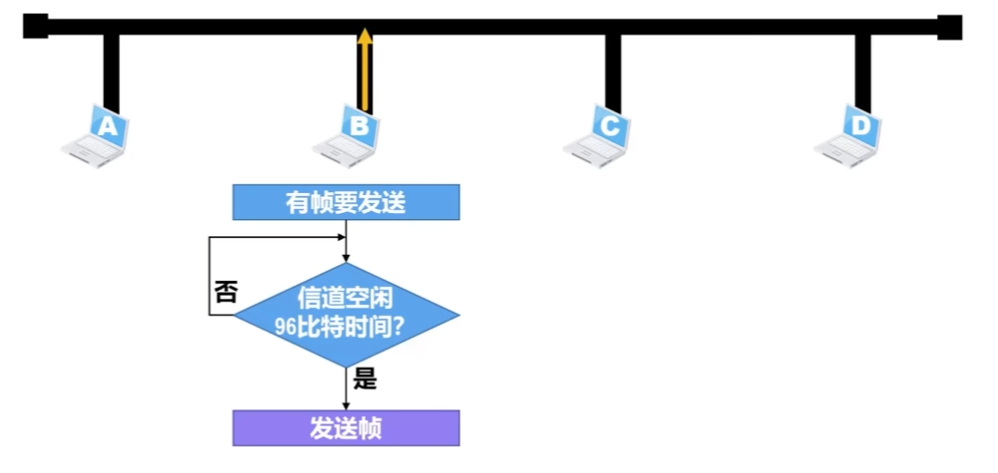
假设在C发送的过程中B也要发送,则B会一直进行载波监听,直到C发送完,也就是信道空闲96bit时间后再发送帧。
CD
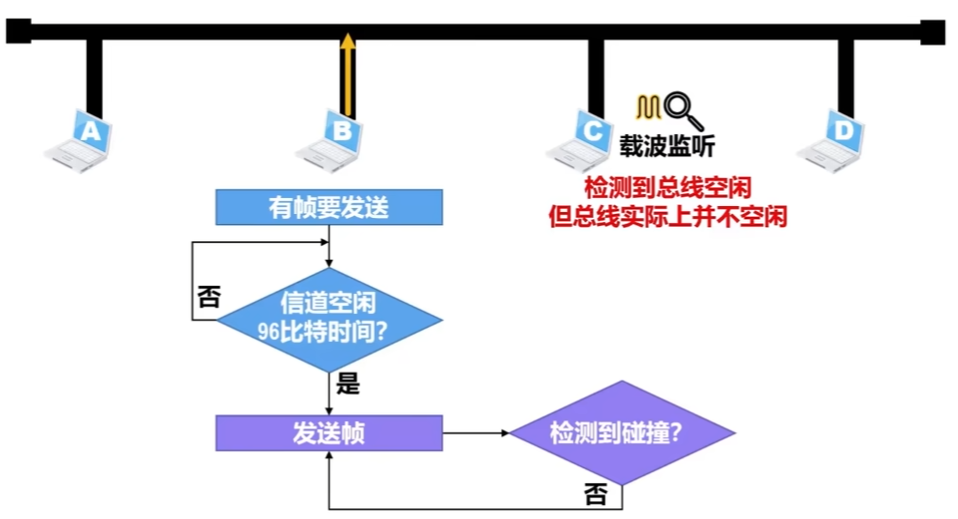
假设B、C几乎同时发送帧(B略快于C),B过了CS后发送帧进入了CD(检测碰撞)状态,由于B的信息还没传送到C处,所以C进行CS后检测到信道空闲,也发送了帧
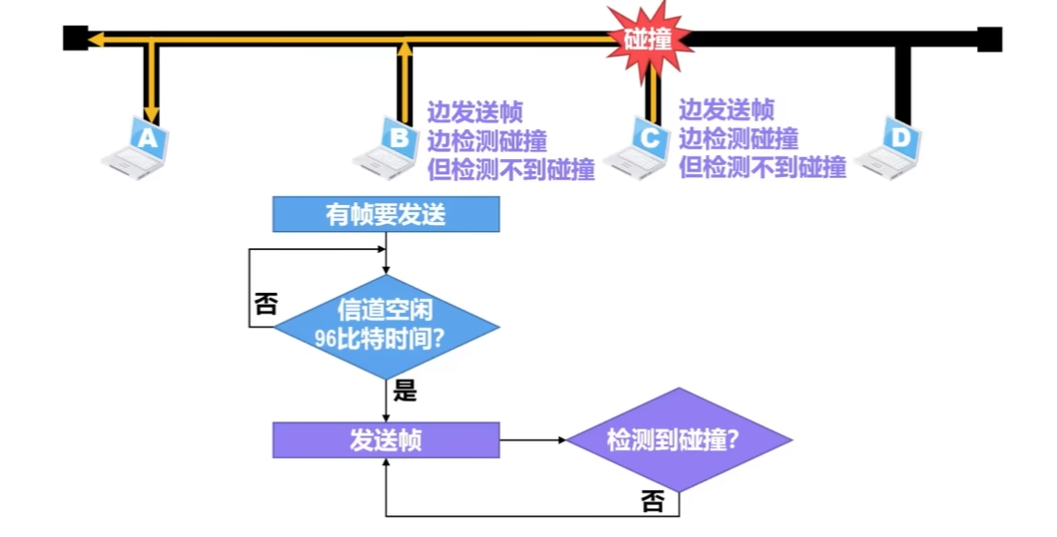
如此就会产生碰撞,碰撞产生后B、C不会立刻检测到,需要等碰撞信号传回B、C后才会被检测到(如下图所示)

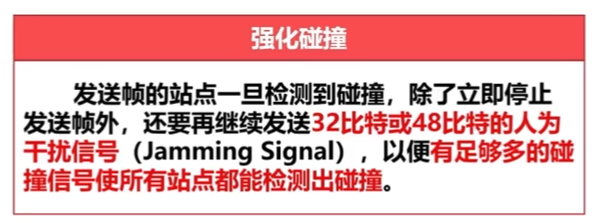
补充说明
- 载波监听检测到总线空闲,但总线并不一定空闲。
- 使用CSMA/CD协议的共享总线以太网上的各站点,只是尽量避免碰撞并在出现碰撞时做出退避后重发的处理,但不能完全避免碰撞。
- 在使用CSMA/CD协议时,由于正在发送帧的站点必须“边发送帧边检测碰撞”,因此站点不可能同时进行发送和接收,也就是不可能进行全双工通信,而只能进行半双工通信(双向交替通信)。
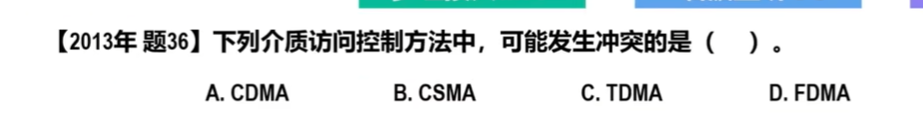
CSMA CD例题
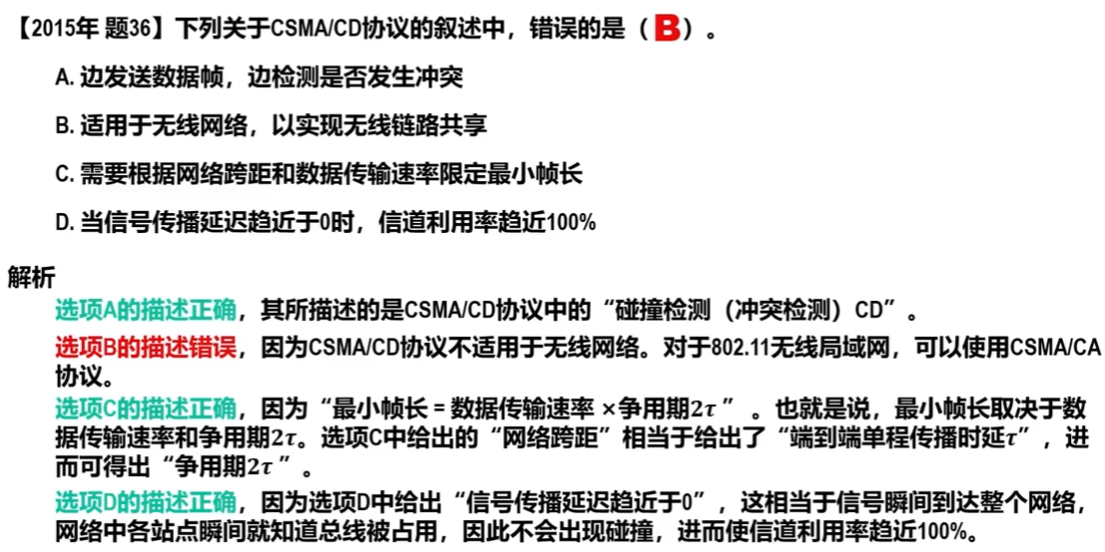
B ACD都是物理层的信道复用技术
共享式以太网的争用期、最小/大帧长
争用期
问题:某站点从发送帧开始,最长要经过多少时间才能检测出自己发送的帧与其他站点发送的帧产生了碰撞?
示意图
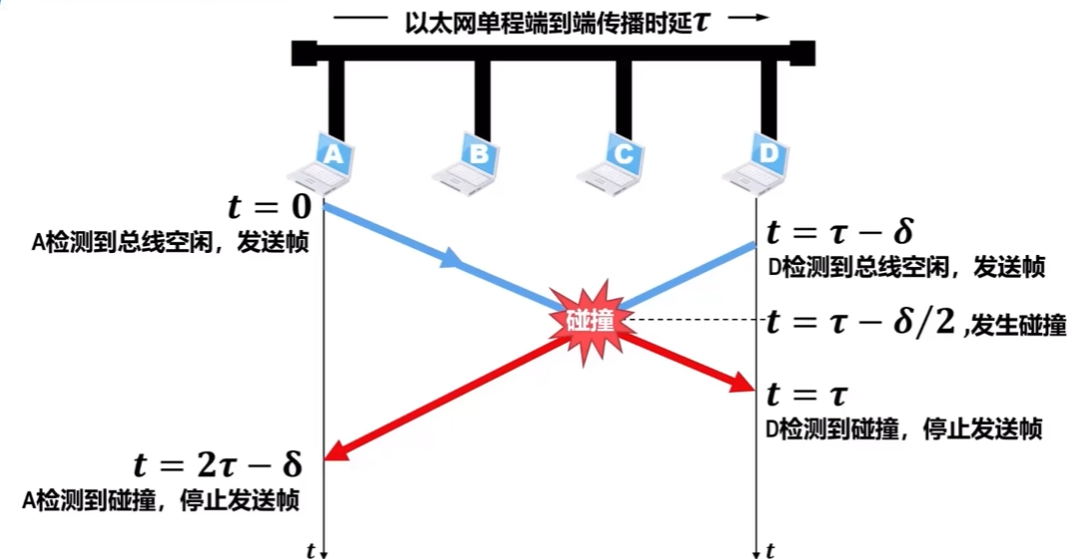
等效图
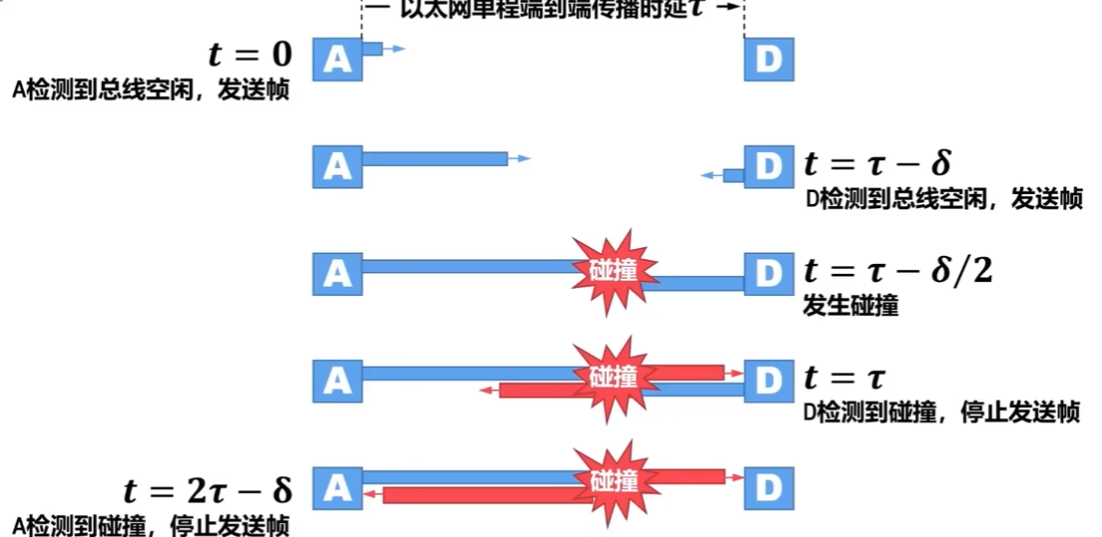
解析
- 站点从发送帧开始,最多经过时长(即)就可检测出所发送的帧是否遭遇了碰撞。
- 因此,共享总线以太网的端到端往返时间被称为争用期(Contention Period)或碰撞窗口(Collision Window),它是一个非常重要的参数。
- 站点从发送帧开始,经过争用期这段时间还没有检测到碰撞,就可以肯定这次发送不会产生碰撞。
- 从争用期的概念可以看出,共享总线以太网上的每一个站点从发送帧开始,到之后的一小段时间内,都有可能遭遇碰撞,而这一小段时间的长短是不确定的,它取决于另一个发送帧的站点与本站点的距离,但不会超过总线的端到端往返传播时延,即一个争用期。
- 很显然,总线的长度越长(单程端到端传播时延越大),网络中站点数量越多,发生碰撞的概率就越大。
- 因此,共享以太网的总线长度不能太长,接入的站点数量也不能太多。
相关规定
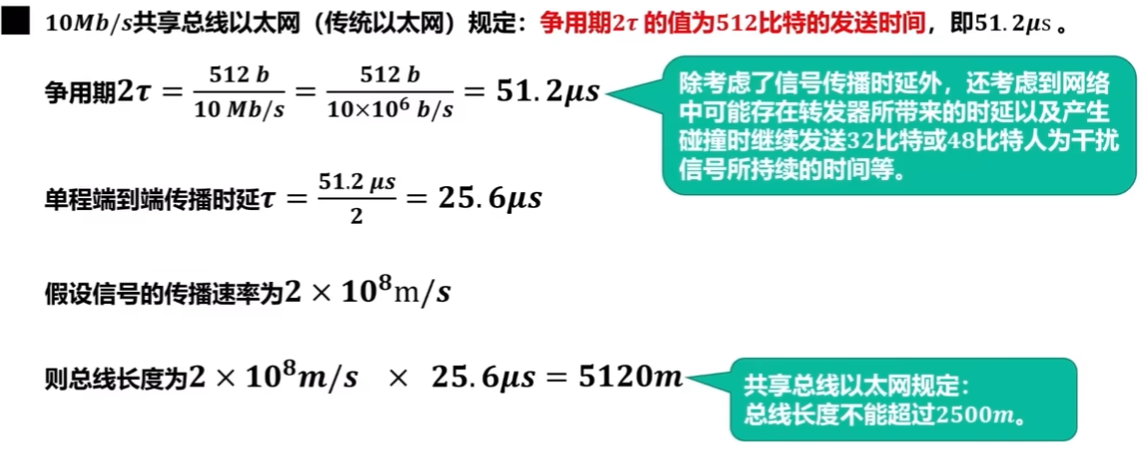
争用期习题
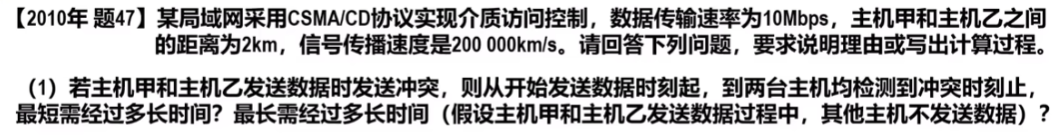
习题
注意题目中是两台主机均检测到碰撞
由上述分析我们可知时延表达式为: 即:两台主机接检测到碰撞的时间加起来一定为2
所以最短时间为两台主机同时发出,此时两台主机会同时检测到碰撞 时间为****
最长时间为其中一台(甲)马上要发送到另一台(乙)时,另一台(乙)刚发送,即:
此时甲检测到的时间为 乙检测到的时间 要求两台均检测到所以最长时间为
最小/大帧长
最小帧长
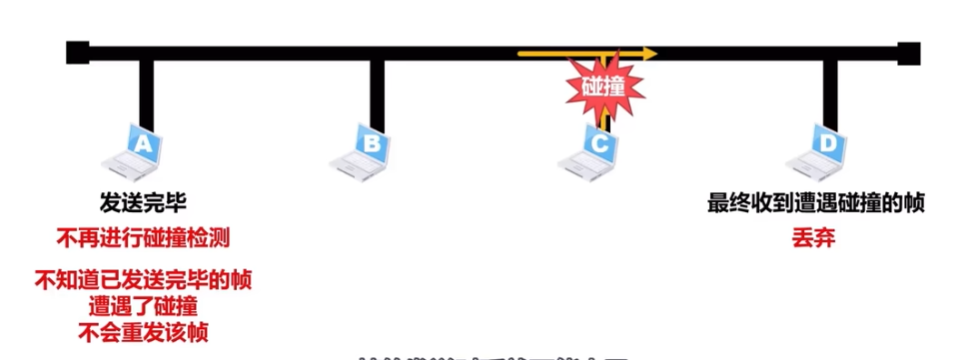
假设A发送了一个很小的帧,由于CSMA CD是边发边听的,当帧发送完毕后就不再监听是否有碰撞产生,而若是在A发送完毕后发生了碰撞,A就不会知道发生了碰撞,因而不会重发帧。此时就会导致有一些站点收到的是碰撞的帧
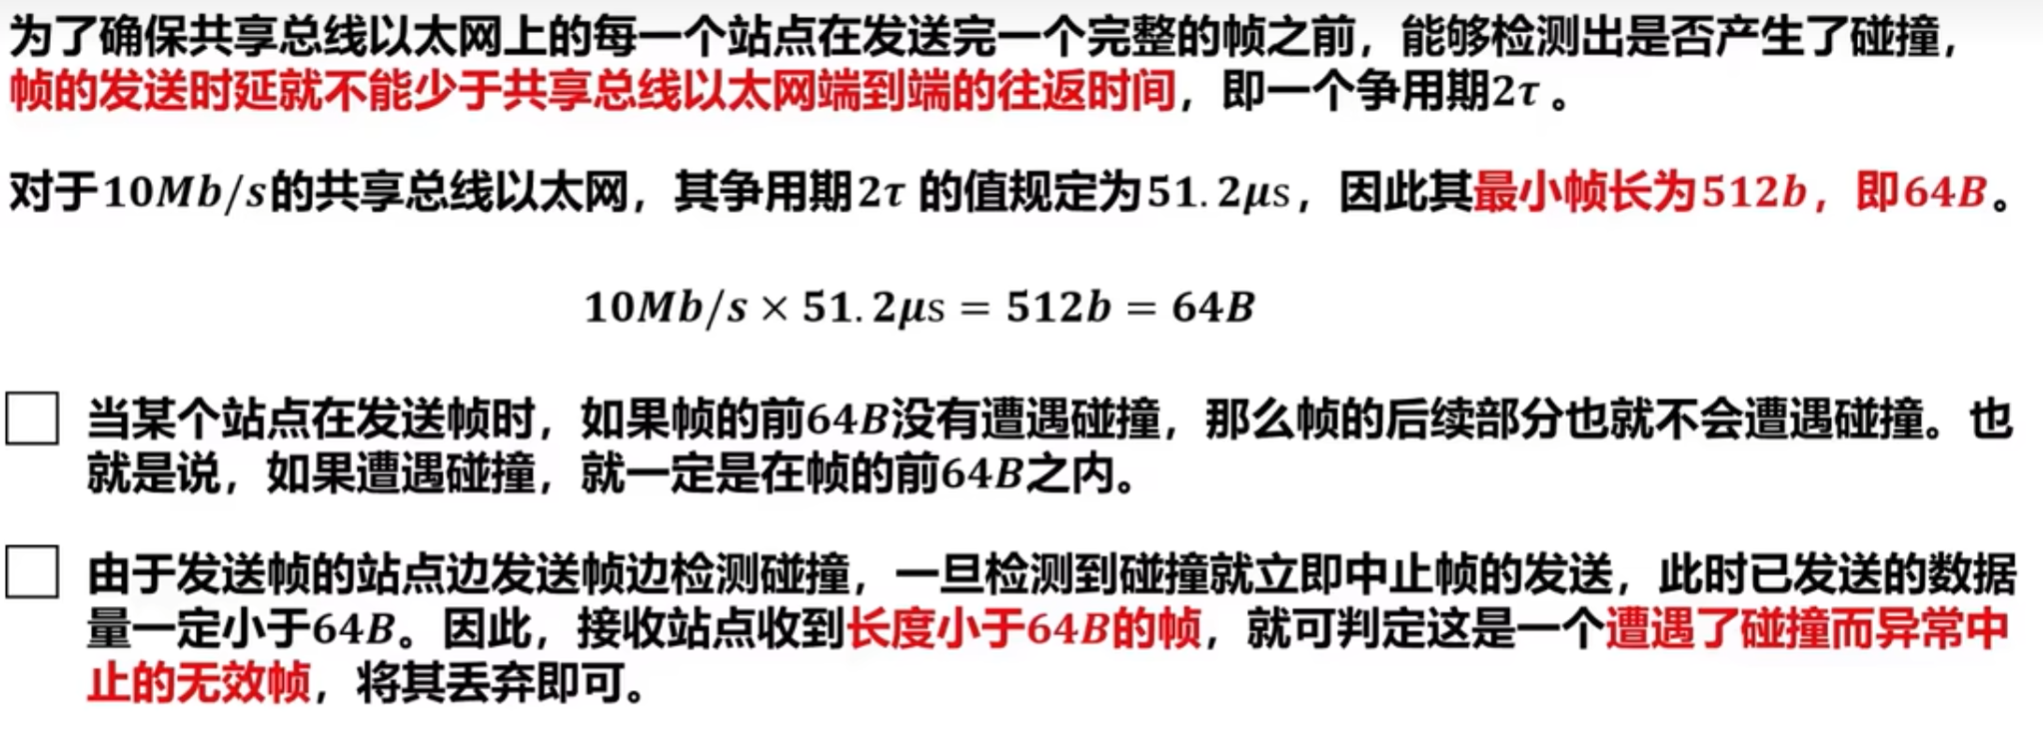
为了确保每个站点在发送完一个完整的帧之前,能够检测出是否产生了碰撞,帧的发送时延就要大于等于最大争用期
:star
:若超过仍未检测到碰撞 说明该帧已经成功发送且并无碰撞产生, 很巧妙的一点是:当超过时间未检测到碰撞又恰巧意味着总线上所有的站点都接收到了总线被占用的信息(即:总线空闲时间<96bit)。 :star::star::star<实际上要使得每个站点知道总线被占用只需要>的时间,但是要让发送站点知道帧在发送过程中没有发生碰撞需要时间, 二者取大就取了
最小帧长即满足发送帧的时间≥2τ的帧的最小长度
最大帧长
相较于最小帧长,最大帧长所解决的问题就没那么麻烦了。
问题
- 当帧长过大时,总线会长时间被占用,影响其他站点的发送
- 当帧长过大时,接收方的缓冲区可能会溢出
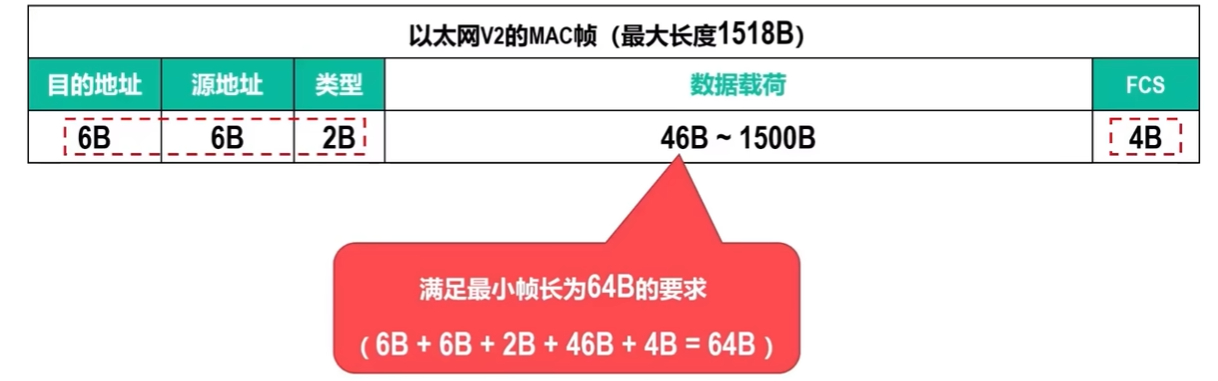
在以太网V2要求中 最大帧长为1518B
最小/大帧长习题
习题
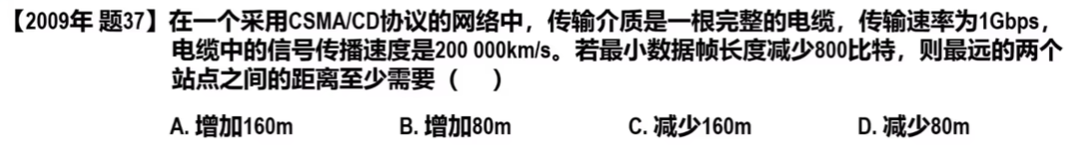
减少800bit 传输时间减少 800/110^9^=0.8 * 10^-6^s 往返距离()需减少 2 * 10^9^m/s 0.8 * 10^-6^ =160m 单程距离减少80m D
:star::star<最小帧长> = 数据传输速率 × 争用期2τ = 站点距离/信号传播速度
共享以太网的退避算法和信道利用率
退避算法
在CD过程中检测到碰撞时会停止发送并退避一段时间,此时就需要用到退避算法
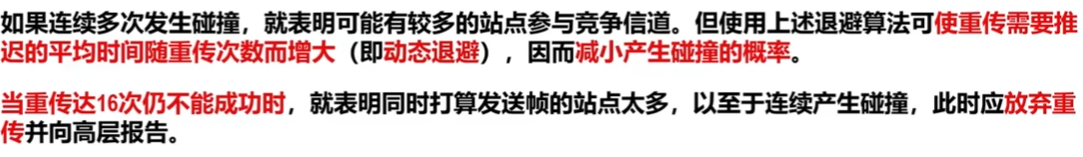
截断二进制指数退避算法
退避时间 = 基本退避时间(争用期) * 随机数(0,1,2,3 … 2^k-1^)
随机数的补充:k=min(重传次数,10)
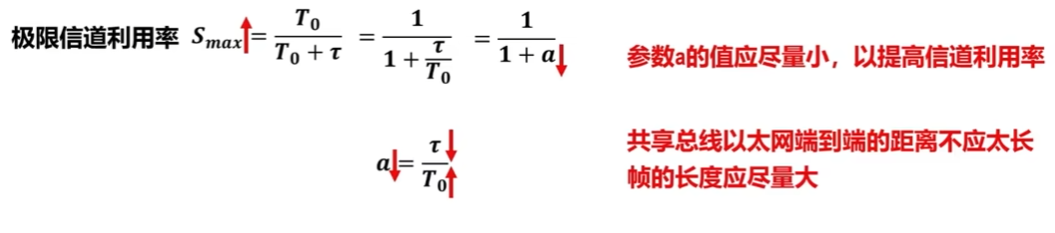
共享式以太网信道利用率

共享式以太网信道利用率习题
使用集线器的共享式以太网
粗同轴电缆(无源)连接
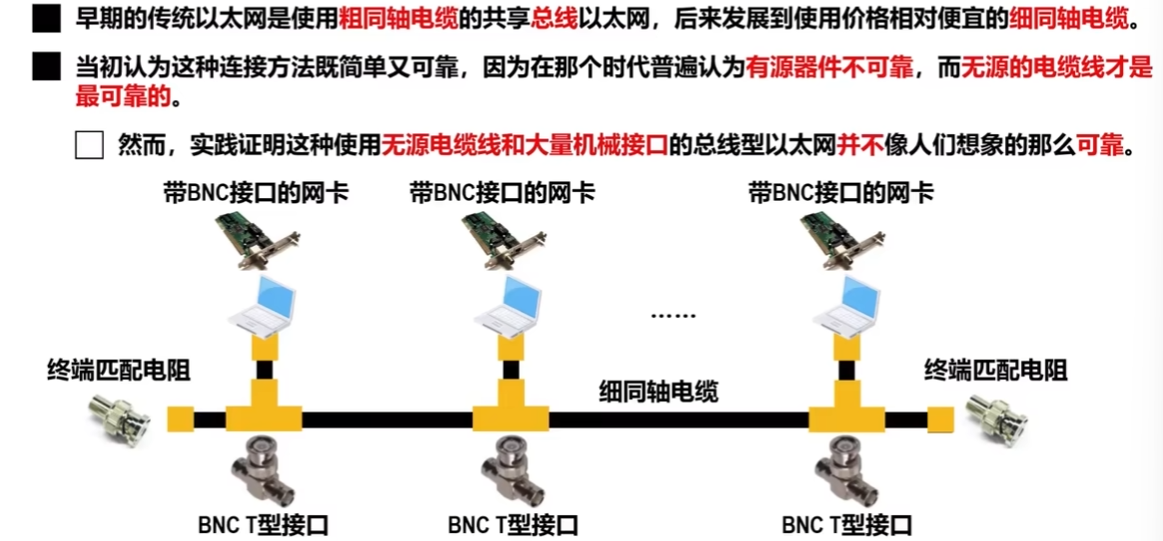
若总线上某个机械连接点接触不良或断开,则整个网络通信就不稳定或彻底断开
集线器(有源)连接
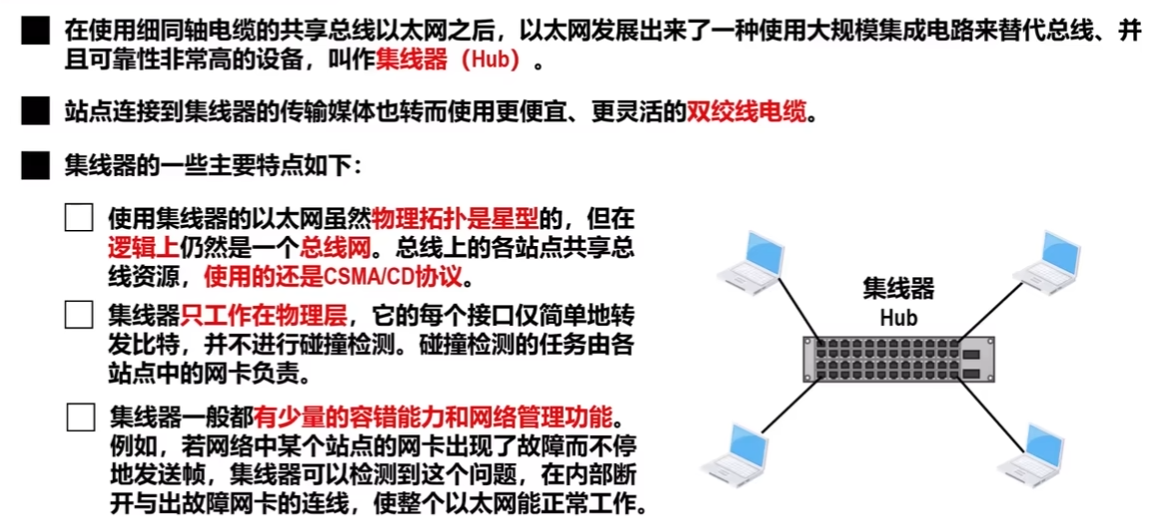
工作原理(与总线型对比)
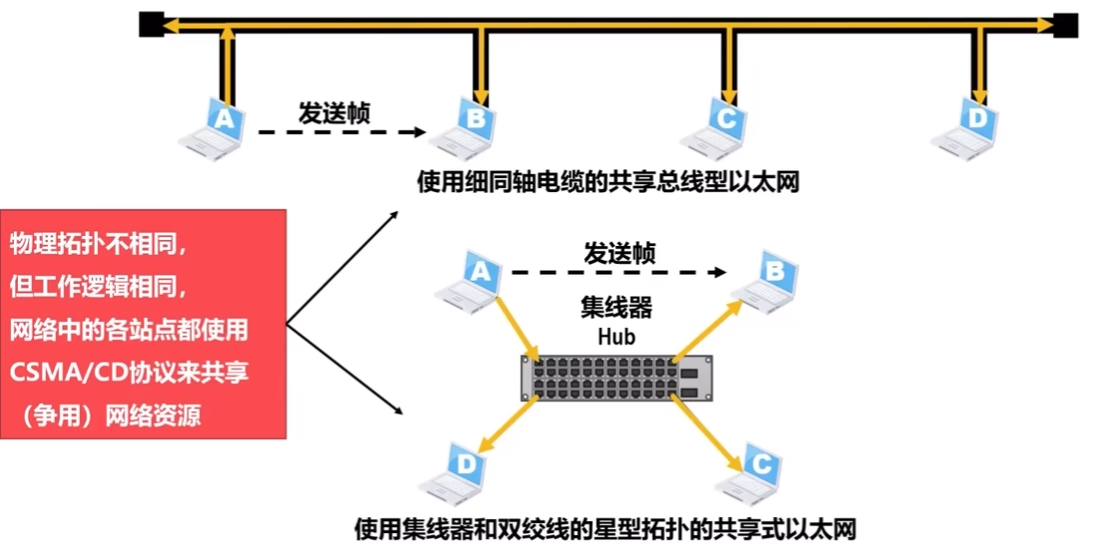
使用集线器也会发生碰撞
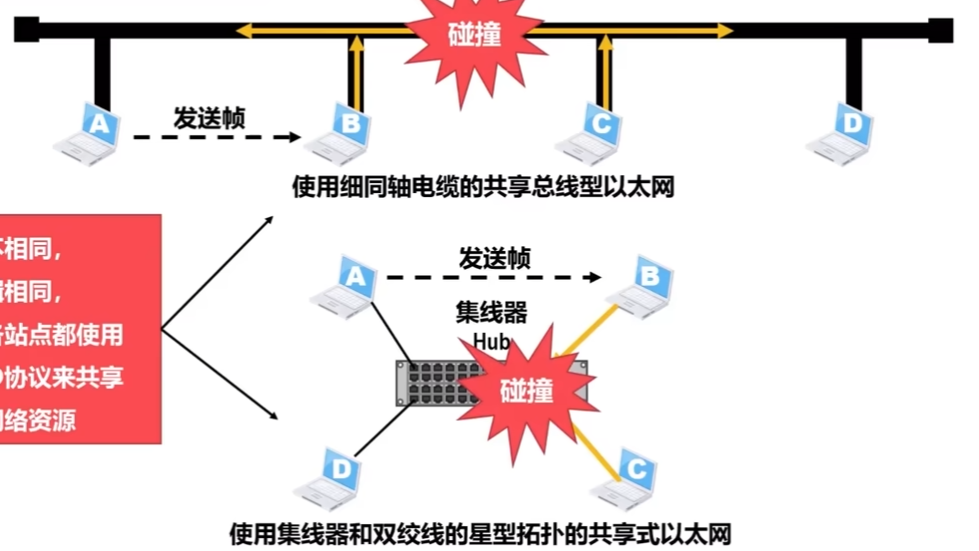
10BASE-T以太网标准
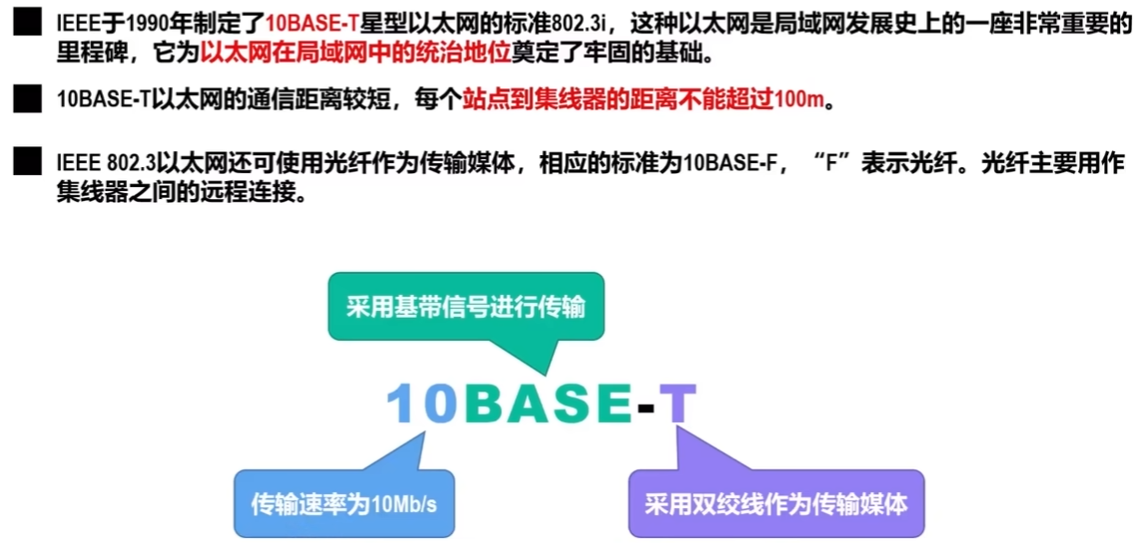
以太网的扩展
物理层的以太网扩展
扩展站点与集线器间的距离
共享总线以太网中两站点之间的距离不能太远,否则它们之间所传输的信号就会衰减到使CSMA/CD协议无法正常工作。
早期扩展方式
- 在早期广泛使用粗同轴电缆或细同轴电缆共享总线以太网时,为了提高网络的地理覆盖范围,常用的是工作在物理层的转发器。
- IEEE 802.3标准规定,两个网段可用一个转发器连接起来,任意两个站点之间最多可以经过三个网段。

当前扩展方式
- 随着使用双绞线和集线器的10BASE-T星型以太网成为以太网的主流类型,扩展网络覆盖范围就很少使用转发器了。
- 10BASE-T星型以太网中每个站点到集线器的距离不能超过100m,因此两站点间的通信距离最大不能超过200m。
- 在10BASE-T星型以太网中,可使用光纤和一对光纤调制解调器来扩展站点与集线器之间的距离。
- 这种扩展方法比较简单,所需付出的代价是:为站点和集线器各增加一个用于电信号和光信号转换的光纤调制解调器,以及它们之间的一对通信光纤。
- 信号在光纤中的衰减和失真很小,因此使用这种方法可以很简单地将站点与集线器之间的距离扩展到1000m以上。
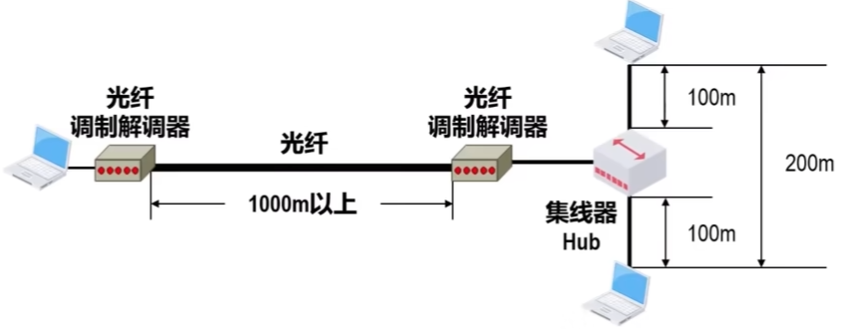
扩展共享式以太网的覆盖范围和站点数量
以太网集线器一般具有8~32个接口,如果要连接的站点数量超过了单个集线器能够提供的接口数量,就需要使用多个集线器,这样就可以连接成覆盖更大范围、连接更多站点的多级星型以太网。
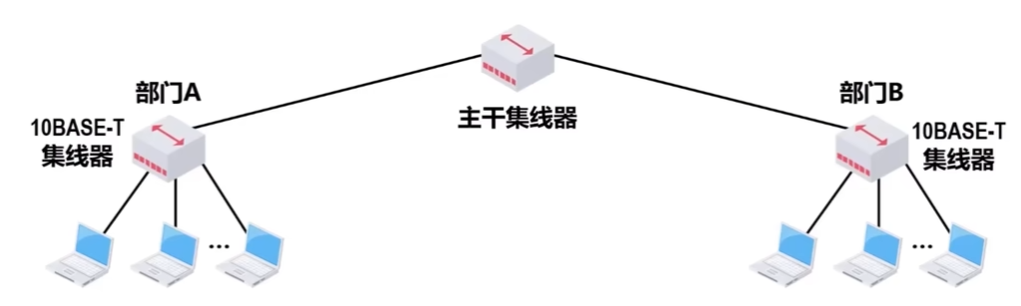
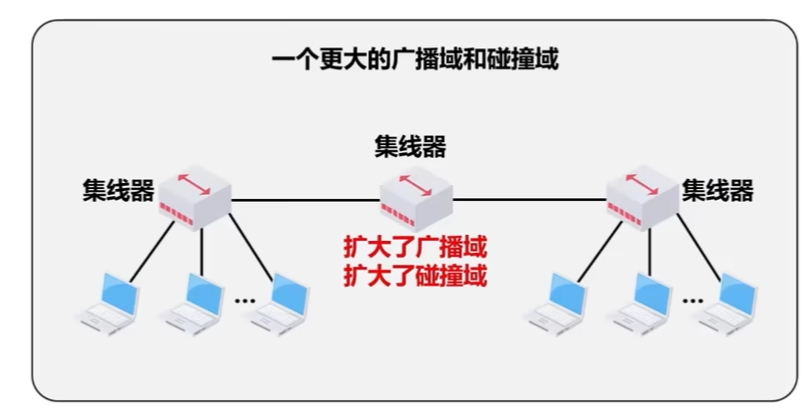
采用多个集线器连接而成的多级星型以太网,在扩展了网络覆盖范围和站点数量的同时,也带来了一些负面因素。
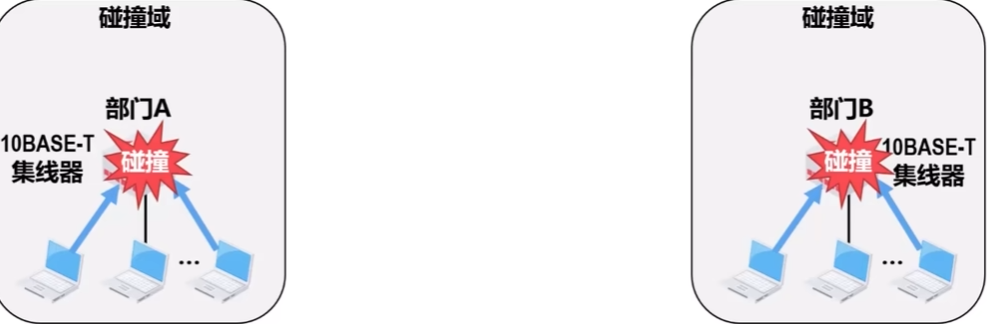
合并后碰撞概率明显增加,数据平均吞吐量会变低

数据链路层的以太网扩展
网桥简介
上面提到使用多个集线器连接多级星型以太网会造成碰撞域的增大。针对这个问题我们可以用网桥来解决
网桥(bridge)介绍
工作于数据链路层(包含其下的物理层),因此网桥具备属于数据链路层范畴的相关能力
- 网桥可以识别帧的结构
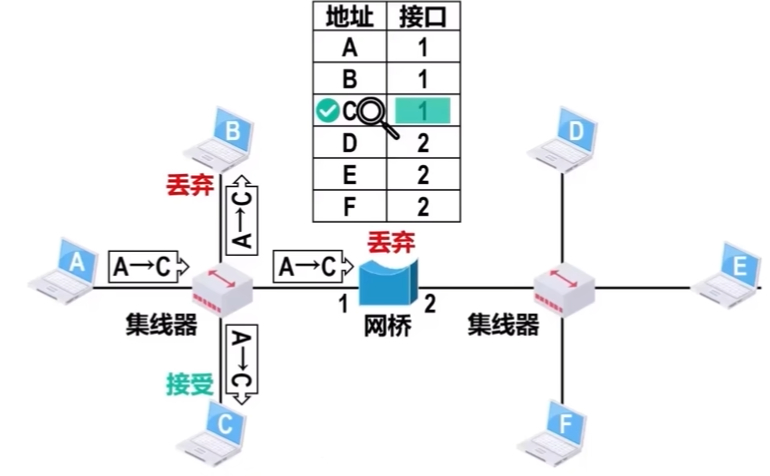
- 网桥可以根据帧首部中的目的MAC地址和网桥自身的帧转发表来转发或丢弃所收到的帧
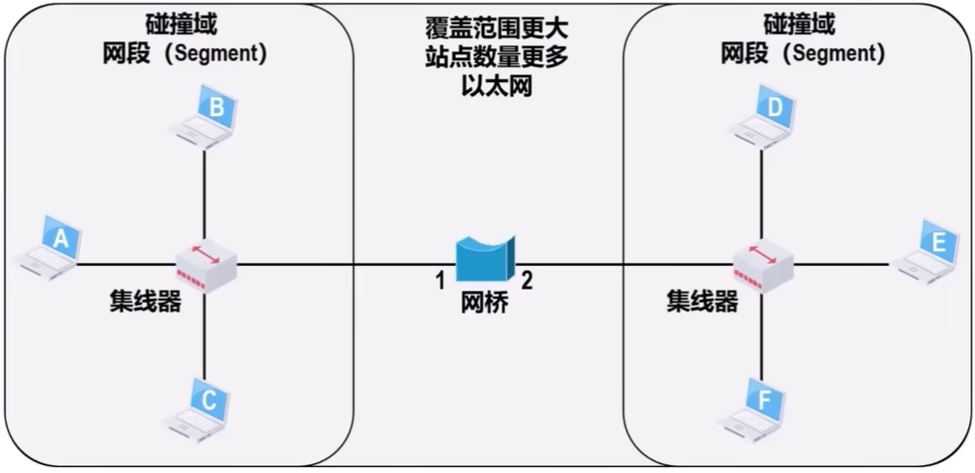
网桥的主要结构和工作原理
结构
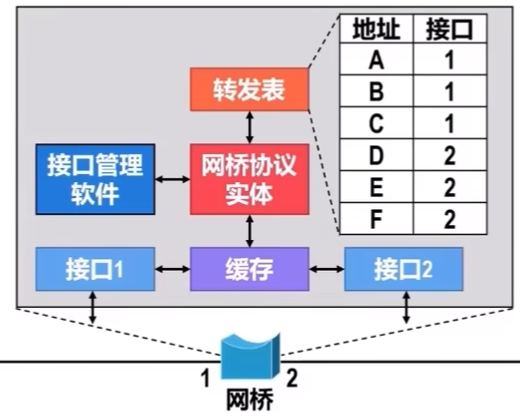
工作原理
网桥转发帧
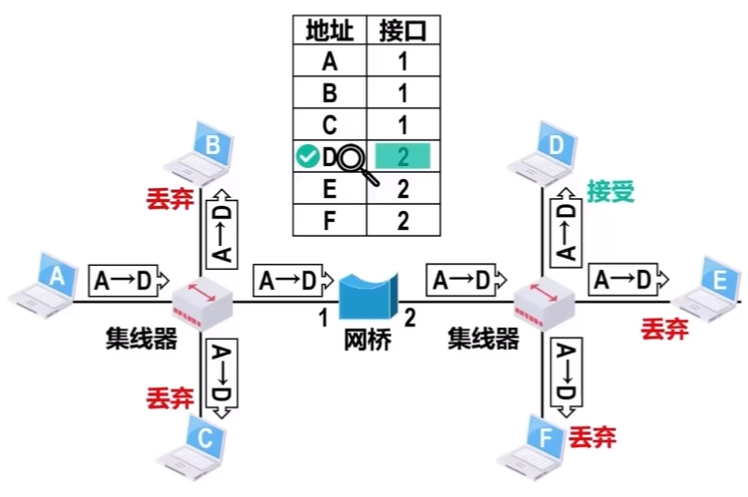
网桥丢弃帧
网桥转发广播帧
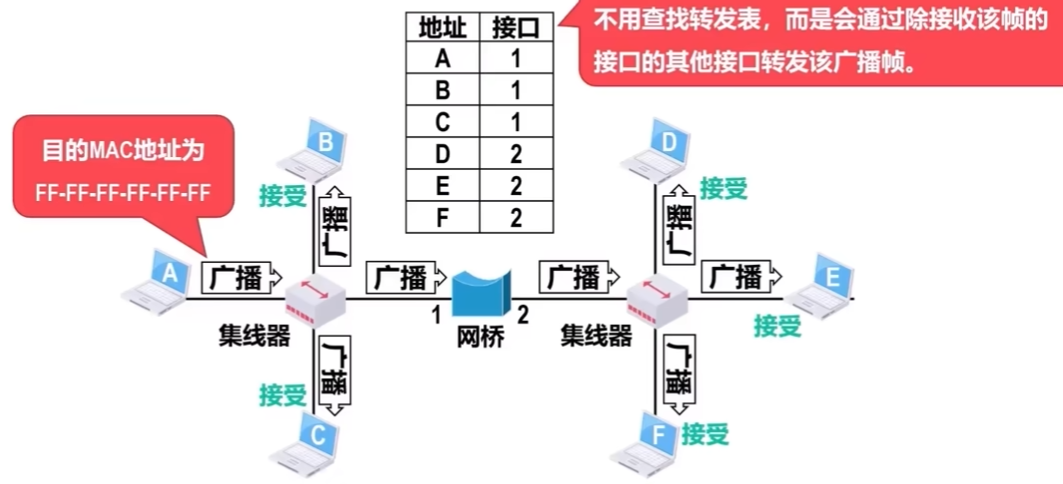
透明网桥的自学习和转发帧的过程
透明网桥概念
透明网桥(Transparent Bridge)通过自学习算法建立转发表。
透明网桥中的“透明”,是指以太网中的各站点并不知道自己所发送的帧将会经过哪些网桥的转发,最终到达目的站点。也就是说,以太网中的各网桥对于各站点而言是看不见的。
透明网桥的标准是IEEE 802.1D,它通过一种自学习算法基于以太网中各站点间的相互通信逐步建立起自己的转发表。
透明网桥的自学习
网桥的转发表最开始为空,每当有一个新的站点进行转发后网桥都会对其进行登记,登记内容为该站点的地址,以及该站点的帧是从哪个接口进来的
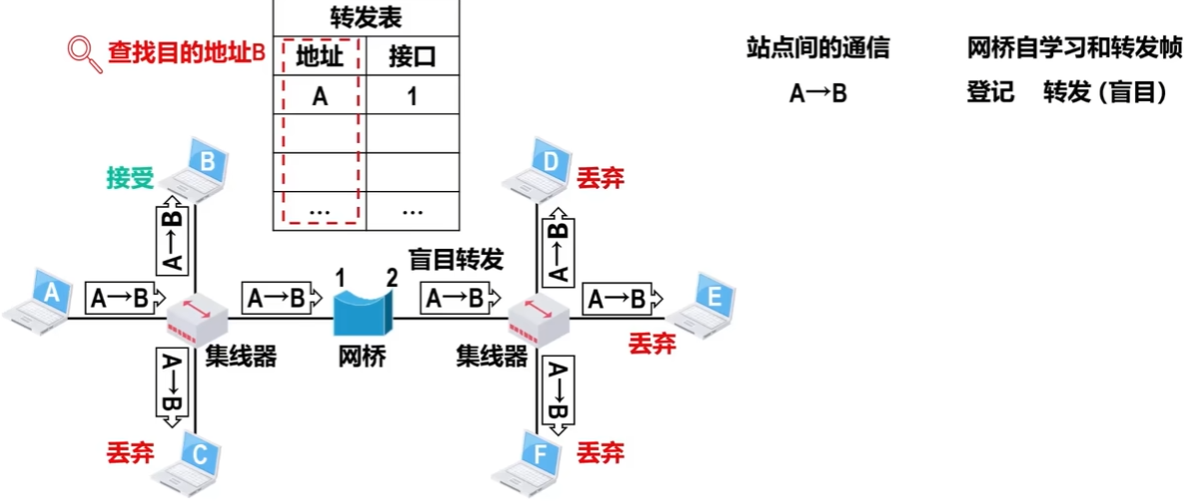
进行登记后网桥会进行转发,当网桥无法在转发表的所有登记中查询到目标地址时,转发表就会盲目转发
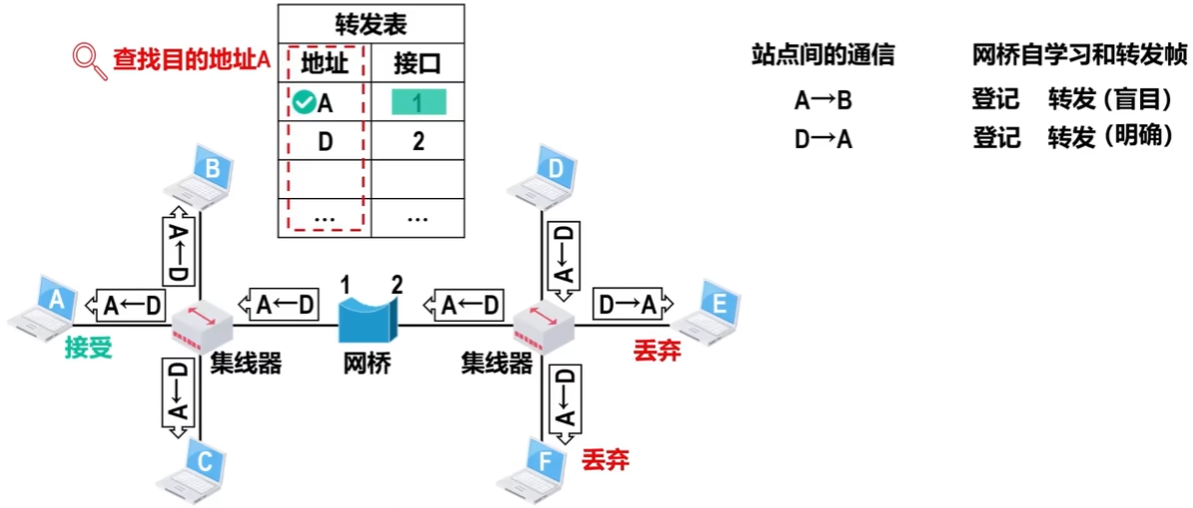
同样的,网桥接收到D –> A的转发也会先登记D是从哪个接口进来的,随后查表转发至A所在的那个接口 登记 <–> 记录某设备在网桥的哪个接口处
当网桥查询到目标地址的接口与帧传入接口相同时,说明这两个站点位于同一网段内,网桥就会丢弃该帧 tip:网桥收到有误码的帧也会直接丢弃
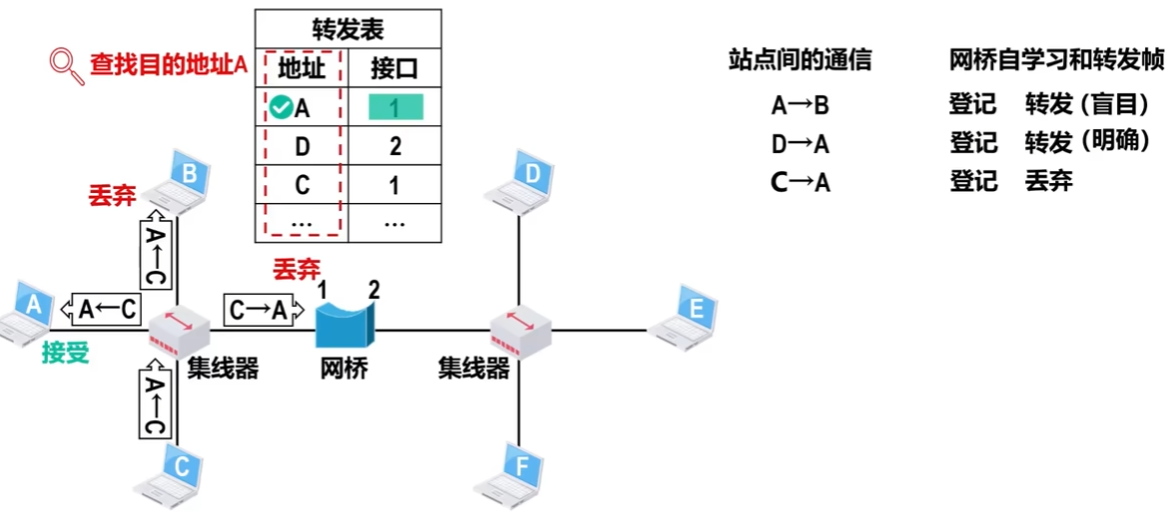
tip:网桥转发表中的记录会定期清除,因为各站点的MAC地址和网桥接口的关系不是永久性的
生成树协议STP
为了提高网桥可靠性,有时需要在两个以太网之间使用多个透明网桥来提供冗余链路,当主路网桥故障是,可以重新生成树,通过备用网桥重新形成一个网络通路。
示意图
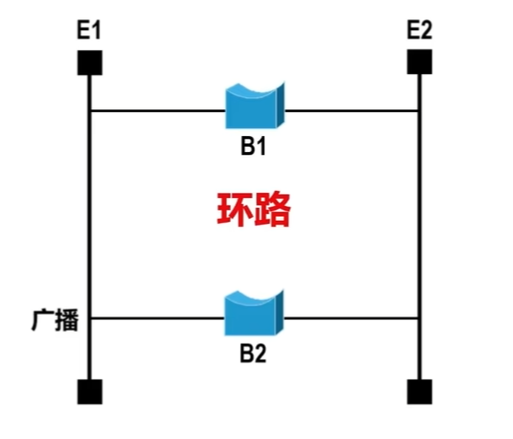
由上图图二可见,由于形成环路,广播帧会一直在环路里循环
解决方法 — 生成树协议(Spanning Tree Protocol STP)
原理及示意图
原理
不管网桥之间连接成了怎样复杂的带环拓扑,网桥之间通过交互网桥协议单元(Bridge Protocol Data Unit, BPDU),找出原网络拓扑的一个连通子集(即生成树),在这个子集里整个连通的网络中不存在环路。
示意图
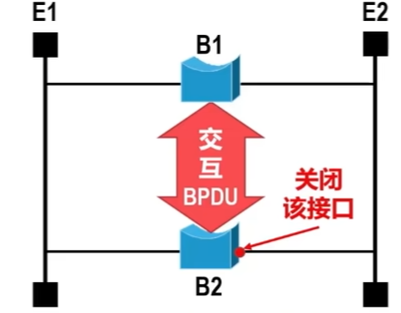
故障时的处理
当首次连接网桥或网络拓扑发生变化时(人为改变或出现故障),网桥都会重新构造生成树,以确保网络的连通。
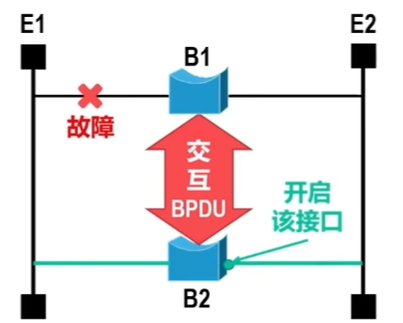

5.交换式以太网
简介
网桥接口数量很小,通常只有2~4个,一般只用来连接不同的网段
1990年面世的交换式集线器(Switching Hub),实质上是具有多个接口的网桥,常称为以太网交换机(Switch)或二层交换机。
- “二层”是指以太网交换机工作在数据链路层(包括物理层)。
- 与网桥相同,交换机内部的转发表也是通过自学习算法,基于网络中各主机间的通信,自动地逐步建立起来的。
- 另外,交换机也使用生成树协议STP,来产生能够连通全网但不产生环路的通信路径。
仅使用交换机(而非集线器)的以太网就是交换式以太网
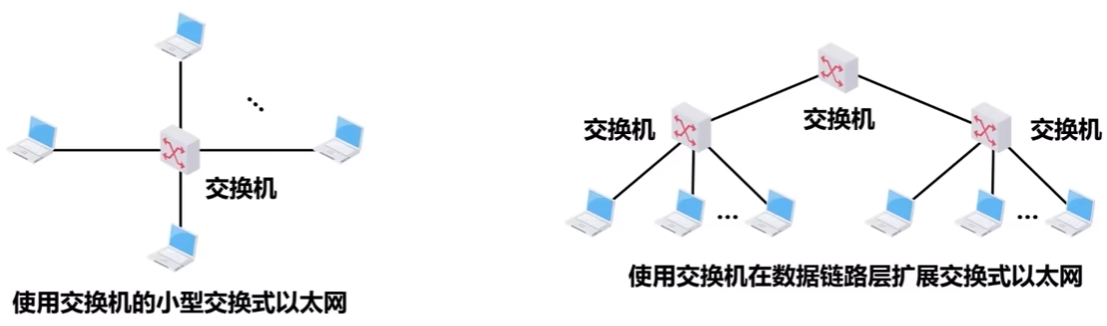
以太网交换机
以太网交换机本质上就是一个多接口的网桥
交换机的每个接口可以连接计算机,也可以连接集线器或另一个交换机。
- 当交换机的接口与计算机或交换机连接时,可以工作在全双工方式,并能在自身内部同时连通多对接口,使每一对相互通信的计算机都能像独占传输媒体那样,无碰撞地传输数据,这样就不需要使用 CSMA/CD 协议了。
- 当交换机的接口连接的是集线器时,该接口就只能使用 CSMA/CD 协议并只能工作在半双工方式。
- 现在的交换机和计算机中的网卡都能自动识别上述两种情况,并自动切换到相应的工作方式。
如图所示,直接在交换机内部进行连通,这样就不会发生碰撞
交换机一般都具有多种速率的接口,例如10Mb/s、100Mb/s、1Gb/s甚至10Gb/s的接口,大部分接口支持速率自适应。
以太网交换机的直通交换
一般的交换机都采用“存储转发”方式,为了减小交换机的转发时延,某些交换机采用了**直通(Cut-Through)**交换方式。
- 采用直通交换方式的交换机,在接收帧的同时就立即按帧的目的MAC地址决定该帧的转发接口,然后通过其内部基于硬件的交叉矩阵进行转发,而不必把整个帧先缓存后再进行处理。
- 直通交换的时延非常小。
- 直通交换不检查差错就直接将帧转发出去,有可能会将一些无效帧转发给其他主机。
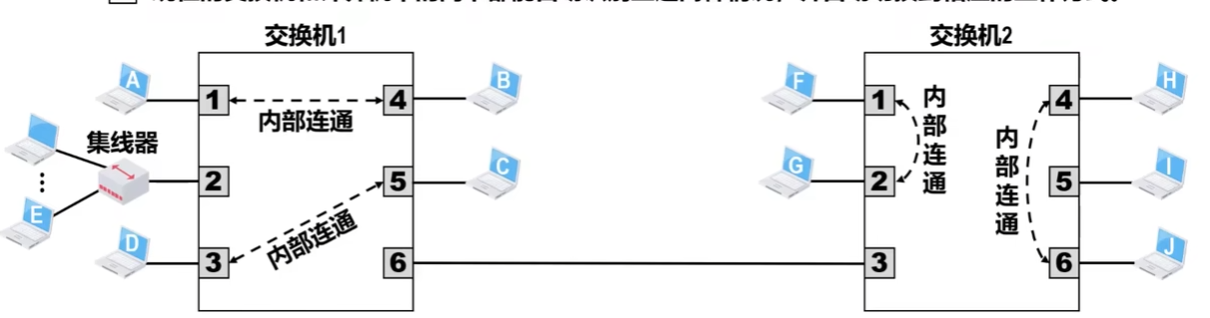
交换机习题
习题1
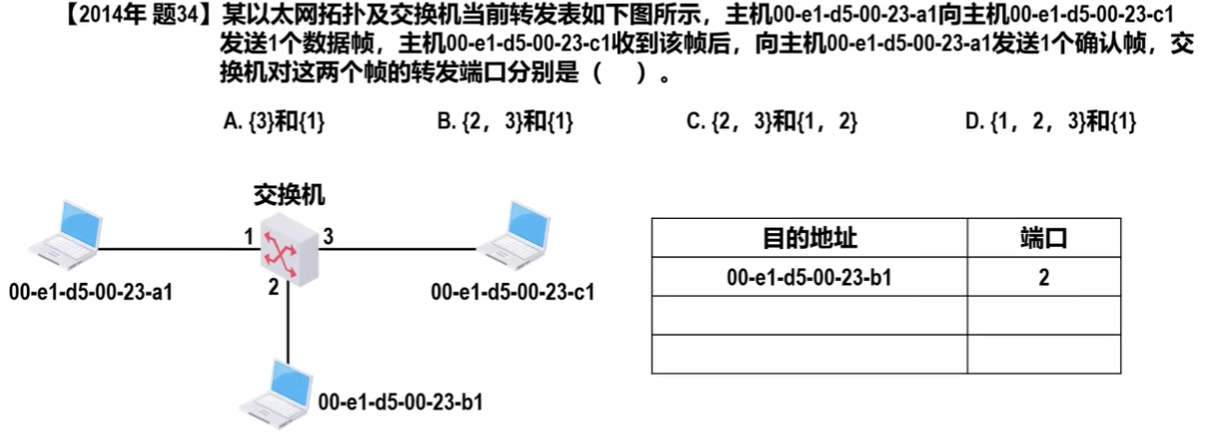
方便起见 分别称a1,b1,c1为A B C。
- A–>C发送 1端口进入 登记、盲目转发至2、3端口
- C–>A发送 3端口进入,由于1已经登记 所以直接明确转发至从1端口
综上选B
习题2
PDU(Protocol Data Unit)的意思是协议数据单元,它是计算机网络体系结构中对等实体间逻辑通信的对象。
以太网交换机工作在数据链路层(包括物理层),它接收并转发的PDU通常称为帧。以太网交换机收到帧后,在转发表中查找帧的目的MAC地址所对应的接口号,然后通过该接口转发帧。 选A
习题3

- 直通交换接受完目的MAC地址就立马进行转发
- 物理层会对MAC帧添加8Byte的前导码 详见 但是题目不要求
转发延迟= 6 * 8/ 100 * 10^6^= 0.48

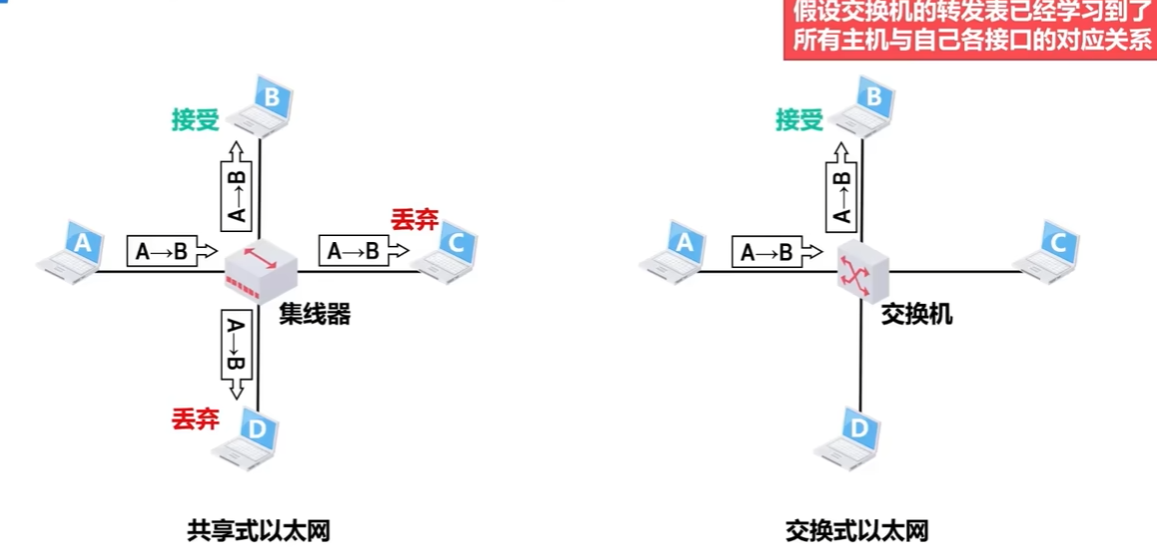
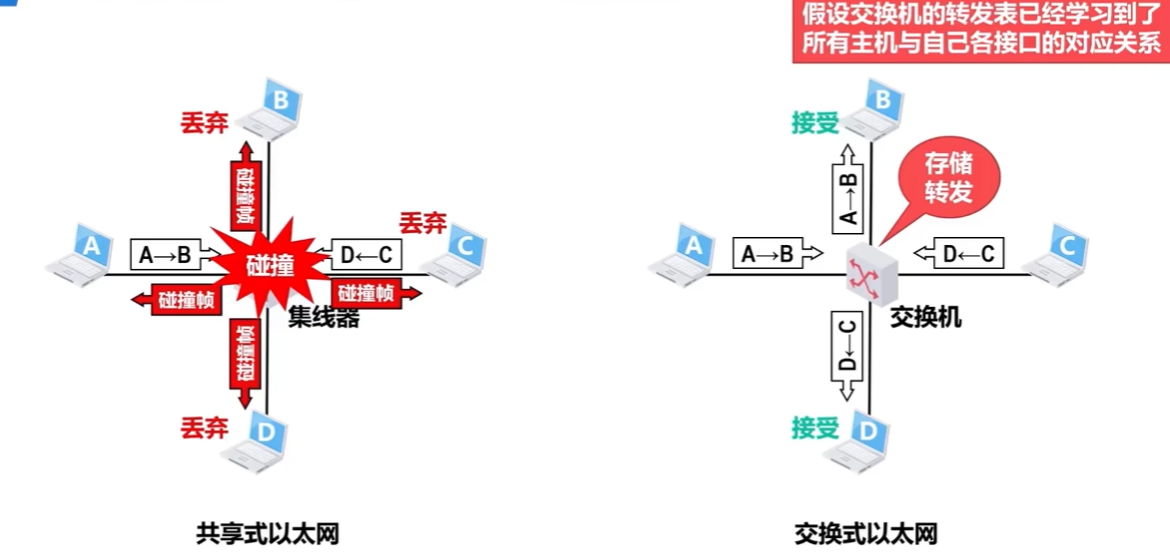
共享式以太网和交换式以太网的对比
二者的对比主要是比较集线器和交换机
单播帧转发对比
广播帧转发的对比
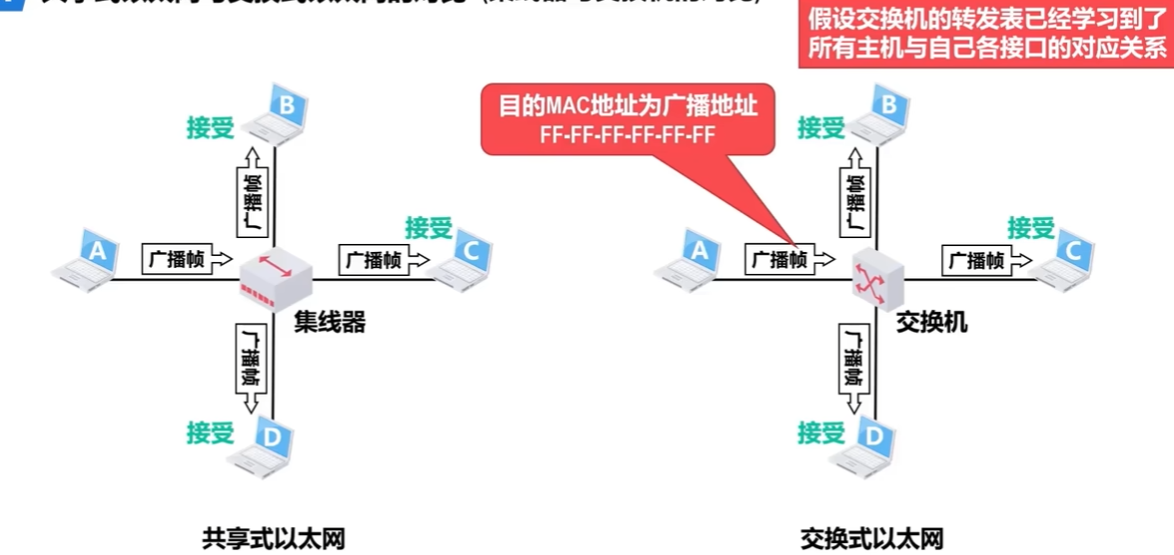
尽管二者的效果类似,但是工作原理却不同
- 集线器工作在物理层,不管什么帧都会同时转发给所有接口,当电脑收到广播帧后再识别MAC地址 当发现是广播帧后接受
- 交换机工作在数据链路层,可以识别MAC地址,当其识别到是广播帧后就会发送给所有接口
多台设备同时通信
扩展以太网

共享式以太网和交换式以太网的对比习题
习题1
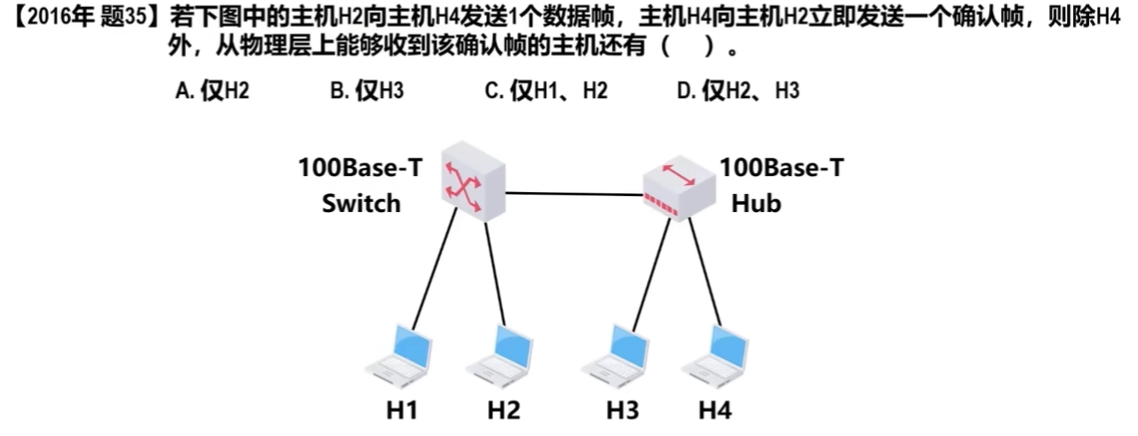
- H2 –> H4 交换机登记并盲目转发
- H4 –> H2 先经过集线器,集线器转发给H3和交换机,由于已经登记过H2 所以直接发给H2
综上选D
习题2
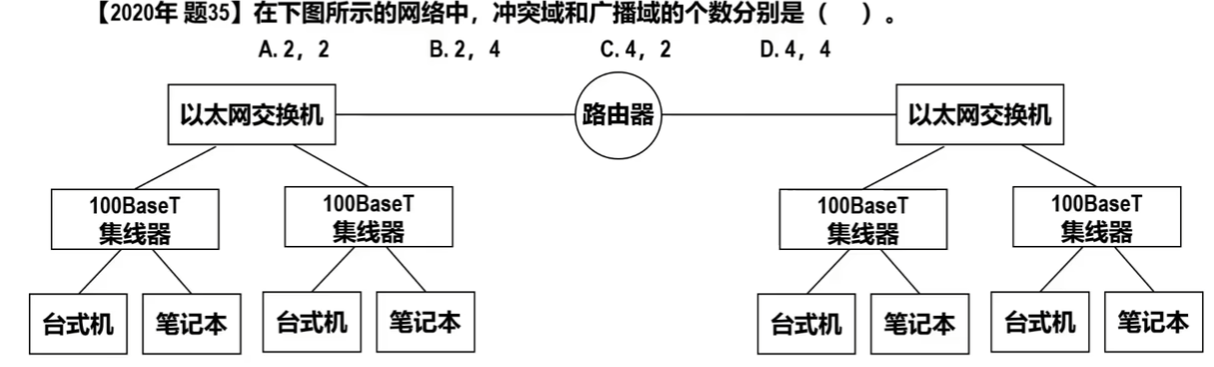
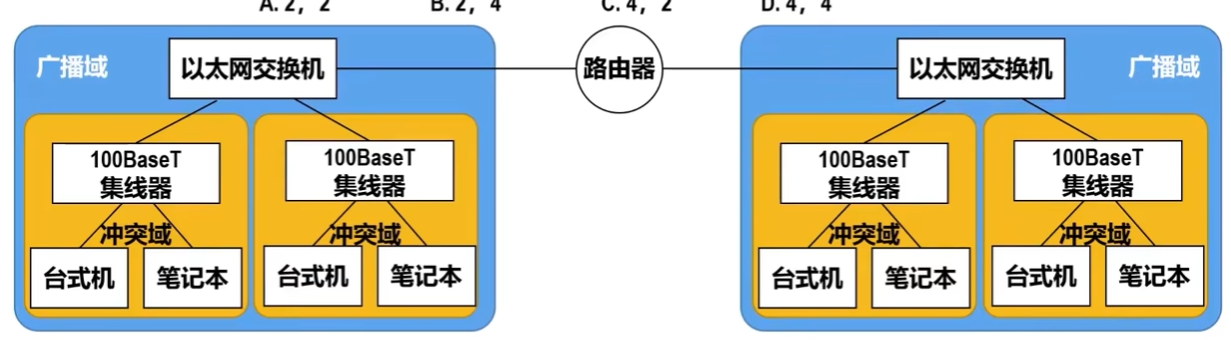
补充:路由器既隔离冲突域又隔离广播域 C
解析
6.以太网的MAC帧格式
以太网V2MAC帧格式
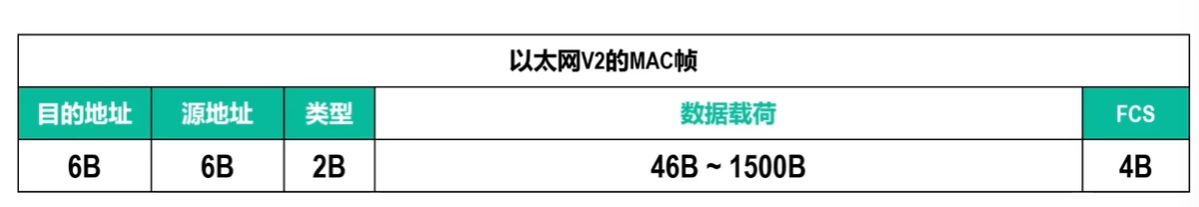
目的地址和源地址:分别填帧的目的MAC地址和源MAC地址
类型:其值用来指明数据载荷中的内容是由上一层的哪个协议封装的,以便将收到的 MAC 帧的数据载荷上交给上一层的这个协议。
FCS:CRC检测误码的校验码
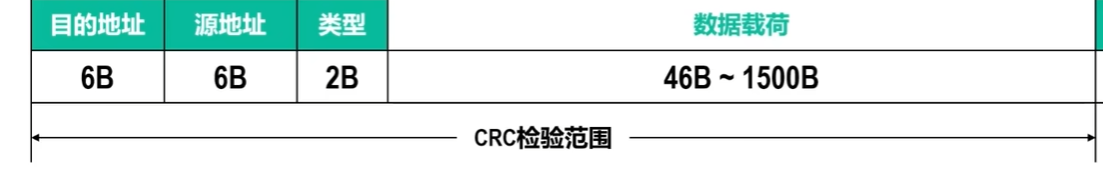
为满足最小帧长(64Byte)规定 当数据载荷小于46Byte时,数据链路层就会在数据载荷后插入填充数据,使得帧长不小于64Byte
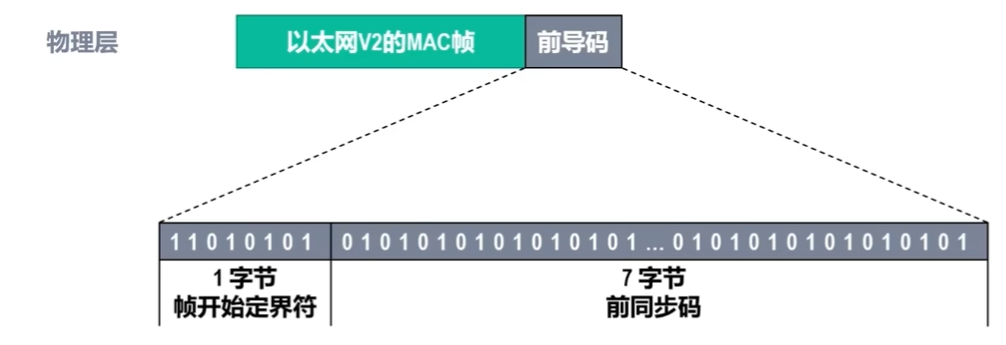
封装成帧后交付物理层添加前导码
接收方可能收到的无效MAC帧的情况
- MAC帧的长度不是整数个字节
- 通过MAC帧的FCS字段的值检测出帧有误码
- MAC帧的长度不在64~1518字节之间
当检测到无效帧后直接丢弃,属于不可靠传输
7.虚拟局域网VLAN
概述
诞生背景
交换式以太网得到大范围应用,从而构成了巨大的广播域,巨大的广播域会引起广播风暴等一系列问题
广播风暴
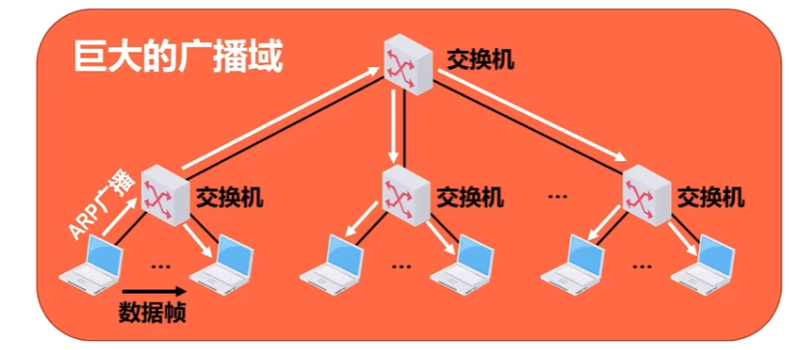
当一个主机在一个巨大的广播域内发起广播时(如:查找目的主机的MAC地址需要发起ARP广播),会浪费大量的网络资源
由于互联网中经常会有广播的使用,所以我们需要将一个巨大的广播域分割 ——— 路由器(分割广播域)
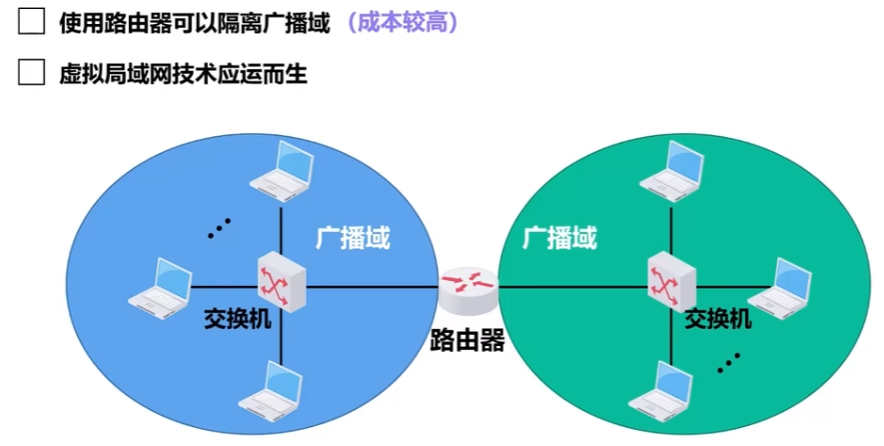
而路由器分割广播域的方法成本较高,所以虚拟局域网技术应运而生。
简介
虚拟局域网(Virtual Local Area Network, VLAN)是一种将局域网内的站点划分成与物理位置无关的逻辑组的技术,一个逻辑组就是一个VLAN,VLAN中的各站点具有某些共同的应用需求。
示意图
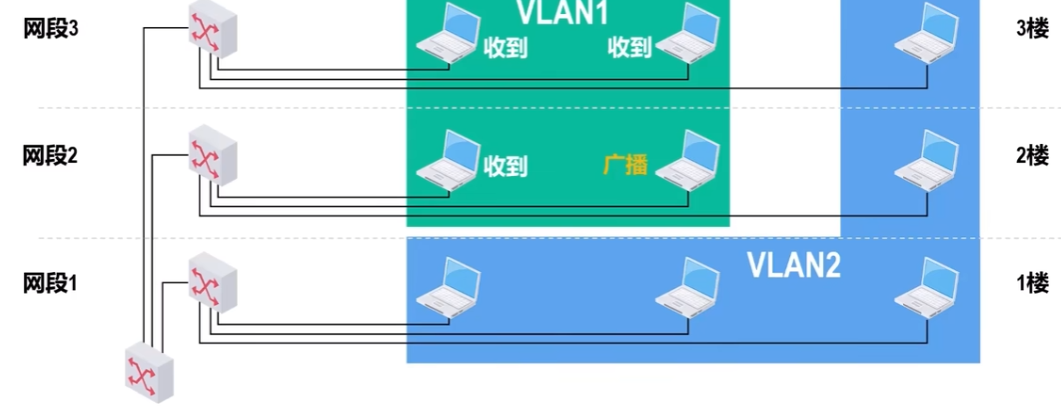
属于同一VLAN的站点之间可以直接进行通信,而不同VLAN中的站点之间不能直接通信。
网络管理员可对局域网中的各交换机进行配置来建立多个逻辑上独立的VLAN。
☐ 连接在同一交换机上的多个站点可以属于不同的VLAN,而属于同一VLAN的多个站点可以连接在不同的交换机上。
虚拟局域网VLAN并不是一种新型网络,它只是局域网能够提供给用户的一种服务。
VLAN的实现机制
相关概念
虚拟局域网VLAN有多种实现技术,最常见的就是基于以太网交换机的接口来实现VLAN。这就需要以太网交换机能够实现以下两个功能:
能够处理带有VLAN标记的帧,也就是IEEE 802.1Q帧。
交换机的各接口可以支持不同的接口类型,不同接口类型的接口对帧的处理方式有所不同。
IEEE 802.1Q帧
IEEE 802.1Q帧也称为DotOne Q帧,它对以太网V2的MAC帧格式进行了扩展:在源地址字段和类型字段之间插入了**4字节的VLAN标签(tag)**字段。
示意图
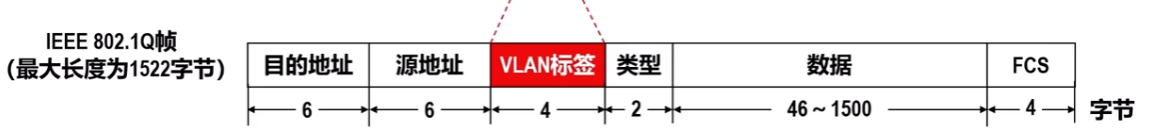
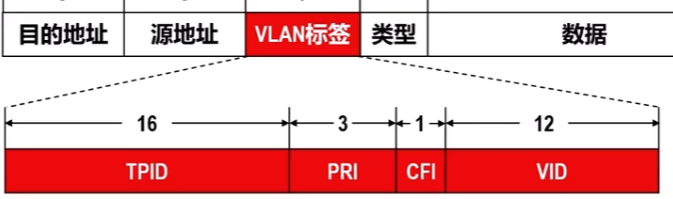
- 标签协议标识符TPID:长度为16bit,值固定为0x8100,表示该帧时IEEE 802.1Q帧
- 优先级PRI:长度为3bit,取值范围为0~7,值越大越优先,当网络阻塞时,优先发送优先级高的帧
- 规范格式指示符CFI:长度为1比特,取值为0表示MAC地址以规范格式封装,取值为1表示MAC地址以非规范格式封装。对于以太网,CFI的取值为0。(以太网帧只是MAC帧的一种)
- 虚拟局域网标识符VID:长度为12bit,取值为0~4095 其中0和4095保留不使用 VID是802.1Q帧所属VLAN的编号,设备利用VID来识别帧所属的VLAN。 广播帧只在同一VLAN内转发,这样就将广播域限制在了一个VLAN内。
VLAN标签
802.1Q帧一般不由用户主机处理,而是由以太网交换机来处理:
☐ 当交换机收到普通的以太网MAC帧时,会给其插入4字节的VLAN标签使之成为802.1Q帧,该处理简称为“打标签”。
☐ 当交换机转发802.1Q帧时,可能会删除其4字节的VLAN标签使之成为普通的以太网MAC帧,该处理简称为“去标签”。交换机转发802.1Q帧时也有可能不进行“去标签”处理,是否进行“去标签”处理取决于交换机的接口类型。
交换机接口类型
根据接口在接收帧和发送帧时对帧的处理方式的不同,以及接口连接对象的不同,以太网交换机的接口类型一般分为**Access(用于连接用户计算机)和Trunk(用于交换机之间或交换机与路由器之间)**两种。
当以太网交换机上电启动后,若之前未对其各接口进行过VLAN的相关设置,则各接口的接口类型默认为Access,并且各接口的缺省VLAN ID为1,即各接口默认属于VLAN1。
☐ 对于思科交换机,接口的缺省VLAN ID称为本征VLAN(Native VLAN)。
☐ 对于华为交换机,接口的缺省VLAN ID称为端口VLAN ID(Port VLAN ID),简记为PVID。
交换机的每个接口有且仅有一个PVID tip:缺省=默认
交换机端口举例说明
一台交换机内不进行VLAN划分、且各接口为Acess的情况
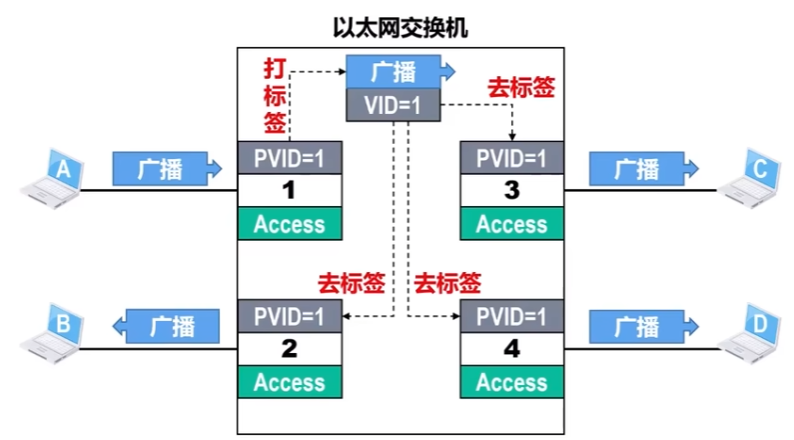
一台交换机内划分两个不同VLAN、接口类型为Acess的情况
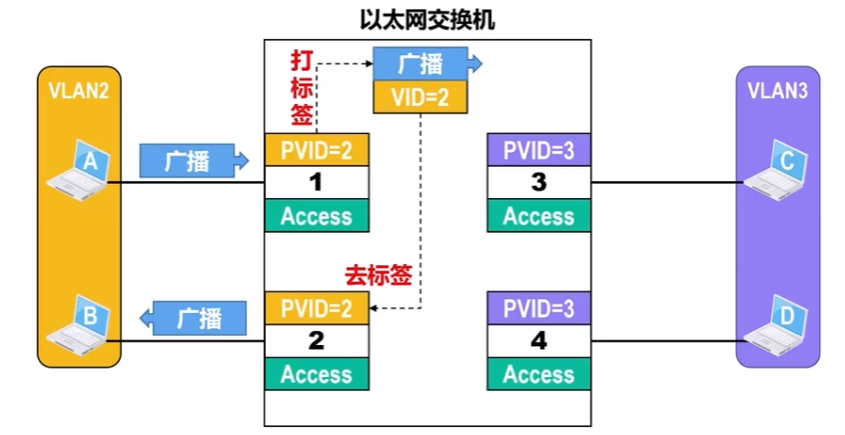
两台交换机通过Trunk接口连接的情况
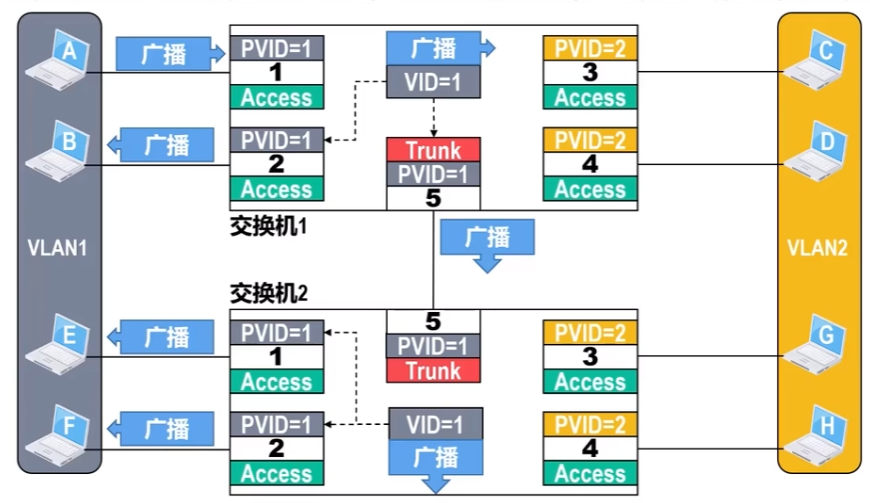
由上两图可见
- Trunk接口的PVID默认为1 一般不建议修改, 两交换机的Trunk接口的VID需相同 不然可能转发失败
- 当广播的VID与Trunk接口VID一样时,转发时会对其进行去标签,到达另一Trunk接口后再为其打上标签
- 当广播的VID不同于Trunk接口VID时,Trunk接口会连带着VLAN标签一起转发,不再进行去标签操作


VLAN习题
习题1
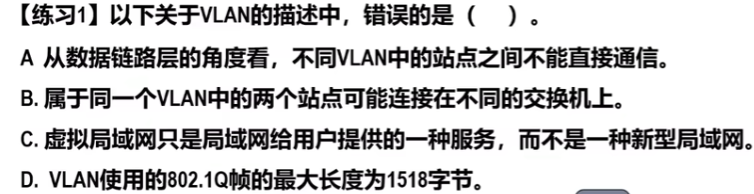
D 802.1Q帧最大长度为 1518+4=1522
习题2
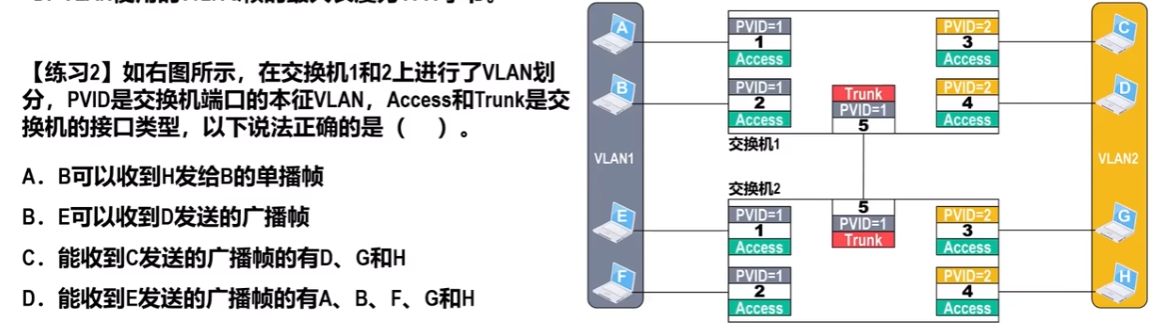
C
8.以太网发展
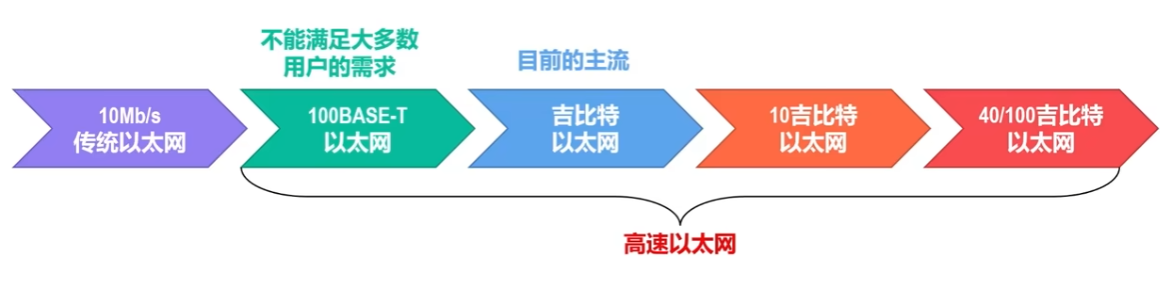
100BASE-T以太网
100BASE-T以太网是指在双绞线上传输基带信号的速率为100Mb/s的以太网,也称为快速以太网(Fast Ethernet)。
100BASE-T以太网与10Mb/s标准以太网(传统以太网)一样,仍然使用IEEE 802.3的帧格式和CSMA/CD协议。
100BASE-T以太网为了与10Mb/s标准以太网保持兼容,需要以太网最小帧长保持不变,即仍为64字节。
网段的最大电缆长度从1000m减小到100m
争用期缩短为5.12μs
帧间最小间隔缩短为0.96μs
100BASE-T以太网还可以使用以太网交换机来提供比集线器更好的服务质量,即在全双工方式下无碰撞工作。因此,使用交换机的100BASE-T以太网,工作在全双工方式下,并不使用CSMA/CD协议。
吉比特以太网
吉比特以太网也称为千兆以太网(Gigabit Ethernet)。1998年,千兆以太网的标准802.3z成为正式标准。
近几年来,千兆以太网已迅速占领市场,成为了以太网的主流产品。 IEEE 802.3z千兆以太网的主要特点有:
速率为1000Mb/s(1Gb/s)
使用IEEE 802.3的帧格式(与10Mb/s和100Mb/s以太网相同)
支持半双工方式(使用CSMA/CD协议)和全双工方式(不使用CSMA/CD协议)
兼容10BASE-T和100BASE-T技术
当千兆以太网工作在半双工方式时,需要使用CSMA/CD协议。由于速率已经提高到了1000Mb/s,因此只有减小网段最大长度或增大最小帧长,才共享式以太网信道利用率介绍的以太网的参数a(τ/T₀)保持为较小的数值。
导致的两个问题
☐ 若将网段最大长度减小到10m,则网络基本失去了应用价值。
☐ 若将最小帧长增大到640字节,则当上层交付的待封装的协议数据单元PDU很短时,开销就会太大。
解决方法
千兆以太网的网段最大长度仍保持为100m,最小帧长仍保持为64字节(与10BASE-T和100BASE-T兼容)。
这就需要使用**载波延伸(Carrier Extension)**的办法,将争用期增大为512字节的发送时间而保持最小帧长仍为64字节。
☐ 只要发送的MAC帧的长度不足512字节时,就在MAC帧尾部填充一些特殊字符,使MAC帧的长度增大到512字节。
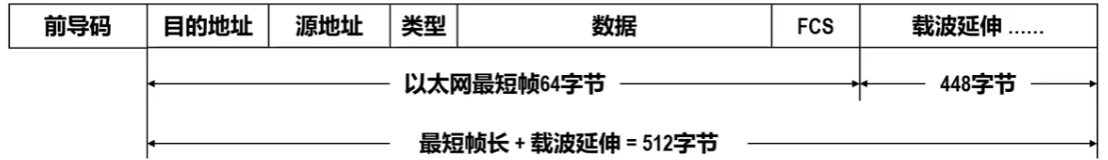
在使用载波延伸的机制下,如果原本发送的是大量的64字节长的短帧,则每一个短帧都会被填充448字节的特殊字符,这样会造成很大的开销。
因此,千兆以太网还使用了分组突发(Packet Bursting)功能。也就是当有很多短帧要连续发送时,只将第一个短帧用载波延伸的方法进行填充,而其后面的一系列短帧不用填充就可一个接一个地发送,它们之间只需空开必要的帧间最小间隔即可。
☐ 这样就形成了一连串分组的突发,当累积发送1500字节或稍多一些为止。
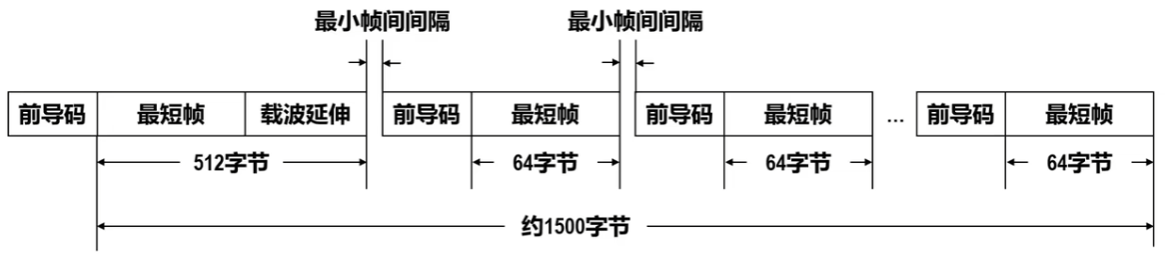
tip:当千兆以太网工作在全双工方式时,不使用CSMA/CD协议,也不会使用载波延伸和分组突发。
10吉比特以太网
2002年6月,IEEE 802.3ae委员会通过10吉比特以太网(10GE)的正式标准,10GE也称为万兆以太网。
万兆以太网并不是将千兆以太网的速率简单地提高了10倍。万兆以太网的目标是将以太网从局域网范围(校园网或企业网)扩展到城域网与广域网,成为城域网和广域网的主干网的主流技术之一。
IEEE 802.3ae万兆以太网的主要特点有:
- 速率为10Gb/s
- 使用IEEE 802.3标准的帧格式(与10Mb/s、100Mb/s和1Gb/s以太网相同)
- 保留IEEE 802.3标准对以太网最小帧长和最大帧长的规定。这是为了用户升级以太网时,仍能和较低速率的以太网方便地通信。
- 只工作在全双工方式而不存在争用媒体的问题,因此不需要使用CSMA/CD协议,这样传输距离就不再受碰撞检测的限制。
- 增加了支持城域网和广域网的物理层标准
万兆以太网交换机常作为千兆以太网的汇聚层交换机,与千兆以太网交换机相连,还可以连接对传输速率要求极高的视频服务器、文件服务器等设备。
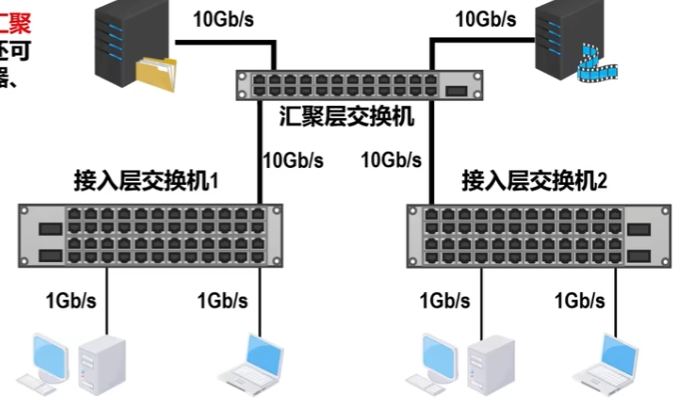
40/100吉比特以太网
2010年,IEEE发布了40吉比特/100吉比特以太网(40GE/100GE)的IEEE 802.3ba标准,40GE/100GE也称为四万兆/十万兆以太网。
为了使以太网能够更高效、更经济地满足局域网、城域网和广域网的不同应用需求,IEEE 802.3ba标准定义了两种速率类型:
40Gb/s主要用于计算应用
100Gb/s主要用于汇聚应用
IEEE 802.3ba标准只工作在全双工方式(不使用CSMA/CD协议),但仍使用IEEE 802.3标准的帧格式并遵守最小帧长和最大帧长的规定。
9.802.11无线局域网
无线局域网的组成
介绍
随着移动通信技术的发展,**无线局域网(Wireless Local Area Network, WLAN)**自20世纪80年代末以来逐步进入市场。
IEEE于1997年制定出了无线局域网的协议标准802.11,802.11无线局域网是目前应用最广泛的无线局域网之一,人们更多地将其简称为Wi-Fi(Wireless Fidelity,无线保真度)。
802.11无线局域网可分为以下两类:
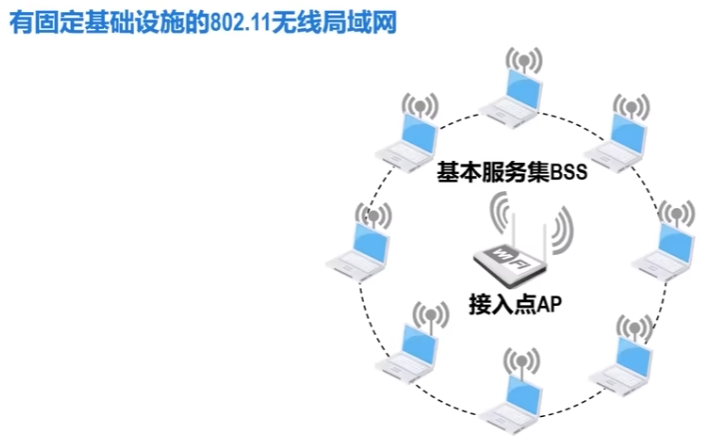
☐ 有固定基础设施的
☐ 无固定基础设施的
固定基础设施是指预先建立的、能够覆盖一定地理范围的、多个固定的通信基站。
802.11无线局域网使用最多的是它的固定基础设施的组网方式。
有固定基础设施的无线局域网
组成
- 本 BSS 内各站点之间的通信以及与本 BSS 外的站点之间的通信,都必须经过本 BSS 内的 AP 进行转发。
- 网络管理员需要为 AP 分配一个最大 32 字节的服务集标识符(Service Set Identifier,SSID)和一个无线通信信道,SSID 实际上就是使用该 AP 的 802.11 无线局域网的名字。
- 一个基本的BSS服务区直径不超过100m
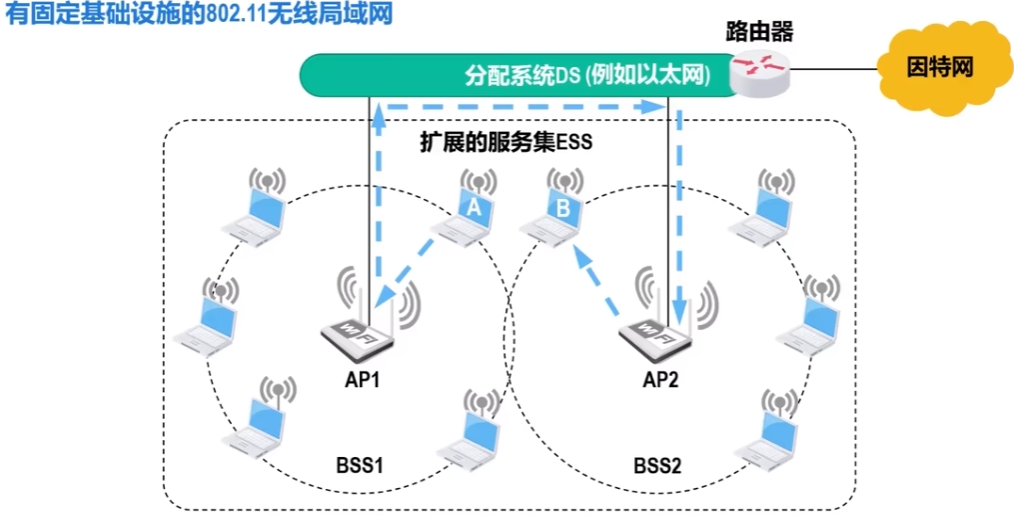
- 孤立的BSS可以通过分配系统DS与其他的BSS建立连接 构成一个扩展服务集ESS
- DS可以为BSS中的用户提供连接到非802.11无线局域网服务,例如:BSS中的设备可以通过DS连接到因特网上
- 同一个ESS但不同BSS中的设备也可以通过DS进行交互,如图所示
相关服务
关联(Association)服务
移动站与可接入AP建立连接的方法有以下两种
被动扫描
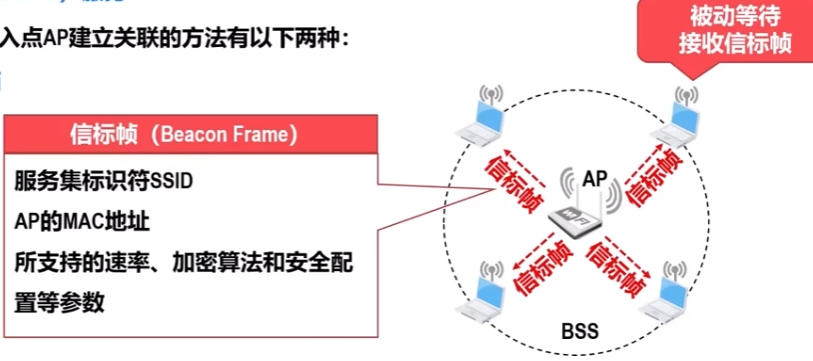
AP每隔一段时间发送信标帧,移动端被动等待接收信标帧
主动扫描
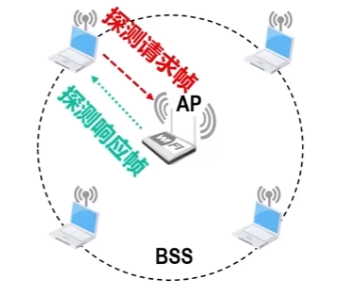
移动端主动发送探测请求帧,等待来自AP的探测响应帧
重建关联(Reassociation)服务和分离(Dissociation)服务
如果一个移动站要把与某个接入点AP的关联转移到另一个AP,就可以使用重建关联服务,若要终止关联服务,就应使用分离服务。
无固定基础设施的无线局域网
又称自组织网络(ad hoc Network)
由一些对等的移动站点组成的网络,数据通过多跳来完成转发
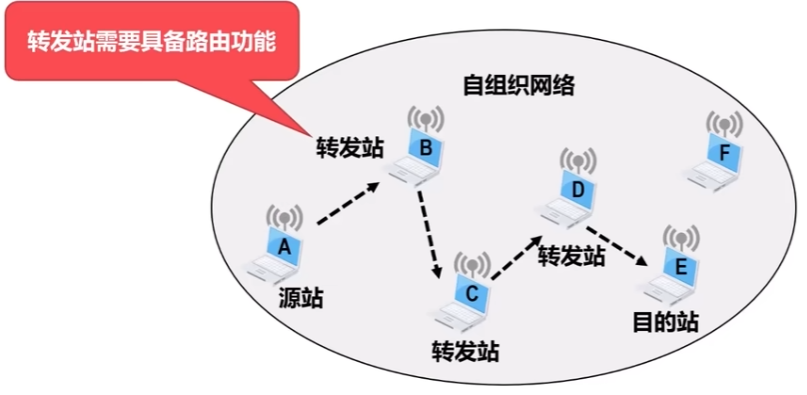
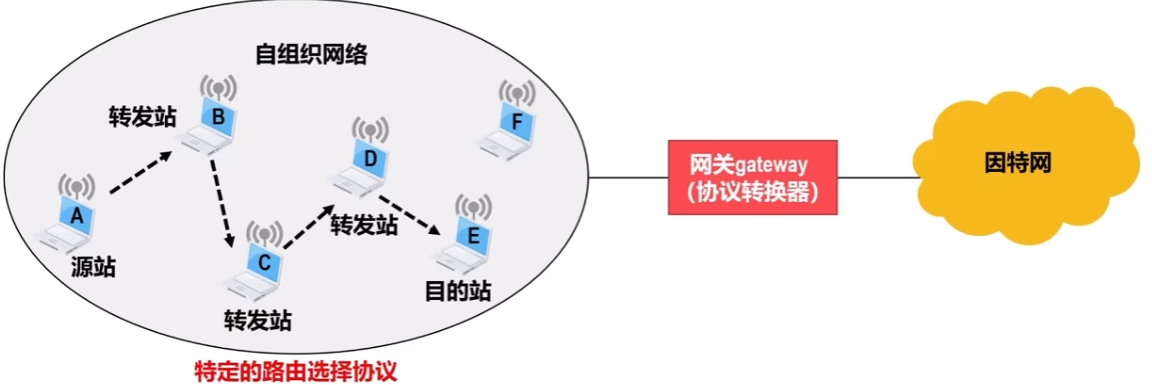
组网方便,不需要基站,具有很好的生存性,在军用民用都有很好前景
说明:802.11 无线局域网的 ad hoc 模式允许网络中的各站点在其通信范围内直接通信,也就是支持站点间的单跳通信,而标准中并没有包括多跳路由功能。因此,802.11 无线局域网的 ad hoc 模式应用较少。
无线局域网的物理层
802.11 无线局域网的物理层非常复杂,依据工作频段、调制方式、传输速率等,可将其分为多种物理层标准。
802.11 无线网卡一般会被做成多模的,以便能适应多种不同的物理层标准,例如支持 802.11b/g/n。
无线局域网最初还使用红外技术(infrared, IR)和跳频扩频(Frequency Hopping Spread Spectrum, FHSS)技术,但目前已经很少使用了。
跳频技术的发明人,是好莱坞黄金时代的著名女星海蒂・拉玛,跳频技术为 CDMA 和 Wi-Fi 等无线通信技术奠定了基础。因此,海蒂・拉玛被誉为 “Wi-Fi 之母”。
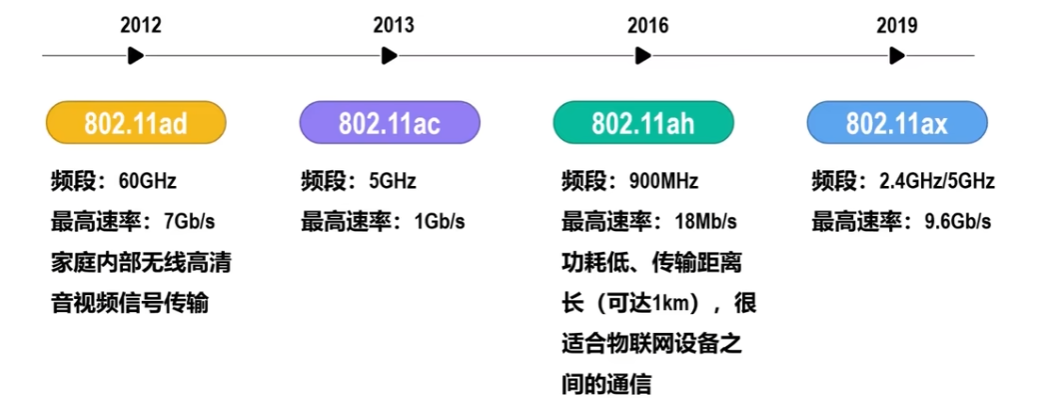
- 最近几年,802.11 无线局域网又有一些新的物理层标准陆续推出:
CSMA/CA协议
简介
为解决无线局域网中各站点争用总线的问题,由于传输介质不同,不能照搬CSMA/CD协议,所以采用了CSMA/CA协议,即:载波监听多址接入 / 避免碰撞(Carrier Sense Multiple Access/Collision Avoidance)。
CSMA/CA
- 仍然沿用了CSMA/CD中的CSMA部分,即:“先听后说”。用于减少碰撞发生
- 将碰撞检测CD改为了碰撞避免CA,注意:尽管名为碰撞避免,但也无法避免所有的数据碰撞,只能尽可能降减少数据碰撞的发生
不采用CSMA/CD的原因
由于无线信道的传输环境复杂且信号强度的动态范围非常大,在802.11无线网卡上接收到的信号强度一般都远远小于发送信号的强度,信号强度甚至相差百万倍。因此,如果要在802.11无线网卡上实现碰撞检测,对硬件的要求非常高。
即使能够在硬件上实现碰撞检测功能,但由于无线电波传播的特殊性(存在隐蔽站问题),还会出现无法检测到碰撞的情况,因此实现碰撞检测并没有意义。
隐蔽站问题
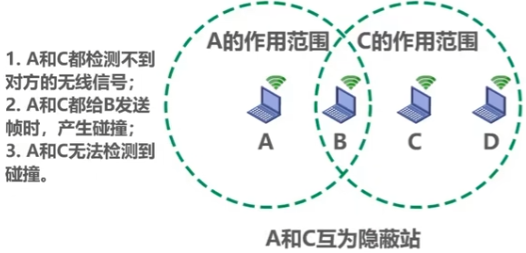
隐蔽站问题即信号碰撞后产生的碰撞信号无法被接收到 在图中A、C互为隐蔽站
:star::star
发送
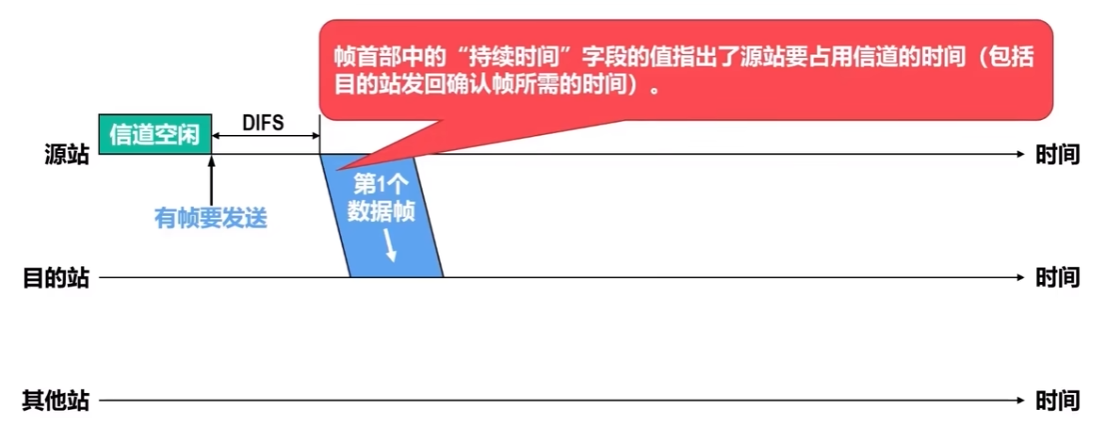
DCF 帧间间隔 DIFS 的长度为 128μs,在 DCF 方式中,DIFS 用来发送数据帧和管理帧,等待DIFS间隔是考虑到其他站可能有更高优先级的帧需要发送
- DCF 是 分布式协调功能(Distributed Coordination Function, DCF)** 的英文缩写词。在 DCF 方式下,没有一个 “总控” 设备来分配信道使用权,所有设备(手机、电脑等)都要通过CSMA/CA 协议“抢”信道,谁抢到谁就能发送数据。DCF 方式是 802.11 定义的默认方式(必须实现)。
虚拟载波监听机制和信道预约
虚拟载波监听机制 ——— 在数据帧中加入占用信道持续时间
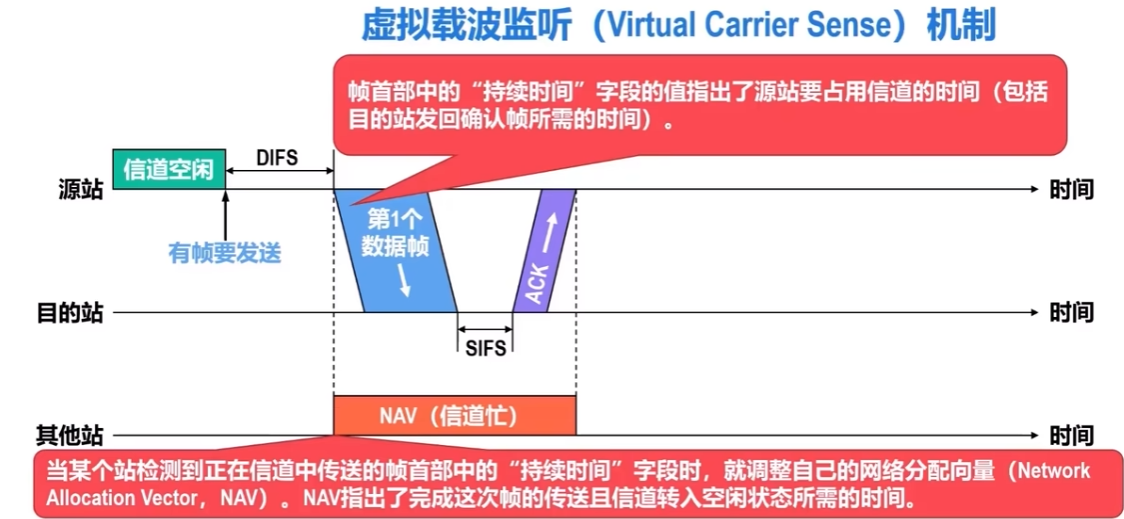
由于无线传输误码率较高,无线局域网传输时使用的是[SW可靠传输协议](#停止-等待协议(Stop-and-Wait , SW)),会发送确认帧ACK,同样有超时重传,且重传多次都未成功会放弃重传
- 短帧间间隔(Short Interframe Space, SIFS)的长度为 28μs,在 Wi-Fi 中优先级最高、间隔最短的帧间间隔,核心作用是保障 “对话类帧” 的快速响应:使用 SIFS 的帧类型有 ACK 帧、CTS 帧等。
:star: 信道预约 ——— 在RTS CTS帧中加入占用信道持续时间
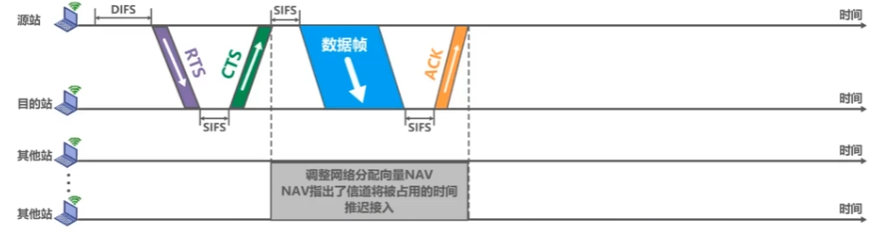
源站检测到信道空闲并经过DIFS间隔后向目的站发送RTS帧进行预约请求,RTS帧中携带了占用信道的持续时间
目的站接收到RTS帧后会向**范围内的所有站点(包括源站)**发送CTS帧(CTS帧会从RTS帧中将占用信道时间复制过来),当除了源站的其他站收到了CTS帧后就知道了信道在一段时间内会被占用。这样他们就会推迟发送
当源站收到CTS帧后经过SIFS间隔就可以发送数据帧了,这样就通过RTS、CTS帧成功进行了信道的预约,解决了隐蔽站问题
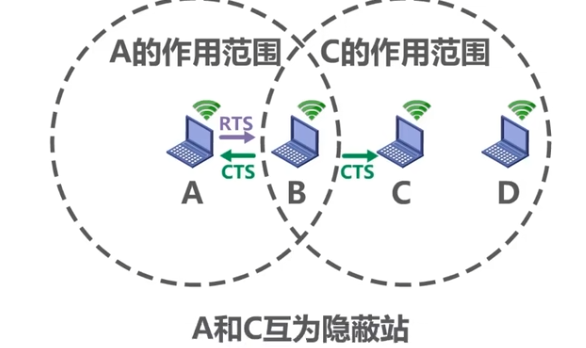
如图所示,AC互为隐蔽站,彼此无法进行交流。A发送RTS帧进行预约,预约成功后B会向范围内的站点发送CTS帧,告知除A外的其他站点,在一段时间内信道被A预约了。当其他站点收到CTS帧后就不会再向B发送数据帧,避免了碰撞
- 若RTS帧发生碰撞会执行退避算法重传
- 由于RTS帧和CTS帧很短,发送碰撞的概率、碰撞产生的开销及本身的开销都很小。而对于一般的数据帧,其长度往往大于传播时延(因为是局域网),碰撞的概率很大,且一旦发生碰撞而导致数据帧重发,则浪费的时间就很多,因此用很小的代价对信道进行预约往往是值得的。
二者意义
由于利用虚拟载波监听和信道预约,站点只要监听到RTS 帧、CTS 帧或数据帧中的任何一个,就能知道信道被占用的情况(无线信道是 “广播介质”,无线局域网的所有信息都是广播特性),而不需要真正监听到信道上的信号,因此虚拟载波监听机制能减少隐藏站带来的碰撞问题。
CSMA/CA中的避退算法
:star<碰撞避免ca>
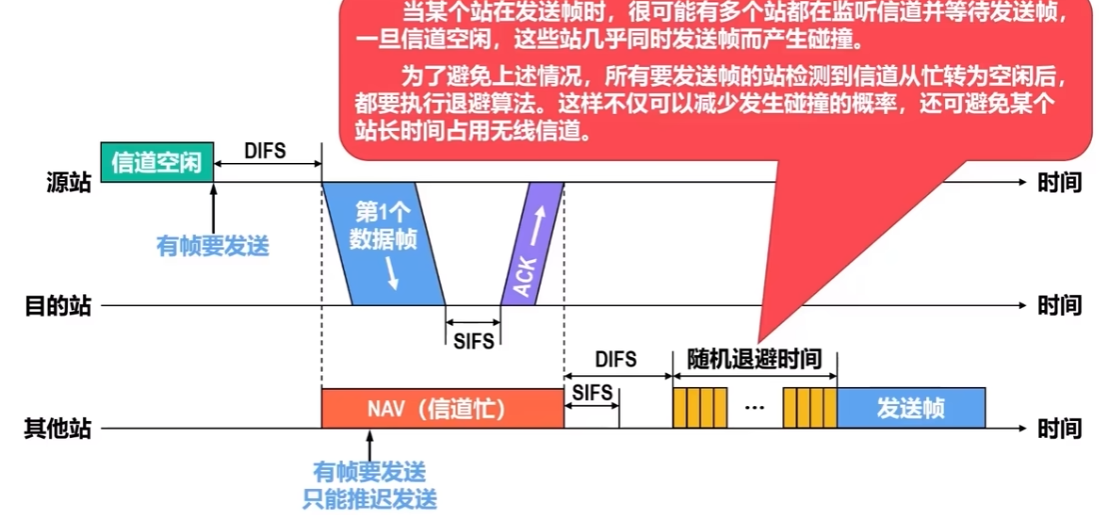
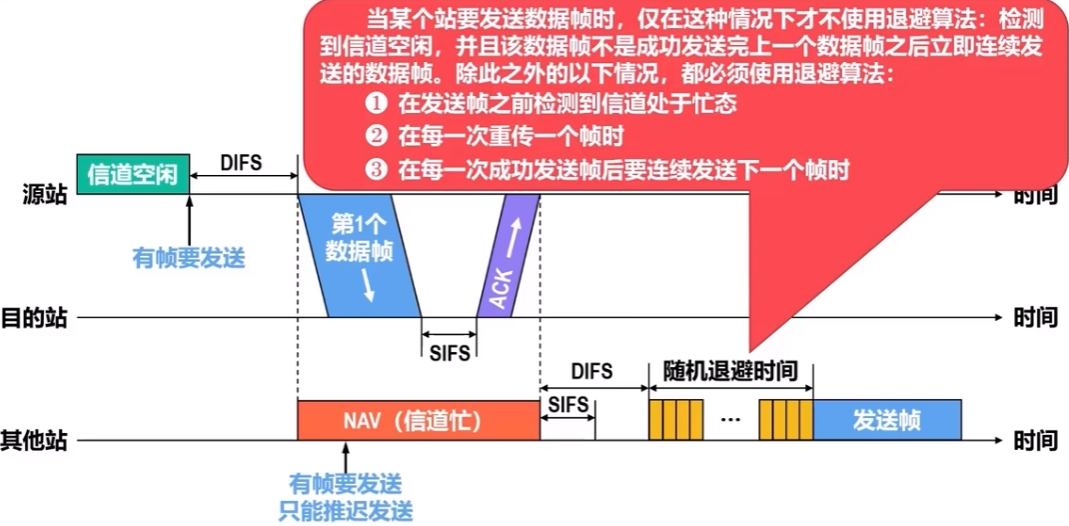
:star
/CA的退避算法
在执行退避算法时,站点为退避计时器设置一个随机的退避时间:
当退避计时器的时间减小到零时,就开始发送数据;
当退避计时器的时间还未减小到零时而信道又转变为忙状态,这时就冻结退避计时器的数值,重新等待信道变为空闲,再经过帧间间隔DIFS后,继续启动退避计时器。
在进行第次退避时,退避时间在时隙编号****中随机选择一个,然后乘以基本退避时间(也就是一个时隙的长度)就可以得到随机的退避时间。当时隙编号达到255时(对应于第6次退避)就不再增加了。
示意图
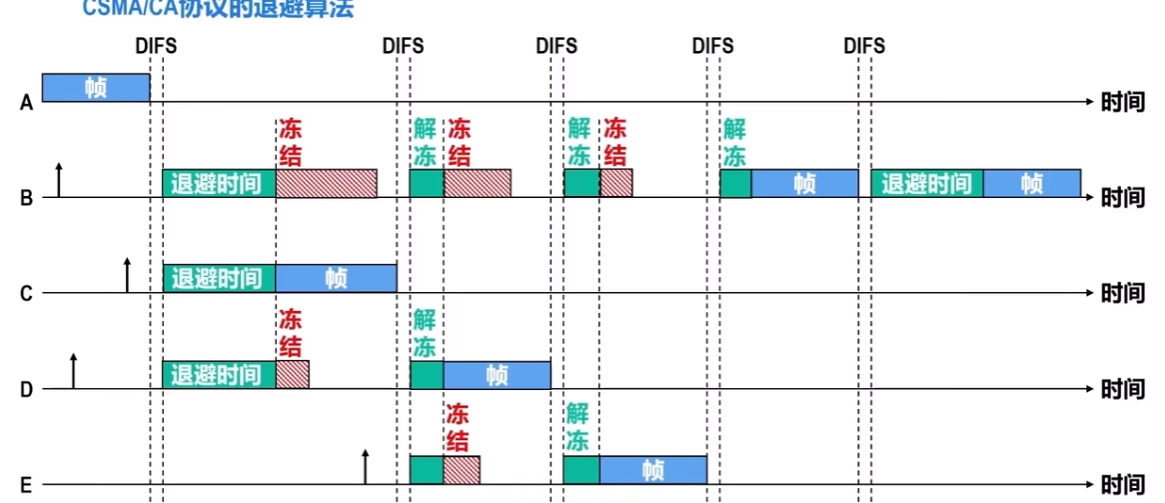
详解 6~10min
CSMA/CA习题
习题1
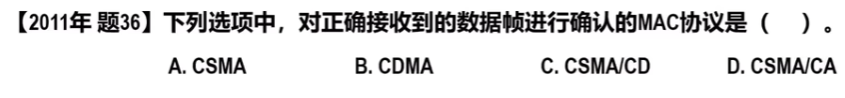
D 无限传播误码率较高,所以CSMA/CA协议会发送确认帧ACK
习题2
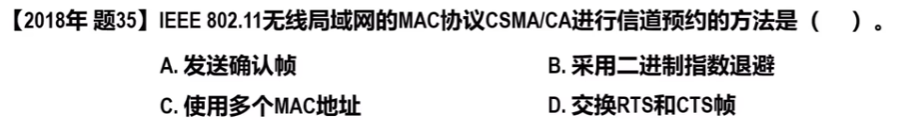
D
习题3
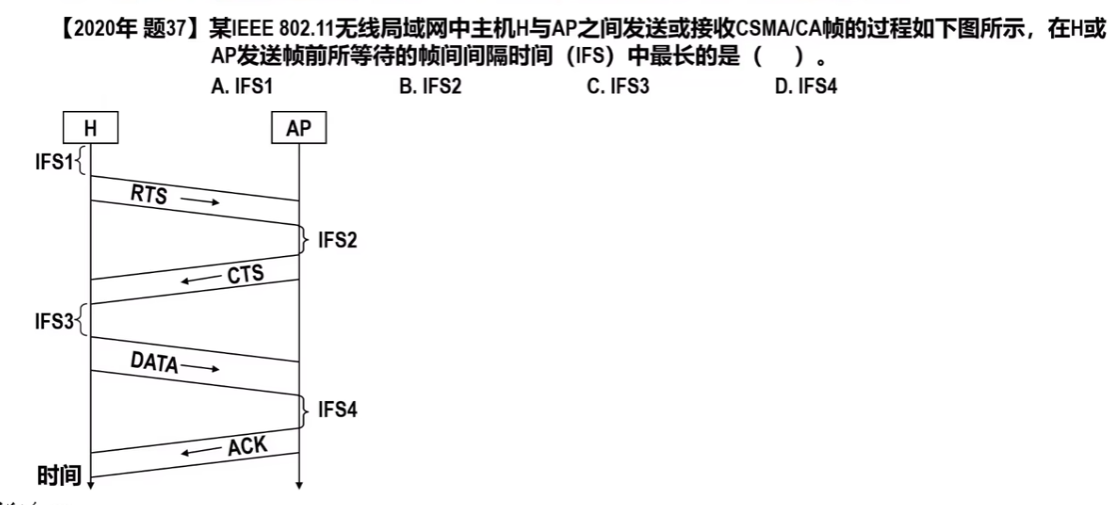
A IFS1是DIFS 其余三个都是SIFS
无线局域网的MAC帧
数据帧
用于在站点间传输数据
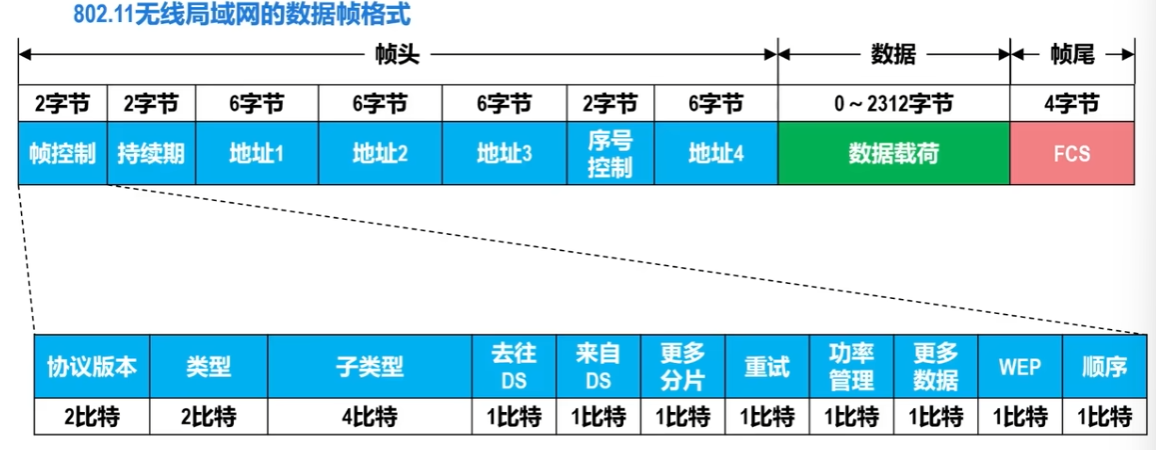
去往/来自DS
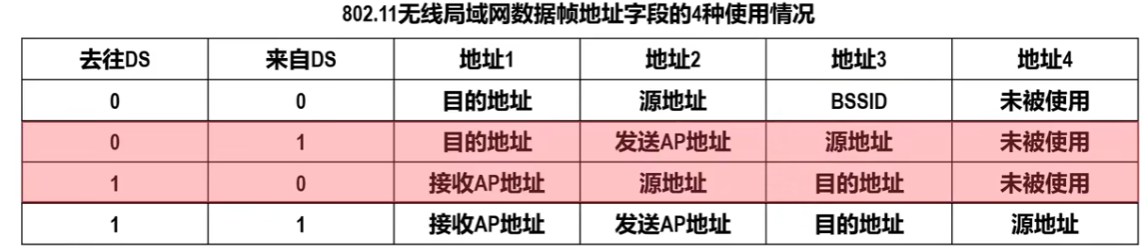
用于控制地址1/2/3/4 这四个字段的内容和使用情况
类型/子类型
用于区分不同类型的帧(数据/控制/管理)
有线等效保密WEP控制位
用于指示是否使用了WEP加密算法
持续期
用于实现CSMA/CA的虚拟载波监听和信道预约机制。在数据帧、RTS帧和CTS帧中用该字段指出将要持续占用信道的时长。
序号控制
实现SW[可靠传输](#停止-等待协议(Stop-and-Wait , SW)),对数据帧编号
控制帧
通常与数据帧搭配使用
负责区域的清空、虚拟载波监听的维护以及信道的接入,并于收到数据帧时予以确认。
ACK 帧、RTS 帧以及 CTS 帧等都属于控制帧。
管理帧
用于加入或退出无线网络,以及处理 AP 之间连接的转移事宜。
信标帧、关联请求帧以及身份认证帧等都属于管理帧。

无线局域网的MAC帧习题
习题
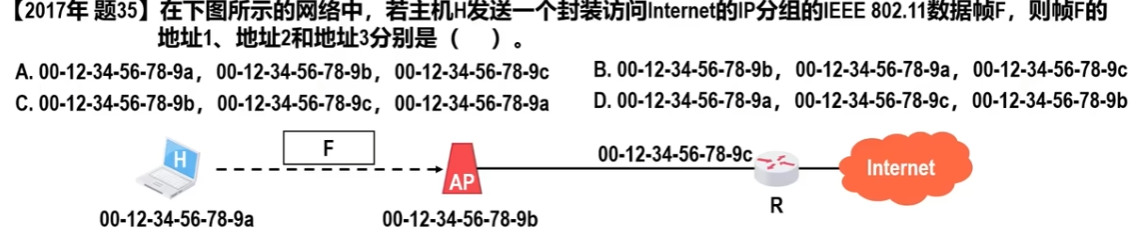
去往DS:1 来自DS:0 查表地址1/2/3分别为 AP地址 源地址 目的地址
9b 9a 9c B
四、网络层
1.网络层概述
- 网络层主要任务是实现网络互连,进而实现数据包在网络之间的传输
- 网络层所需解决的问题
- 网络层向运输层提供怎样的服务?(可靠传输还是不可靠传输)
- 网络层寻址问题
- 路由路径选择问题 –> 路由表
2.网络层提供的两种服务
面向连接的虚电路服务
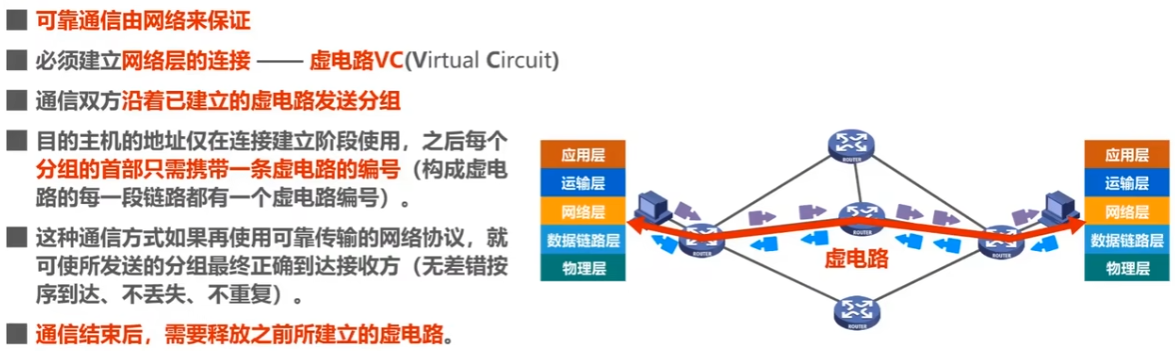
注意:虚电路是逻辑上建立连接
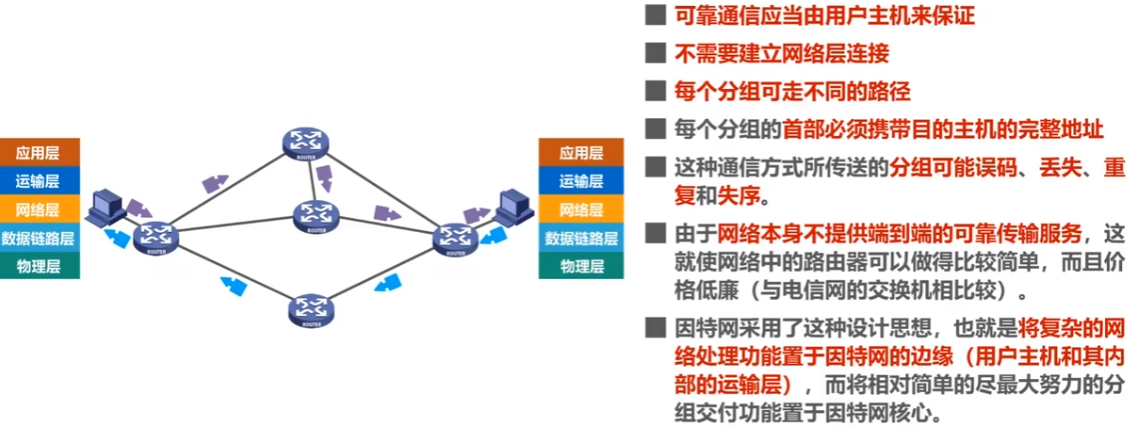
无连接的数据报服务(TCP/IP体系结构采取的方式)
3.IP地址
简介
IP地址是因特网上的主机和路由器所使用的地址,用于表示两部分信息
- 网段编号:标识不同网段
- 主机编号:同一网段下的不同主机(或路由器接口)
tip:具体哪几位表示网段哪几位表示主机 主要通过子网掩码决定
与MAC地址的区别
很显然,之前介绍的MAC地址不具备区分不同网络的功能。
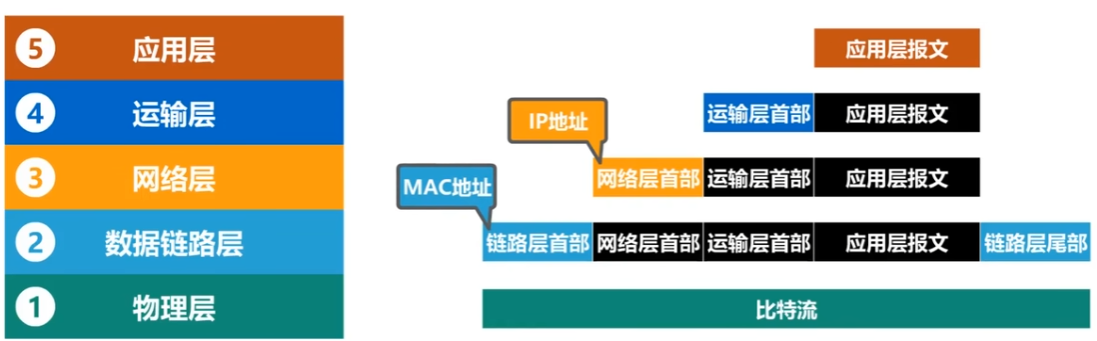
- 如果只是一个单独的网络,不接入因特网,可以只使用MAC地址(这不是一般用户的应用方式)。
- 如果主机所在的网络要接入因特网,则IP地址和MAC地址都需要使用。
网络体系结构中的IP和MAC
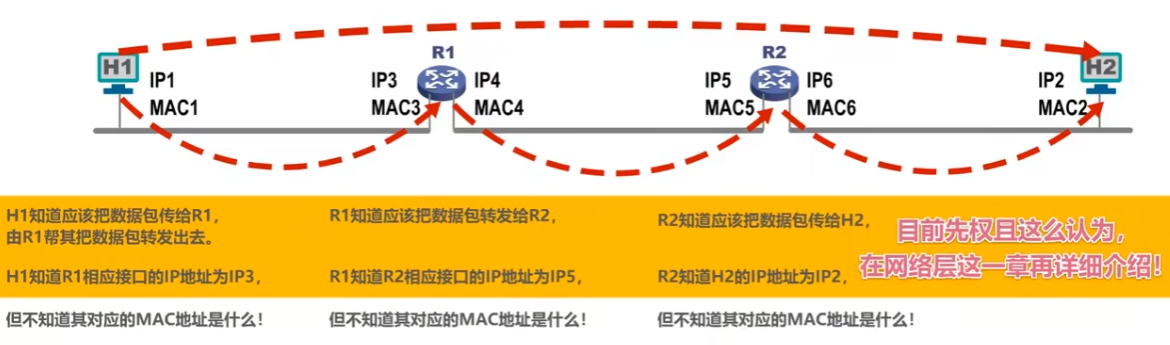
数据包转发过程中IP和MAC的变化
IP地址是不变的,MAC地址是逐链路变化的
示意图
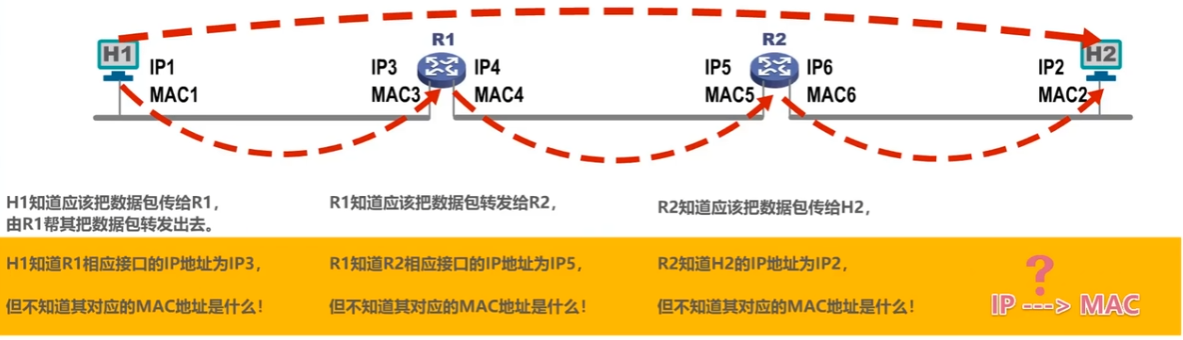
tip:IP–>MAC的转换就要用到ARP地址转换协议
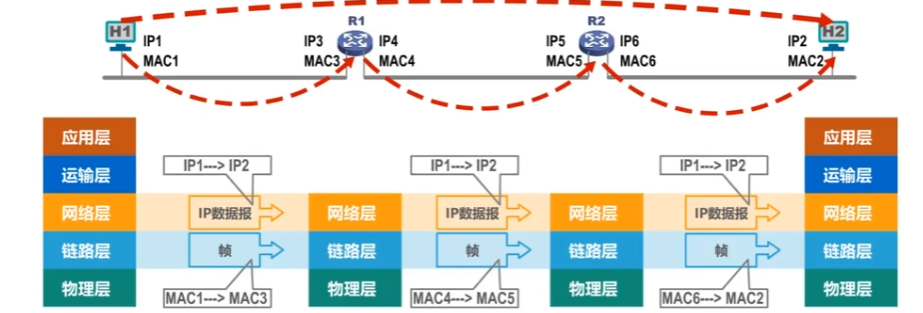
IP习题
习题
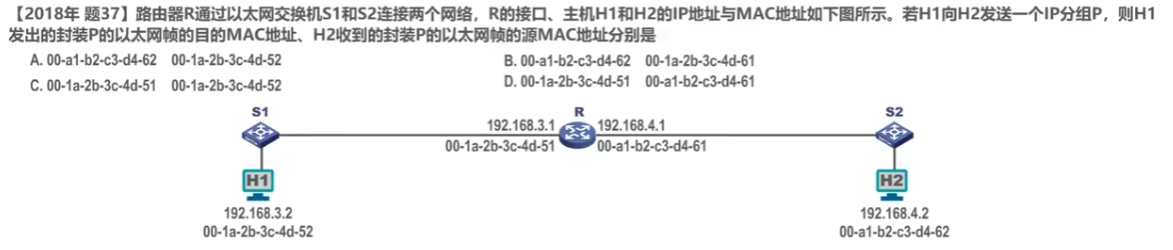
MAC地址逐链路变化, H1–>H2 的详细传播路径应该是 H1–>R–>H2 所以选D
4.ARP协议
所解决的问题
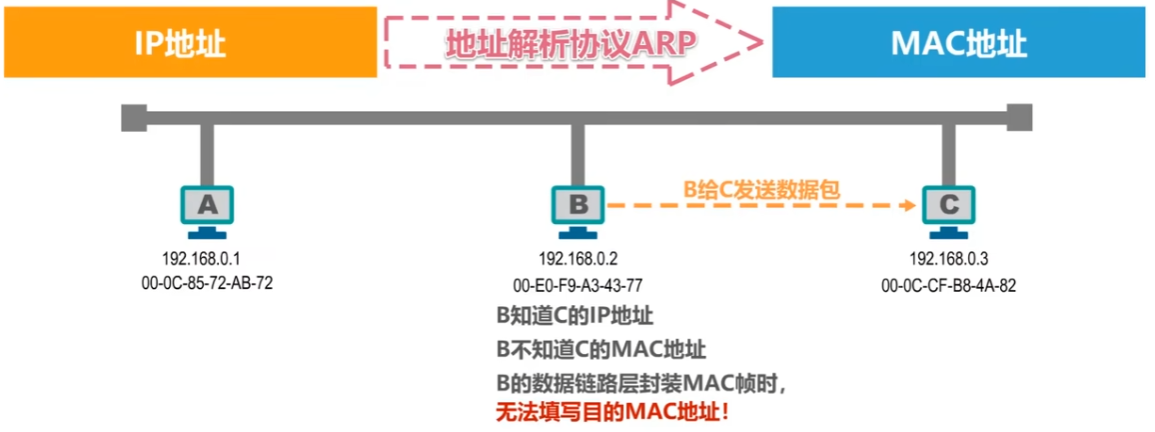
为什么知道IP地址?
IP地址是建立通信的前提,比如要访问一个网站,在对网站进行域名解析(DNS)后也可以知道其IP地址。
为什么不知道MAC地址?
MAC地址是设备接口的编号,只在本地链路上有效,其他设备根本没法提前知道。
ARP工作原理
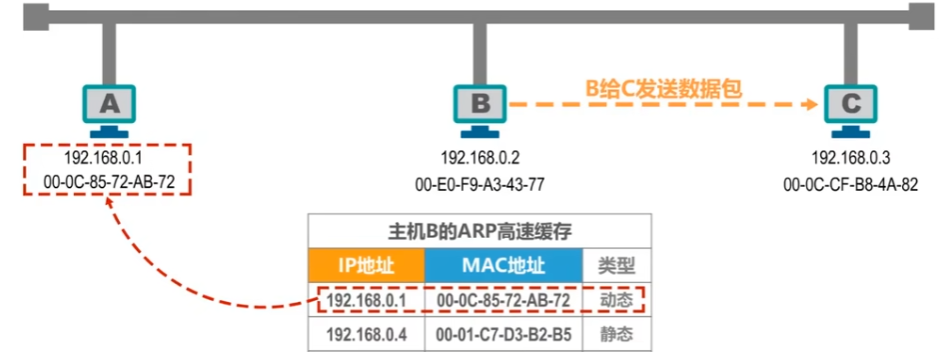
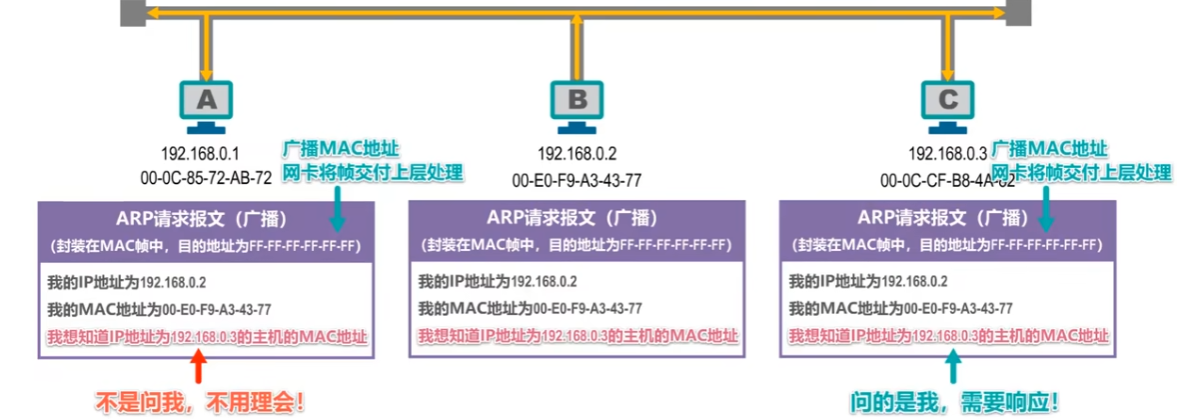
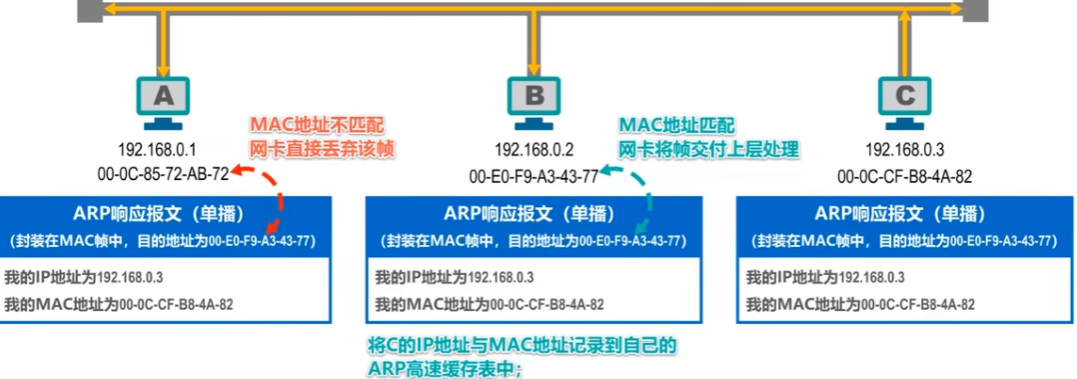
每个主机内都会有一张ARP高速缓存表,存储的内容是IP地址和与其对应的MAC地址
ARP高速缓存表补充
ARP缓存表中每条记录都会有类型,可分为两类
- 动态:自动获取,生命周期默认为两分钟; 原因:MAC地址和IP地址不是永久对应的
- 静态:手工设置,不同操作系统下的生命周期不同,例如系统重启后不存在或系统重启后依然有效。
解析
由于ARP协议需要以帧的形式转发ARP请求报文,所以ARP协议只能在同一网段中使用。所以MAC地址是随网段变化而变化的
5.IPv4地址
概述
在TCP/IP体系中,IP地址是一个最基本的概念
IPv4地址就是给因特网上的每一台主机(路由器)的每一个接口分配一个在全世界范围内唯一的32bit的标识符
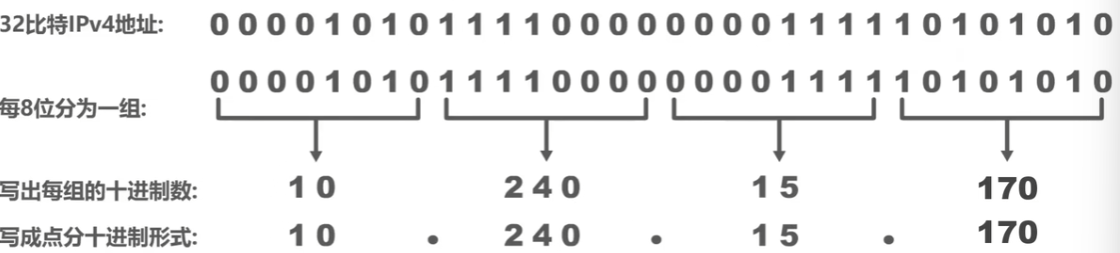
由于32位IPv4地址不方便阅读、记录、输入,因此IPv4地址采用点分十进制的方法以方便用户进行使用
三种不同的IPv4编址方式
分类编址
A类地址
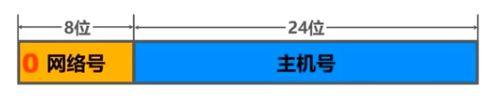
8位网络号的最高位固定为0
当8位网络号全取0时不可以被指派给其他的设备接口
其余7位都为1时,取到最大的网络号127,作为本地环回测试地址,不指派
- 最小的本地环回测试地址为127.0.0.1
- 最大的本地环回测试地址为127.255.255.254
B类地址
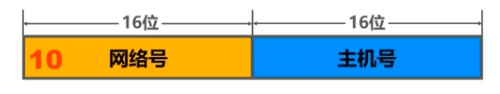
- 16位网络号最高两位固定为10
- 最小网络号也是第一个可以指派的网络号是128.0
- 最小网络地址为128.0.0.0
- 最大网络号也是最后一个可以指派的网络号是191.255
- 最大的网络地址为191.255.0.0
C类地址
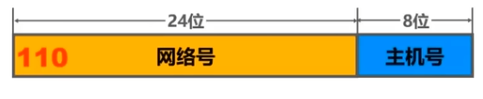
24位最高三位固定为110
最小网络号也是第一个可以指派的网络号是192.0.0
最小网络地址为192.0.0.0
最大网络号也是最后一个可以指派的网络号是223.255.255
- 最大的网络地址为223.255.255.0
D类地址
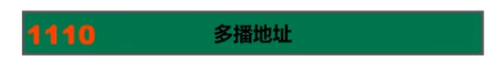
E类地址
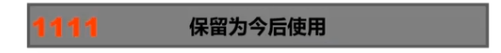
- 注意
- 只有A类、B类和C类地址可分配给网络中的主机或路由器的各接口
- 主机号为“全0”的地址是网络地址,不能分配给主机或路由器的各接口
- 主机号为“全1”的地址是广播地址,不能分配给主机或路由器的各接口
分类编址习题
习题1
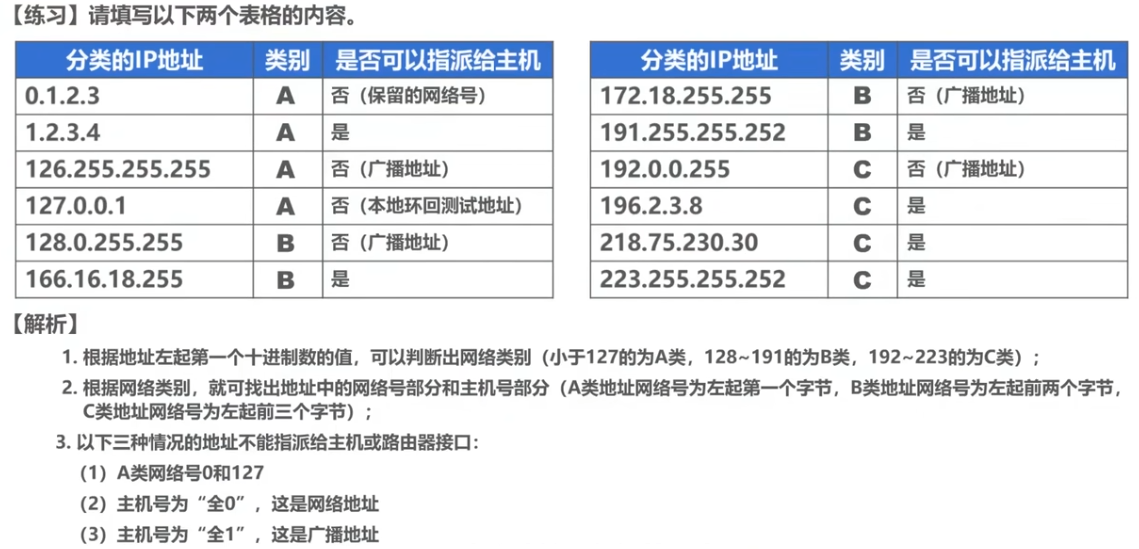
习题2
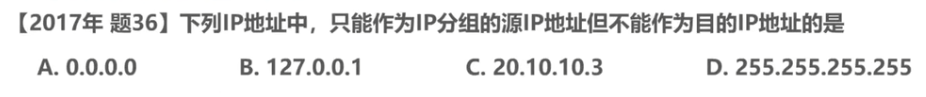
补充:源地址:发送数据包的地址 目的地址:接收数据包的地址
解析
地址0.0.0.0是一个特殊的IPv4地址,只能作为源地址使用,表示“在本网络上的本主机”。封装有DHCP Discovery报文的IP分组的源地址使用0.0.0.0;
以127开头且后面三个字节非“全0”或“全1”的IP地址是一类特殊的IPv4地址,既可以作为源地址使用,也可以作为目的地址使用,用于本地软件环回测试,例如常用的环回测试地址127.0.0.1;
地址255.255.255.255是一个特殊的IPv4地址,只能作为目的地址使用,表示“只在本网络上进行广播(各路由器均不转发)”。
综上所述,选项A正确。
习题3
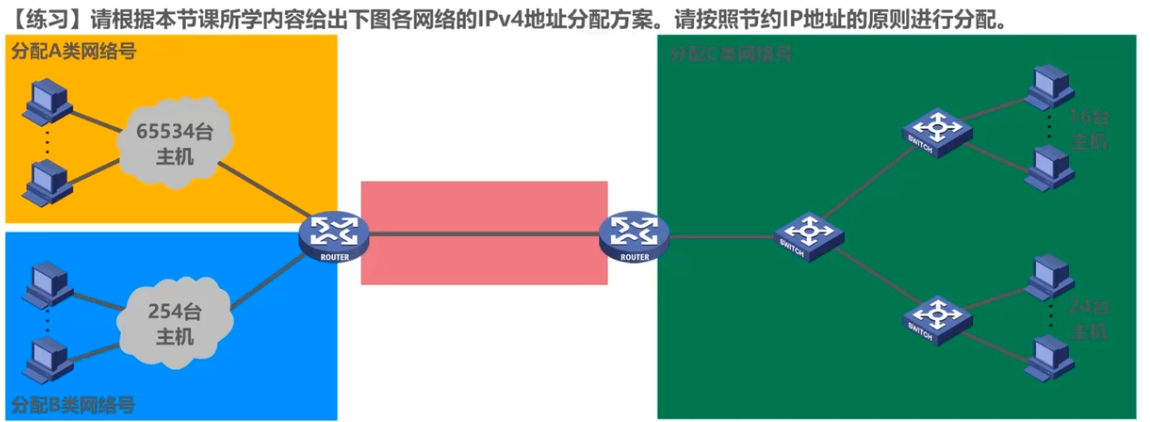
如图所示共有4个网络区域,接下来我们对每个区域分配合适的网络地址类型
橙色
橙色区域有65534台主机,加上路由器的接口共65535个接口,分配A类网络号(A类网络号最少,但可分配的接口数量最多)
蓝色
加上路由器共255个接口,可分配A、B类网络号,但为了节约IP地址,选择B类网络号
绿色
加上路由器共41个接口,可分配A、B、C类网络号,为了节约IP地址选择C类
红色
红色共两个接口 同绿色 选择C类网络号
在选好了网络类型后选择一个网络号并分配IP地址
划分子网编址
诞生原因
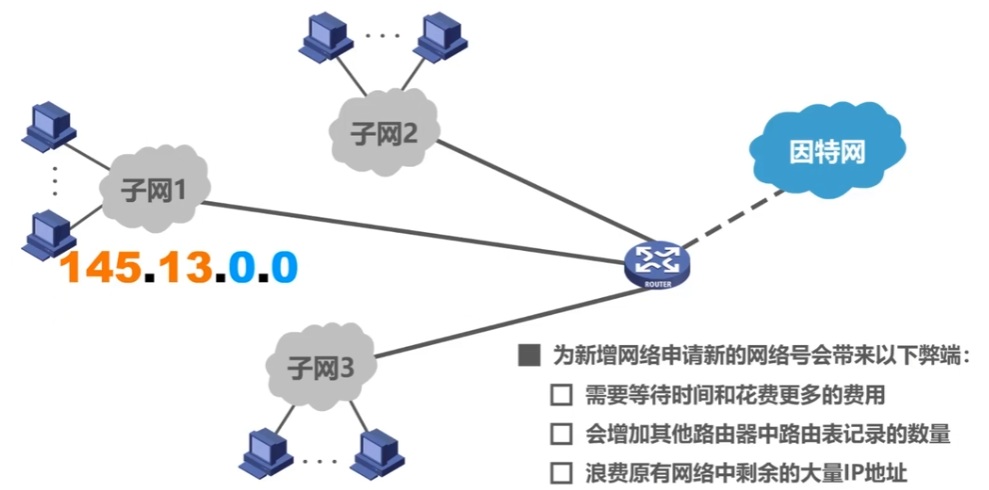
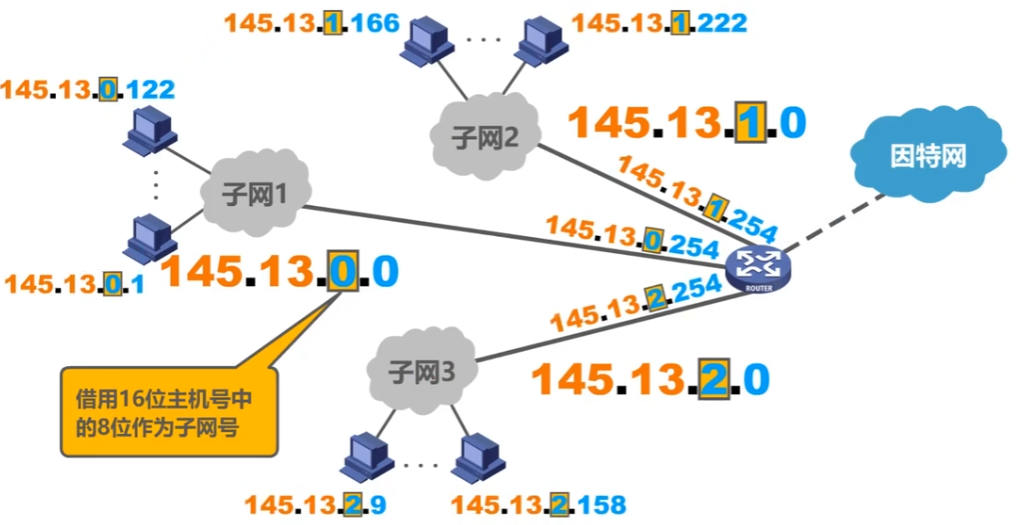
当一个组织申请了一个网络号后,想在组织内部再划分出几个子网,此时如果再为每个子网额外申请一个网络号会造成不必要的浪费。所以可以将原先申请的网络号的一些主机位作为子网的网络号
例如:
如此一来就将申请来的网络号划分为了不同的子网,但是该如何让计算机区分网络号和主机号呢?— 子网掩码
子网掩码
32bit的子网掩码可以表明分类IP地址的主机号部分被借用了几个比特作为子网号
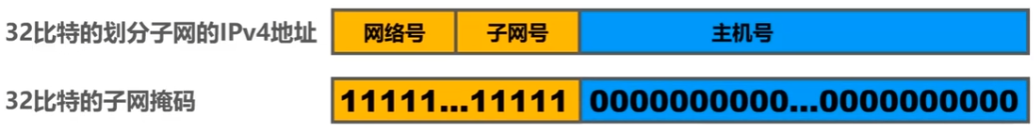
用连续的1来表示这一块对应网络号和子网号
用连续的0来表示这一块对应主机号
随后只要使用逻辑与运算就可以截取网络号和子网号 (任何数&1=其本身 任何数&0=0)
例子

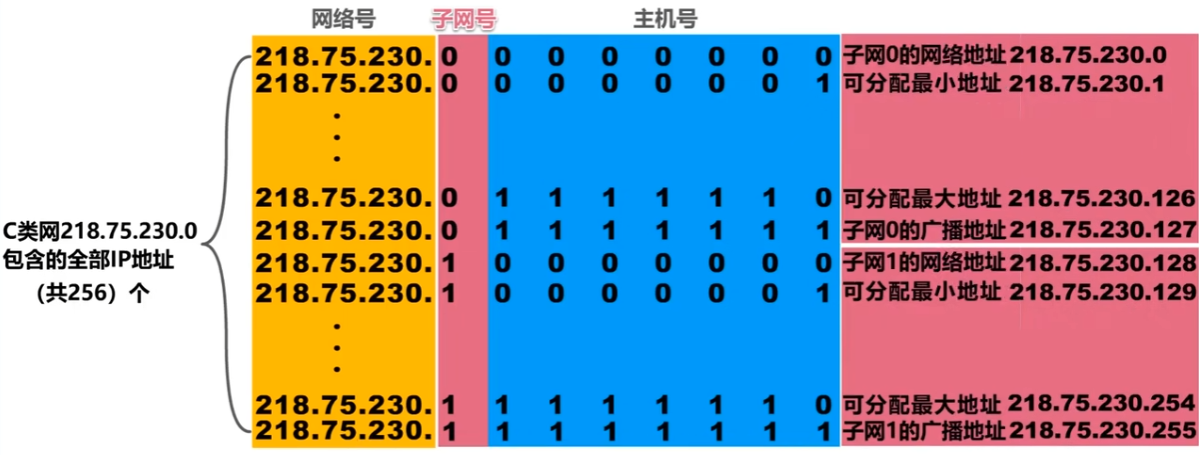
解析
子网掩码为255.255.255.128
对应二进制为:11111111 11111111 11111111 10000000
共有25个连续的1 代表前25个bit为网络号+子网号
由因为网络号为218.75.230.0 说明是C类地址,前24位是网络号
综上 前24位网络号 第25位子网号 后7位主机号
推论
此网络分为了两个子网 (子网0和子网1)
每个子网可以分配 个IP地址 (减2去掉的全0的网络地址和全1广播地址的部分)
划分子网编址习题
习题1
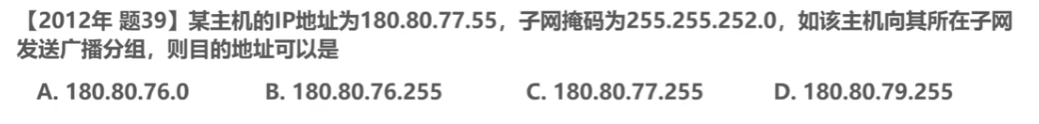
最高位是180说明是B类网络,那么子网掩码中的前两位255代表网络号
重点关注子网掩码第三位252 转换为二进制:11111100 共有个子网
现发送广播 主机位全为1 A排除
76的二进制:01001100 排除 77二进制<010011>01 排除 79的二进制 01001111 选D
无分类编址
诞生背景
具体编制方式
CIDR使用**“斜线记法”,或称CIDR记法。即在IPv4地址后面加上斜线“/”,在斜线后写上网络前缀所占的比特数量。**
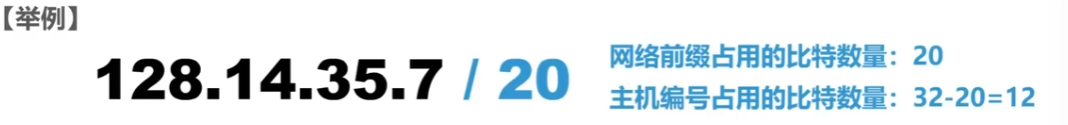
CIDR实际上是将网络前缀都相同的连续IP地址(即:同一网段下的IP地址)组成了一个“CIDR地址块” tip:网络前缀就是 “自定义长度的网络号”
由此 我们只要知道CIDR地址块中的一个地址 就能知道它的所有细节

/20 代表将第一个字节、第二个字节、第三个字节的前四位 共20bit位作为网络号(网络前缀)
将第三、四字节化为二进制:00100011 00000111 标红部分是网络号的一部分
最小地址:128.14.32.0 最大地址:128.14.47.255 地址数量:
聚合C类网数量: 2^8^代表C类网的主机数量 地址掩码:20个连续的比特1+12个连续的比特0
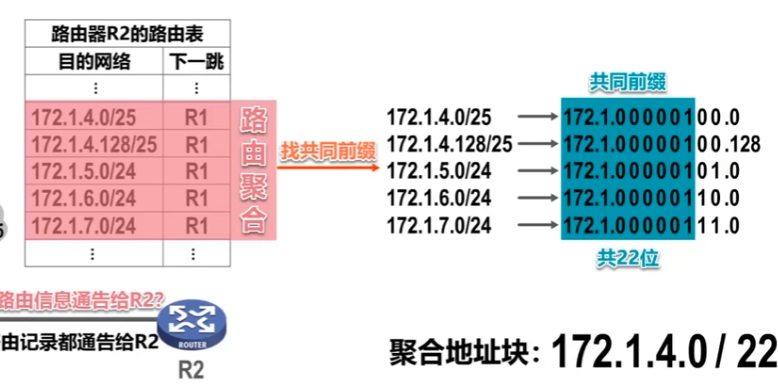
路由聚合(构造超网)

网络前缀越长,说明网络号越长,说明主机号越少,说明网络范围越小
最长前缀匹配(路由器的核心规则)
当路由器收到一个数据包,发现它的目的 IP 地址同时匹配路由表中的多条记录时,它会选择前缀最长的那条路由转发。
无分类编址习题
习题1
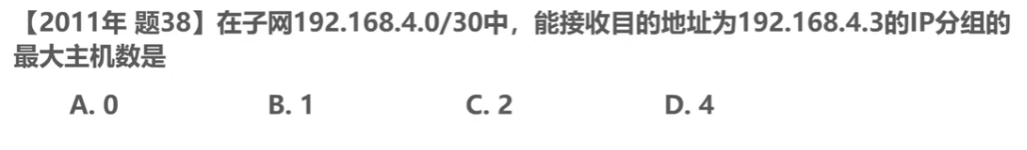
子网:192.168.4.00000000 标红网络号 目的地址:192.168.4.00000011 — 广播地址
能接收到的 去掉广播地址和网络地址 C
习题2
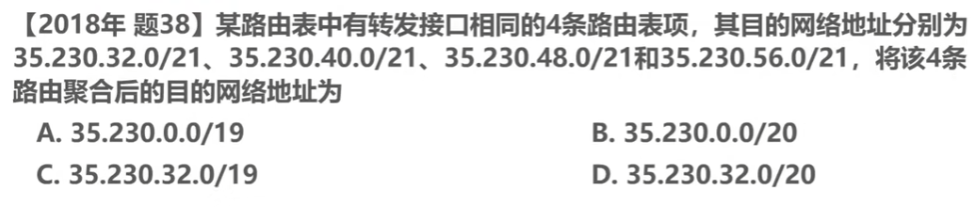
前两位都一样 主要看第三位 分别将四个地址的第三位转化为二进制如下
00100000 00101000 00110000 00111000 可见共同最长前缀是001
聚合网络地址:35.230.32.0/19 C
IPv4地址的应用规划
定长子网掩码(Fixed Length Subnet Mask FLSM)划分
即:使用同一个子网掩码来划分子网,每个子网所分配的IP地址数量相同,会造成浪费
例子
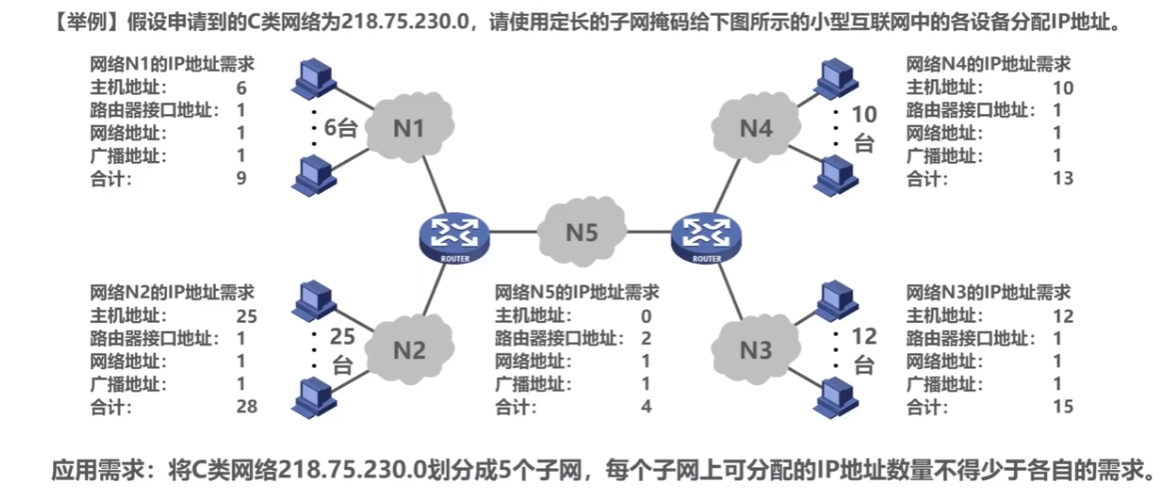
经分析可得,我们需要借用主机号上3个比特位作为子网号
则子网掩码为:255.255.255.224 有了子网掩码就可以进行子网的分配了
变长子网掩码(Variable Length Subnet Mask VLSM)划分
即:使用不同子网掩码来划分子网,每个子网所分配的IP地址数量可以不同,尽可能减少浪费
例子
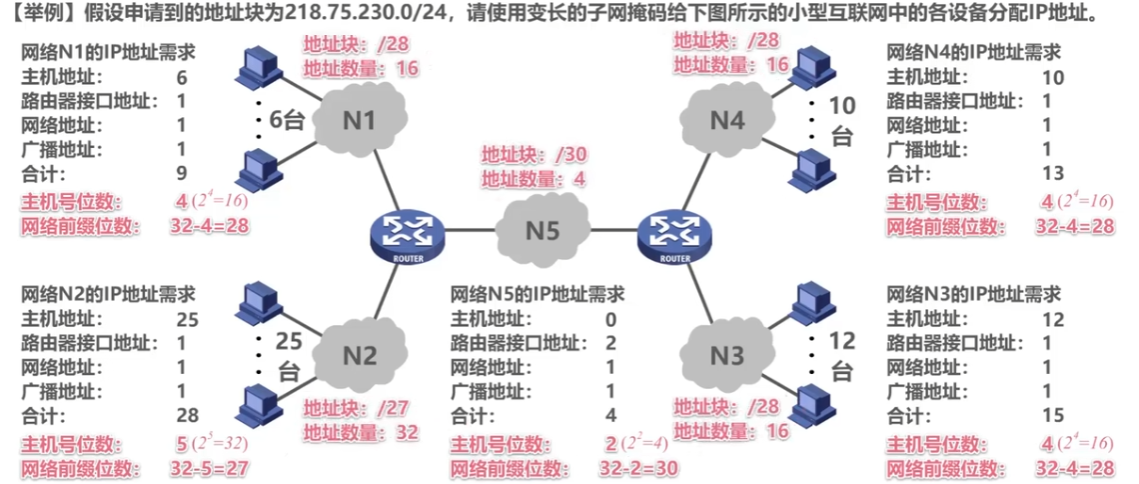
实际上就是用无分类编址CIDR来为每一个不同的子网根据其自身的情况去找到一个最优的子网划分以最大程度地分配IP地址数量
得到每个子网各自的子网掩码后就可以进行子网的分配了
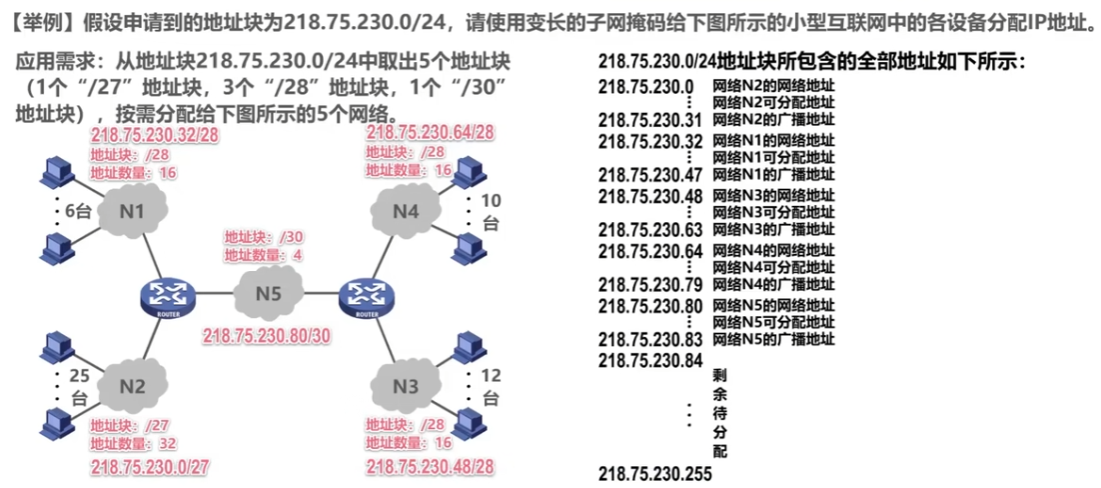
分配原则
在该地址块中给左图所示的网络 N1~N5 分配子块,分配原则是 “每个子块的起点位置不能随意选取,只能选取块大小整数倍的地址作为起点”。建议先给大的子块分配。
这样做的目的也是为了避免地址浪费、保证分配的规整性
6.IP数据报的发送和转发过程
源主机如何知道目的主机是否与自己在同一个网络中?
将源主机IP地址和目的主机IP地址通过和子网掩码进行“与”操作 (详见),来得到源主机的网段与目的主机网段,通过比较网段是否相同来得出是否在同一个网络中
当源主机目的主机不在同一网段时,源主机如何知道该把IP数据包交给哪个路由器转发
主机指定一个默认转发路由器 ——— 默认网关
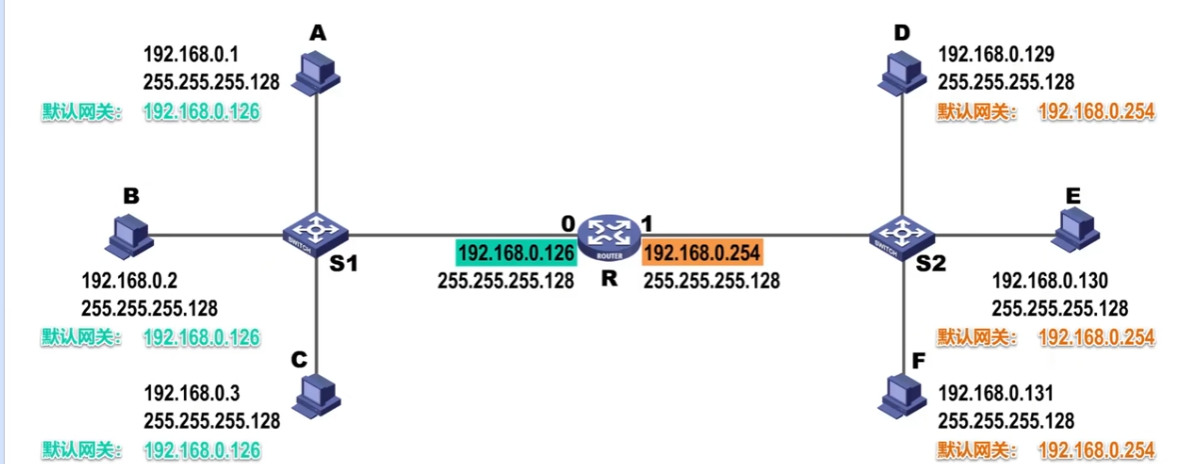
默认网关接收到IP数据报后如何转发?
检查IP数据报首部是否出错,若出错则丢弃并通告源主机 若没错则进行转发
根据IP数据报中的目的地址在路由表中查找匹配条目,若找到,则转发给条目指示的下一跳;若没找到则丢弃并通告源主机
具体过程
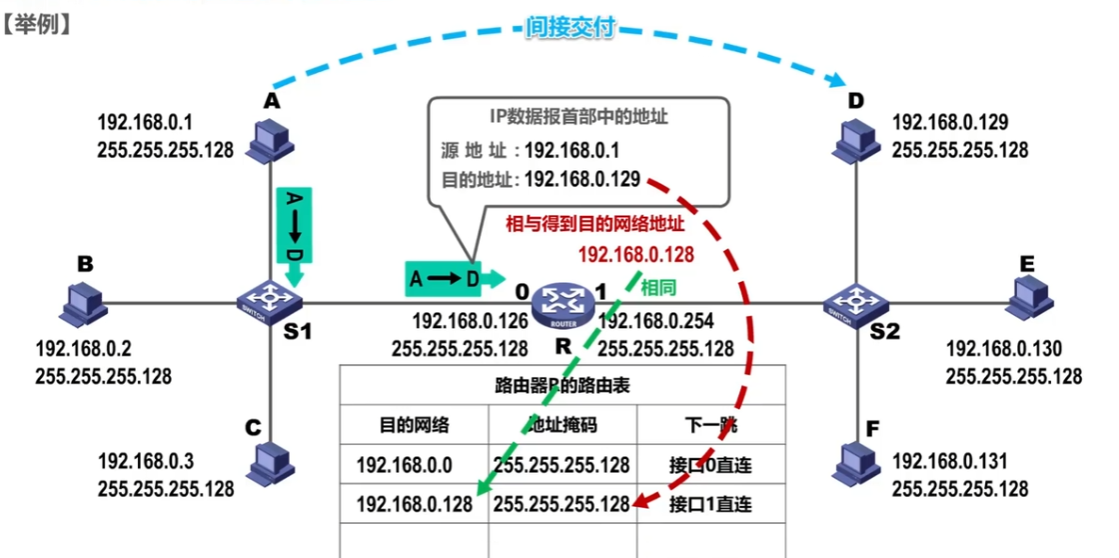
将目的IP地址和路由表中的地址掩码一一进行**“与”操作可以得到其目的网段**,将得到的目的网段和同行的目的网络进行对比,若相同则说明该转发到这个网段
- 实际的路由中会设计数据结构(查找树)以提高查找速度
- 我们划分子网后再进行广播数据报的发送时,由于广播数据报的定义为某网段下主机号全为1,所以当广播数据报转发到路由时,与地址掩码与操作后得到的网段不会得到匹配,所以路由器可以隔绝广播域
IP数据报的发送和转发过程习题
习题1
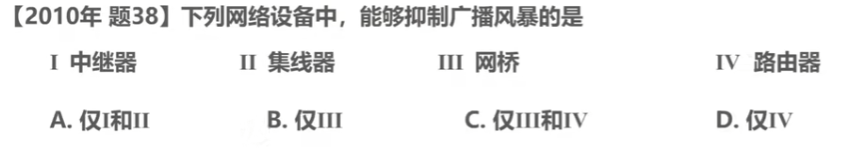
D
中继器和集线器工作在物理层,既不隔离冲突域也不隔离广播域
网桥和交换机工作在数据链路层,隔离冲突域不隔离广播域
路由器工作在网络层,隔离冲突域且隔离广播域
习题2
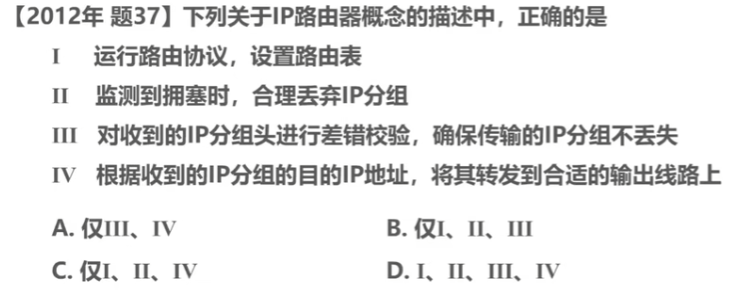
C
IP路由器工作在TCP/IP协议的网际层,网际层提供不可靠传输服务,进行差错检验只是为了确保IP分组无误码
习题3
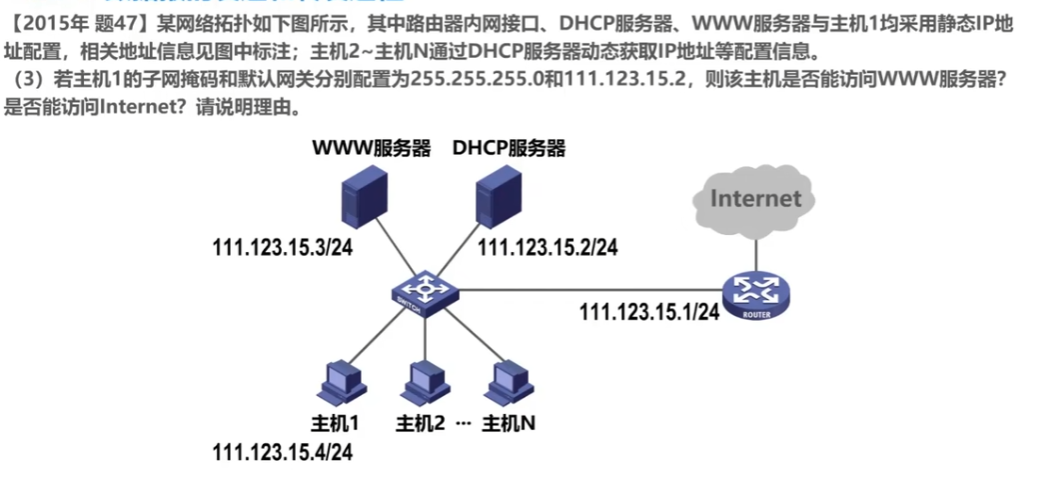
主机1和www服务器属于同一网段 所以可以访问
主机1的默认网关错误写成了 DHCP服务器的IP地址 DHCP服务器无法帮其转发分组 所以无法访问Internet
7.静态路由配置及其可能产生的路由环路问题
静态路由配置
静态路由配置
即:路由表由人工进行配置
这种人工配置方式简单、开销小。但不能及时适应网络状态(流量、拓扑等)的变化。
一般只在小规模网络中采用。
使用静态路由配置可能出现以下导致产生路由环路的错误
- 配置错误
- 聚合了不存在的网络
- 网络故障
举例
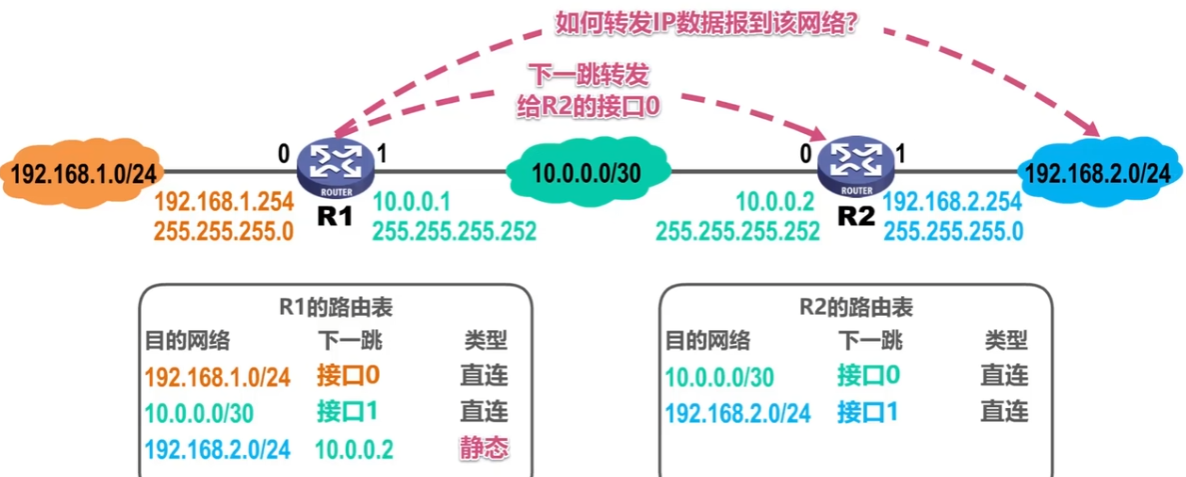
当路由的另一端连接的并不是目的网络时,如图:由于R1没有蓝色部分网络的网段,所以可以静态配置一条记录到路由表中
默认路由举例
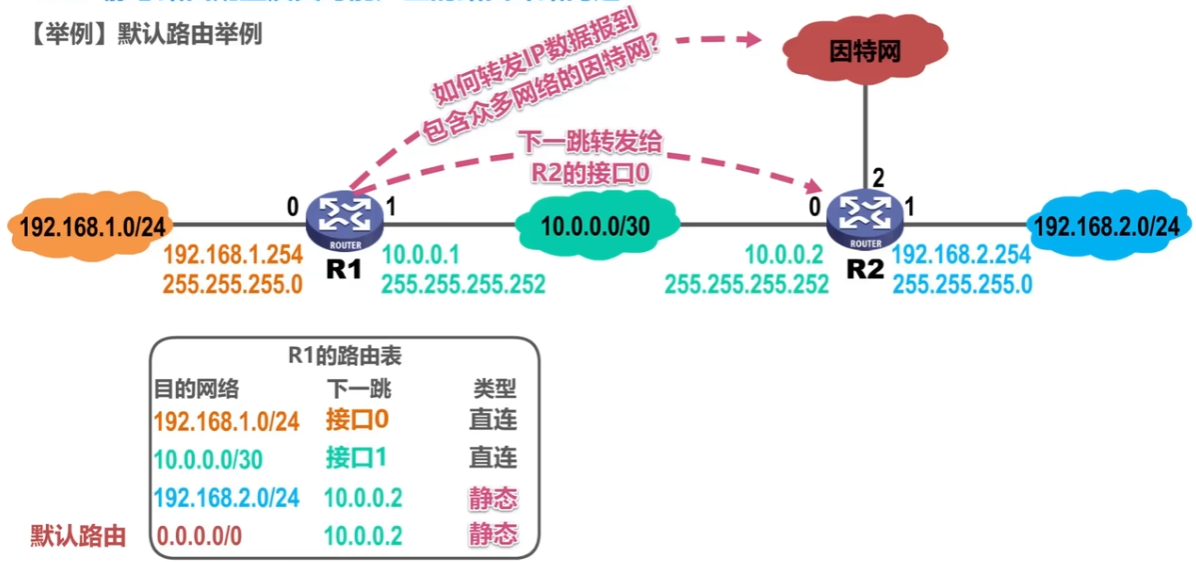
对于不同目的网络,但是其具有相同的下一跳(类似一个分岔路),如图中的R2 可以将其作为默认路由,当我们无法查找到目的网络时,统一发送给默认路由(0.0.0.0/0)
特定主机路由
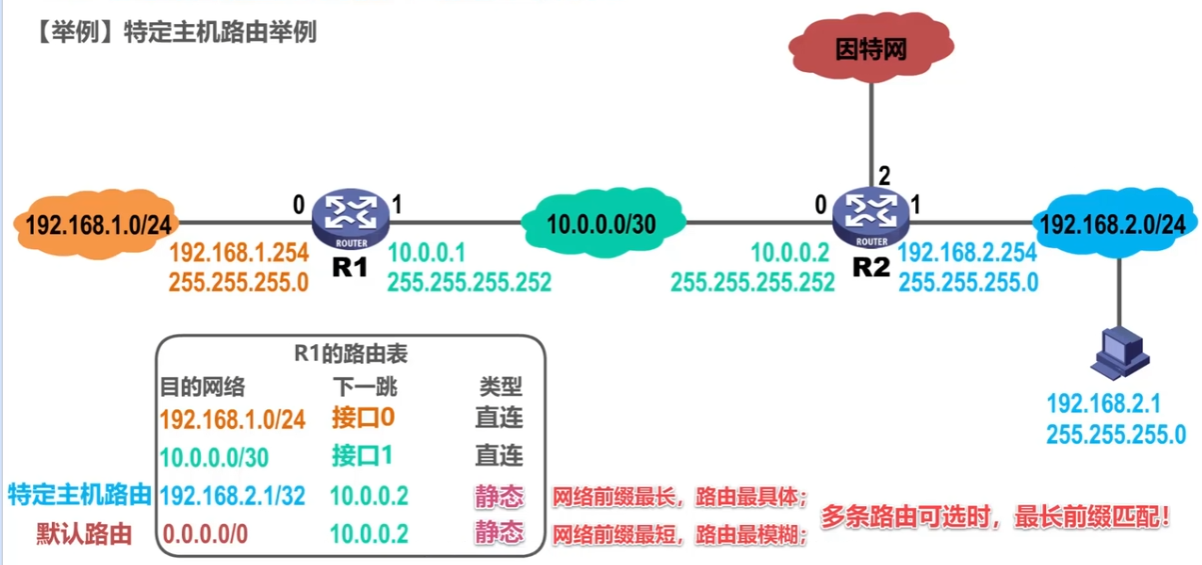
特定主机路由的子网掩码为255.255.255.255 只有当目的主机地址和其完全匹配时才会转发到该主机上
路由环路问题
当我们错误的配置路由表中的下一跳的信息时,就有可能形成这种环路,导致数据报一直在两个路由之间循环转发
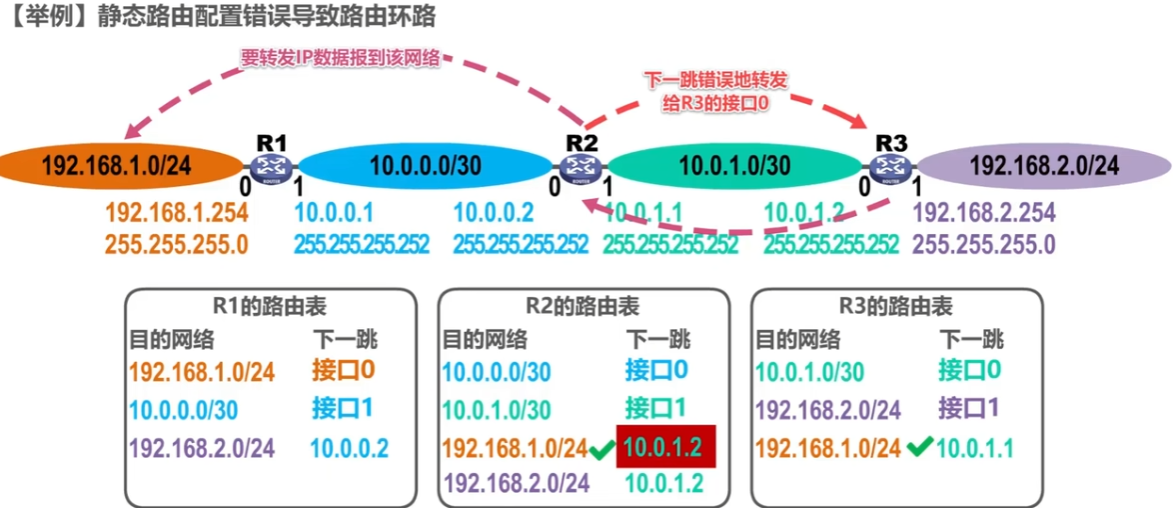
为了防止IP数据报的永久兜圈,在IP数据报首部设有生存时间TTL字段
每当IP数据报进入路由器TTL就会 -1 当TTL=0时 IP数据报被丢弃
当我们聚合了不存在的网络时,也有可能导致环路问题
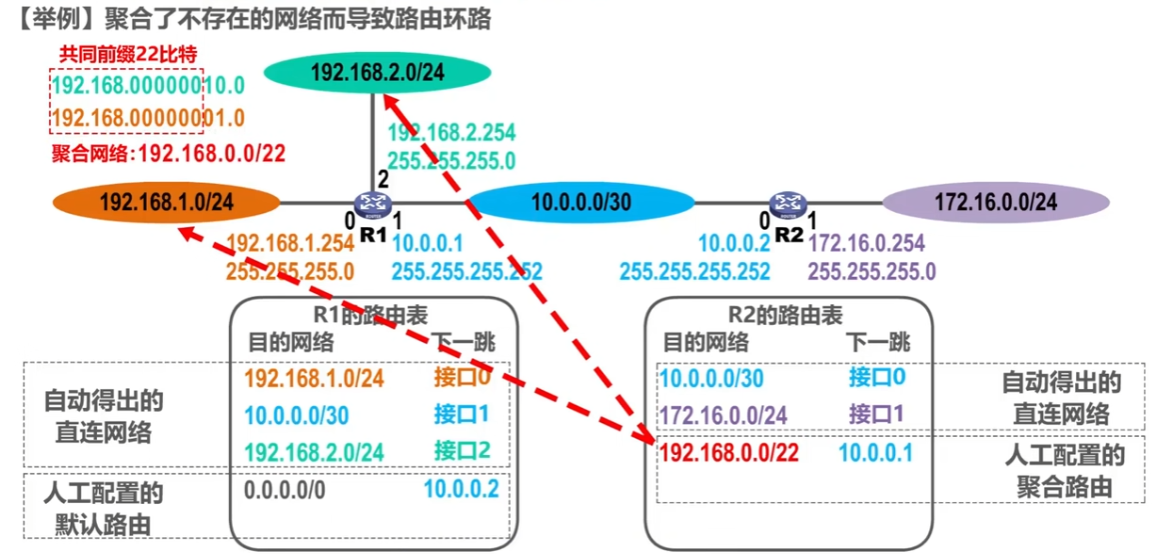
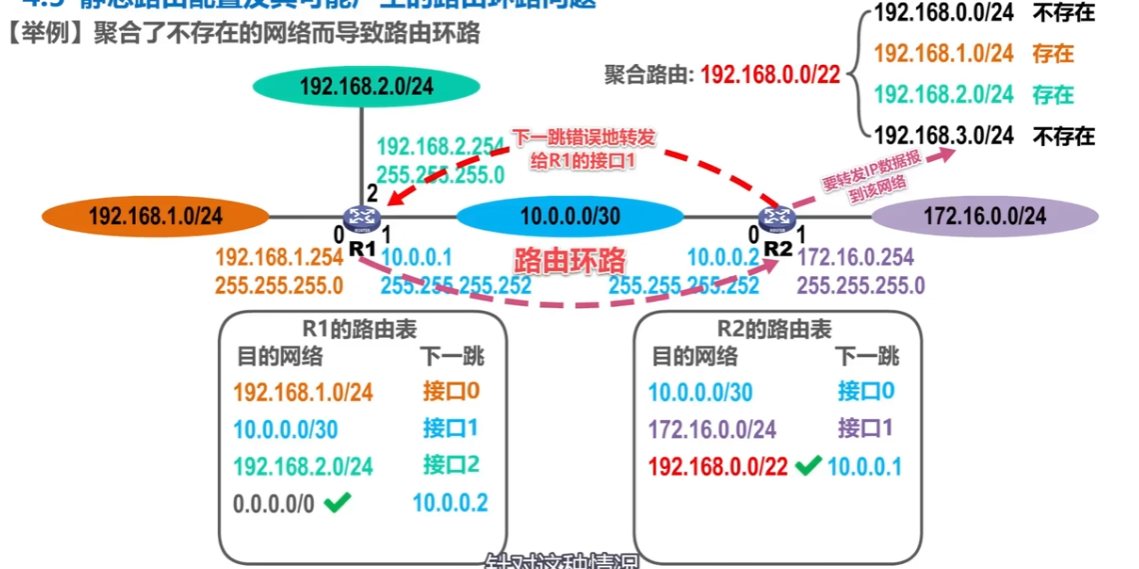
解决方法
为不存在的网段配置“黑洞路由条目”
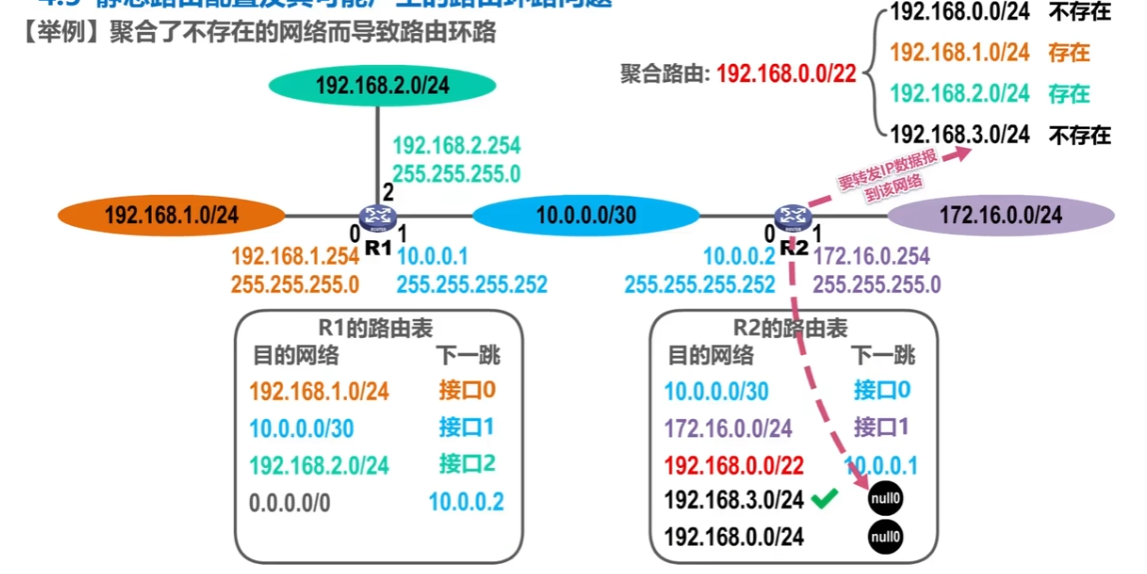
null是路由器中的一个虚拟接口,转发到这里相当于丢弃IP数据报
当网络故障时,也可能导致路由环路
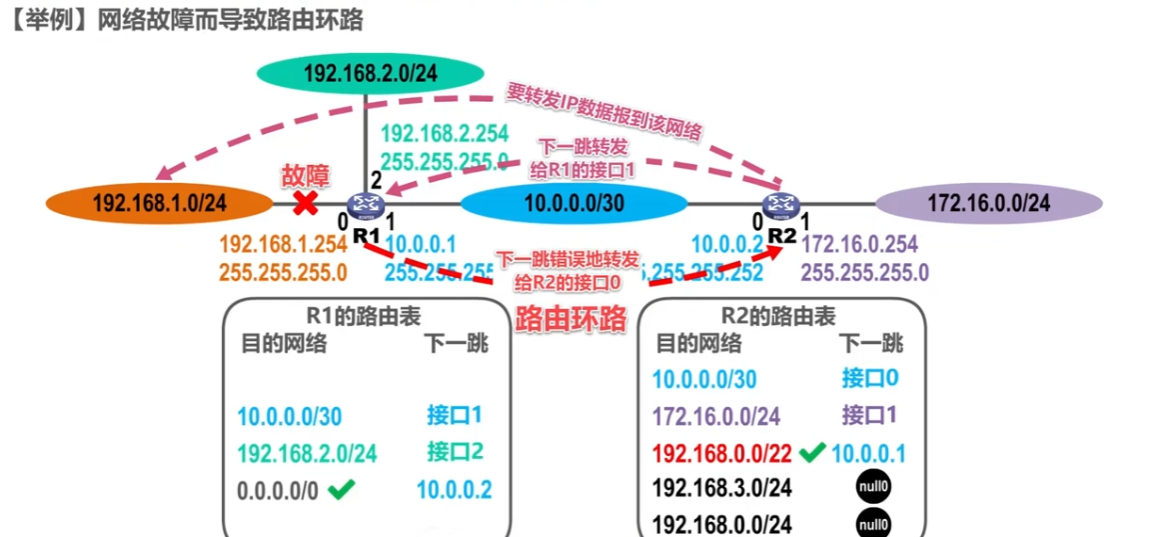
如图 产生故障时路由表中的记录会被自动删除,如此就会形成环路
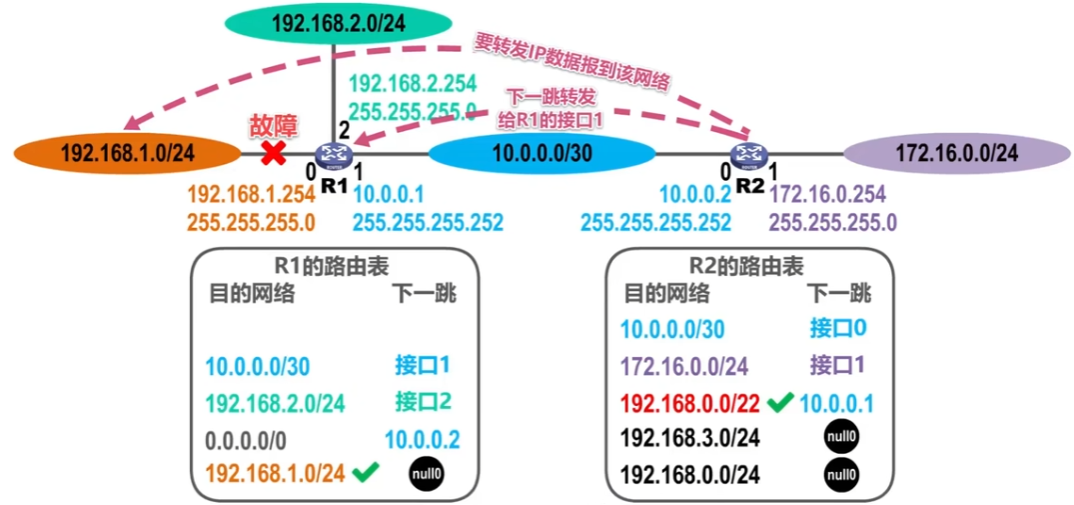
解决方法
添加出现故障的接口的黑洞路由
8.路由选择协议
概述
静态路由选择
详见:静态路由配置
配置简单开销小,不能及时适应网络状态变化
一般在小规模网络中采用
动态路由选择
路由器通过路由选择协议自动获取路由信息
能较好适应网络状态变化,但比较复杂、开销大
适用大规模网络
因特网所采用路由选择协议的主要特点
自适应:动态路由选择,自适应网络变化状态
分布式:路由器之间交换路由信息
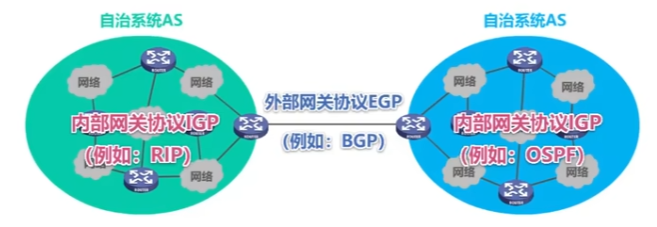
分层次:将因特网划分成许多较小的自治系统AS(Autonomous System)
示意图
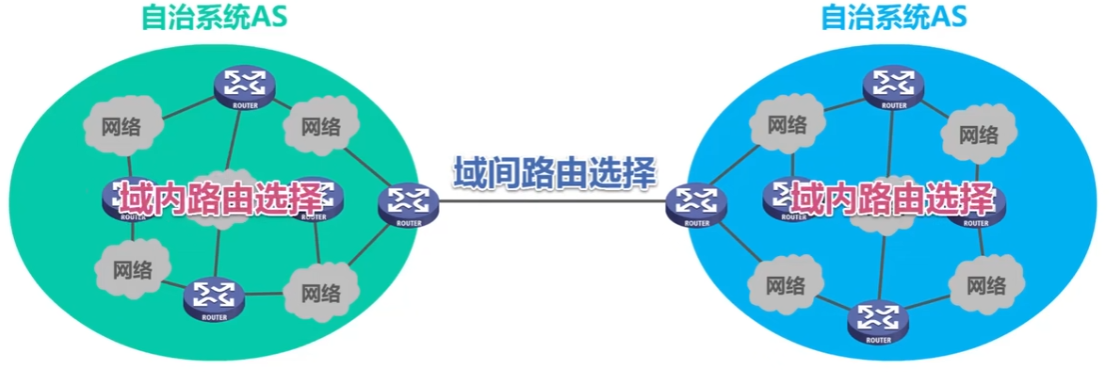
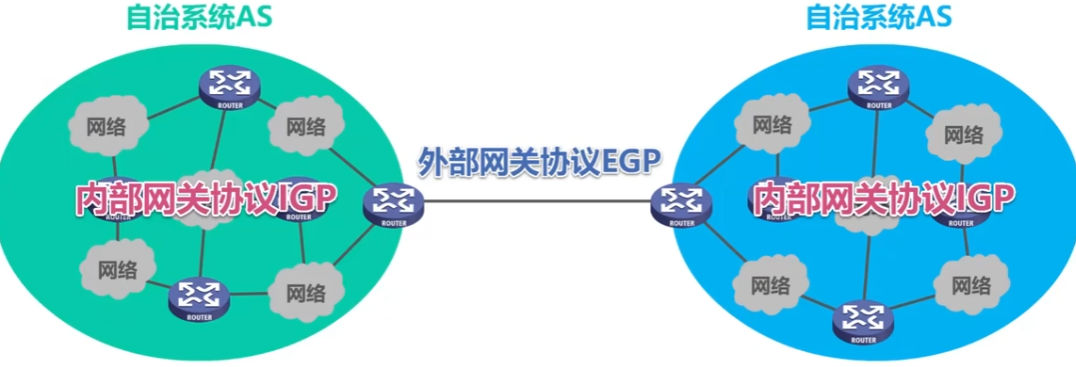
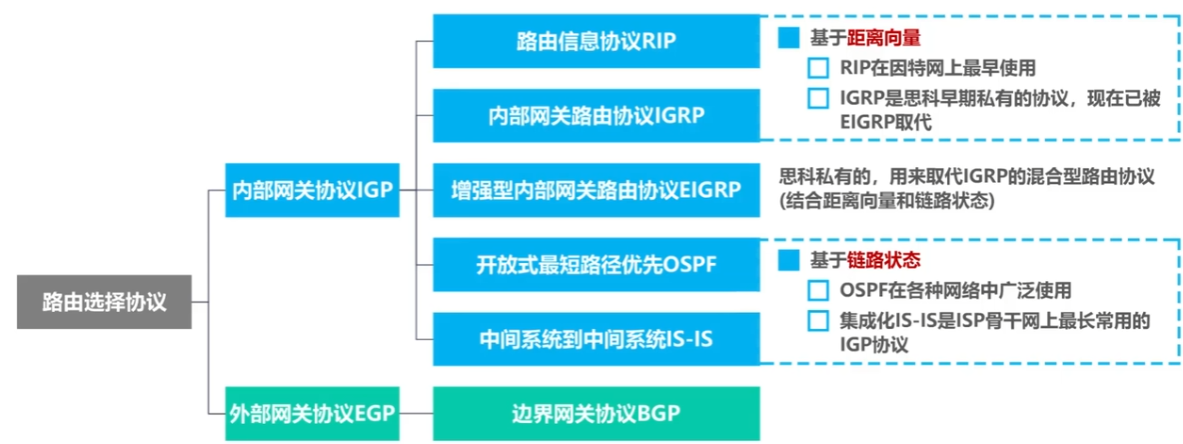
注意:IGP和EGP只是协议的类型,并非具体的协议
常见的网关协议
路由器基本结构
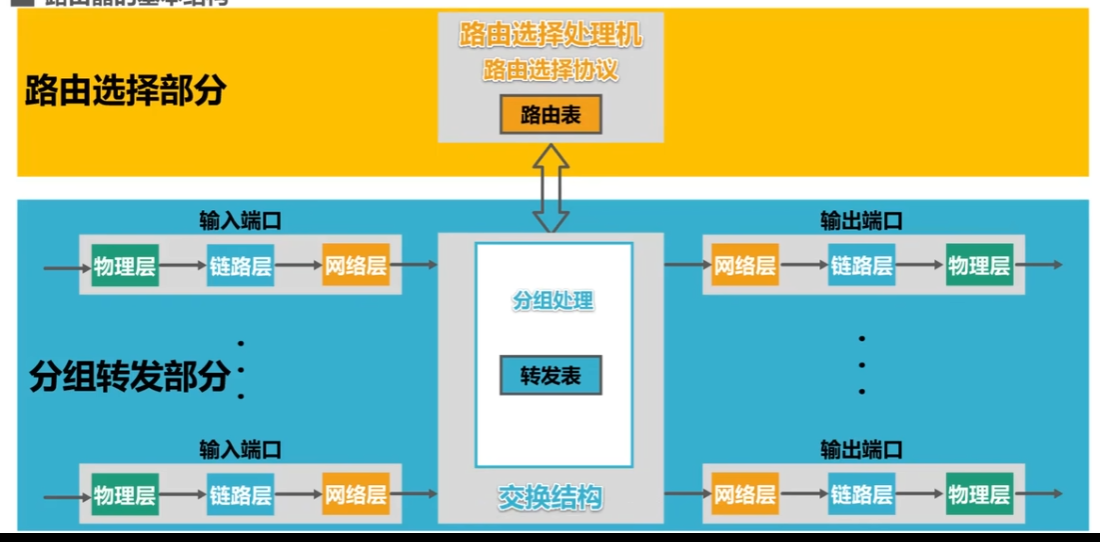
路由选择部分中的路由选择处理机通过周期性地和其他路由交互路由信息(交换的路由信息以路由报文的方式通过输入端口输入,输入到交换结构后送交路由选择处理机处理),更新路由表。同理,路由选择处理机也会周期性的发送自己已知的路由信息
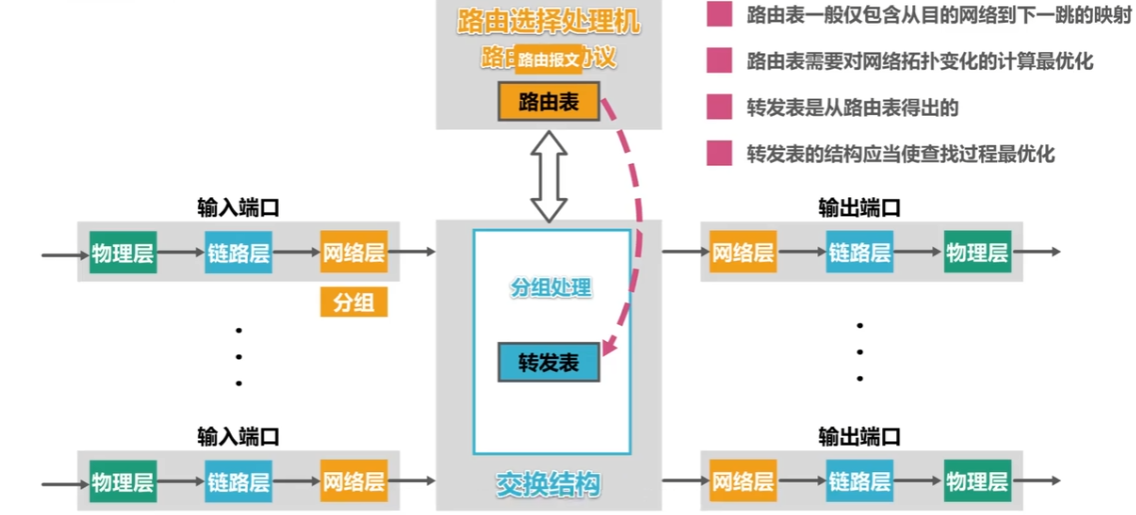
严格意义上转发表是由路由表得出,二者并不一致。但为了学习的方便,后面我们只对路由表进行研究
RIP协议
基本概念
路由信息协议RIP(Routing Information Protocol)是内部网关协议IGP中最先得到广泛使用的协议之一,其相关标准文档为RFC 1058。
RIP要求自治系统AS内的每一个路由器都要维护从它自己到AS内其他每一个网络的距离记录。这是一组距离,称为“距离向量D-V(Distance-Vector)”。
RIP使用跳数(Hop Count)作为度量(Metric)来衡量到达目的网络的距离。
路由器到直连网络的距离定义为1。
路由器到非直连网络的距离定义为所经过的路由器数加1。
允许一条路径最多只能包含15个路由器。“距离”等于16时相当于不可达。因此,RIP只适用于小型互联网。
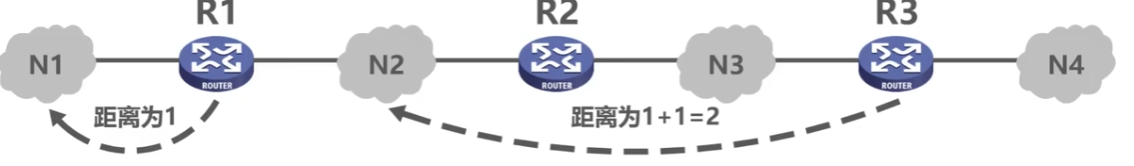
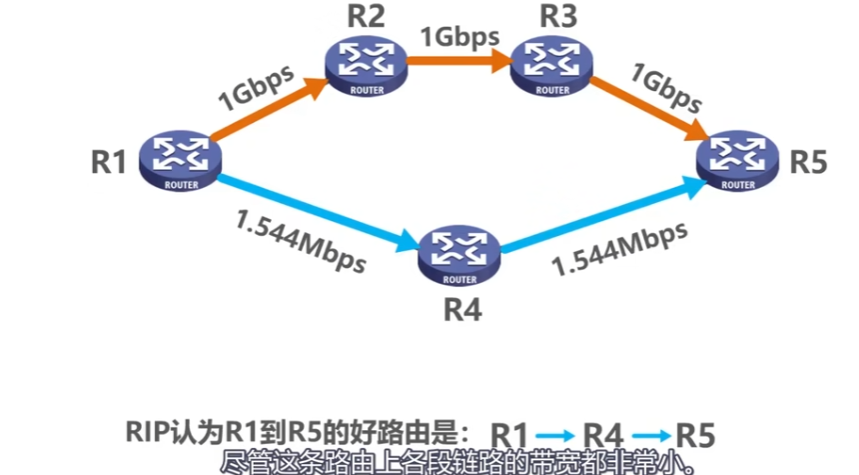
RIP认为距离短的路由就是好路由
RIP只管路径长度,不管带宽等其他因素的影响
当到达同一目的地有多条距离相等的路径时,RIP会进行等价负载均衡 即:把通信量平均分配给多条等价的路由
RIP的三大要点
- RIP只和相邻路由器进行信息的交换
- RIP交换的信息是路由表
- RIP会周期性进行信息的交换 (例如:30s)
基本工作原理
基本工作过程
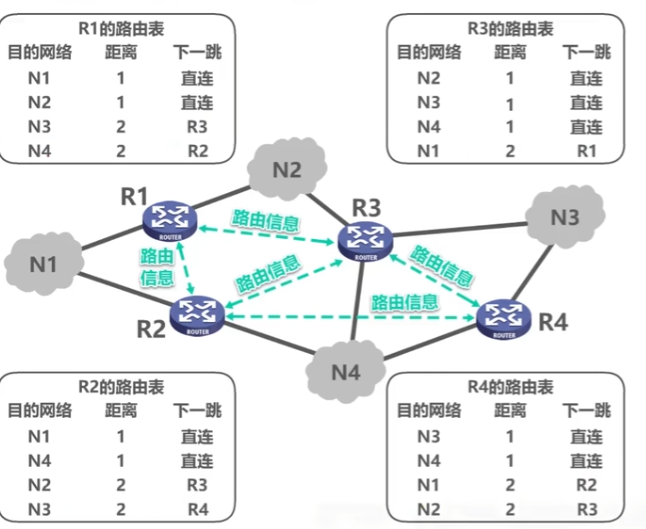
- 路由器刚开始工作时,只知道自己到直连网络的距离为1。
- 每个路由器仅和相邻路由器周期性地交换并更新路由信息。
- 若干次交换和更新后,每个路由器都知道到达本AS内各网络的最短距离和下一跳地址,称为收敛。
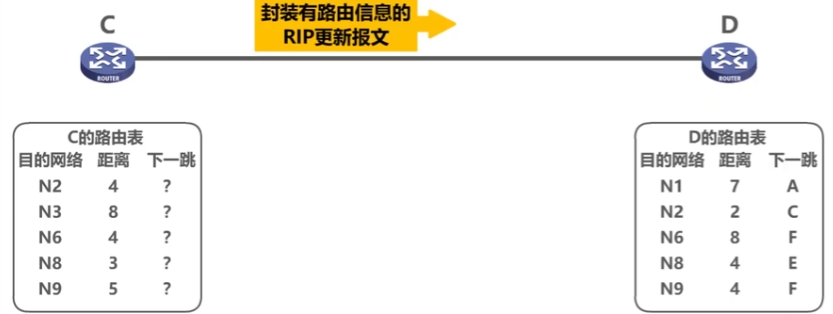
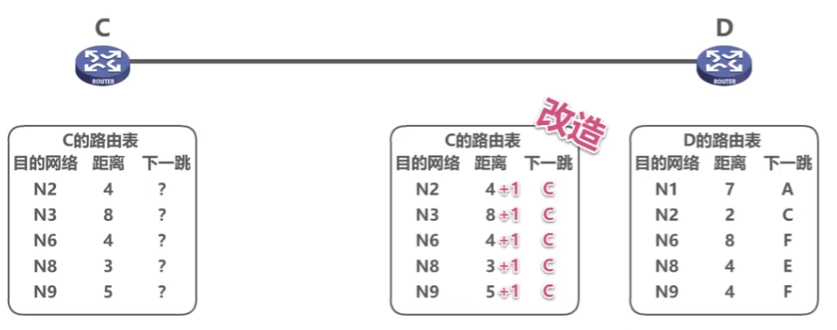
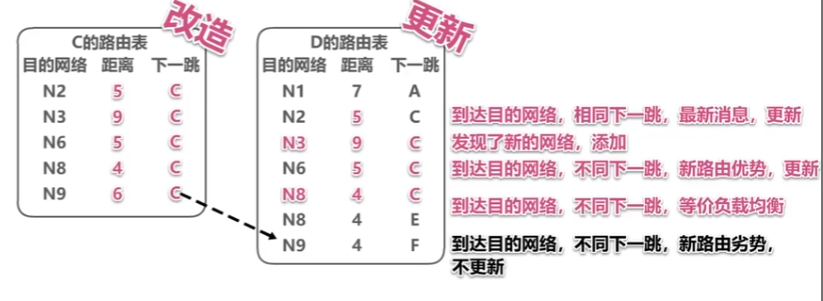
RIP路由条目更新规则
转发路由报文
改造路由报文
更新路由报文
RIP存在的“坏消息传得慢”的问题
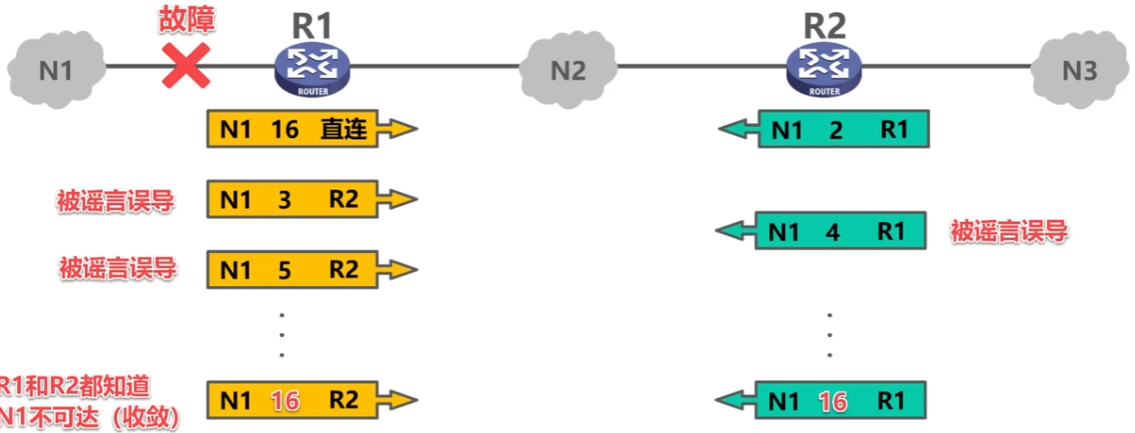
- 当R1到N1的网络线路故障时,R1检测到后会将其设置为不可到达
- 假设R2的路由数据报先到达R1,此时R2的数据报中还写着可到达,所以R1就会被该信息所误导,更新到N1的距离
- 随后R1传递路由数据报给R2,R2也会被误导 … 如此循环至路径长度到16
这个过程中,R1和R2间就形成了路由环路
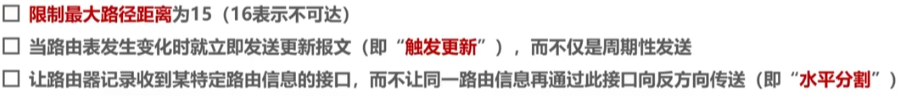
缓解该问题的方法
RIP习题
习题1
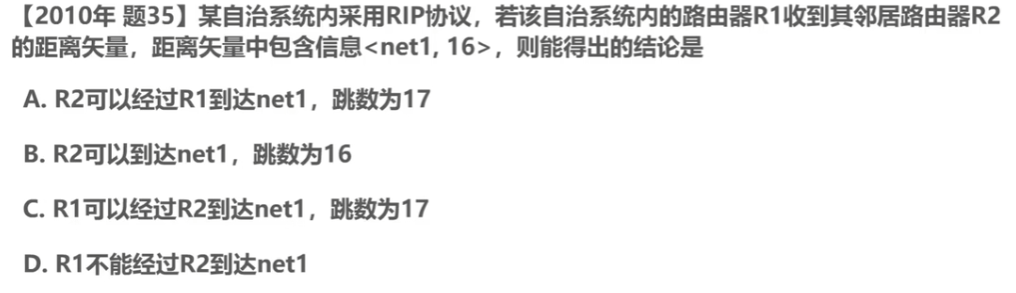
D 在RIP协议中 距离16被定义为目的网络不可达
习题2
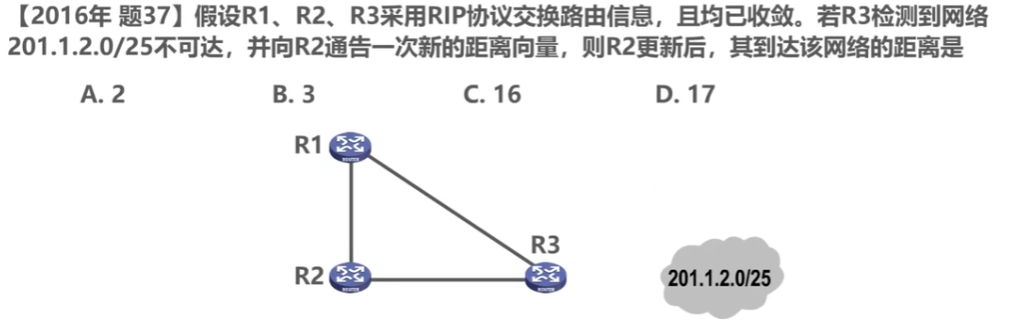
B R3检测到故障并更新距离为16 向R2发送路由报文。 注意题中关键词:R2更新后,R2的更新不仅要有R3的报文还要有R1的报文,R1并未对201.1.2.0/25的不可达进行更新,所以R2会被R1的路由报文迷惑,最终更新结果为2+1=3
开放最短路径优先OSPF协议
基本概念
开放最短路径优先OSPF(Open Shortest Path First),是为克服RIP的缺点在1989年开发出来的。
- “开放”表明OSPF协议不是受某一家厂商控制,而是公开发表的。
- “最短路径优先”是因为使用了Dijkstra提出的最短路径算法SPF。
OSPF是基于链路状态的,而不像RIP那样是基于距离向量的。
OSPF采用SPF算法计算路由,从算法上保证了不会产生路由环路。
OSPF不限制网络规模,更新效率高,收敛速度快。
链路状态是指本路由器都和哪些路由器相邻,以及相应链路的“代价”(cost)。
“代价”用来表示费用、距离、时延、带宽,等等。这些都由网络管理人员来决定。
举例:思科路由器中的代价计算
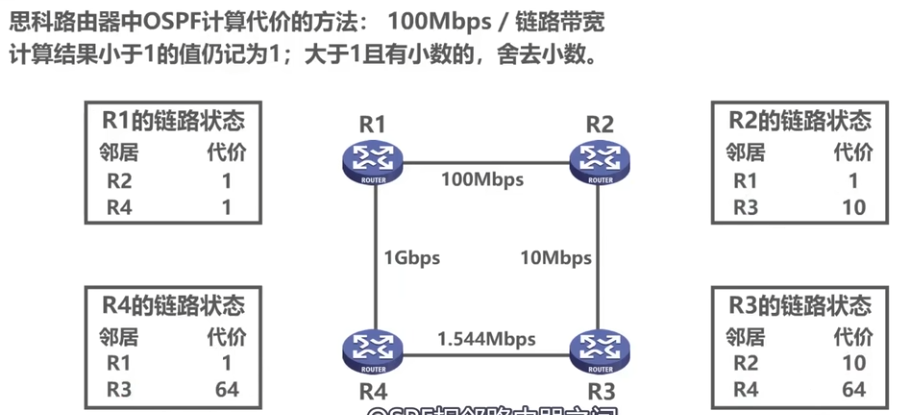
基本工作原理
OSPF相邻路由器之间通过交互问候(hello)分组,建立和维护邻居关系
Hello分组封装在IP数据报中,发往组播地址224.0.0.5
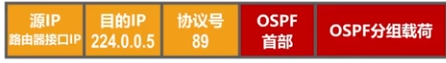
发送周期为10s
若超过40s未收到则认为不可达
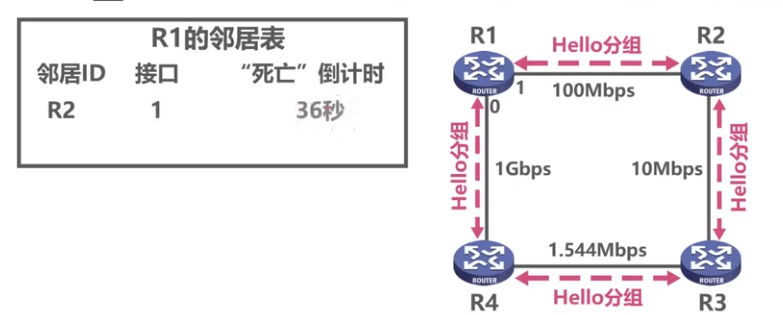
邻居表中会有死亡倒计时(40s开始) 若40s还没收到则认为该邻居不可达。
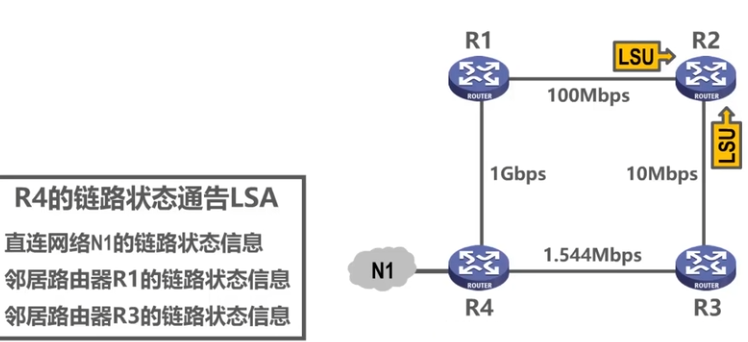
使用OSPF的每个路由器都会产生链路状态通告LSA(Link State Advertisement)。LSA中包含以下内容:
直连网络的链路状态信息
邻居路由器的链路状态信息 LSA被封装在链路状态更新分组LSU中,采用洪泛法发送。
- 洪泛转发:当一个路由器收到一条新的链路状态信息(比如一条 LSA)时,会把这条信息除了收到它的那个接口之外,转发给所有其他直连邻居。
- 利用洪泛转发LSU就可以到达链路上所有连通的结点 (类似DFS判断最大连通块)
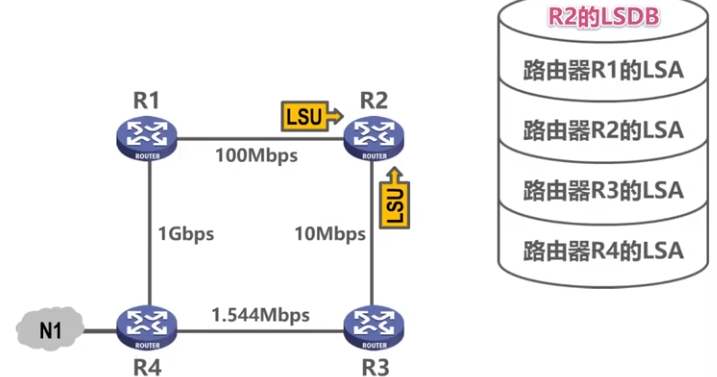
使用OSPF的每个路由器都会有一个链路状态数据库LSDB,用于存储LSA
通过各路由器洪泛转发封装有自己LSA的LSU分组,各路由器的LSDB最终达到一致
由于最终每个路由器的LSDB中都会记录着AS中所有链路的状态信息,由此就可以计算最短加权路径构建路由表了
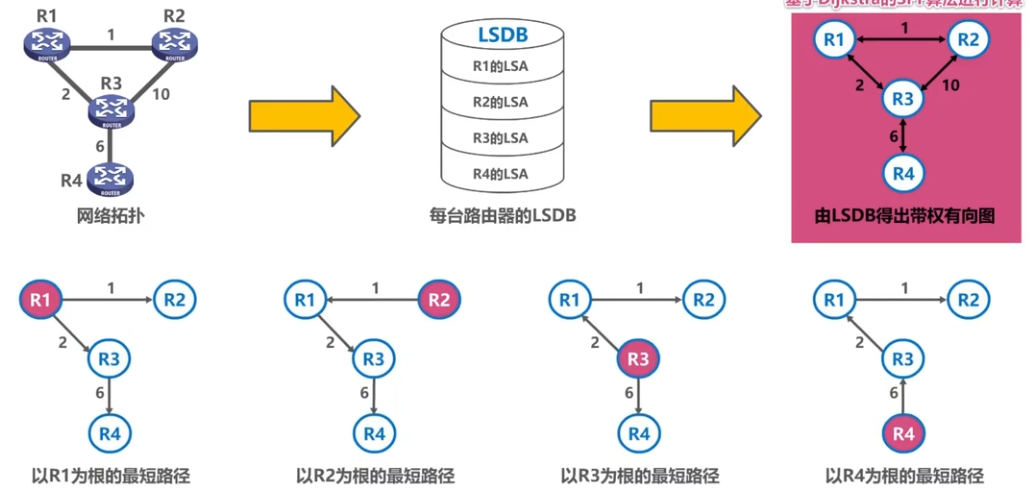
将LSDB中的数据抽象为图进行迪杰斯特拉单源最短路径算法
OSPF的五种分组类型
- 问候(Hello)分组:用来发现和维护邻居路由器的可达性。
- 数据库描述(Database Description)分组:向邻居路由器给出自己的链路状态数据库中的所有链路状态项目的摘要信息。
- 链路状态请求(Link State Request)分组:向邻居路由器请求发送某些链路状态项目的详细信息。
- 链路状态更新(Link State Update)分组:路由器使用这种分组将其链路状态进行洪泛发送,即用洪泛法对全网更新链路状态。
- 链路状态确认(Link State Acknowledgment)分组:这是对链路状态更新分组的确认分组。
基本工作过程
工作过程示例
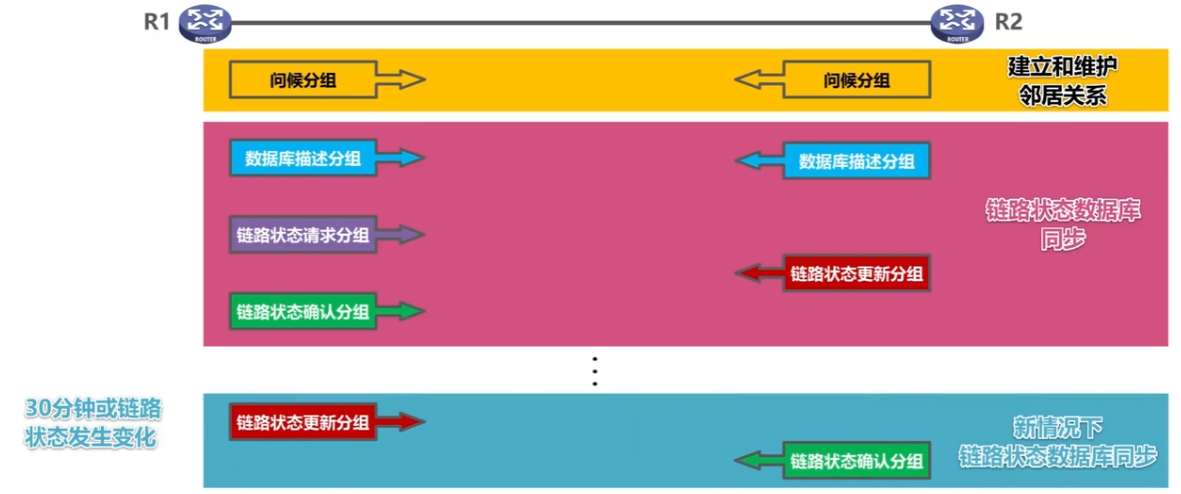
- 互发问候分组以建立维护邻居关系
- 发送数据库描述分组用来确认各自数据库中是否有缺失部分,若有则发送链路状态请求分组,被请求方收到请求分组后发送更新分组,请求方更新后发送确认分组。 以此完成LSDB的同步
- 每隔30min或链路状态变化时需要发送链路状态更新分组以确保LSDB同步
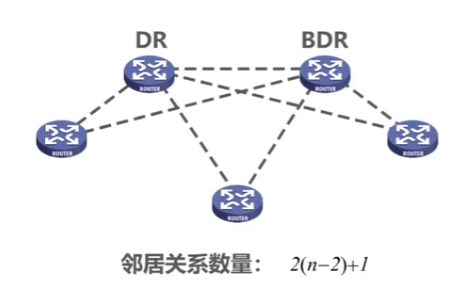
注意1:OSFP在多点接入网络中路由器邻居关系的建立会产生大量多播分组
如图所示,俩俩互为邻居,这样建立的邻居关系过多
解决方法
选举指定路由器DR(designated router)和 备用的指定路由器BDR(backup designated router)
所有的非DR/BDR只与DR/BDR建立邻居关系
非DR/BDR之间通过DR/BDR交换信息
注意2:为了使OSPF能够用于规模很大的网络,OSPF把一个自治系统再划分为若干个更小的范围,叫做区域(Area)
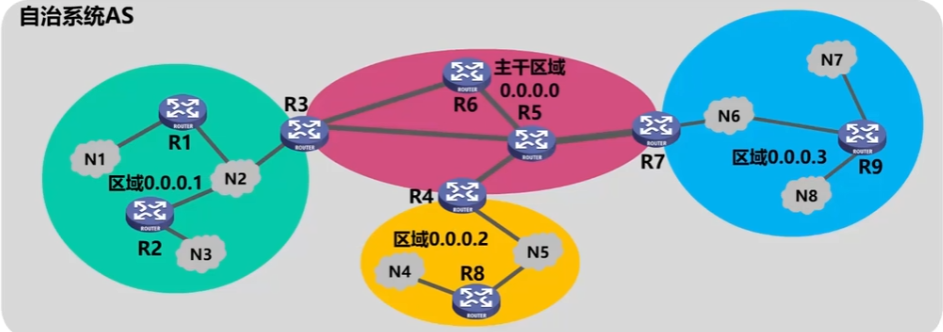
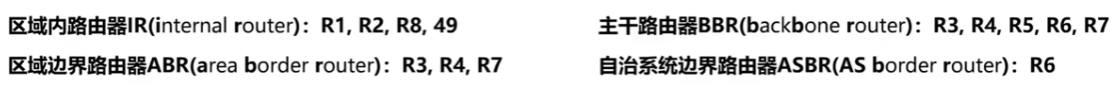
主干区域编号必须为0.0.0.0
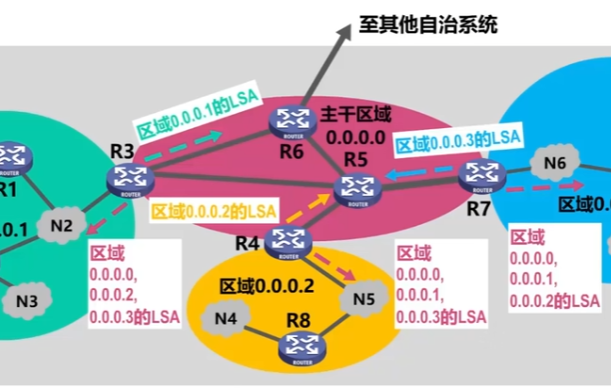
每个区域的区域边界路由器会向外转发自身的LSA报文,向内转发其他区域的LSA报文
边界网关协议BGP
基本概念
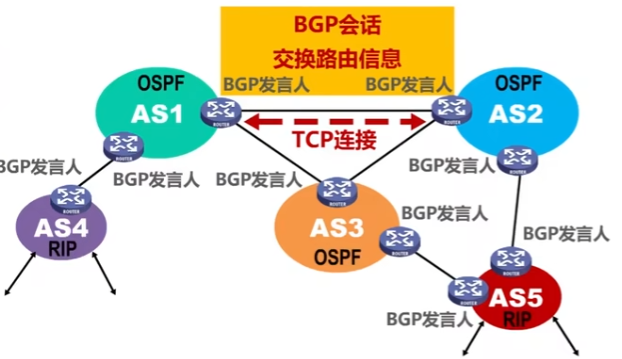
示意图
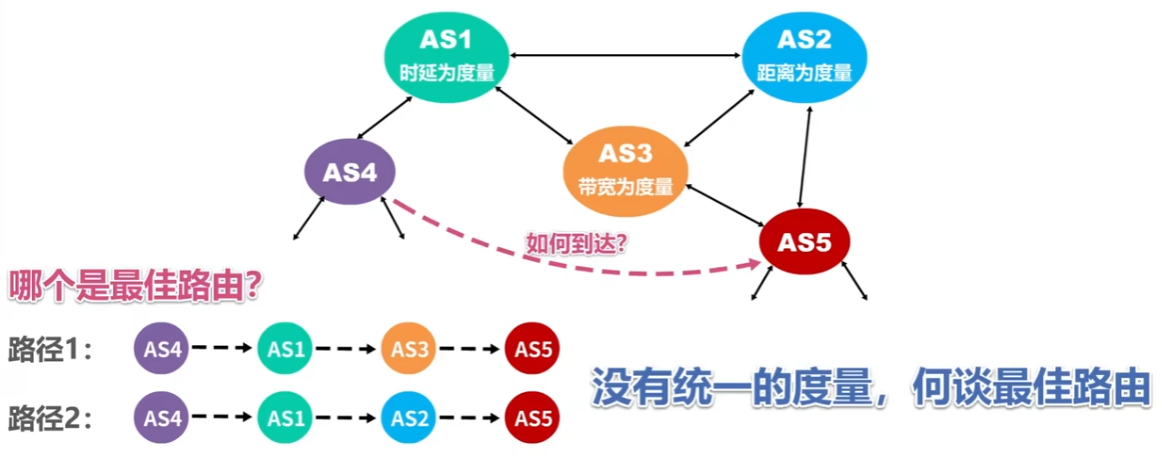
在不同自治系统内,度量路由的“代价”(距离,带宽,费用等)可能不同。 因此,对于自治系统之间的路由选择,使用“代价”作为度量来寻找最佳路由是不行的。
自治系统之间的选择必须考虑相关策略(政治经济安全等)
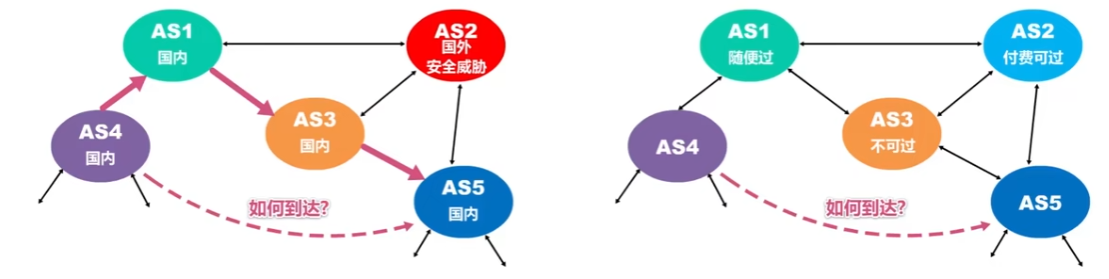
综上所述:BGP只能是力求寻找一条能够到达目的网络且比较好的路由(不能兜圈子),而非要寻找一条最佳路由。
基本工作原理
在配置BGP时,每个自治系统的管理员要选择至少一个路由器作为该自治系统的“BGP发言人”
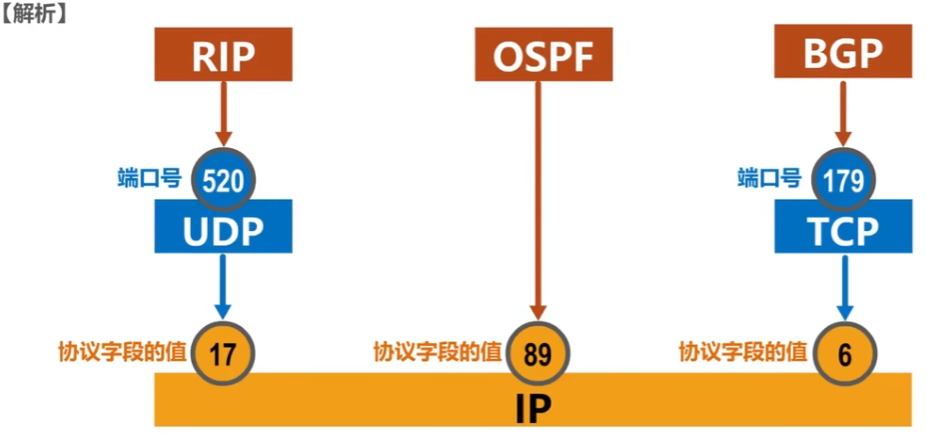
不同自治系统的BGP发言人要交换路由信息,首先必须建立TCP连接,端口号为179
在此TCP连接上交换BGP报文以建立BGP会话
利用BGP会话交换路由信息(例如,增加新的路由,或撤销过时的路由,以及报告出错的情况等)
使用TCP连接交换路由信息的两个BGP发言人,彼此称为对方的邻站(neighbor)或对等站(peer)
BGP发言人除了运行BGP外,还必须运行自己所在自治系统所使用的内部网关协议IGP,例如OSPF或RIP。
BGP发言人交换网络可达性的信息(要到达某个网络所要经过的一系列自治系统) 当BGP发言人互相交换了网络可达性的信息后,各BGP发言人就根据所采用的策略从收到的路由信息中找出到达各自治系统的较好的路由。也就是构造出树形结构、不存在回路的自治系统连通图。
示例
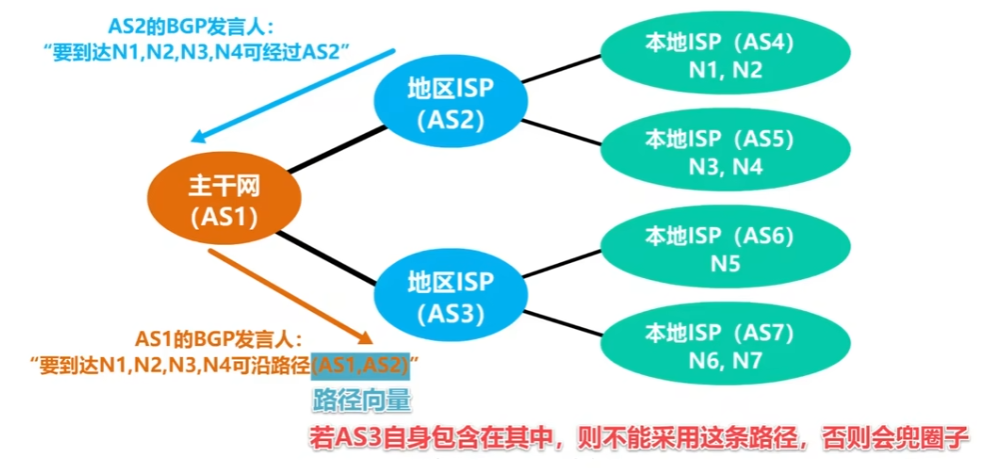
BGP-4的四种报文
- **OPEN(打开)**报文:用来与相邻的另一个BGP发言人建立关系,使通信初始化。
- **UPDATE(更新)**报文:用来通告某一路由的信息,以及列出要撤销的多条路由。
- **KEEPALIVE(保活)**报文:用来周期性地证实邻站的连通性。
- **NOTIFICATION(通知)**报文:用来发送检测到的差错。
BGP习题
习题1
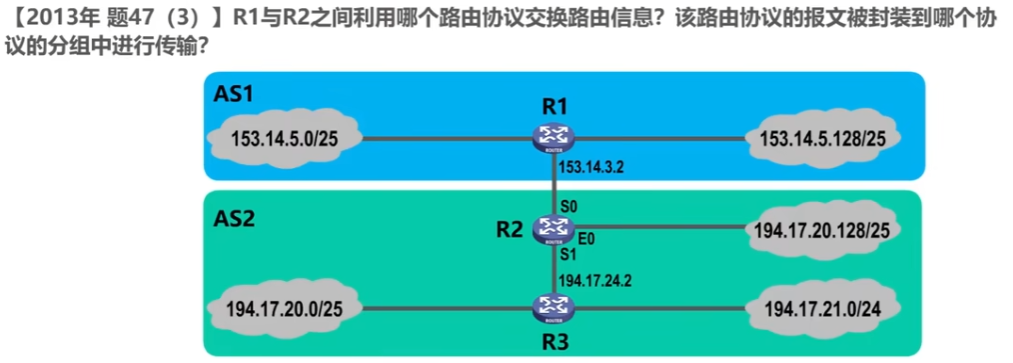
R1、R2间用BGP路由协议交换路由信息 被封装在TCP报文段中传输
习题2

D
9.IPv4数据报首部格式
总述
示意图
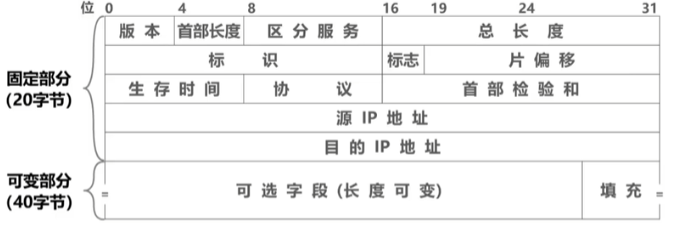
版本:占4bit,表示IP协议的版本,通信双方使用的IP协议版本必须一致。目前广泛使用的版本号为4(即IPv4)
首部长度:占4bit ,表示IP数据报首部的长度。以4字节为单位
最小十进制取值为 5,表示 IP 数据报首部只有 20 字节固定部分;
最大十进制取值为 15,表示 IP 数据报首部包含 20 字节固定部分和最大 40 字节可选部分。
区分服务:占8bit,用来更好的服务,利用该字段的不同数值可提供不同等级的服务质量。
只有在使用区分服务时,该字段才起作用。一般情况下都不使用该字段。
总长度:占16bit,表示IP数据报总长度(首部长度+数据载荷),最大10进制为655355 单位字节
标识、标志、片偏移:这三个字段共同用于IP数据报分片
原因:封装成帧时规定了最大帧长,当IP数据报过大时,需对其进行分片再封装成帧
标识:占16bit,属于同一个数据报的各分片数据报应该具有相同的标识。
IP软件维持一个计数器,每产生一个数据报,计数器值加1,并将此值赋给标识字段。
标志:占3bit,各比特含义如下
第 1 位(最高位):保留位,协议规定必须为
0,不用于任何功能,只是为了后续扩展预留。第 2 位:DF 位(Don’t Fragment,不分片位):1标识不允许切片,0表示允许切片
第 3 位:MF 位(More Fragments,更多分片位):1表示“后面还有分片”,0表示“这是最后一个分片”
片偏移:占13比特,指出分片数据报的数据载荷部分偏移其在原数据报的位置有多少个单位。 片偏移以8个字节为单位。
生存时间TTL:占8比特,最初以秒为单位,最大生存周期为255秒;路由器转发IP数据报时,将IP数据报首部中的该字段的值减去IP数据报在本路由器上所耗费的时间,若不为0就转发,否则就丢弃。 详见:路由环路问题
协议:占8bit,指明IP数据报的数据部分用的是何种数据单元
常用的协议和协议字段值
协议名称 ICMP IGMP TCP UDP IPv6 OSPF 协议字段值 1 2 6 17 41 89 首部检验和:占16bit,用于检验IP数据报在传输过程中有无误码。比CRC简单,称为因特网检验和
IP数据报每经过一个路由器,路由器都要重新计算首部检验和,因为某些字段(生存时间、标志、片偏移等)的取值可能发生变化。
由于IP层本身并不提供可靠传输的服务,并且计算首部校验和是一项耗时的操作,因此在IPv6中,路由器不再计算首部校验和,从而更快转发IP数据报。
源IP地址/目的IP地址:
可选字段
长度从1个字节到40个字节不等。用来支持排错、测量及安全等措施。
可选字段增加了IP数据报的功能,但这同时也使得IP数据报的首部长度成为可变的。这就增加了每一个路由器处理IP数据报的开销。实际上可选字段很少被使用。
填充字段
确保首部长度为4的整数倍,如不是整数倍会向填充字段填0
IP数据报分片举例
示意图(以太网传输)
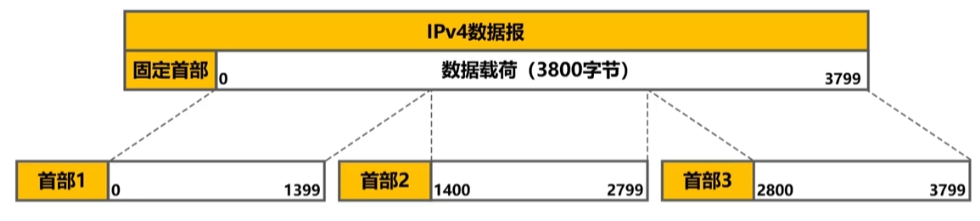
各分片的IP首部的值
总长度 标识 MF DF 片偏移 原始数据报 3800+20 12345 0 0 0 分片 1 的数据报 1400+20 12345 1 0 0/8 分片 2 的数据报 1400+20 12345 1 0 1400/8 分片 3 的数据报 1000+20 12345 0 0 2800/8 假定分片2在经过某网络时还要进行分片
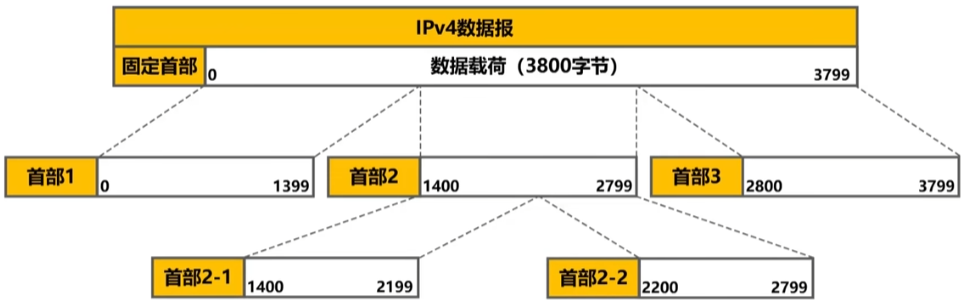
分片2-1 2-2的IP首部的值
总长度 标识 MF DF 片偏移 原始数据报 3800+20 12345 0 0 0 分片 2 的分片 1 数据报 800+20 12345 1 0 1400/8 分片 2 的分片 2 数据报 600+20 12345 0 0 2200/8
IPv4数据报首部格式习题
习题1
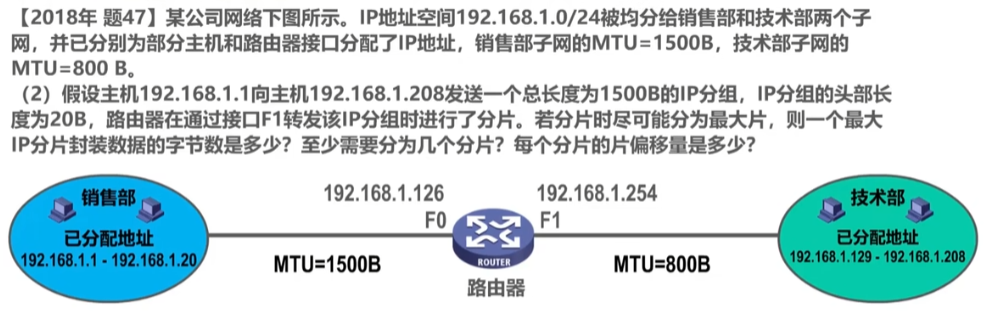
解析
最大的分片封装的数据字节数为780Byte 至少分2个分片 片偏移量分别为:0、780/8,由于片偏移量一定要是整数,所以该种方法不行
由于尽可能往大了分,那么可以确定一定是分为2片,那我们只要找到小于780的最大的8的倍数则可取 776Byte 分为776Byte和724Byte 片偏移量为:0、776/8=97
习题2
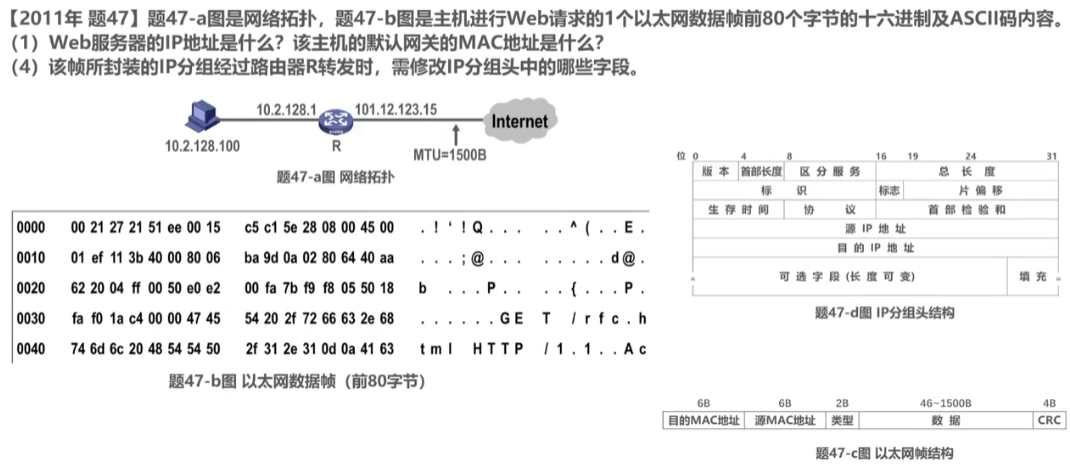
默认网关地址即为目的MAC地址:00-21-27-21-51-ee(前6个字节)
Web服务器的IP地址的起始位置: 6+6+2+ 32/8 * 4 +1= 31 IP地址长度为32/8=4Byte
所以IP地址为:40 aa 62 20 转换为十进制点分法:64.187.98.32
需修改IP分组头中的生存时间、首部校验和 ,再看IP数据报总长度决定要不要分片,IP数据报总长度起始位置为:6+6+2+16/4+1=19 11 3b 40 00 要分片。 所以还需要修改总长度、标志和片偏移
10.网际控制报文协议ICMP
简介
为了更有效地转发IP数据报和提高交付成功的机会,在网际层使用了网际控制报文协议ICMP(Internet Control Message Protocol)。
主机或路由器使用ICMP来发送差错报告报文和询问报文。
ICMP报文被封装在IP数据报中发送。
差错报告文的分类
终点不可达
当路由器或主机不能交付数据报时,就向源点发送终点不可达报文。具体可再根据ICMP的代码字段细分为:目的主机不可达、目的协议不可达、目的端口不可达、目的网络未知、目的主机未知等情况。
举例
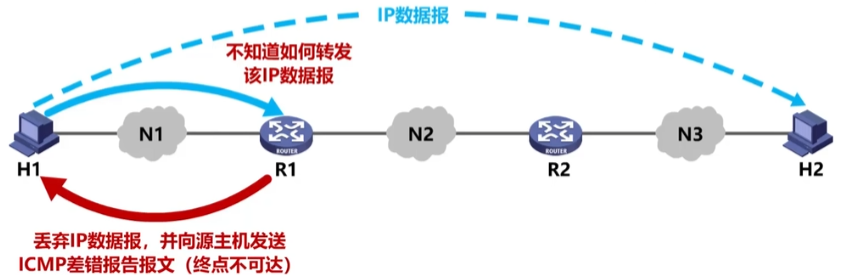
当R1中没有下一跳为R2的信息时,R1就不知道该如何转发,会向H1发送终点不可达报文
源点抑制
源站抑制报文(拥塞控制):当路由器或主机因拥塞而丢弃数据报时,就向源站发送源站抑制报文,通知源站降低发送速率。
举例
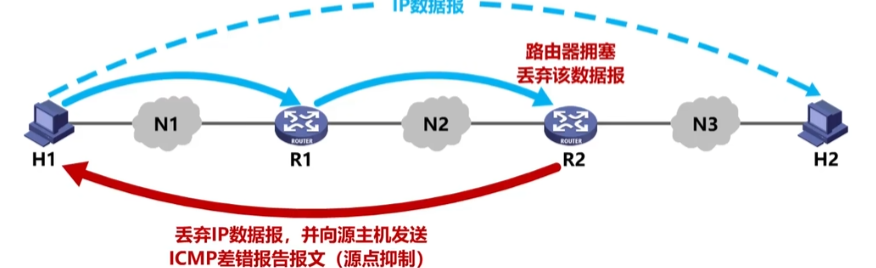
时间超过
当路由器收到一个目的IP地址不是自己的IP数据报,会将其生存时间TTL字段的值减1。
若结果不为0,则将该IP数据报转发出去;若结果为0,除丢弃该IP数据报外,还要向源点发送时间超时报文。
当终点在预先规定的时间内不能收到一个数据报的全部数据报片时,就把已收到的数据报片都丢弃,也会向源点发送时间超过报文。
举例
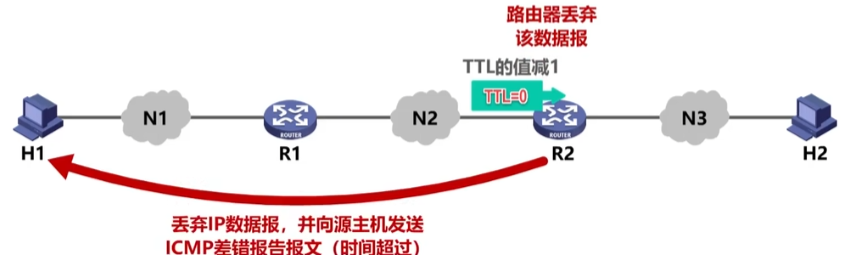
参数问题
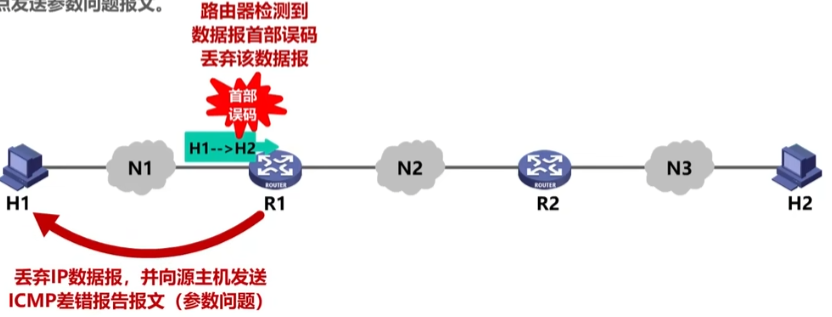
当路由器或目的主机收到IP数据报后,根据其首部中的检验和字段发现首部在传输过程中出现了错误,就丢弃该数据报,并向源点发送参数问题报文。
举例
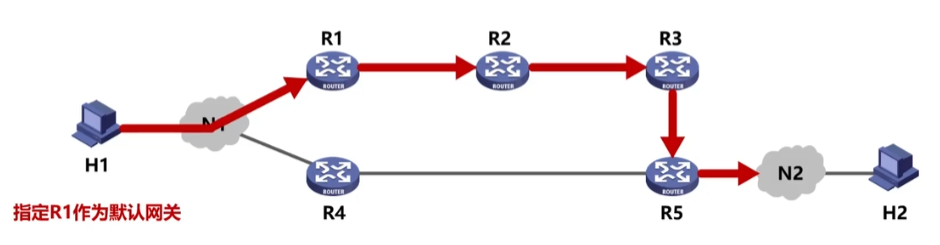
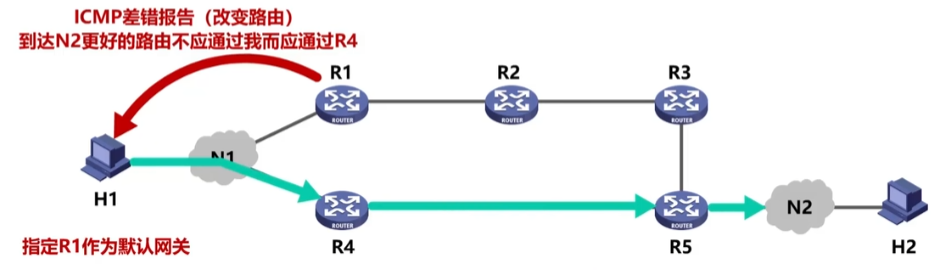
改变路由(定向)
路由器向源主机发送重定向报文,让主机知道下次应将数据报发送给其他更合适的路由器。
举例
以下情况不应传送ICMP差错报告报文
对ICMP差错报告报文不再发送ICMP差错报告报文
对第一个分片的数据报片的所有后续数据报片都不发送ICMP差错报告报文
对具有多播地址的数据报都不发送ICMP差错报告报文
对具有特殊地址(如127.0.0.0或0.0.0.0)的数据报不发送ICMP差错报告报文
询问报文
常用的ICMP询问报文有以下两种:
- 回送请求和回答 ICMP回送请求报文是由主机或路由器向一个特定的目的主机发出的询问。 收到此报文的主机必须给源主机或路由器发送ICMP回送回答报文。 这种询问报文用来测试目的站是否可达及了解其有关状态。
- 时间戳请求和回答 ICMP时间戳请求报文是请某个主机或路由器回答当前的日期和时间。 在ICMP时间戳回答报文中有一个32位的字段,其中写入的整数代表从1900年1月1日起到当前时刻一共有多少秒。 这种询问报文用来进行时钟同步和测量时间。
ICMP的应用
分组网间探测PING (Packet InterNet Groper)
用来测试主机或路由器间的连通性
应用层直接使用网际层的ICMP(没有通过运输层的TCP或UDP)
使用ICMP回送请求和回答报文
用来测试IP数据报从源主机到达目的主机要经过哪些路由器
Windows版本
tracert命令
应用层直接使用网际层ICMP
使用了ICMP回送请求和回答报文以及差错报告报文
Unix版本 traceroute命令
在运输层使用UDP协议
仅使用ICMP差错报告报文
实现原理
通过TTL时间超过报文的特性,第一次发送的数据报的TTL=1,可到达与主机距离为1的路由;第二次发送的数据报的TTL=2,可到达与主机距离为2的路由 … 以此类推直到到达目的IP,到达目的IP后发送回送请求回答报文
网际控制报文协议ICMP习题
习题
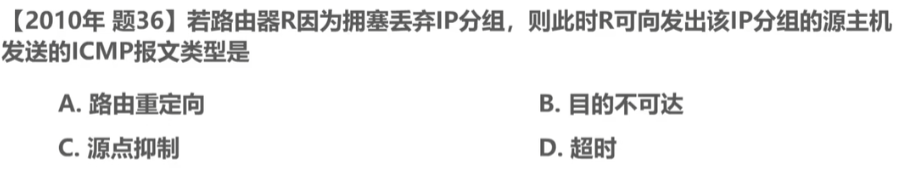
C
11.虚拟专用网VPN和网络地址转换NAT
VPN
虚拟专用网VPN(Virtual Private Network) 利用公用的因特网作为本机构各专用网之间的通信载体,这样的专用网又称为虚拟专用网。
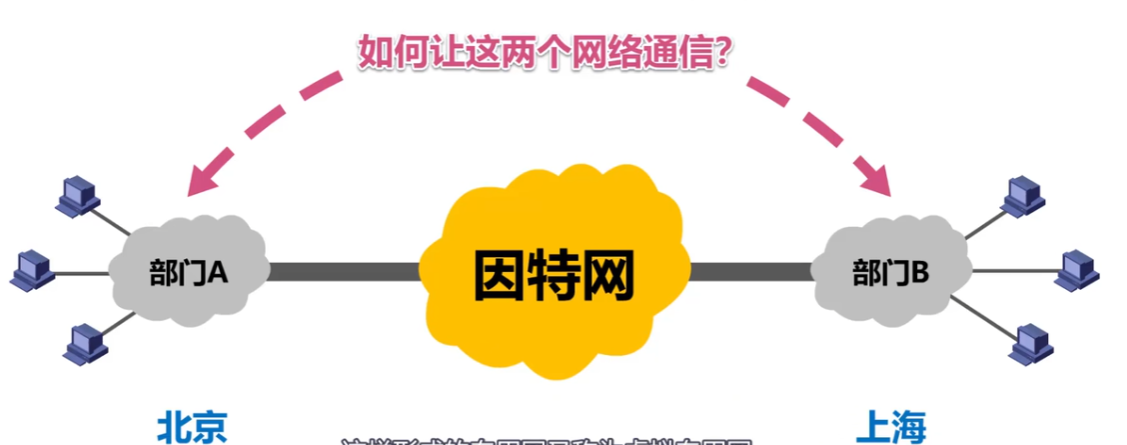
如何分配IP地址?
由于 IPv4 地址的紧缺,一个机构能够申请到的 IPv4 地址数量往往远小于本机构所拥有的主机数量。因此,虚拟专用网中的各主机所分配的地址应该是本机构可自由分配的专用地址,而不是需要申请的、在因特网上使用的公有地址。
- IANA规定以下三个地址块为专用地址块(私有地址)
- 10.0.0.0~10.255.255.255(10/8地址块)
- 172.16.0.0~172.31.255.255(172.16/12地址块)
- 192.168.0.0~192.168.255.255(192.168/16地址块)
- 需要注意的是:私有地址只能用于内部通信,所有的路由器对IP源地址是私有地址的IP数据报一律不予转发
综上,各部门(私有地址区域)至少需要有一个路由器具有合法的全球IP地址
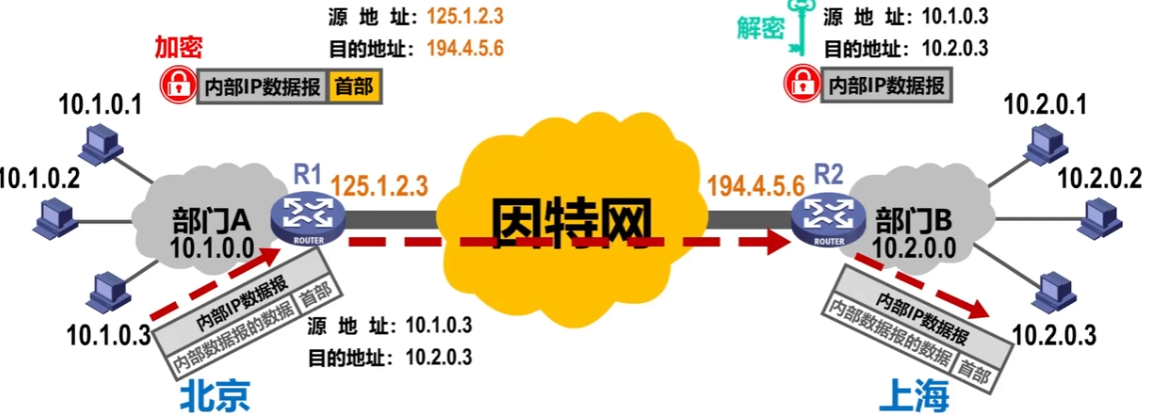
部门A的主机将内部IP数据报发送给R1,R1发现此IP数据报需要通过因特网才能到达目的主机。于是R1会对该内部数据报进行加密,并加上一个新的首部,将其包装成一个外部IP数据报,新首部中的源地址和目的地址分别为R1、R2的IP地址。
当该外部数据报通过因特网传到R2时,R2会拆掉新首部并对其内部数据报解密再转发给相应目的主机
- 上述过程中,数据报需在因特网之间经过因特网中多个路由器的进行转发,但在最终的效果上完成了部门A、B之间的通信,逻辑效果和在两部门间架设专用的链路。因此被称为虚拟专用网,此技术又被称为**“IP隧道技术”**
本例中,同一机构内不同部门的内部网络所构成的虚拟专用网VPN又称为内联网VPN。
有时一个机构的VPN需要有某些外部机构(通常就是合作伙伴)参加进来。这样的VPN就称为外联网VPN。
在外地工作的员工需要访问公司内部的专用网络时,只要在任何地点接入到因特网,运行驻留在员工PC中的VPN软件,在员工的PC和公司的主机之间建立VPN隧道,即可访问专用网络中的资源。这种VPN称为远程接入VPN。
NAT
产生背景
网络地址转换NAT(Network Address Translation)
虽然因特网采用了无分类编址方式来减缓IPv4地址空间耗尽的速度,但由于因特网用户数目的激增,特别是大量小型办公室网络和家庭网络接入因特网的需求不断增加,IPv4地址空间即将面临耗尽的危险仍然没有被解除。
1994年提出了一种网络地址转换NAT的方法再次缓解了IPv4地址空间即将耗尽的问题。
NAT能使大量使用内部专用地址的专用网络用户共享少量外部全球地址来访问因特网上的主机和资源。
工作原理
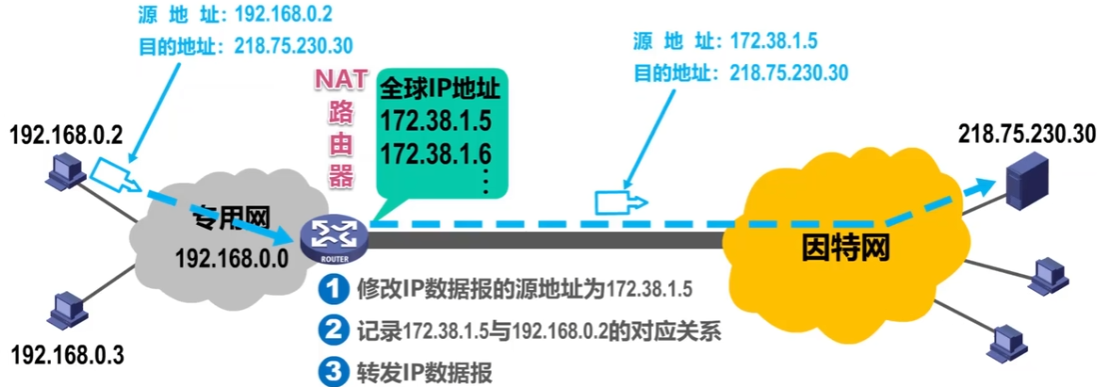
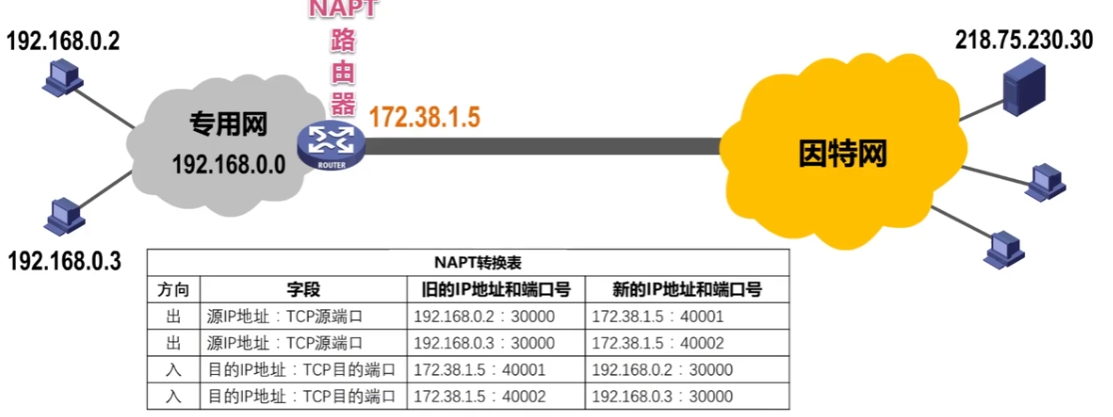
装有NAT软件的路由器称为NAT路由器,私有网络中的IP数据报转发给NAT路由器后,其中的源地址会被替换为路由器的全球IP地址并转发出去。
注意:在替换后,路由器会暂存私有地址和替换的全球地址间的对应关系
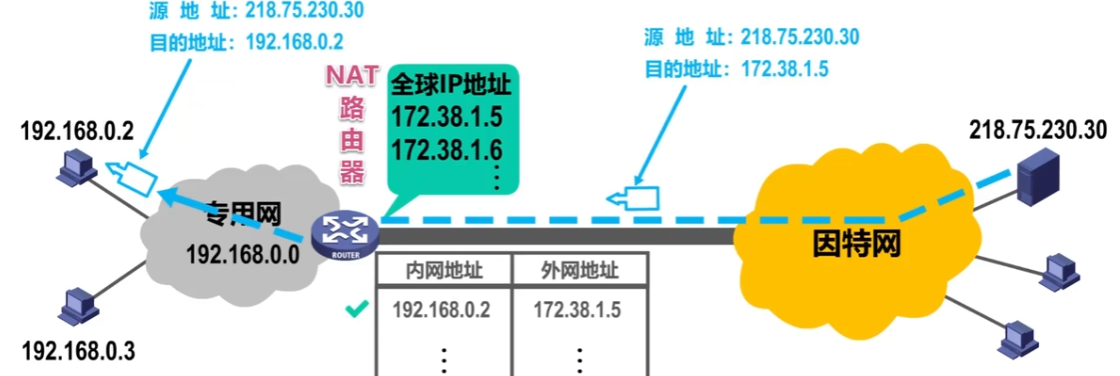
- 因特网上的服务器收到IP数据报后发回数据报给路由器,当路由器收到后会从原先暂存的对应关系中找到这份数据报应该发送给哪个主机,再次利用NAT技术将目的地址修改为专用网中的那个主机并进行发送
工作原理优化
问题:由上例可以看出,NAT技术受限于路由器拥有的全球IP地址数量,对于有N个全球IP地址的路由器,同时只能支持N台设备访问因特网
优化方法:由于绝大多数的网络应用都是使用运输层协议TCP或UDP来传送数据,因此可以利用运输层的端口号和IP地址一起进行转换。 这样,用一个全球IP地址就可以使多个拥有本地地址的主机同时和因特网上的主机进行通信。这种将端口号和IP地址一起进行转换的技术叫作网络地址与端口号转换NAPT(Network Address and Port Translation)。
NAPT示意图
补充
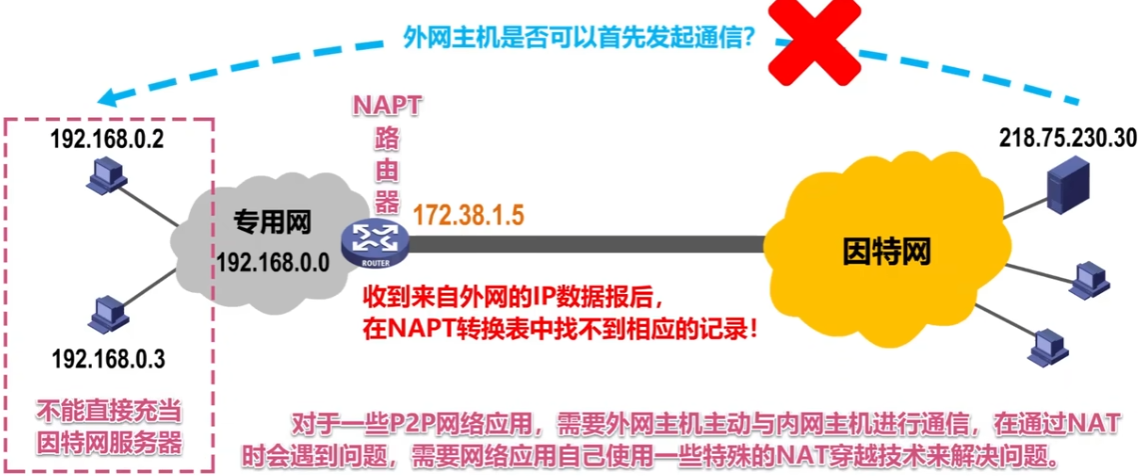
由上述NAT技术我们可知,外网的主机主动发起的通信是不能传输给内网的主机的 — 原因:NA(P)T 路由器中并没有相应的转换关系。 所以对于内网中的主机而言是无法作为服务器的(即外网请求无法被正确接收),若要实现内网主机作服务器,可以用相应的**NAT穿越技术(如内网穿透技术)**实现
五、运输层
1.运输层概述
之前课程所介绍的计算机网络体系结构中的物理层、数据链路层以及网络层它们共同解决了将主机通过异构网络互联起来所面临的问题,实现了主机到主机的通信。
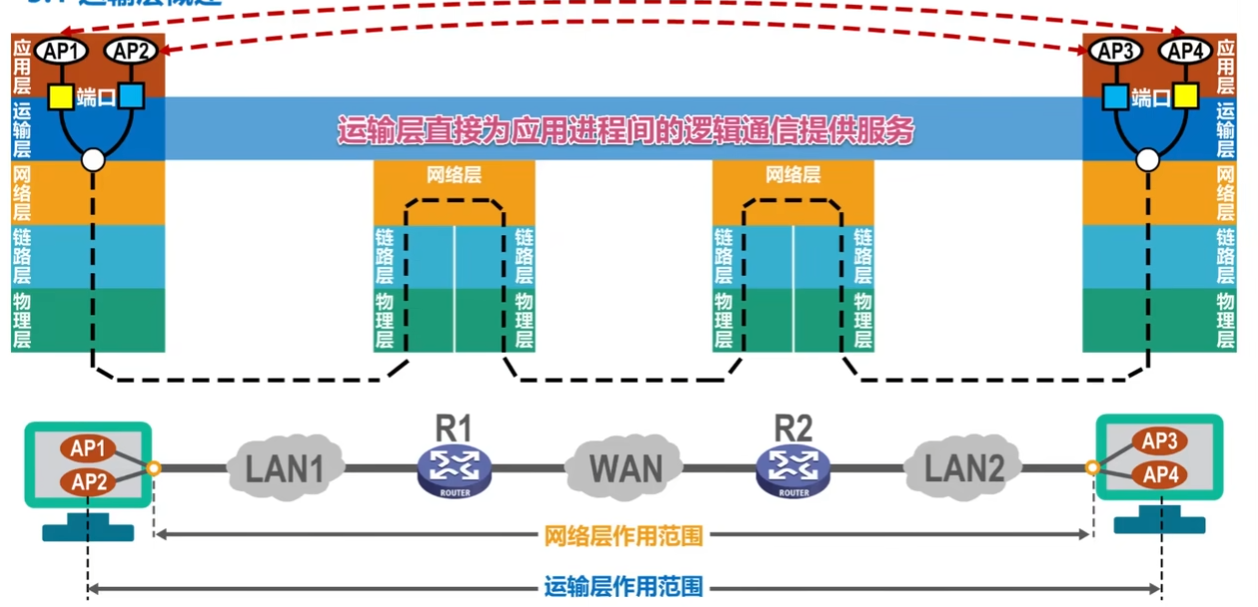
但实际上在计算机网络中进行通信的真正实体是位于通信两端主机中的进程。
如何为运行在不同主机上的应用进程提供直接的通信服务是运输层的任务,运输层协议又称为端到端协议。
端口:用于区分不同应用进程的标识符
运输层向高层用户屏蔽了下面网络核心的细节(如网络拓扑、所采用的路由选择协议等),它使应用进程看见的就好像是在两个运输层实体之间有一条端到端的逻辑通信信道。
根据应用需求的不同,因特网的运输层为应用层提供了两种不同的运输协议,即面向连接的TCP和无连接的UDP,这两种协议就是本章要讨论的主要内容。
2.端口号复用、分用
端口号简介
运行在计算机上的进程使用进程标识符PID来标志。
因特网上的计算机并不是使用统一的操作系统,不同的操作系统(windows, Linux, Mac OS)又使用不同格式的进程标识符。
为了使运行不同操作系统的计算机的应用进程之间能够进行网络通信,就必须使用统一的方法对TCP/IP体系的应用进程进行标识。
TCP/IP体系的运输层使用端口号来区分应用层的不同应用进程。
- 端口号使用16比特表示,取值范围0~65535;
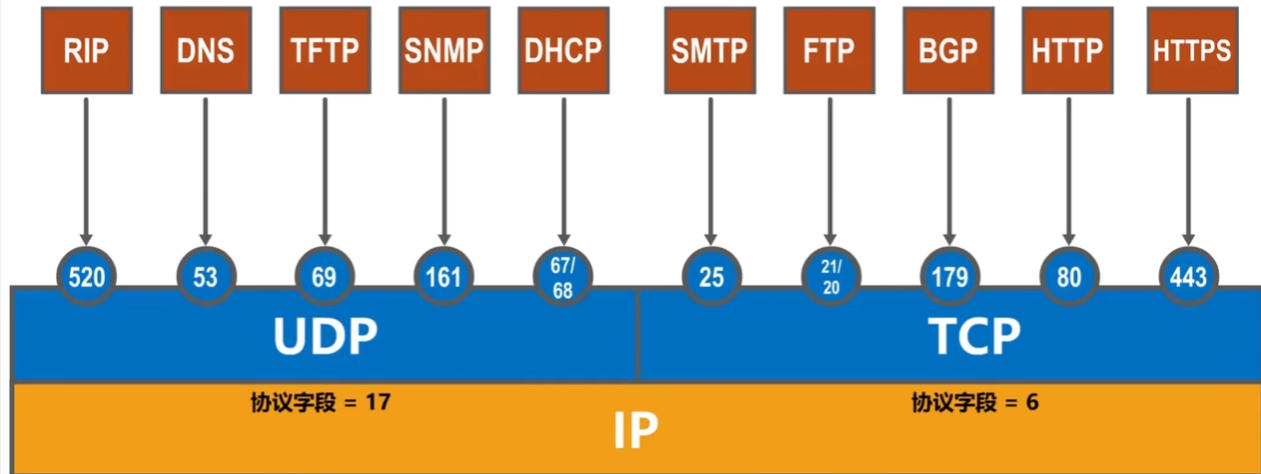
- 熟知端口号:0~1023,IANA把这些端口号指派给了TCP/IP体系中最重要的一些应用协议,例如:FTP使用21/20,HTTP使用80,DNS使用53。
- 登记端口号:1024~49151,为没有熟知端口号的应用程序使用。使用这类端口号必须在IANA按照规定的手续登记,以防止重复。例如:Microsoft RDP 微软远程桌面使用的端口是3389。
- 短暂端口号:49152~65535,留给客户进程选择暂时使用。当服务器进程收到客户进程的报文时,就知道了客户进程所使用的动态端口号。通信结束后,这个端口号可供其他客户进程以后使用。
端口号只具有本地意义,即端口号只是为了标识本计算机应用层中的各进程,在因特网中,不同计算机中的相同端口号是没有联系的。
发送方的复用和接收方的分用
示意图
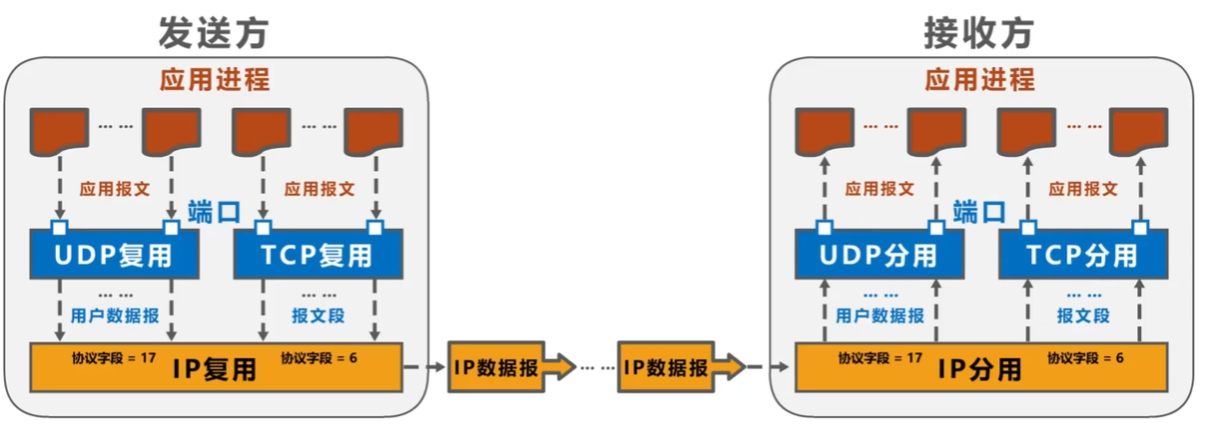
一个 IP 数据报里,只会封装一种运输层数据(要么是 UDP,要么是 TCP)
当交给网络层后会进行IP复用,并加上协议字段以标记使用的运输层协议(方便接收方分用)
到达接收方后进行分用,将分用后的数据交给应用层
TCP/IP体系应用层常用协议所使用的运输层熟知端口号
举例:以访问域名为例
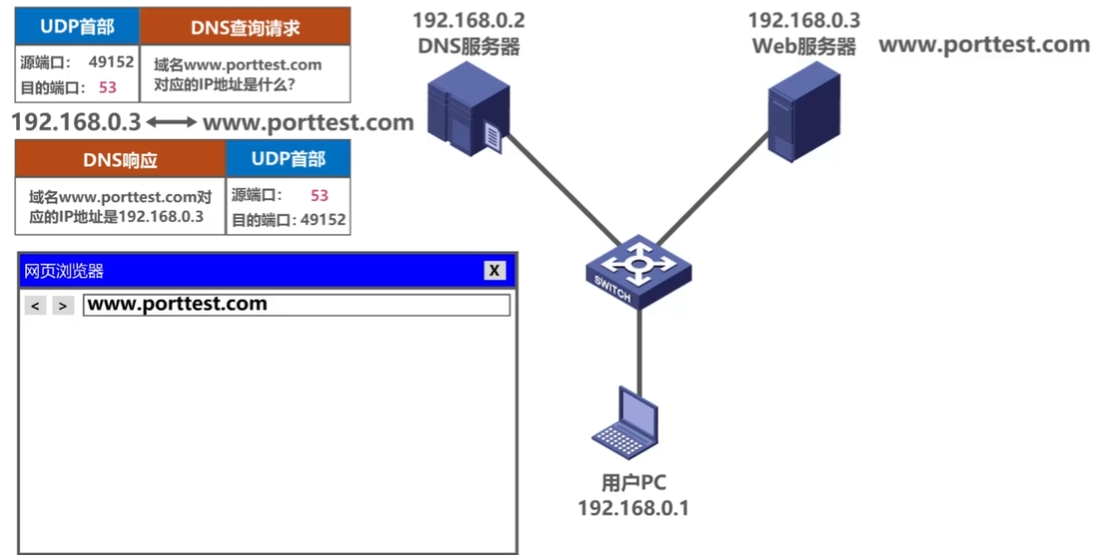
- PC向DNS服务器发送查询请求报文,附上UDP首部 其中源端口:在PC的短暂端口里任选一个作为源端口,目的端口即为DNS服务器的熟知端口53
- DNS服务器接收到查询请求报文后,将报文交由占用53号端口的进程,由其查询域名所对应的IP地址,查询到后发回回应报文
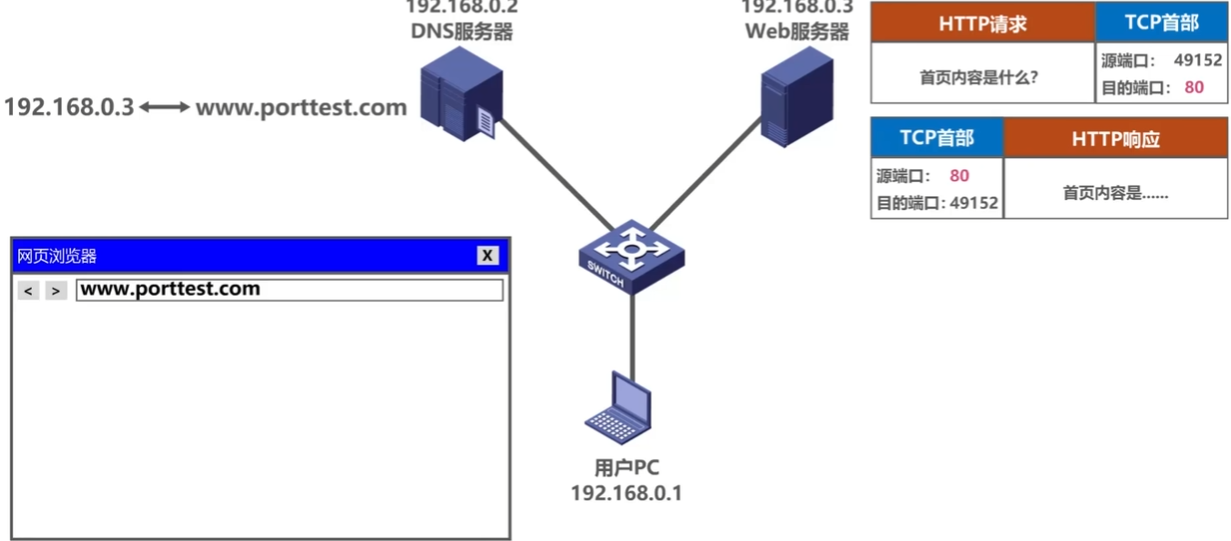
- 当PC接收到DNS的回应报文后就知道了Web服务器的IP地址,就可以与其进行HTTP通信了
- 进行HTTP通信时使用的是TCP协议,PC会挑选一个短暂端口给HTTP客户端进程作为源端口,并发给Web服务器的熟知端口80
- Web服务器收到请求后将报文交给占用80端口的HTTP进程 并发回HTTP响应
- PC收到响应报文后进行解析并显示网页内容
3.UDP和TCP的对比
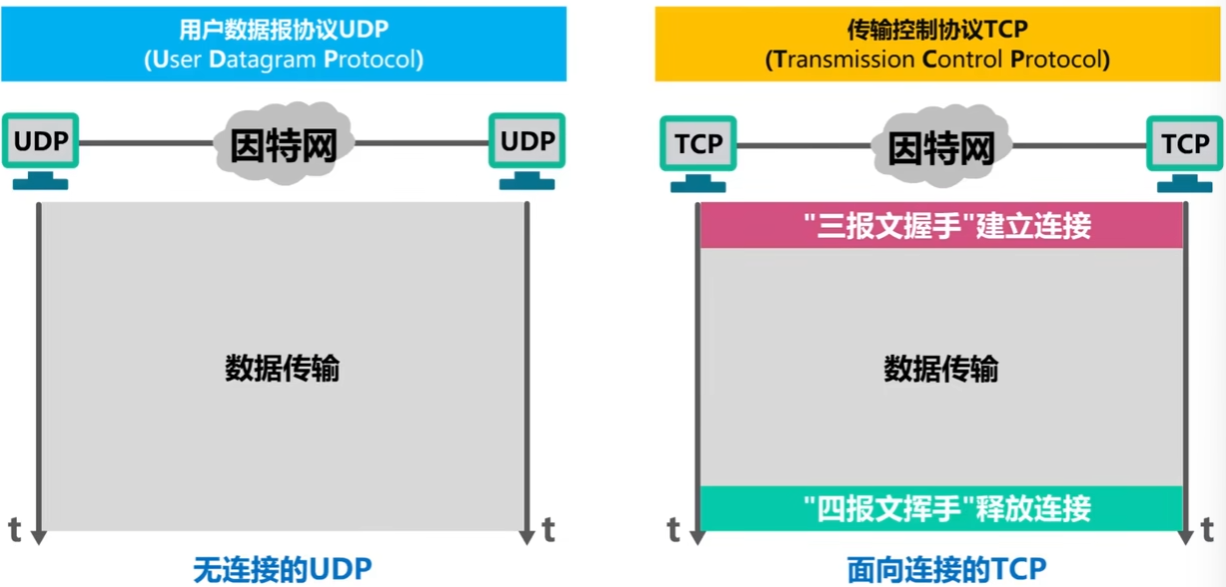
传输数据是否需要建立连接
传输对象数量
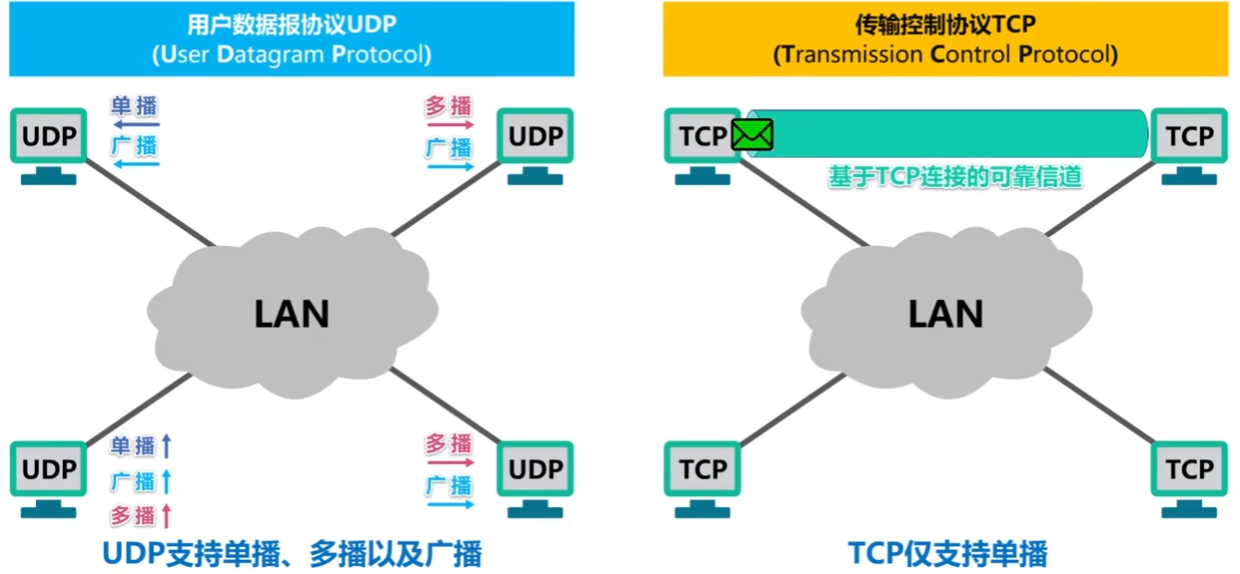
UDP支持一对一(单播)、一对多(多播)、一对全(广播)
TCP仅支持一对一(单播),TCP通信前需与另一台设备进行三次握手建立连接
传输方式
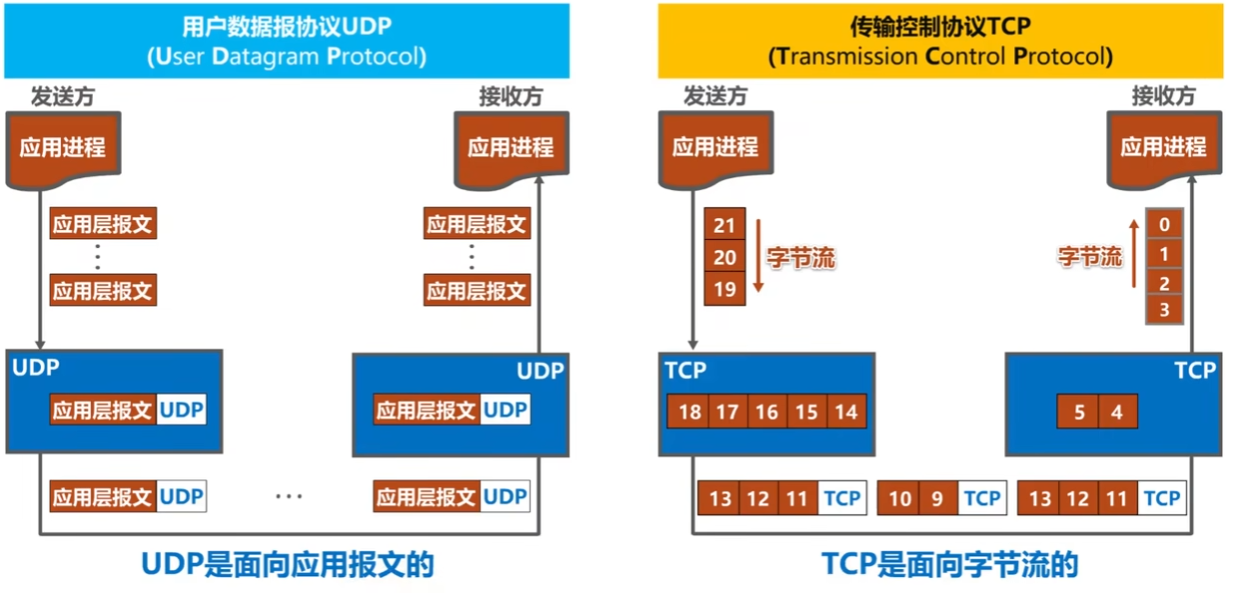
- UDP是面向应用报文的,不对应用报文进行合并/拆分
- TCP是面向字节流的,将报文看作是字节流,并对其进行拆分,拆分后加上TCP首部进行传输。所以应用层必须具备将字节流还原为报文原数据的能力
- tip:实际上TCP传输可实现全双工通信,即双方都可同时发送/接收数据
- TCP面向字节流正是其实现可靠传输、流量控制等的基础
误码后是否重传
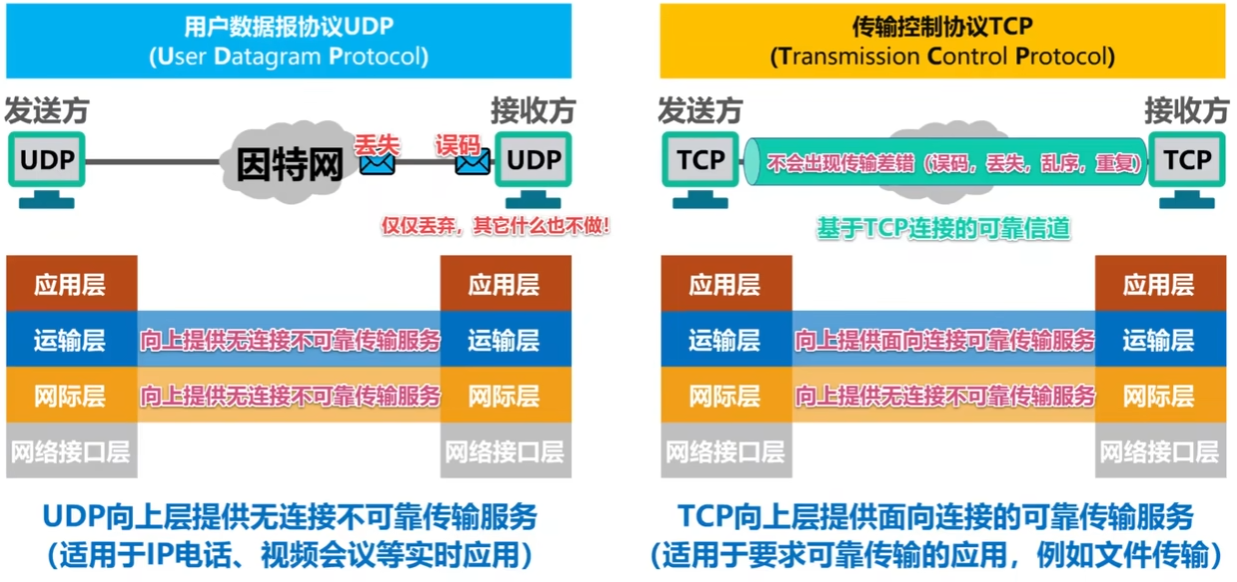
首部对比
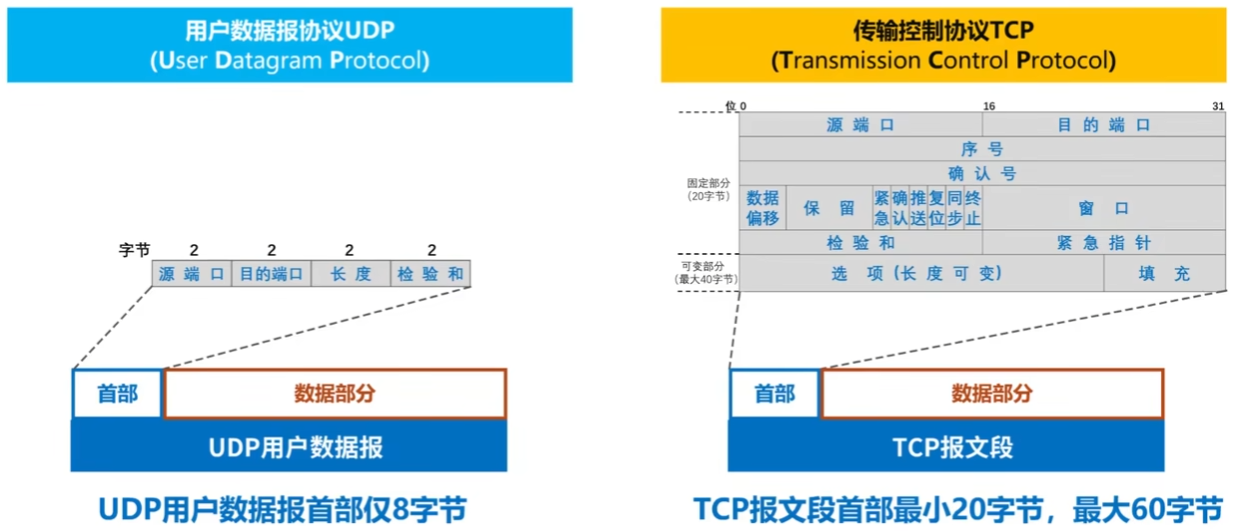
4.TCP的流量控制
TCP流量控制的简介与实现
简介
一般来说,我们总是希望数据传输得更快一些。 但如果发送方把数据发送得过快,接收方就可能来不及接收,这就会造成数据的丢失。
所谓流量控制(flow control)就是让发送方的发送速率不要太快,要让接收方来得及接收。
利用滑动窗口机制可以很方便地在TCP连接上实现对发送方的流量控制。
举例
前提条件:A、B已经建立TCP联系,A给B发送数据,B对A进行流量控制;A的发送窗口和B的接收窗口大小为400字节。 每个TCP报文段可携带100字节的数据
一、
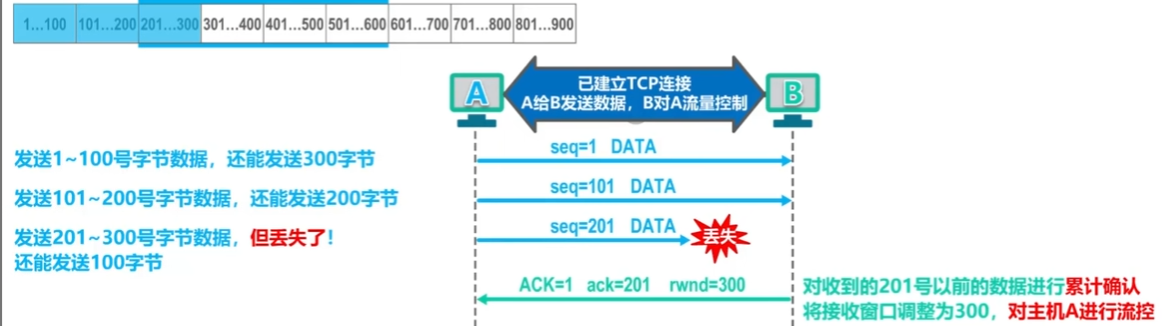
假设201~300号字节丢失。且此时B发回确认TCP报文,其中ACK是TCP首部中的标识字段,ACK=1表示该报文是TCP确认报文;ack=201表示201号前的数据都被接收(累计确认);rwnd=300表示B将自己的接收窗口调整为了300字节
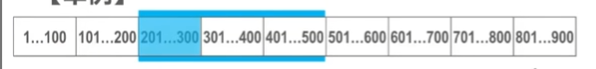
主机A接收到确认报文后窗口滑动到201处并删除缓存中1~200的数据,并将窗口大小设置为300
二、
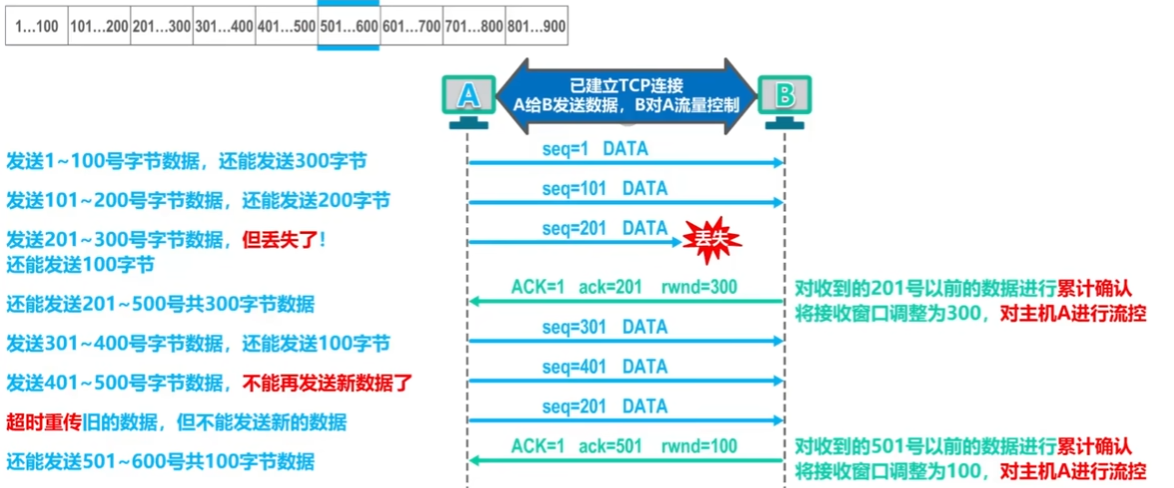
- 主机A向B传输301
400 401500的数据,并在原先丢失的201 ~ 300触发超时重传后重传。 当B都接收到后向A发送TCP确认报文,其中累积确认到501 并进行流量控制调整窗口大小为100. A接收到后进行相应的操作三、
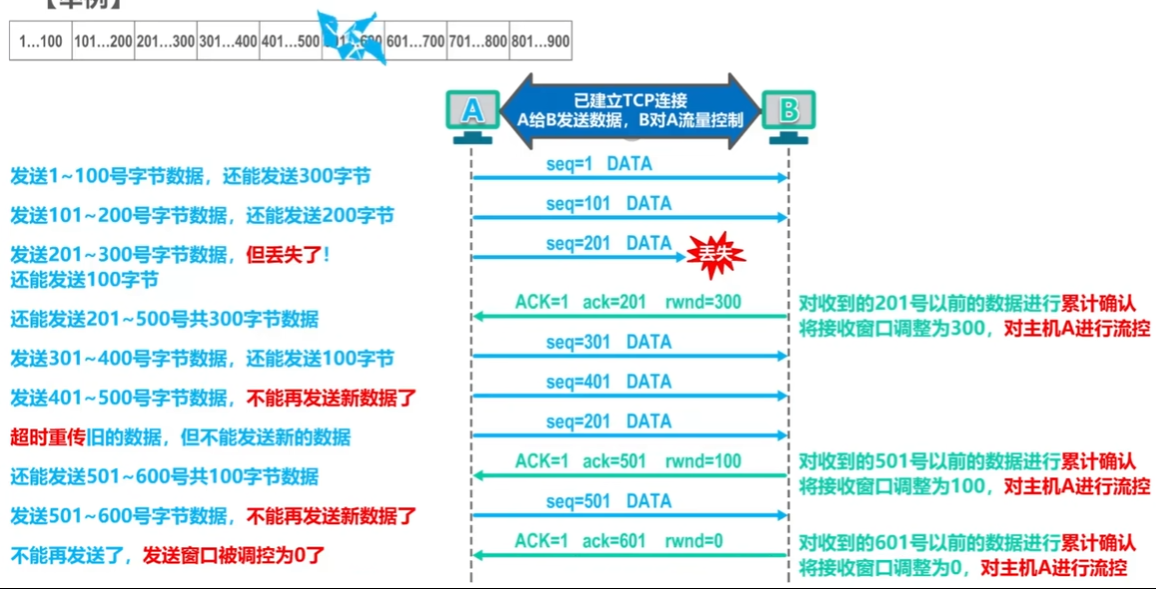
- B中没有存储空间了 流量控制调整窗口为0 A不进行转发,在接收到0窗口的通知后,持续计时器开始计时
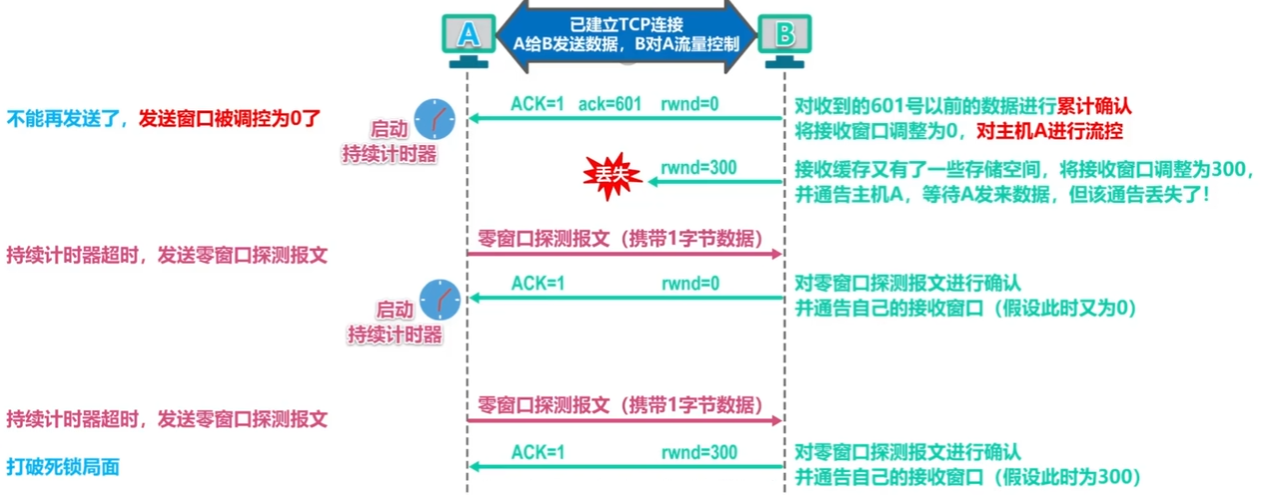
- 当持续计时器超时后,会发送方会发送零窗口探测报文。接收方接收到后会发送自己的窗口大小。 这样做就有效防止了0窗口通知后,调整窗口通知丢失而造成的死锁
TCP的流量控制习题
习题

甲只收到了第一个确认段,窗口向前滑动一个最大段长度,并将窗口调整为两个最大长度。还有一个最大长度的ack没有收到 所以甲还可以发送一个最大段长度即 A.1000
5.TCP拥塞控制
简介
在某段时间,若对网络中某一资源的需求超过了该资源所能提供的可用部分,网络性能就要变坏。这种情况就叫做拥塞(congestion)。
- 在计算机网络中的链路容量(即带宽)、交换结点中的缓存和处理机等,都是网络的资源。
若出现拥塞而不进行控制,整个网络的吞吐量将随输入负荷的增大而下降。
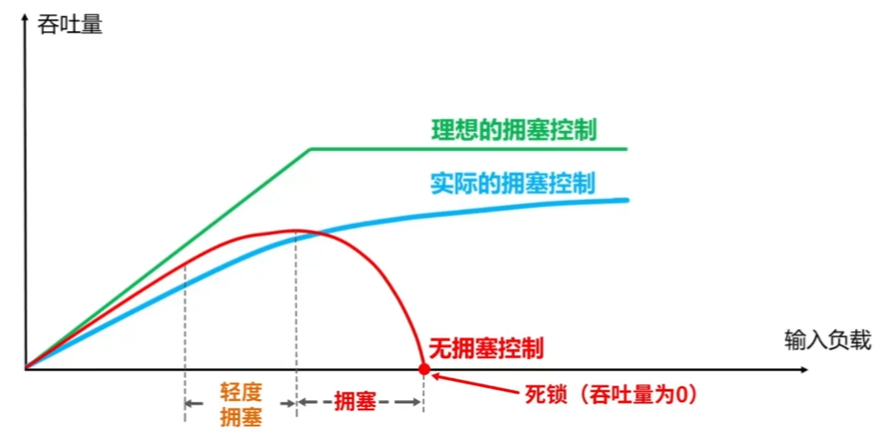
TCP的四种拥塞控制协议
为方便研究,假定如下条件
- 数据是单方向传送,而另一个方向只传送确认。
- 接收方总是有足够大的缓存空间,因而发送方发送窗口的大小由网络的拥塞程度来决定。
- 以最大报文段MSS的个数为讨论问题的单位,而不是以字节为单位。
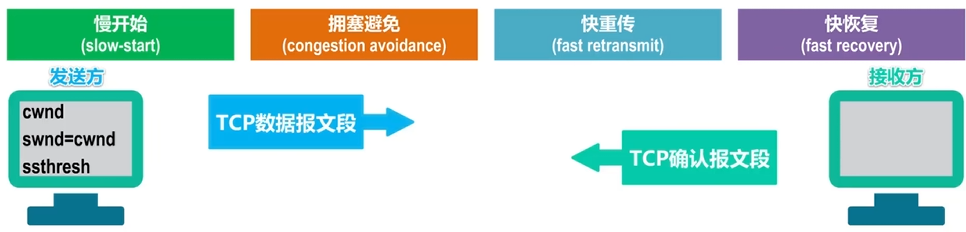
发送方维护一个叫做拥塞窗口cwnd的状态变量,其值取决于网络的拥塞程度,并且动态变化。
- 拥塞窗口cwnd的维护原则:只要网络没有出现拥塞,拥塞窗口就再增大一些;但只要网络出现拥塞,拥塞窗口就减少一些。
- 判断出现网络拥塞的依据:没有按时收到应当到达的确认报文(即发生超时重传)。
- 发送方将拥塞窗口作为发送窗口swnd,即
swnd = cwnd。- 维护一个慢开始门限ssthresh状态变量:
- 当
cwnd < ssthresh时,使用慢开始算法;- 当
cwnd > ssthresh时,停止使用慢开始算法而改用拥塞避免算法;- 当
cwnd = ssthresh时,既可使用慢开始算法,也可使用拥塞避免算法。
慢开始
简介
慢开始(Slow Start)是 TCP 拥塞控制的核心算法之一,它的核心目标是:在连接刚建立或网络出现拥塞后,以 “试探” 的方式逐步增大发送速率,避免一开始就用大流量冲垮网络。
举例
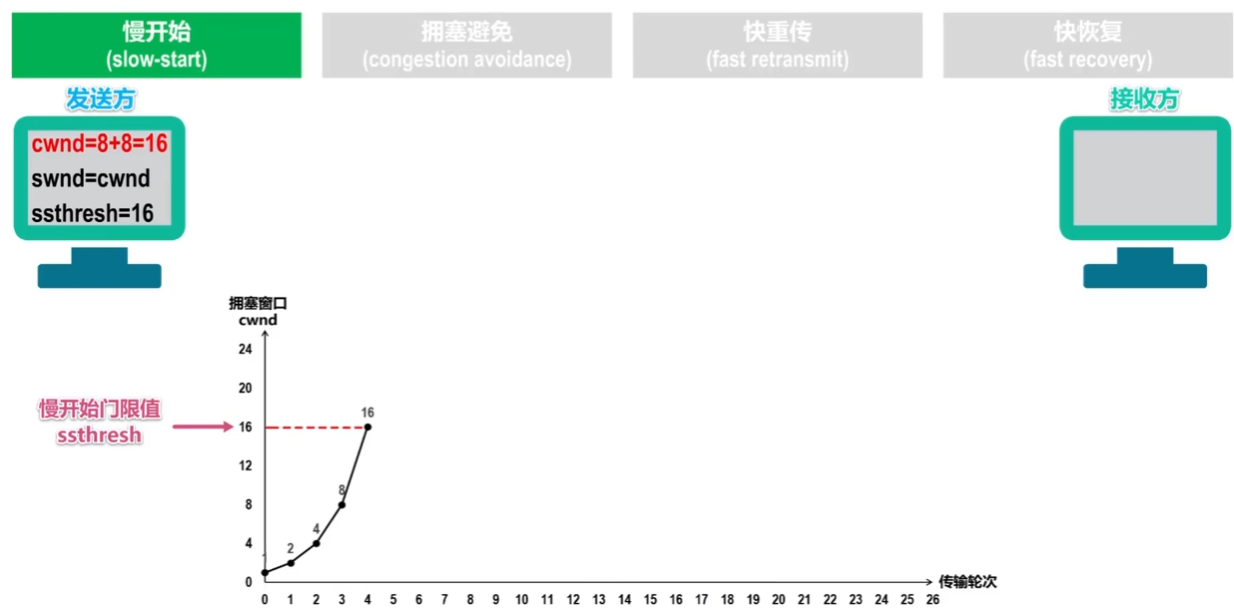
cwnd拥塞窗口大小在刚开始建立连接时为1,1个传输轮次代表数据从发送出去到接收的过程假定慢开始门限值为16 每收到 1 个对新报文段的 ACK
cwnd就加 1。这样一来,每经过一个传输轮次,cwnd 就会翻倍:
第 1 个 传输轮次:cwnd = 1 → 2
第 2 个 传输轮次:cwnd = 2 → 4
第 3 个 传输轮次:cwnd = 4 → 8 … 当窗口大小>慢开始门限时执行拥塞避免算法
拥塞避免算法
简介
拥塞避免算法,是 TCP 在慢开始之后,为了避免指数增长过快导致网络再次拥塞,切换到的线性增长阶段。
举例
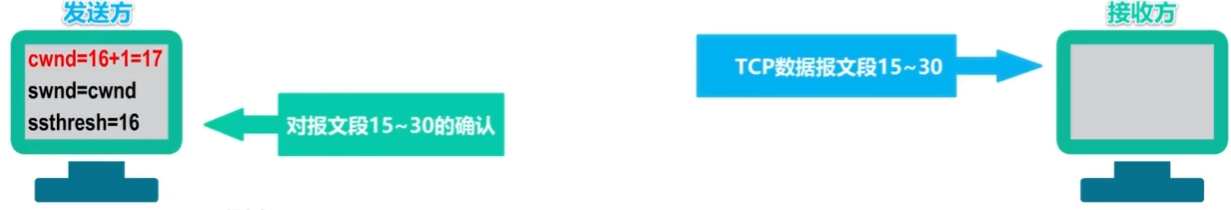
拥塞避免算法接收到确认报文后拥塞窗口每次只增大1
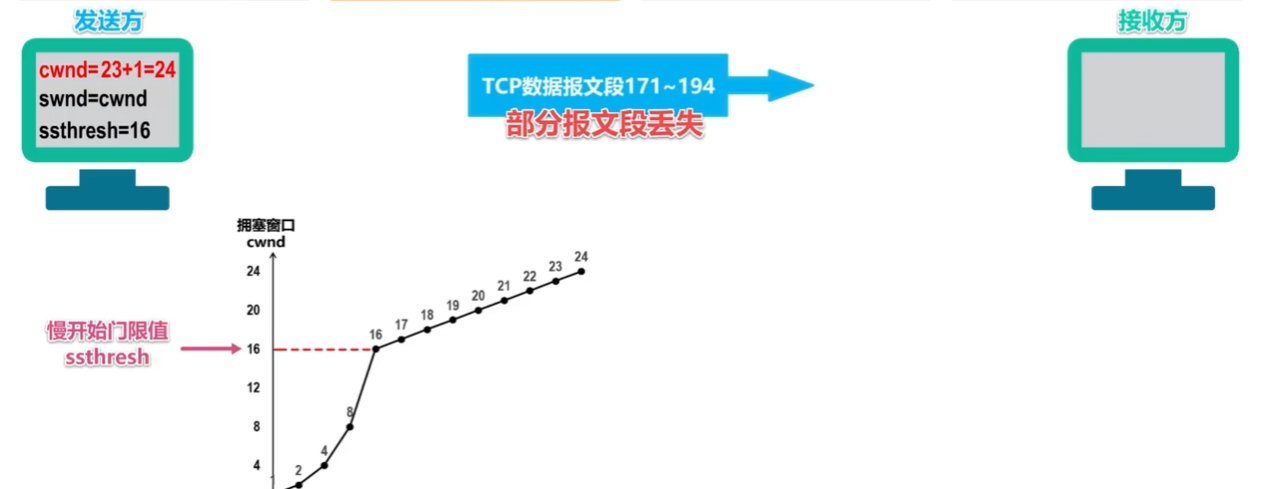
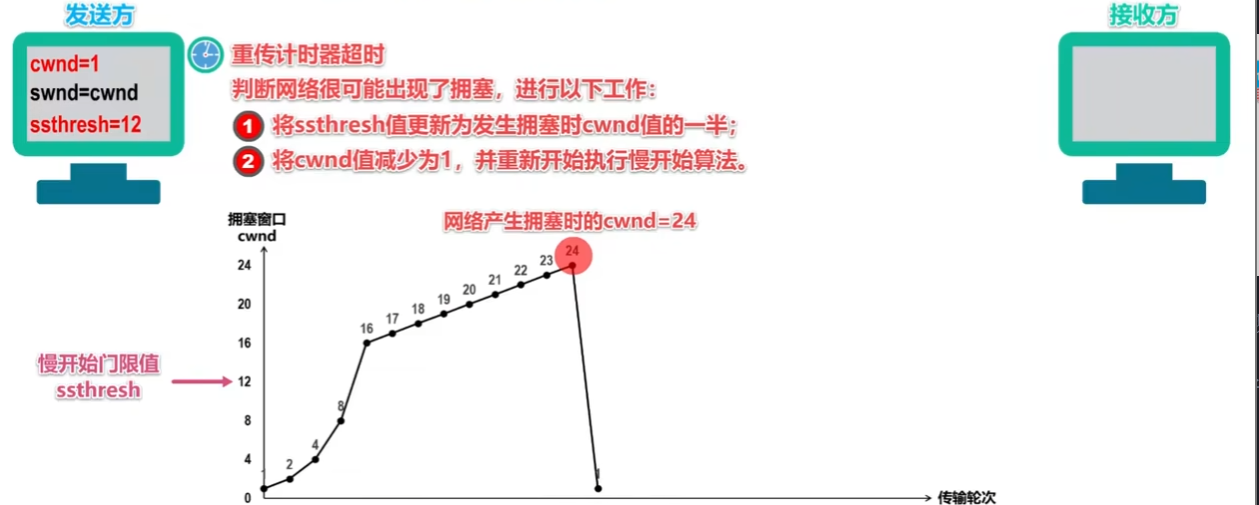
假设在窗口增大到24时出现了数据丢失,此时网络可能开始出现拥塞。当触发超时重传后,拥塞避免算法会执行以下操作:
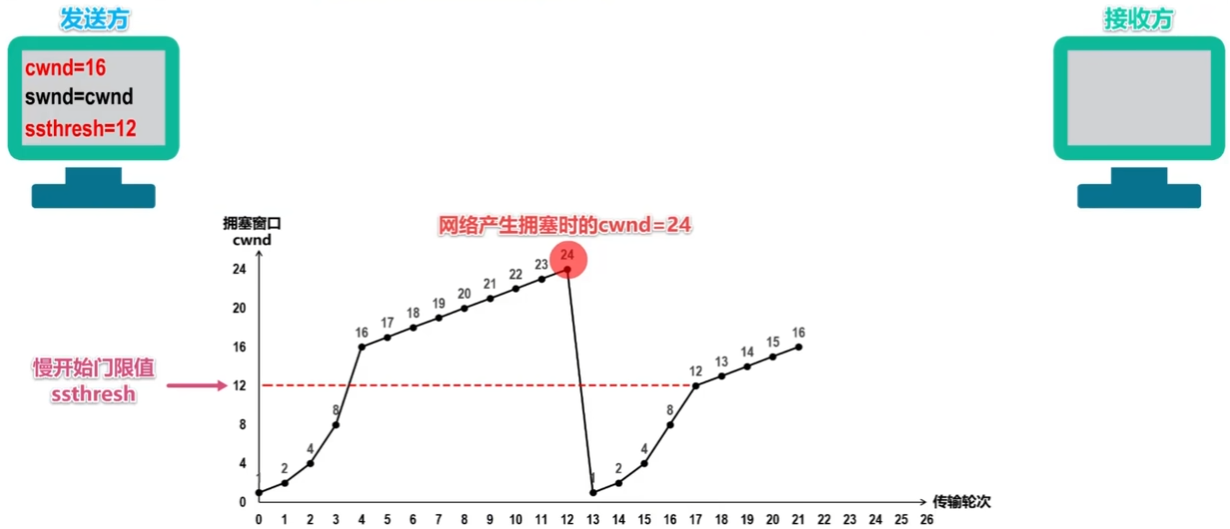
- 将ssthresh值更新为发生拥塞时cwnd值的一半;
- 将cwnd值变为1,并重新开始执行慢开始算法。
拥塞避免算法和慢开始算法就这样循环使用
快重传算法
简介
有时,个别报文段会在网络中丢失,但实际上网络并未发生拥塞。
这将导致发送方超时重传,并误认为网络发生了拥塞;
发送方把拥塞窗口cwnd又设置为最小值1,并错误地启动慢开始算法,因而降低了传输效率。
采用快重传算法可以让发送方尽早知道发生了个别报文段的丢失。 所谓快重传,就是使发送方尽快进行重传,而不是等超时重传计时器超时再重传。
要求接收方不要等待自己发送数据时才进行捎带确认,而是要立即发送确认;
即使收到了失序的报文段也要立即发出对已收到的报文段的重复确认。
发送方一旦收到3个连续的重复确认,就将相应的报文段立即重传,而不是等该报文段的超时重传计时器超时再重传。
举例
示意图
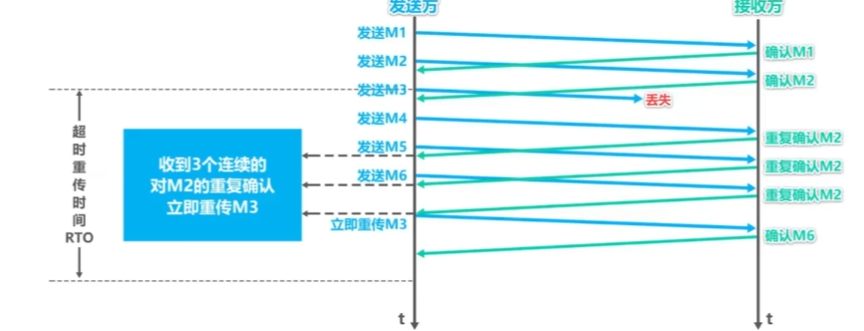
解析
- M3丢失后,在未触发超时重传前发送方会继续发送M4、M5、M6
- 当接收方收到M4时,发现接收的顺序不对(少了M3),就会立即重新发送M2确认,表示:我想要的是M3报文段,但是我收到的是为按序到达的报文段
- M5、M6同理。 当发送方连续收到三个M2确认,就会立即重传M3,如此一来,就在触发超时重传前重传了M3。 既然未触发超时重传,也就意味着网络其实并不拥塞,那么也就不用将窗口大小重新设为1
使用快重传算法可将网络吞吐量提高约20%
快恢复算法
简介
快恢复(Fast Recovery)是 TCP 拥塞控制中,配合快重传一起使用的算法。
当连续收到三个重复确认后,快恢复算法会执行如下操作
- 更新慢开始门限ssthresh为**当前窗口cwnd大小的一半 ** ssthresh=cwnd/2
- 设置cwnd大小为ssthresh cwnd=ssthresh
- 直接执行拥塞控制算法
示意图
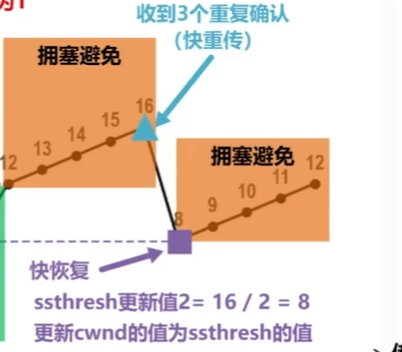
TCP拥塞控制习题
习题
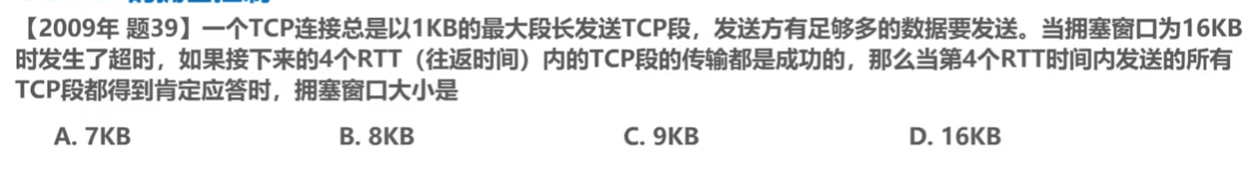
注意:题中说到发生了超时,说明网络发生了拥塞,所以将慢开始门限设为8 将拥塞窗口重设为1
接下来的4个RTT中 前三个RTT窗口大小变化 1–>2 2–>4 4–>8 此时到达慢开始门限,最后一个RTT执行的是拥塞避免算法 所以第四个RTT窗口大小变化是 8–>9 C
6.TCP超时重传时间的选择
超时重传时间RTO的选择
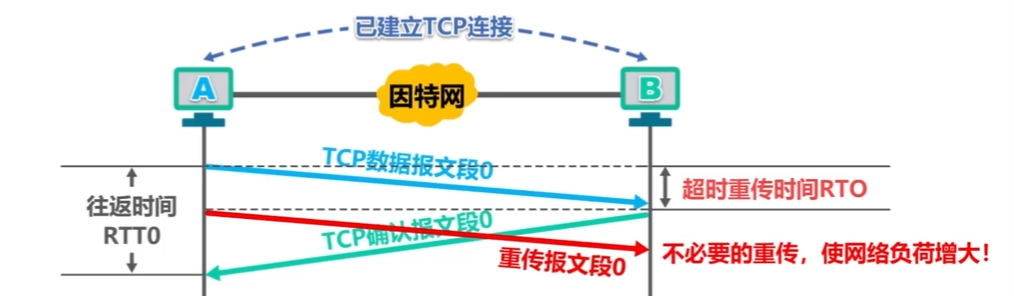
RTO<RTT时会造成不必要的重传
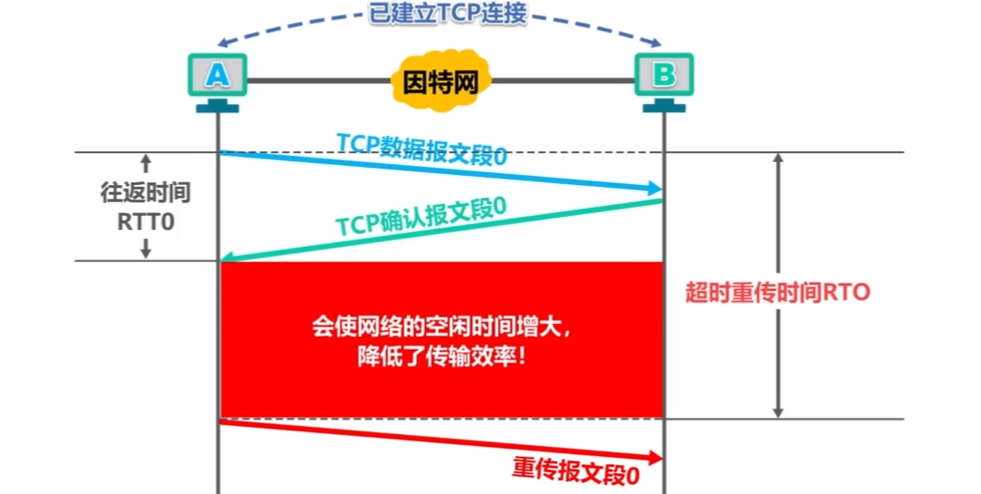
RTO>>RTT时会降低传输效率
综上,RTO应略大于RTT
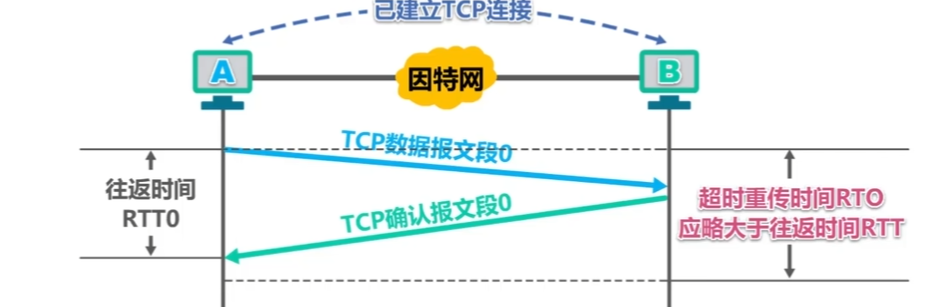
由于RTT受信道传输速率、带宽、报文段大小等各个因素的影响,所以我们不能直接选用单次的RTT作为RTO的确立标准
一般会利用每次测量得到的RTT样本,计算加权平均往返时间RTTₛ(又称为平滑的往返时间)。 新的 旧的 新的 样本 在上式中,:已成为建议标准的RFC6298推荐的 值为1/8,即0.125。
在得到RTT
s后,再根据以下公式计算RTORTO=RTT
s+4*RTTD其中RTTD为RTT偏差的加权平均数,计算过程如下RTT偏差的加权平均RTT_D 新的 旧的 已成为建议标准的RFC6298推荐的 值为1/4,即0.25。
由上述计算过程可见,RTO和RTT
S的计算都是基于RTT的,但是RTT的测算也是较为复杂的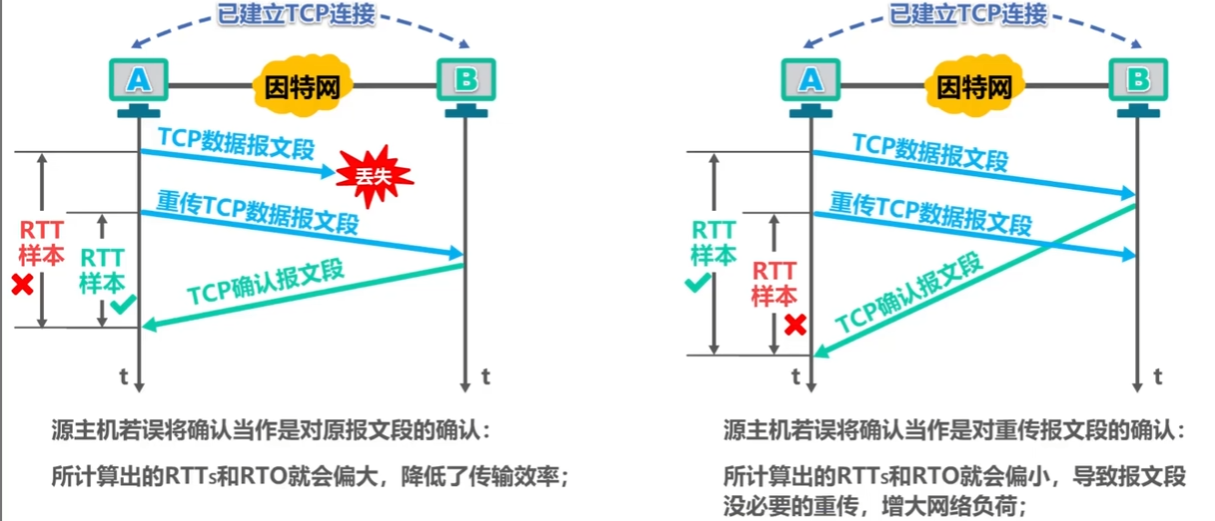
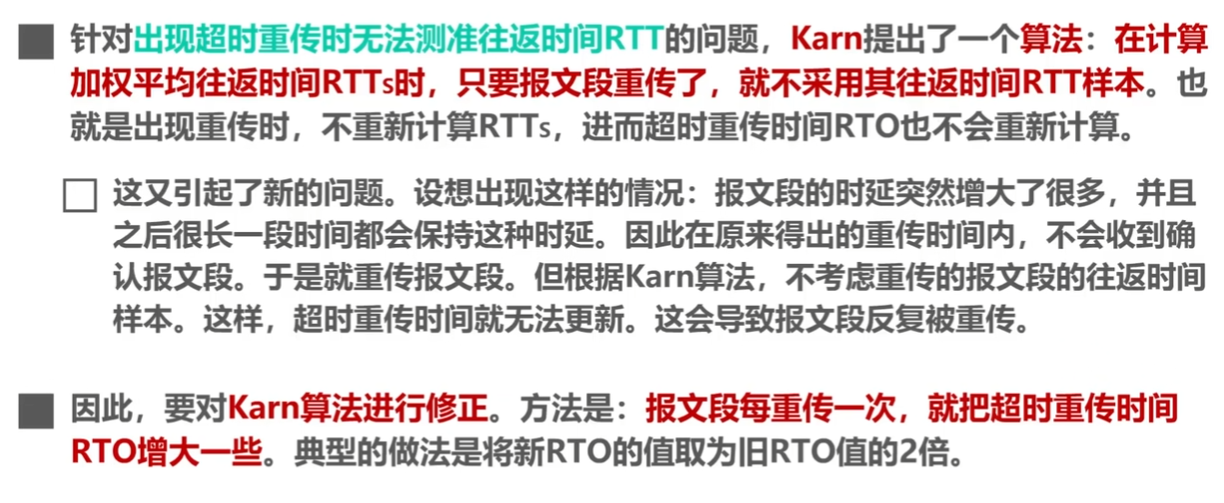
举例
由于本节内容很复杂,详见 10~12min
7.TCP可靠传输的实现
综述
TCP的可靠传输基于以字节为单位的滑动窗口实现
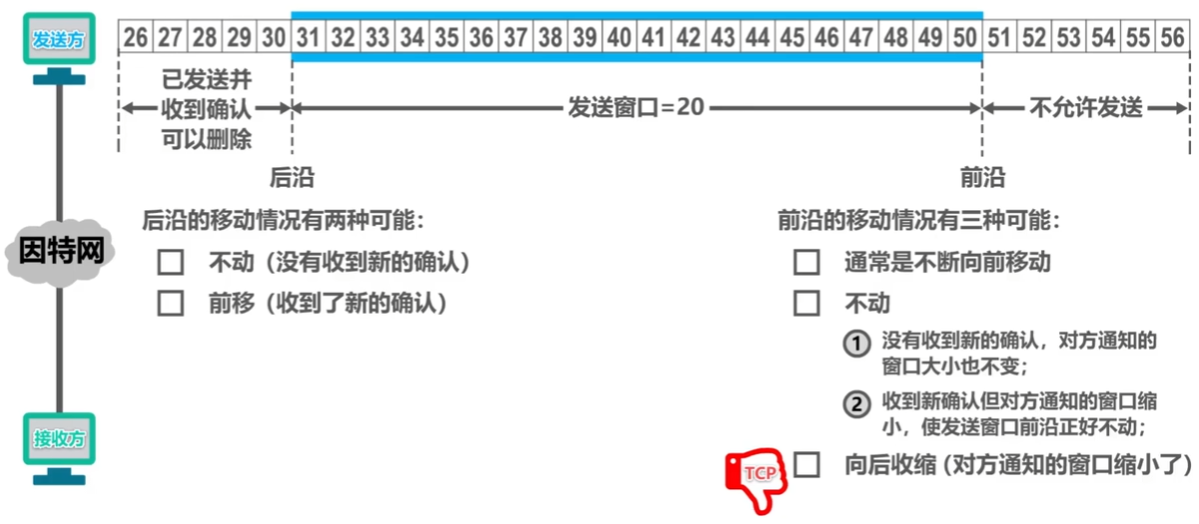
前沿缩小的情况不被TCP标准推荐,原因:当发送方将靠近前沿的数据发送出去后,在收到这些数据的ack前收到窗口缩小的通知,缩小窗口后原先那些发送的数据就不在窗口内了。如此再收到那些数据的ack时就会出错
如何描述发送窗口的状态?
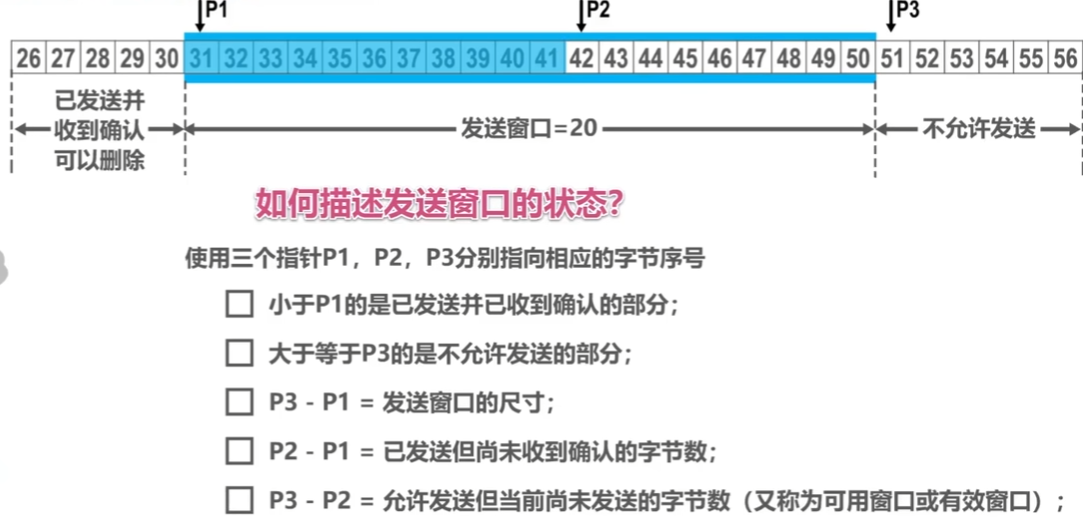
:star
GBN (#回退N帧协议 (Go-back_N , GBN))和[SR](#选择重传协议 (Selective Repeat , SR))的混合体TCP可靠传输是滑动窗口机制,是GBN和SR的混合形式:
TCP可靠传输的接收窗口大于1(这点和SR一样)。
TCP可靠传输当中,会接收失序到达的分组,而不是丢弃这些分组(这里和SR一样),但是当接收到失序的分组之后,和SR不一样的是,TCP收到失序分组不会返回失序分组对应的ACK,而是返回此时接收方顺序接收的最后一个数据分组。(这里又和GBN一样了,也就是在确认的时候,采用累计确认的方式)。
注意事项
虽然发送方的发送窗口是根据接收方的接收窗口设置的,但在同一时刻,发送方的发送窗口并不总是和接收方的接收窗口一样大。
网络传送窗口值需要经历一定的时间滞后,并且这个时间还是不确定的。
发送方还可能根据网络当时的拥塞情况适当减小自己的发送窗口尺寸。
对于不按序到达的数据应如何处理,TCP 并无明确规定。
如果接收方把不按序到达的数据一律丢弃,那么接收窗口的管理将会比较简单,但这样做对网络资源的利用不利,因为发送方会重复传送较多的数据。
TCP 通常对不按序到达的数据是先临时存放在接收窗口中,等到字节流中所缺少的字节收到后,再按序交付上层的应用进程。
TCP 要求接收方必须有累积确认和捎带确认机制,这样可以减小传输开销。接收方可以在合适的时候发送确认,也可以在自己有数据要发送时把确认信息顺便捎带上。
接收方不应过分推迟发送确认
,否则会导致发送方不必要的超时重传,这反而浪费了网络的资源。
TCP 标准规定,确认推迟的时间不应超过 0.5 秒。若收到一连串具有最大长度的报文段,则必须每隔一个报文段就发送一个确认 [RFC 1122]。
捎带确认实际上并不经常发生,因为大多数应用程序很少同时在两个方向上发送数据。
TCP 的通信是全双工通信。通信中的每一方都在发送和接收报文段。因此,每一方都有自己的发送窗口和接收窗口。在谈到这些窗口时,一定要弄清楚是哪一方的窗口。
TCP可靠传输的实现习题
习题1

累计确认 200+300+500=1000 D
习题2
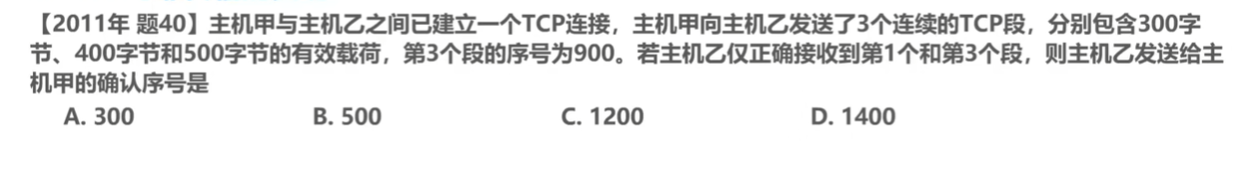
第3个序号为900 则第一个为900-300-400=200 仅接收到1 3 累计确认发送的确认序号应为200+300=500 B
8.TCP运输的连接管理
三次握手建立连接
TCP 的连接建立要解决以下三个问题:
① 使 TCP 双方能够确知对方的存在;
② 使 TCP 双方能够协商一些参数(如最大窗口值、是否使用窗口扩大选项和时间戳选项以及服务质量等);
③ 使 TCP 双方能够对运输实体资源(如缓存大小、连接表中的项目等)进行分配。
三报文握手建立连接过程
TCP服务器创建传输控制块,用于存储TCP连接过程中的一些重要信息
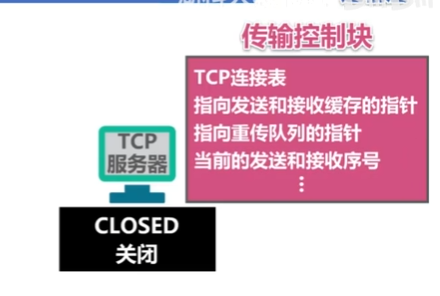
TCP服务器进程进入监听状态,等待TCP客户进程的连接请求
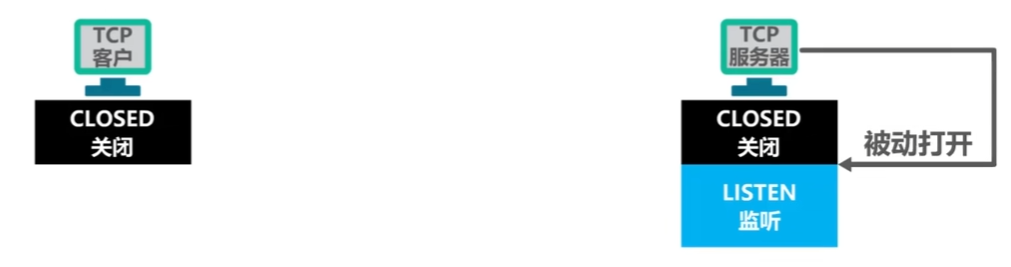
TCP客户进程也是先创建传输控制块,后向TCP服务器发送TCP连接请求报文
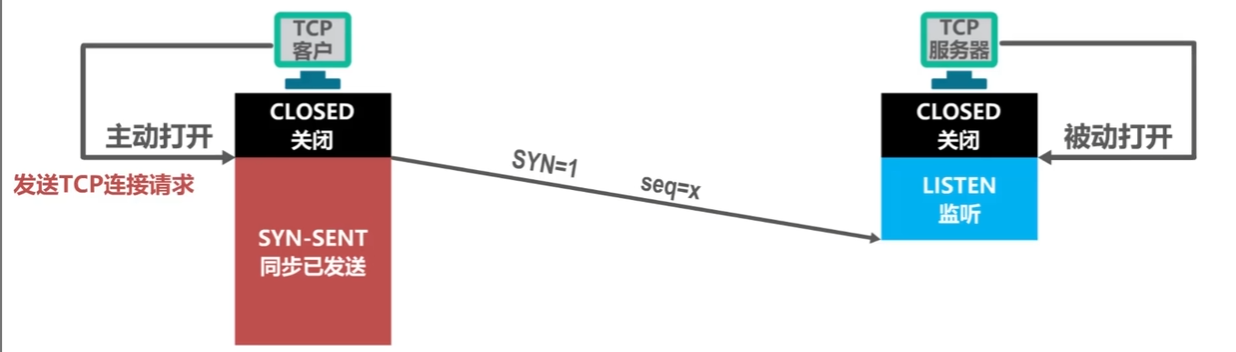
同步位SYN=1表明这是一个TCP连接请求报文段
序号字段seq被设置了一个初始值x,作为TCP进程所选择的初始序号
:star
:TCP规定,SYN=1的请求报文段不能携带数据,但是要消耗一个序号 TCP服务器进程收到请求报文段后,若同意,则向TCP客户进程发送TCP连接请求确认报文段
,并进入同步已接收状态
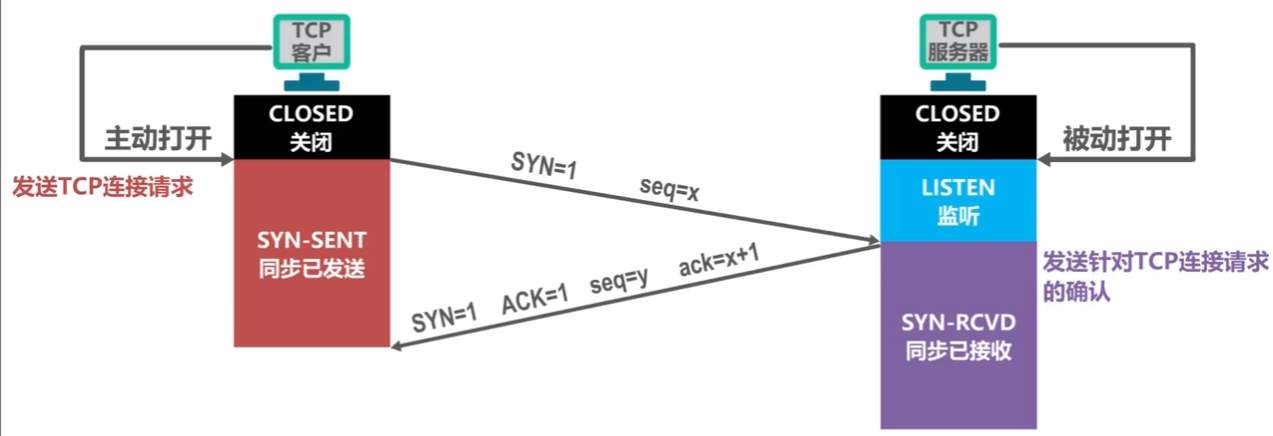
同步位SYN=1且ACK=1表示这是一个TCP连接请求确认报文段
序号字段seq被设置了一个初始值y,作为TCP服务进程选择的初始序号
确认号字段ack=x+1 这是对TCP客户进程所选择的初始序号的确认,意思为**“我已收到x序号字段,下次收到的应该是x+1字段”**
TCP客户进程收到TCP请求确认报文段后,还要向TCP服务器发送一个普通的TCP确认报文段,并进入连接已确立状态 (此时二者都进入了连接已建立状态,可以进行数据传输了)
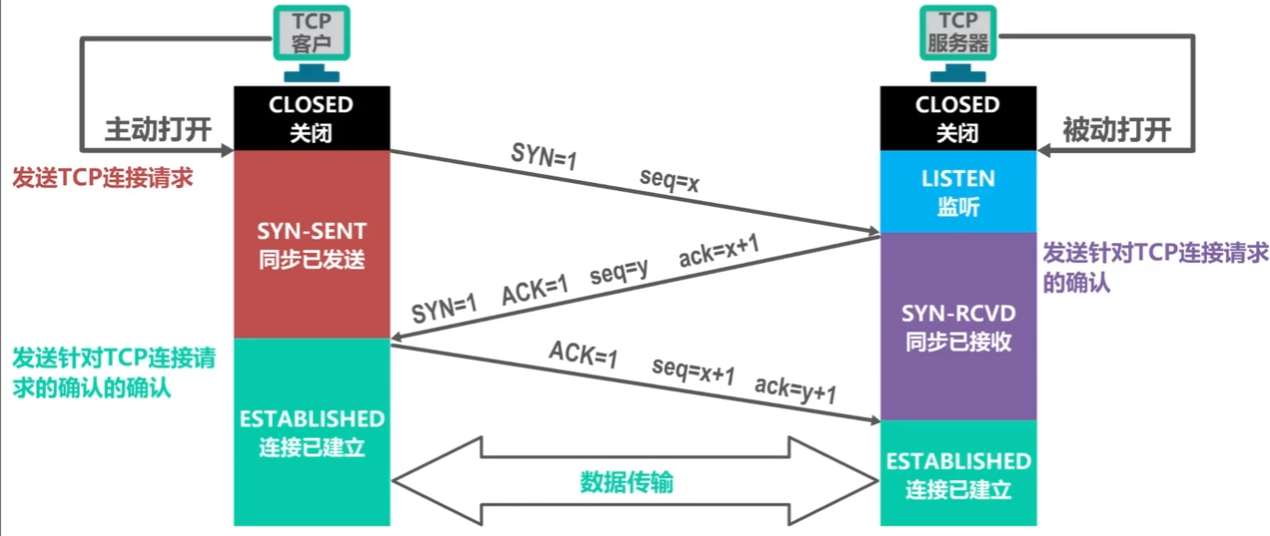
ACK=1且无SYN,表明这是一个普通的TCP确认报文段
序号字段seq=x+1,序号+1
确认号字段ack=y+1 是对TCP服务器所选初始序号的确认 意思为:“我已收到y序号字段,下次收到的应该是y+1字段”
:star
,TCP普通报文段可以携带数据,但若不携带数据,则不消耗序号
使用三报文握手的原因
为什么不用两报文握手建立? 即:为什么要多出最后一个TCP普通报文段?
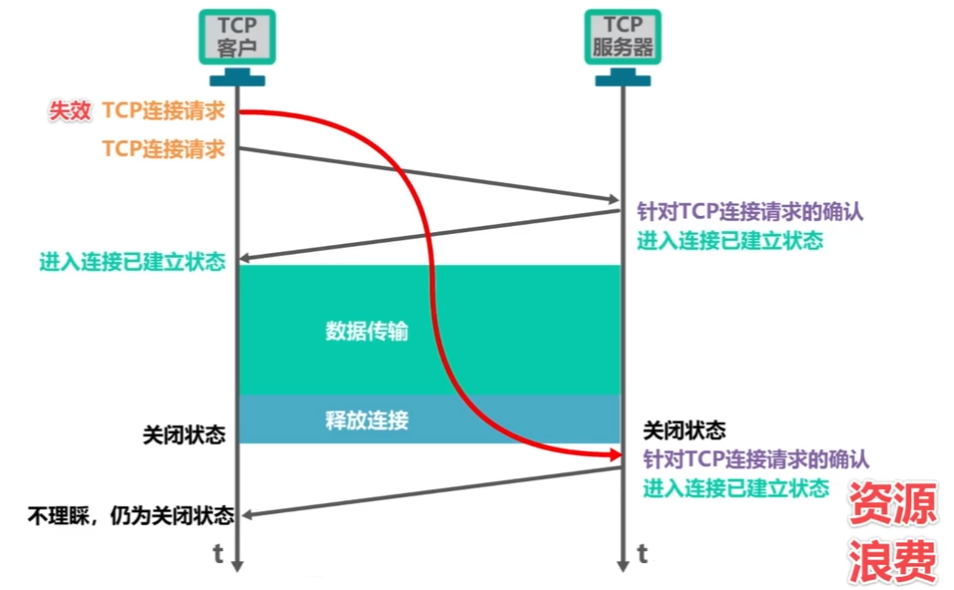
如图所示,假设两报文握手建立连接。 假设TCP客户第一次发送的连接请求报文因某些原因无法及时到达TCP服务器,触发超时重传后重传,当TCP客户和TCP服务器建立连接并传输完数据后释放连接。在释放连接后TCP服务器收到了第一次发送的请求报文并建立连接,但是此时发回去的确认报文段不会被TCP客户所接收,那么TCP服务器就会一直处于连接状态浪费资源
而若是采用三报文握手的方式建立连接,就相当于在建立连接状态前多加入了一个缓冲状态 —— 同步状态 这样就很好的防止了已失效的连接请求报文段突然又传送到了 TCP 服务器,因而导致错误。
TCP建立连接习题
习题
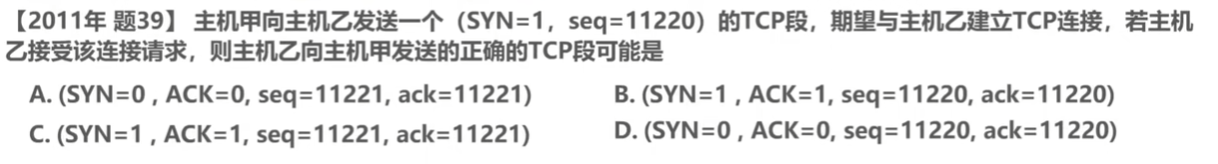
SYN=1 ACK=1 seq=y ack=11221 C
四次挥手断开连接
建立连接的双方都可以发起断开连接
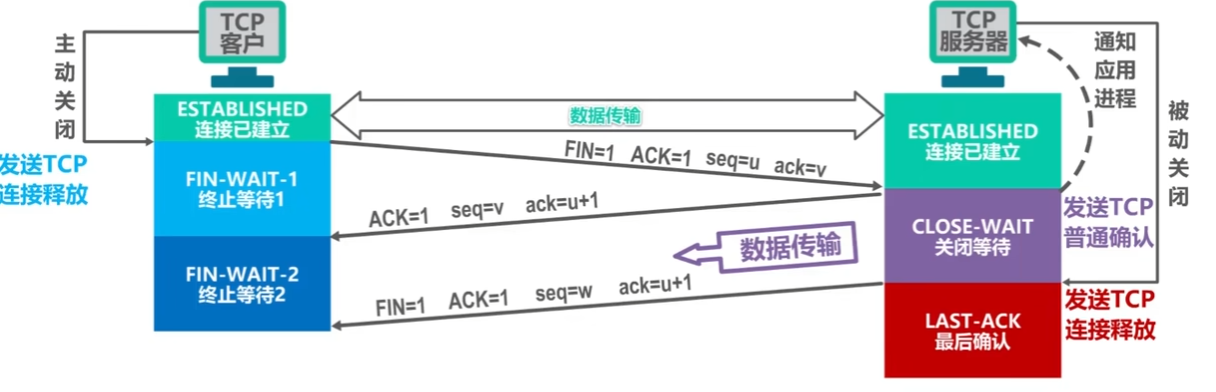
四次挥手断开连接具体过程 (假设TCP客户主动发起断开连接)
TCP客户主动断开连接,发送TCP连接释放报文段,并进入终止等待1状态
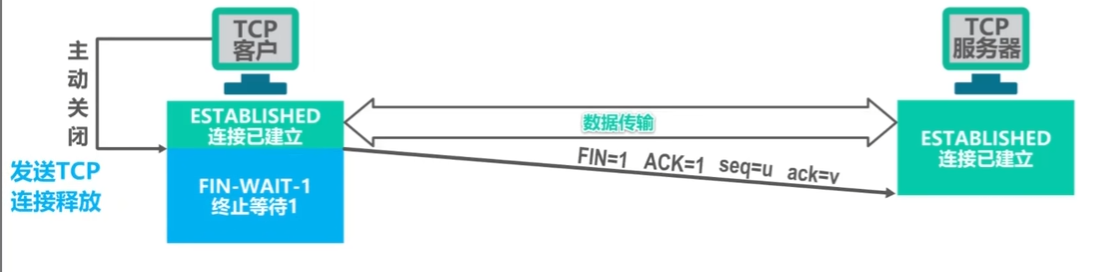
FIN=1且ACK=1 表示这是一个TCP连接释放报文段,同时对先前数据传输时收到的报文段进行确认
seq=u,u=TCP客户进程所传送的最后一个报文段序号+1
ack=v 表示表示客户端确认收到了服务器之前发送的所有数据,下一期待收到的序号是
v。:star
:TCP规定FIN=1的连接释放报文段不能携带数据,但是要消耗一个序号 TCP服务进程收到TCP连接释放报文段后,会发送一个普通的TCP确认报文段,并进入关闭等待状态,此时TCP服务器进程会通知高层应用进程断开连接,那么由客户端–>服务器的通信通道就关闭了
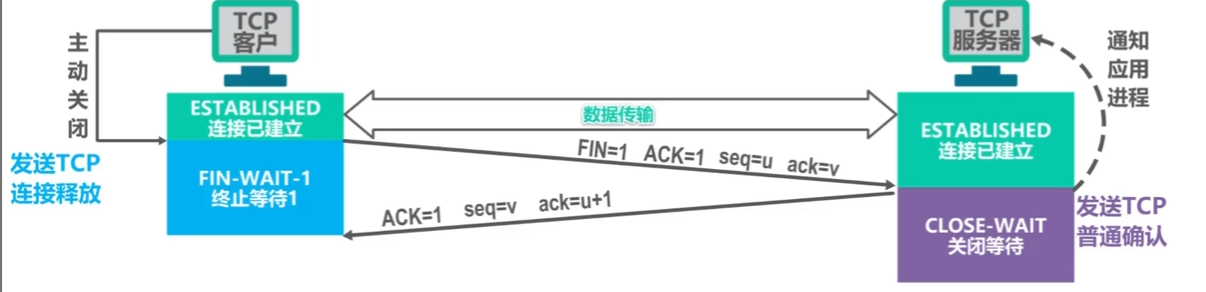
ACK=1表明这是一个普通TCP确认报文段
seq=v表示该报文段序号为v(TCP先前发送过的最后一个报文段序号+1)
ack=u+1表明TCP服务器收到了TCP客户端的u号报文段,下一次期待u+1号报文段
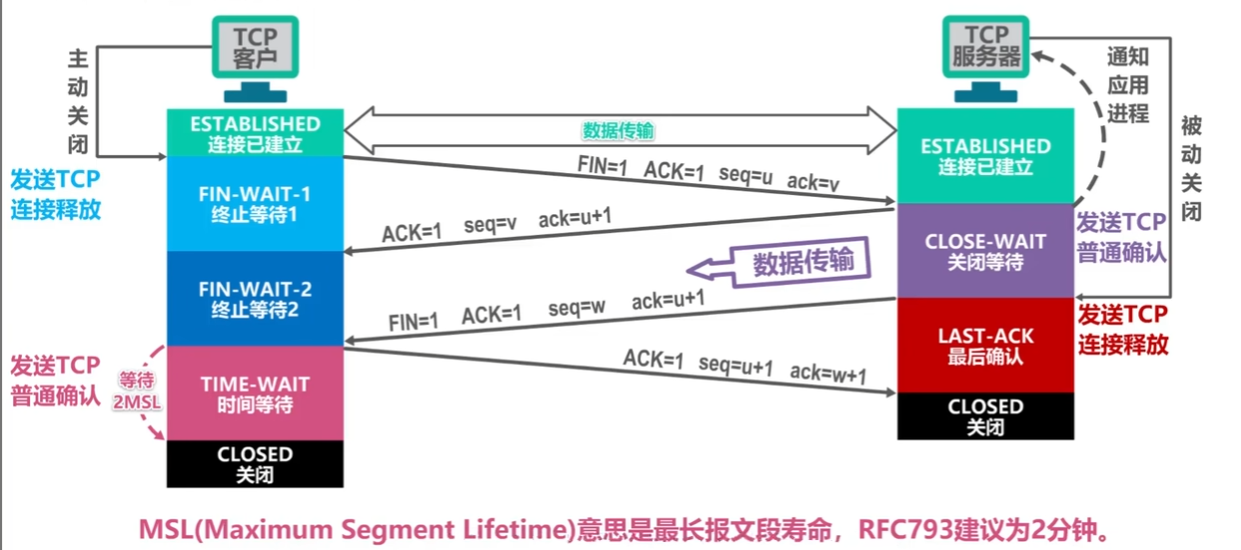
TCP客户进程收到TCP确认报文段后就进入终止等待2状态,等待TCP服务器发出的TCP连接释放报文段。 在2中提到 客户–>服务器的通道已经关闭 但是服务器–>客户并未关闭,所以此时TCP服务器仍能向客户端传输数据。 当没有数据要传输时,TCP服务进程会发送连接释放报文段,并进入最后确认状态
FIN=1且ACK=1 表示这是一个TCP连接释放报文段,同时对先前数据传输时收到的报文段进行确认
seq=w 而不是 v+1 原因是在2后TCP服务器可能还发送了一些数据
ack=u+1,这是对1中TCP客户发送的TCP连接释放报文段的重复确认
TCP客户收到TCP连接释放报文段后,向TCP服务器发送普通TCP确认报文段,并进入时间等待状态 TCP服务器收到后关闭,而TCP客户进程需要等待2MSL才可关闭
时间等待状态的意义及保活计时器
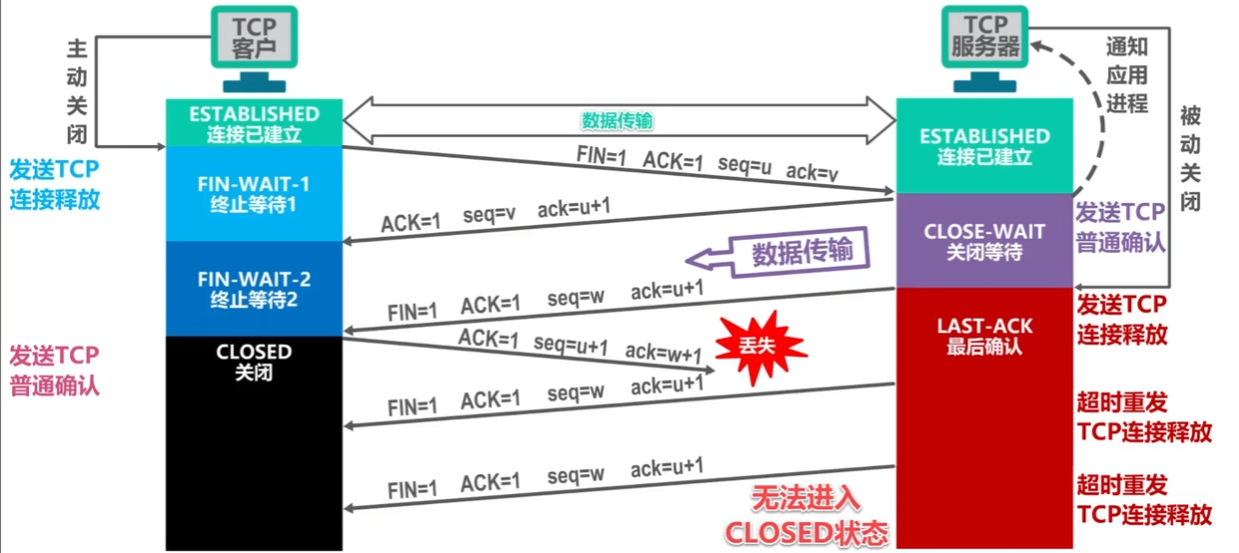
若没有时间等待状态,可能会导致另一方无法关闭
保活计时器
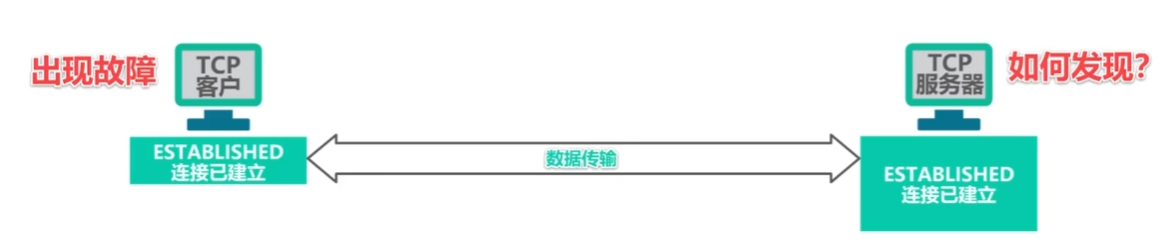
TCP 服务器进程每收到一次 TCP 客户进程的数据,就重新设置并启动保活计时器(2 小时定时)。
若保活计时器定时周期内未收到 TCP 客户进程发来的数据,则当保活计时器到时后,TCP 服务器进程就向 TCP 客户进程发送一个探测报文段,以后则每隔 75 秒钟发送一次。若一连发送 10 个探测报文段后仍无 TCP 客户进程的响应,TCP 服务器进程就认为 TCP 客户进程所在主机出了故障,接着就关闭这个连接。
9.TCP首部格式
TCP报文段的首部格式与IP数据报首部格式类似
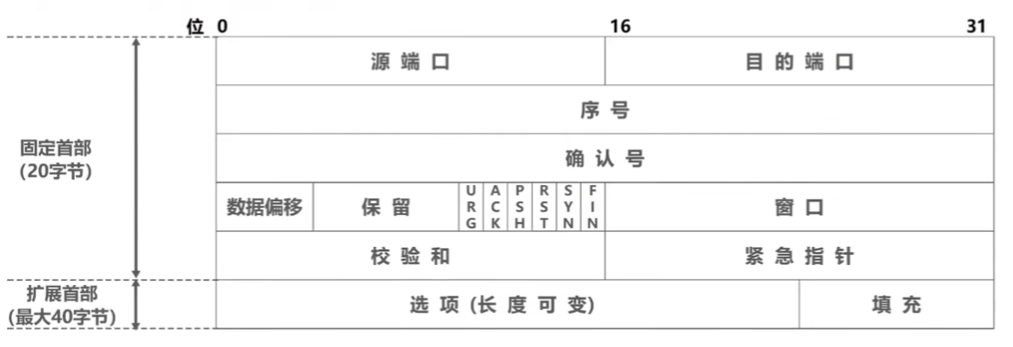
源端口和目的端口
源端口:占16比特,写入源端口号,用来标识发送该TCP报文段的应用进程。
目的端口:占16比特,写入目的端口号,用来标识接收该TCP报文段的应用进程。
序号
占32比特,取值范围,序号增加到最后一个后,下一个序号就又回到0。 指出本TCP报文段数据载荷的第一个字节的序号。
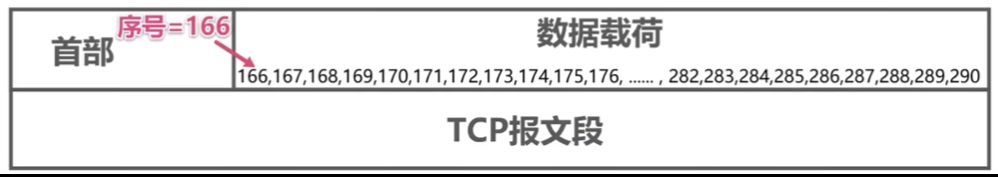
确认号字段和ACK字段
确认号:占32比特,取值范围,确认号增加到最后一个后,下一个确认号就又回到0。
指出期望收到对方下一个TCP报文段的数据载荷的第一个字节的序号,同时也是对之前收到的所有数据的确认。
例子:若确认号=n,则表明到序号n-1为止的所有数据都已正确接收,期望接收序号为n的数据。
ACK:只有当ACK=1时,确认号才有效,TCP规定,在建立连接后的所有传送的TCP报文段的ACK都必须置1
数据偏移
占4比特,并以4字节为单位。
用来指出TCP报文段的数据载荷部分的起始处距离TCP报文段的起始处有多远。 这个字段实际上是指出了TCP报文段的首部长度。
首部固定长度为20字节,因此数据偏移字段的最小值为 首部最大长度为60字节,因此数据偏移字段的最大值为
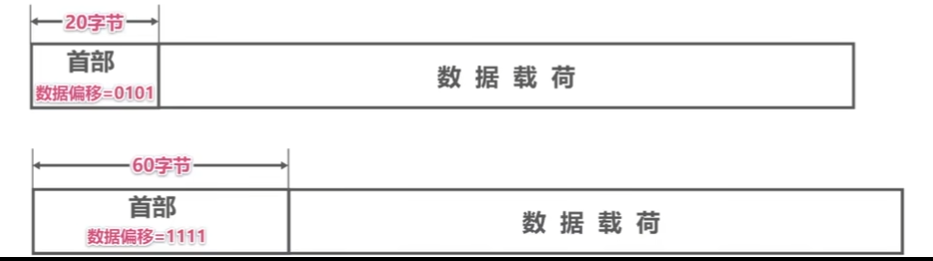
保留字段
6bit,保留给以后使用,目前没用,置为0
窗口
占16比特,以字节为单位。
指出发送本报文段的一方的窗口大小。
窗口值作为接收方让发送方设置其发送窗口的依据。 这是以接收方的接收能力来控制发送方的发送能力,称为流量控制。
校验和
占16bit,用于检验IP数据报在传输过程中有无误码。
同步标志位SYN
在TCP建立连接时用来同步序号
同步序号概念
SYN只是一个flag,当收到SYN=1时,就知道这个数据报中所携带的序号是初始序号
终止标志位FIN
用于释放TCP连接
复位标志位RST
用来复位TCP连接。
当RST=1时,表明TCP连接出现了异常,必须释放连接,然后再重新建立连接。
RST置1还用来拒绝一个非法的报文段或拒绝打开一个TCP连接。
推送标志位PSH
接收方的TCP收到该PSH=1时会尽快上交应用进程,不必等到接收缓存满了再上交
紧急标志位URG和紧急指针
紧急标志位URG:取值为1时紧急指针字段有效;取值为0时紧急指针字段无效。
紧急指针:占16比特,以字节为单位,用来指明紧急数据的长度。
当发送方有紧急数据时,可将紧急数据插队到发送缓存的最前面,并立刻封装到一个TCP报文段中进行发送。紧急指针会指出本报文段数据载荷部分包含了多长的紧急数据,紧急数据之后是普通数据。
接收方接收到URG=1的TCP报文时,会根据紧急指针取出紧急数据,并尽快上交应用层
选项
最大报文段长度MSS选项:TCP报文段数据载荷部分的最大长度。
窗口扩大选项:为了扩大窗口(提高吞吐率)。
时间戳选项:
用来计算往返时间RTT
用于处理序号超范围的情况,又称为防止序号绕回PAWS。
选择确认选项
填充
由于选项的长度可变,因此使用填充来确保报文段首部能被4整除(因为数据偏移字段,也就是首部长度字段,是以4字节为单位的)。
六、应用层
1.应用层概述
应用层是计算机网络体系结构的最顶层,是设计和建立计算机网络的最终目的,也是计算机网络中发展最快的部分。
- 早期基于文本的应用(电子邮件、远程登录、文件传输、新闻组)
- 20 世纪 90 年代将因特网带入千家万户的万维网 WWW
- 当今流行的即时通信、P2P 文件共享及各种音视频应用
- 计算设备的小型化和 “无处不在”,宽带住宅接入和无线接入的日益普及和迅速发展,为未来更多的新型应用提供了广阔的舞台。
2.客户 — 服务器方式(C/S)和对等方式(P2P)
网络应用程序运行在处于网络边缘的不同的端系统上,通过彼此间的通信来共同完成某项任务。
开发一种新的网络应用首先要考虑的问题就是网络应用程序在各种端系统上的组织方式和它们之间的关系。目前流行的主要有以下两种:
- 客户 / 服务器(Client/Server,C/S)方式
- 对等(Peer-to-Peer,P2P)方式
客户 — 服务器(C/S)方式
示意图
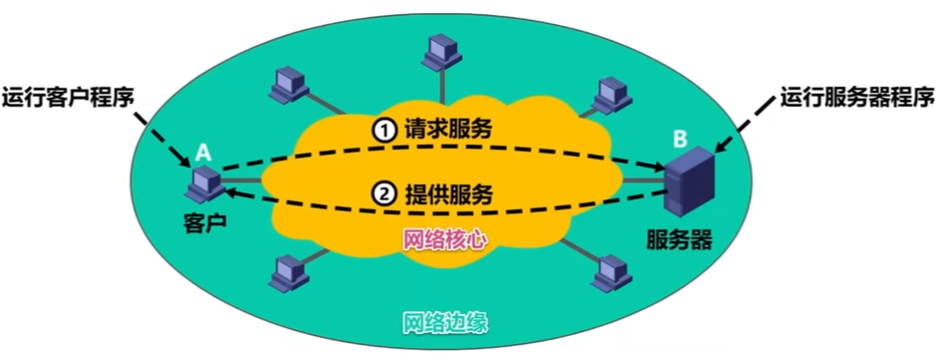
客户 / 服务器(Client/Server,C/S)方式
- 客户和服务器是指通信中所涉及的两个应用进程。
- 客户 / 服务器方式所描述的是进程之间服务和被服务的关系。
- 客户是服务请求方,服务器是服务提供方。
- 服务器总是处于运行状态,并等待客户的服务请求。服务器具有固定端口号(例如 HTTP 服务器的默认端口号为 80),而运行服务器的主机也具有固定的 IP 地址。
C/S 方式是因特网上传统的、同时也是最成熟的方式,很多我们熟悉的网络应用采用的都是 C/S 方式。包括万维网 WWW、电子邮件、文件传输 FTP 等。
基于 C/S 方式的应用服务通常是服务集中型的,即应用服务集中在网络中比客户计算机少得多的服务器计算机上。
- 由于一台服务器计算机要为多个客户机提供服务,在 C/S 应用中,常会出现服务器计算机跟不上众多客户机请求的情况。
- 为此,在 C/S 应用中,常用计算机群集(或服务器场)构建一个强大的虚拟服务器。
对等(P2P)方式
示意图
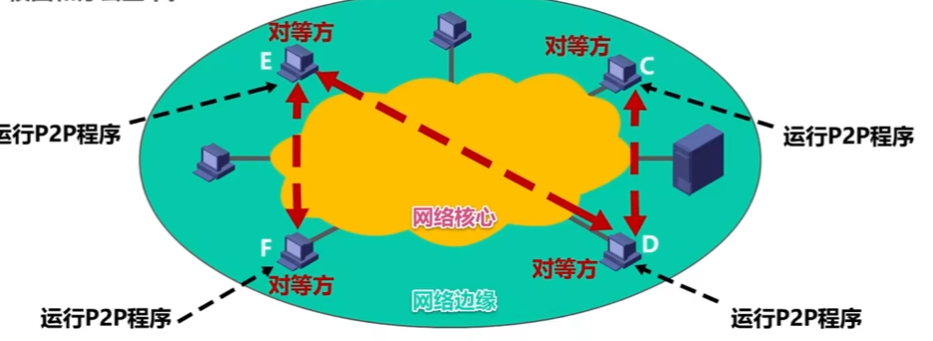
对等(Peer-to-Peer,P2P)方式
- 在 P2P 方式中,没有固定的服务请求者和服务提供者,分布在网络边缘各端系统中的应用进程是对等的,被称为对立方。对立方相互之间直接通信,每个对立方既是服务的请求者,又是服务的提供者。
目前,在因特网上流行的 P2P 应用主要包括 P2P 文件共享、即时通信、P2P 流媒体、分布式存储等。
基于 P2P 的应用是服务分散型的,因为服务不是集中在少数几个服务器计算机中,而是分散在大量对等计算机中,这些计算机并不为服务提供商所有,而是为个人控制的桌面计算机和笔记本电脑,它们通常位于住宅、校园和办公室中。
P2P 方式的最突出特性之一就是它的可扩展性。因为系统每增加一个对等方,不仅增加的是服务的请求者,同时也增加了服务的提供者,系统性能不会因规模的增大而降低。
P2P 方式具有成本上的优势,因为它通常不需要庞大的服务器设施和服务器带宽。为了降低成本,服务提供商对于将 P2P 方式用于应用的兴趣越来越大。
P2P应用
迅雷(P2P 加速),下载的用户越多,参与上传的节点就越多,整体下载速度反而越快
3.动态主机配置协议DHCP
DHCP的作用
示意图
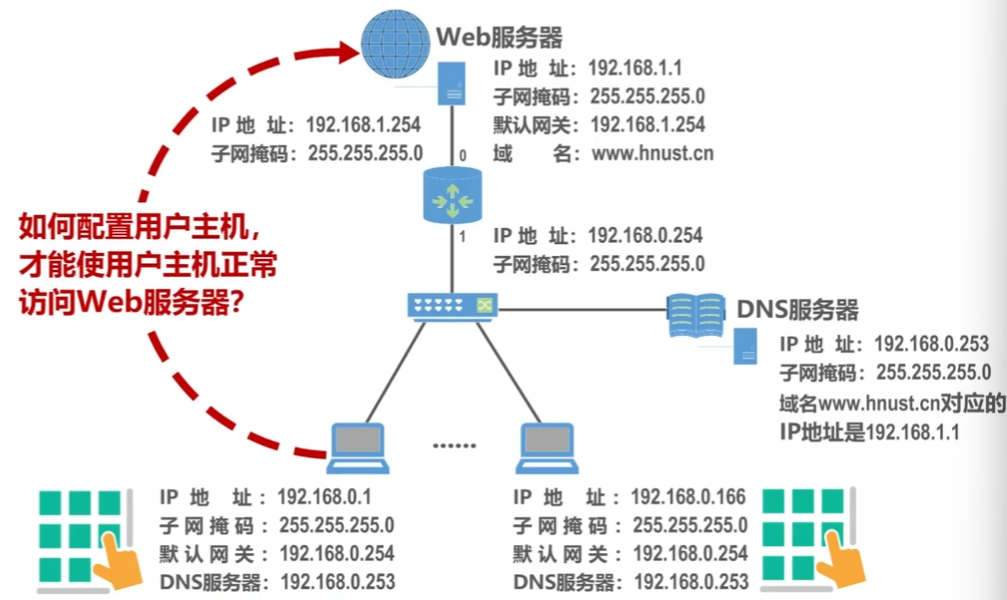
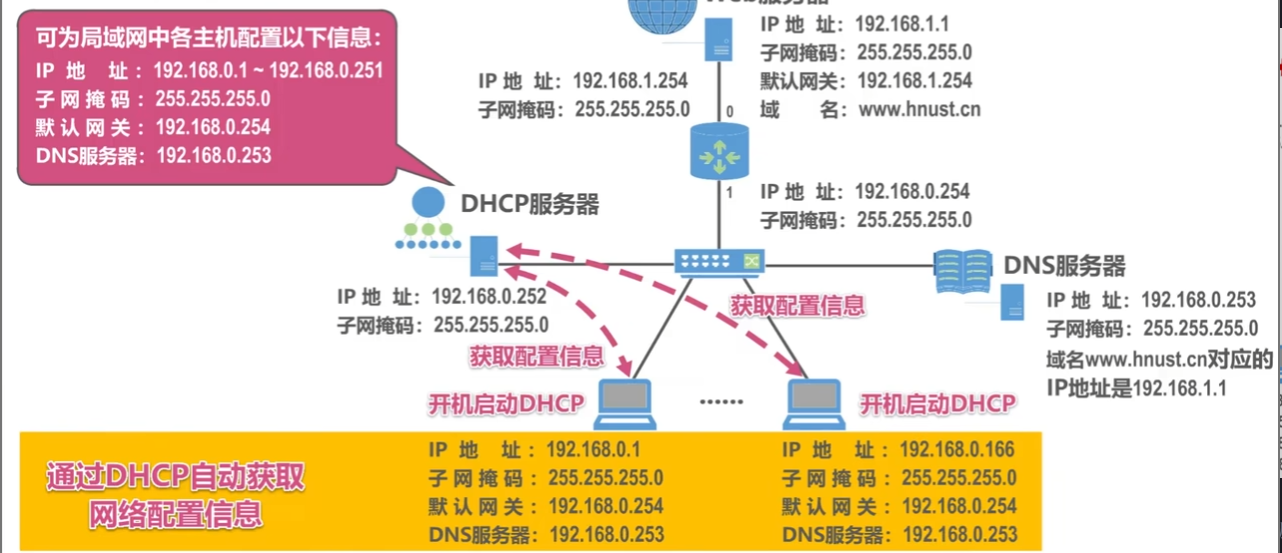
用户主机需要配置相应的IP地址、子网掩码、默认网关、DNS服务器 才可正常上网,当同一个网段下主机较多时,如果都采用手动配置,IP地址容易发生冲突 所以使用DHCP对上述内容进行自动配置
DHCP工作过程
注意:DHCP服务由运输层中的UDP提供,DHCP服务器端口号UDP67 用户DHCP服务端口号UDP68
用户主机将广播发送DHCP发现报文
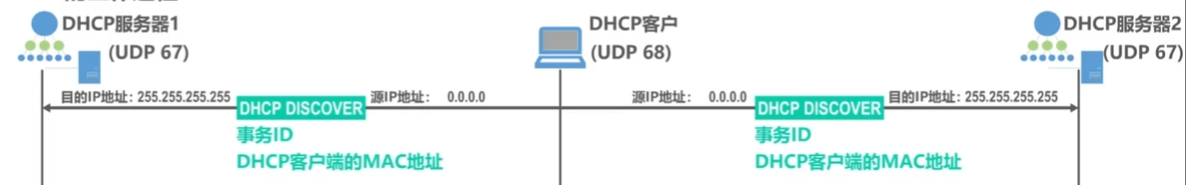
- 源IP地址为:0.0.0.0 原因:DHCP客户还未配置IP地址,用这个代替
- 以广播的形式发送(目的地址:255.255.255.255),在同一广播域中的其他客户主机接收到后,由于UDP67窗口并未运行DHCP服务器程序所以会将其丢弃; 而DHCP服务器接收到后会对其进行解析并作出回应
- DHCP发现报文中存有事务ID、客户端MAC地址
DHCP服务器作出回应
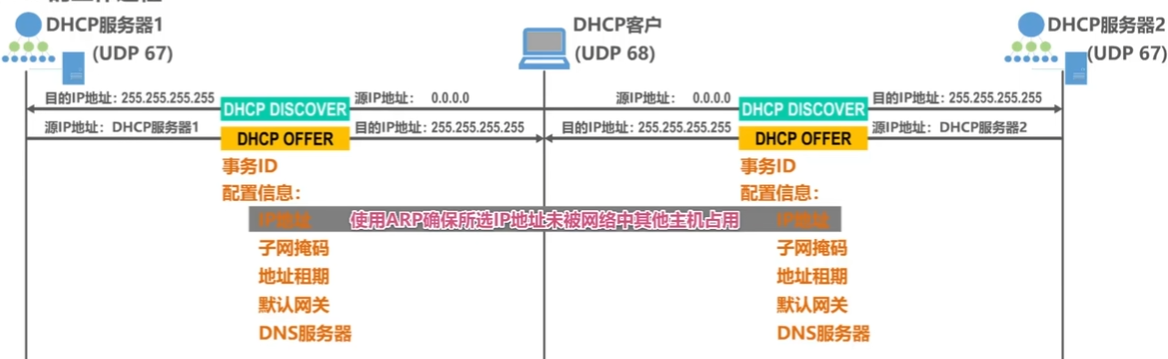
DHCP服务器接收到发现报文后会为其分配相关的配置信息并发送回去,同一广播域中的DHCP服务器接收到后没有68端口的DHCP客户进程将其丢弃;客户机接收到后会将事务ID和自己发送出去的事务ID进行对比,若不一样则丢弃,一样则接收
当客户端收到DHCP OFFER后,会进行ARP探测以确保这个IP地址未被占用,即:以0.0.0.0作为源地址广播发送DHCP OFFER中所分配的IP地址,若与某主机的IP地址相同,这个主机就会发回ARP响应。若被占用:给 DHCP 服务器发送 “DHCP DECLINE” 报文撤销 IP 地址租约,并重新发送 “DHCP DISCOVER” 报文
用户主机发送DHCP请求
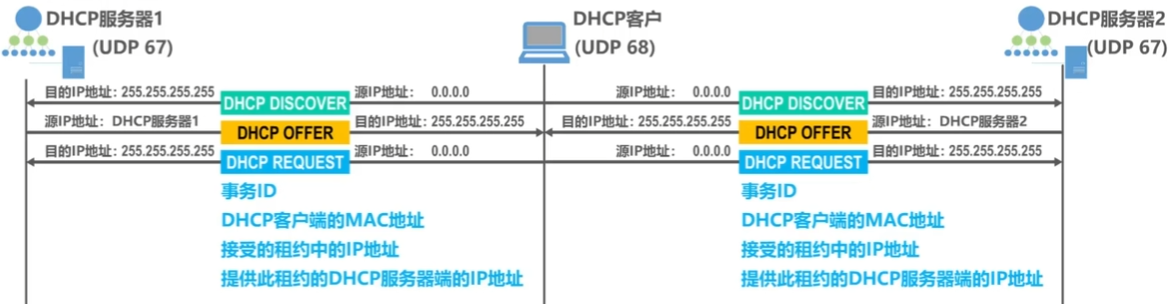
用户主机收到DHCP OFFER后(一般选择先到的那个),广播发送发送DHCP请求报文,其中包括事务ID、DHCP客户端的MAC地址、租约中的IP地址、提供租约的DHCP服务器IP地址
在这一步中DHCP客户还会使用ARP探测,探测IP有无被占用 详见第二步第二小点
DHCP服务器发送DHCP确认报文
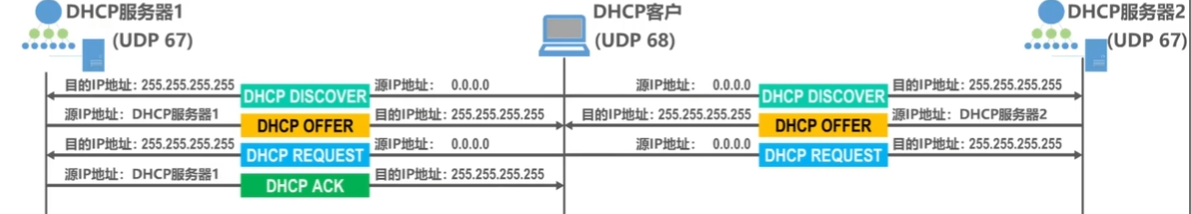
- 依旧以广播形式发送,DHCP客户端用事务ID确认。当客户端收到DHCP ACK后就可以使用该IP了
“续租”
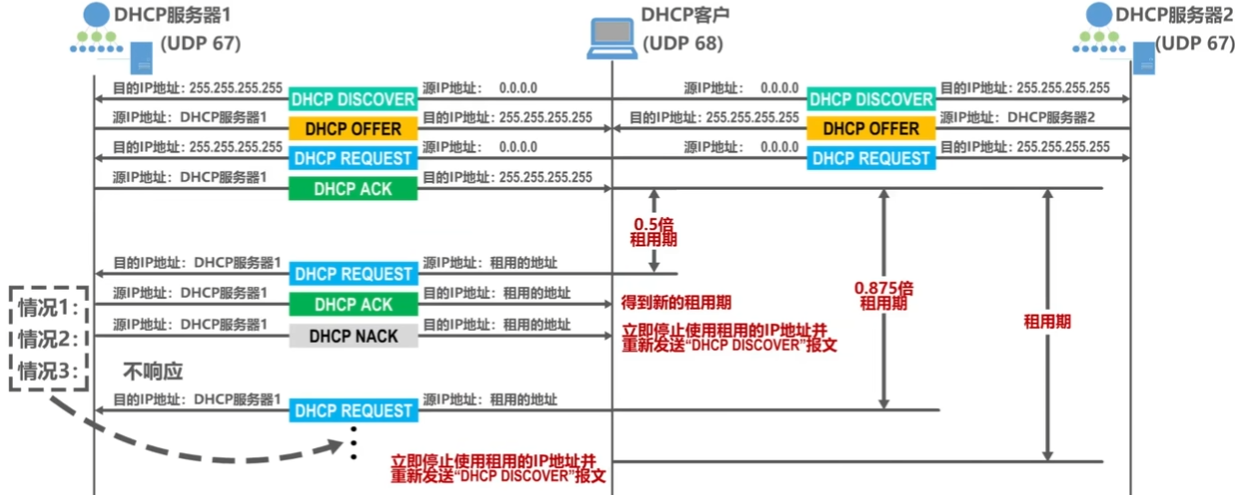
租用期过半时会重新发送DHCP请求报文请求续租,分三种情况
DHCP服务器同意:更新租用期
DHCP服务器不同意:立即停止使用
DHCP服务器未响应:在0.875倍租用期时再次发送DHCP请求报文
tip:过了租用期必须立即停止使用
“停租”
DHCP客户端可随时停租,只需向DHCP服务器发送DHCP释放报文即可
DHCP中继代理
示意图
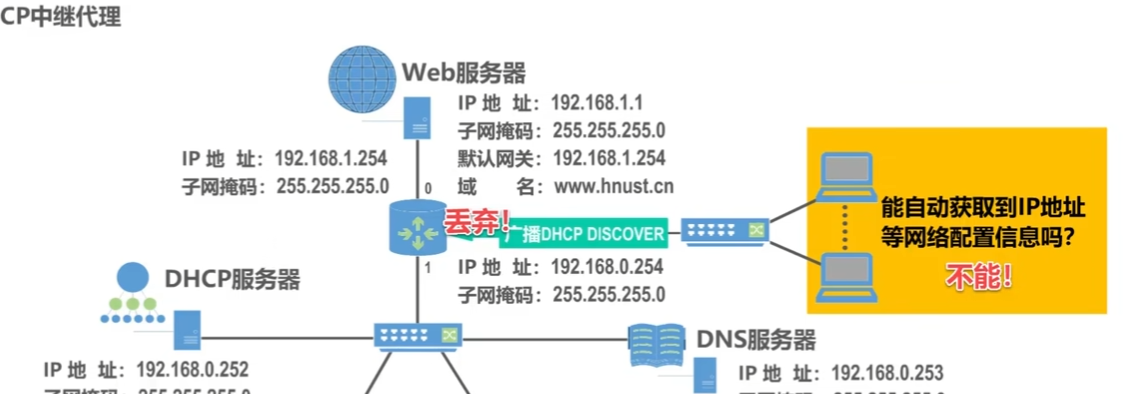
如图所示该网段和DHCP服务器不在同一广播域无法发送DHCP发现报文给DHCP服务器
解决方法
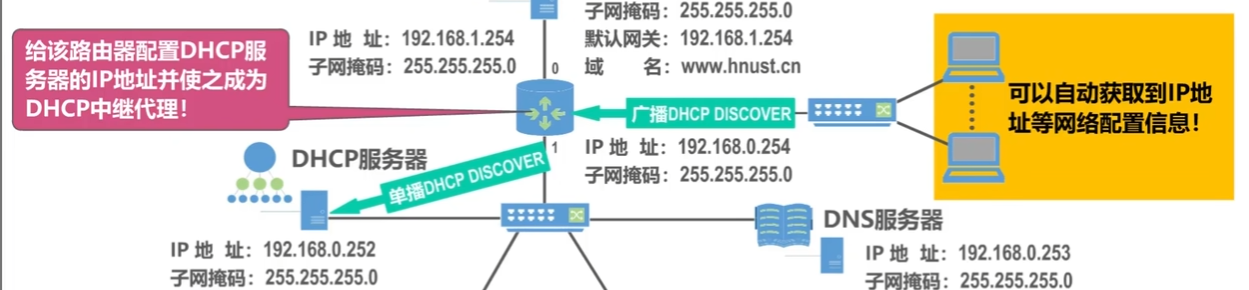
为路由器配置DHCP服务器IP地址使其称为DHCP中继代理,单播转发DHCP配置过程中的报文
4.域名系统DNS(Domain Name System)
DNS作用
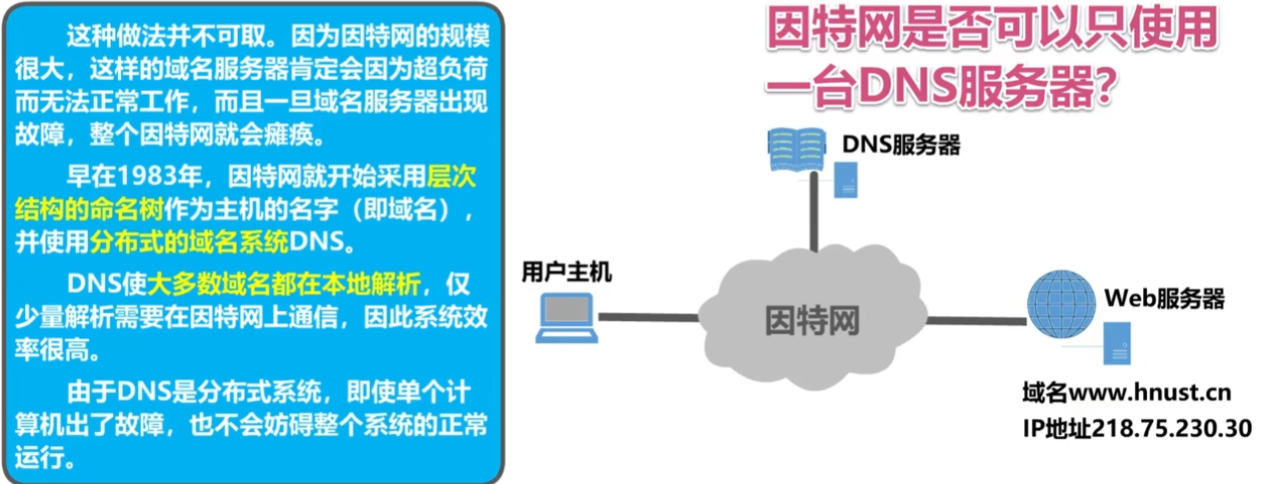
DNS服务器中有着域名与IP地址对应的数据库
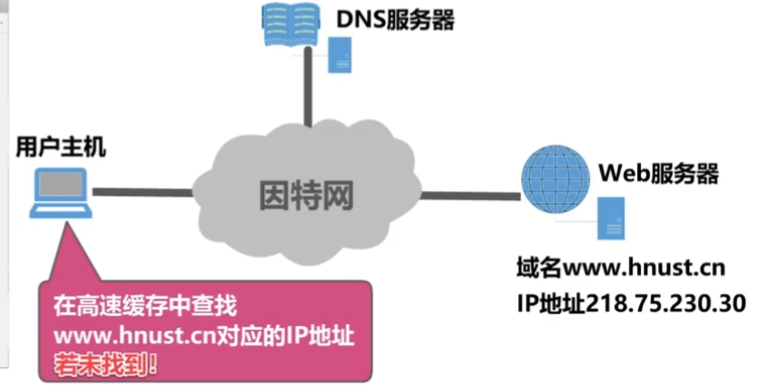
当主机访问某一域名时,会先在高速缓存中查找该域名对应的IP地址,若找不到,会向DNS服务器发送请求,由DNS服务器查找并返回IP地址
DNS报文以UDP封装,运输层端口为53

树状域名结构
因特网采用层次树状结构的域名结构。
示意图
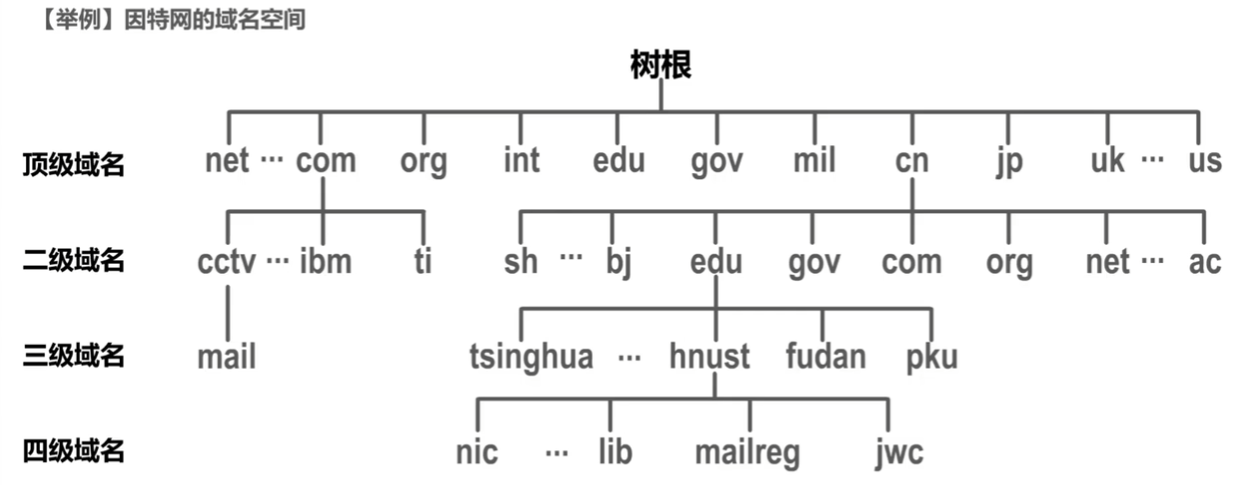
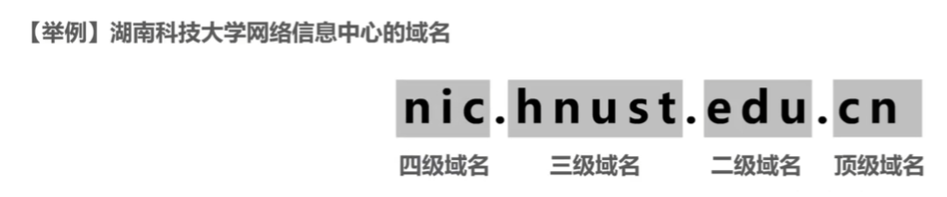
域名的结构由若干个分量组成,各分量之间用 “点” 隔开,分别代表不同级别的域名:
… .三级域名.二级域名.顶级域名
- 每一级的域名都由英文字母和数字组成,不超过 63 个字符,不区分大小写字母。
- 级别最低的域名写在最左边,而级别最高的顶级域名写在最右边。
- 完整的域名不超过 255 个字符。
域名系统既不规定一个域名需要包含多少个下级域名,也不规定每一级的域名代表什么意思。
各级域名由其上一级的域名管理机构管理,而最高的顶级域名则由因特网名称与数字地址分配机构 ICANN 进行管理。
示例
顶级域名 TLD(Top Level Domain)分为以下三类:
- 国家顶级域名 nTLD:采用 ISO 3166 的规定。如
cn表示中国,us表示美国,uk表示英国,等等。- 通用顶级域名 gTLD:最常见的通用顶级域名有七个,即:
com(公司企业)、net(网络服务机构)、org(非营利性组织)、int(国际组织)、edu(美国教育机构)、gov(美国政府部门)、mil(美国军事部门)。- 反向域 arpa:用于反向域名解析,即 IP 地址反向解析为域名。
在国家顶级域名下注册的二级域名均由该国家自行确定。例如,顶级域名为
jp的日本,将其教育和企业机构的二级域名定为ac和co,而不用edu和com。我国则将二级域名划分为以下两类:
- 类别域名:共七个:
ac(科研机构)、com(工、商、金融等企业)、edu(教育机构)、gov(政府部门)、net(提供网络服务的机构)、mil(军事机构)和org(非营利性组织)。- 行政区域名:共 34 个,适用于我国的各省、自治区、直辖市。例如:
bj为北京市、sh为上海市、js为江苏省,等等。域名服务器
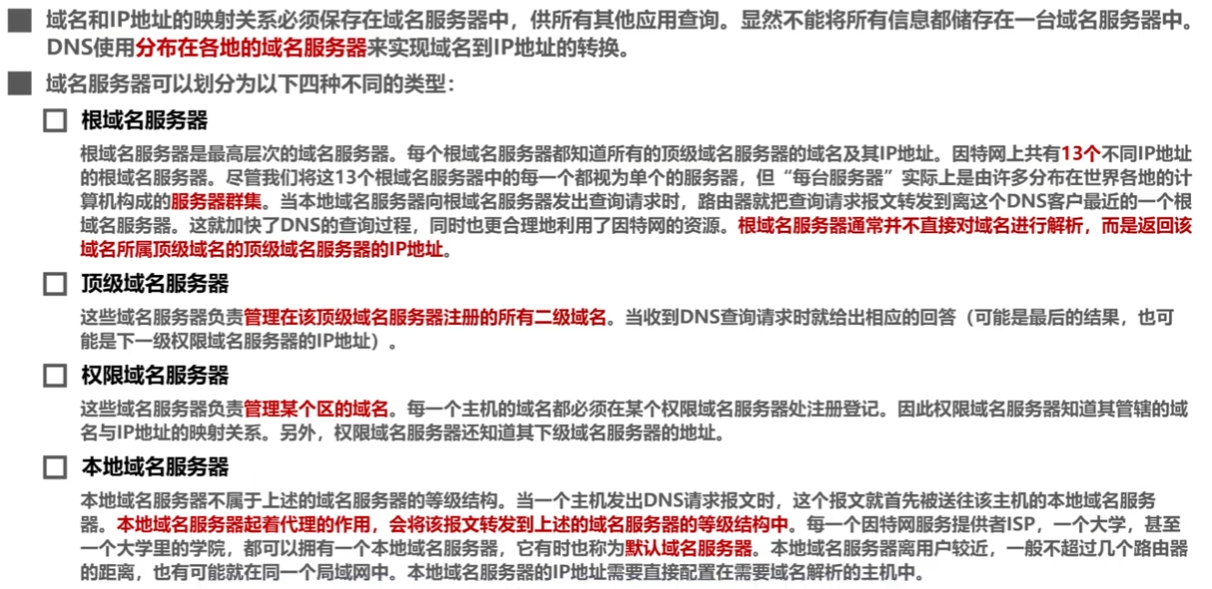
域名解析过程
两种查询方式
递归查询
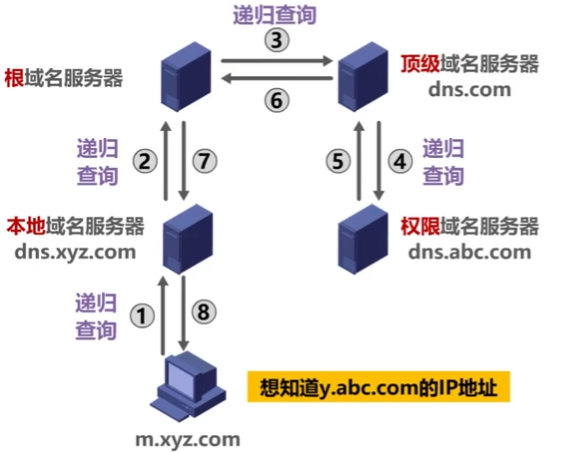
迭代查询
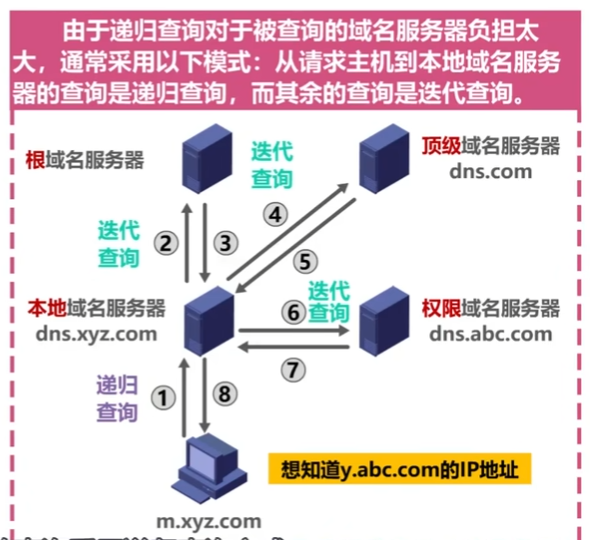
本地高速缓存
为了提高DNS的查询效率,并减轻根域名服务器的负荷和减少因特网上的DNS查询报文数量,在域名服务器中广泛地使用了高速缓存。高速缓存用来存放最近查询过的域名以及从何处获得域名映射信息的记录。
示意图
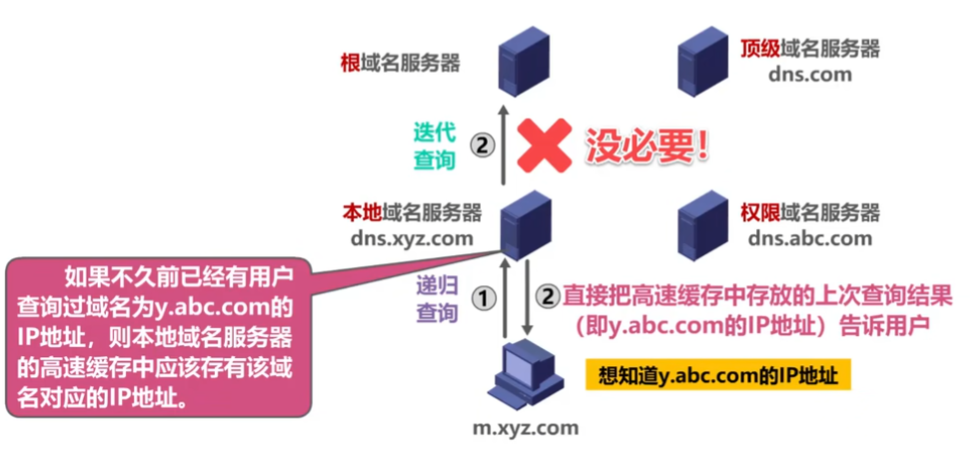
由于域名到IP地址的映射关系并不是永久不变,为保持高速缓存中的内容正确,域名服务器应为每项内容设置计时器并删除超过合理时间的项(例如,每个项目只存放两天)。
不但在本地域名服务器中需要高速缓存,在用户主机中也很需要。许多用户主机在启动时从本地域名服务器下载域名和IP地址的全部数据库,维护存放自己最近使用的域名的高速缓存,并且只在从缓存中找不到域名时才向域名服务器查询。同理,主机也需要保持高速缓存中内容的正确性。
DNS习题
习题1
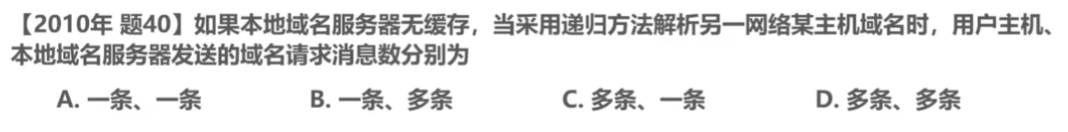
A
习题2
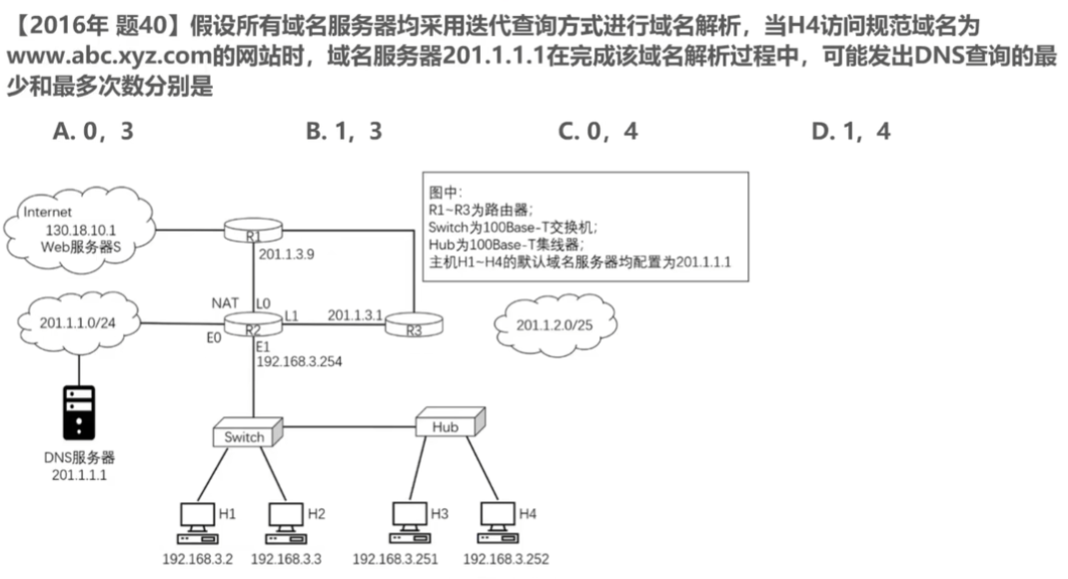
C
最少为0次,即:本地高速缓存中存有域名与IP地址对应关系
最多为4次,即:
步骤 查询对象 目的 查询次数 1 根域名服务器 问: .com顶级域名服务器的地址1 次 2 .com顶级域名服务器问: xyz.com二级域名的权限服务器地址1 次 3 xyz.com的权限域名服务器问: abc.xyz.com三级域名的权限服务器地址1 次 4 abc.xyz.com的权限域名服务器问: abc.xyz.com对应的 IP 地址1 次
5.文件传送协议FTP
简介
将某台计算机中的文件通过网络传送到可能相距很远的另一台计算机中,是一项基本的网络应用,即文件传送。
文件传送协议 FTP(File Transfer Protocol)是因特网上使用得最广泛的文件传送协议。
- FTP提供交互式的访问,允许客户指明文件的类型与格式(如指明是否使用 ASCII 码),并允许文件具有存取权限(如访问文件的用户必须经过授权,并输入有效的口令)。
- FTP 屏蔽了各计算机系统的细节,因而适合于在异构网络中任意计算机之间传送文件。
在因特网发展的早期阶段,用 FTP 传送文件约占整个因特网的通信量的三分之一,而由电子邮件和域名系统所产生的通信量还要小于 FTP 所产生的通信量。只是到了 1995 年,万维网 WWW 的通信量才首次超过了 FTP。
工作原理
FTP采取[客户—服务器方式](#客户 — 服务器(C/S)方式),FTP用户可以上传文件至FTP服务器,也可以从FTP服务器下载文件
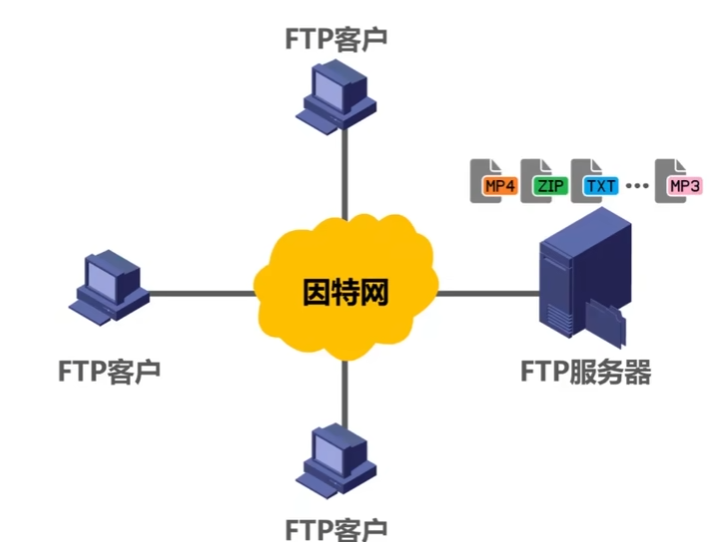
工作原理剖析
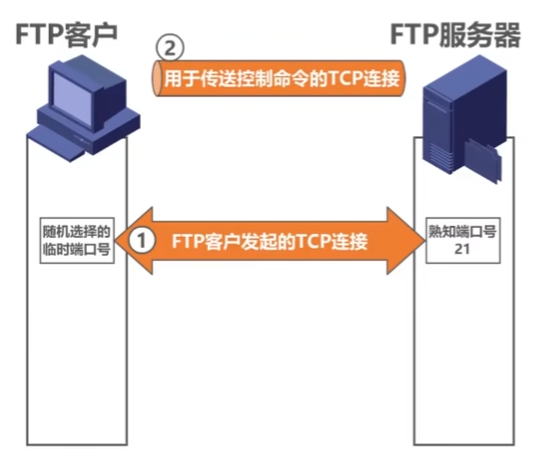
FTP服务器的进程工作于熟知的端口号21,FTP客户随机选取一个临时端口号与其建立TCP连接,这条TCP连接用于FTP服务器与用户之间传送FTP相关控制命令,而就是说这条TCP连接是命令通道,并不传输数据
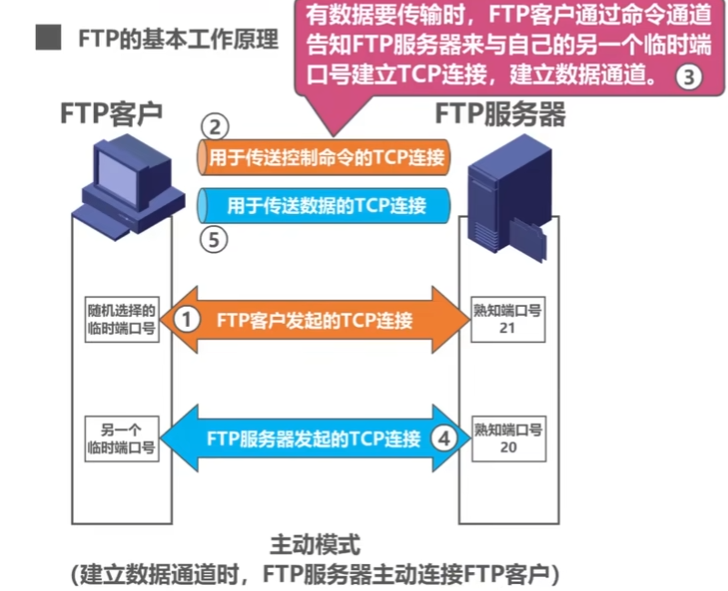
有数据要传输时,FTP客户会用命令通道告知服务器,让服务器的20端口与自己的另一个临时端口建立连接用以传输数据,在建立数据通道时,是FTP服务器主动连接FTP客户,因此称为主动模式
有数据传输时,FTP客户也可以通过命令通道告知服务器,让服务器开启某个临时端口等待客户的TCP连接,这种模式被称为被动模式
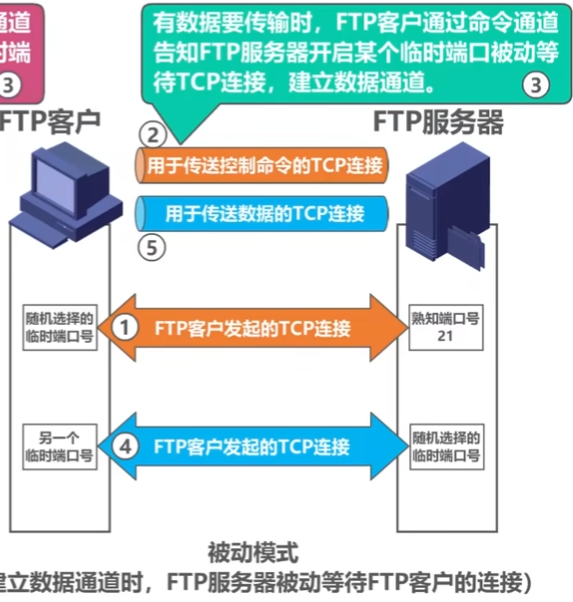
注意:命令通道在整个会话期间内都开启,数据通道只有在传输数据的时候开启,数据传输完后关闭
FTP习题
习题1
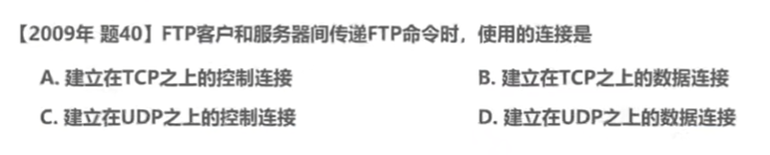
A
习题2
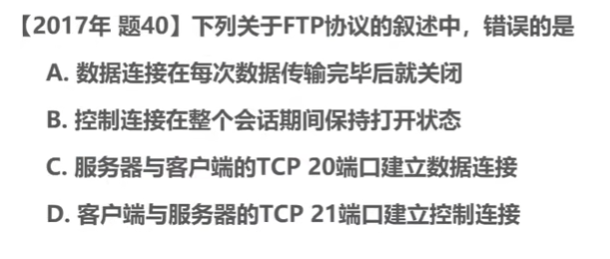
C 应为:客户端与服务器的TCP20端口建立数据连接
6.电子邮件
简述
电子邮件采用[客户—服务器方式](#客户 — 服务器(C/S)方式)
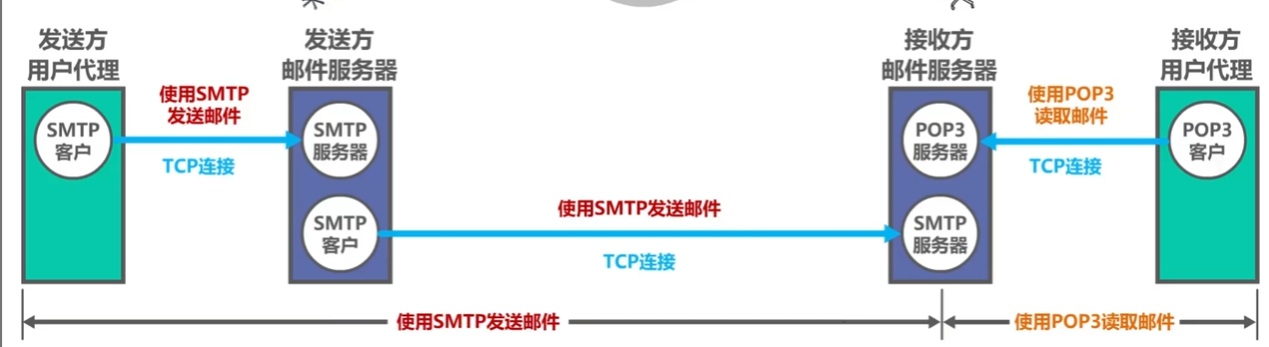
电子邮件系统由三个主要组成构建:用户代理、邮件服务器、电子邮件所需协议
用户代理:用户与电子邮件系统的接口,又称为电子邮件客户端软件
邮件服务器:电子邮件系统的基础设施。因特网上所有的ISP都有邮件服务器,其功能是发送和接收邮件,同时还要负责维护用户的邮箱。
协议:协议包括邮件发送协议(例如SMTP)和邮件读取协议(如:POP3,IMAP)
示意图
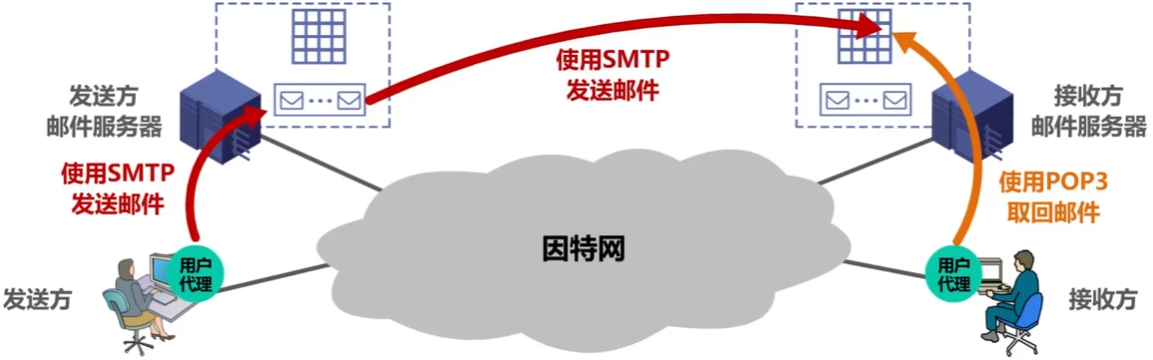
工作原理
发送方客户代理 –> 发送方邮件服务器 –> 接收方邮件服务器 –> 接收方用户代理
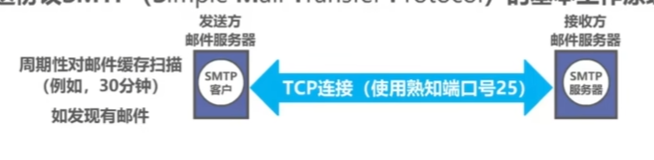
简单邮件传送协议SMTP (Simple Mail Transfer Protocol)基本工作原理
发送方邮件服务器周期性地扫描邮件缓存,若发现有未发送的邮件,则发送方邮件服务器中的SMTP客户会与接收方的SMTP服务器建立TCP连接(熟知端口号25)
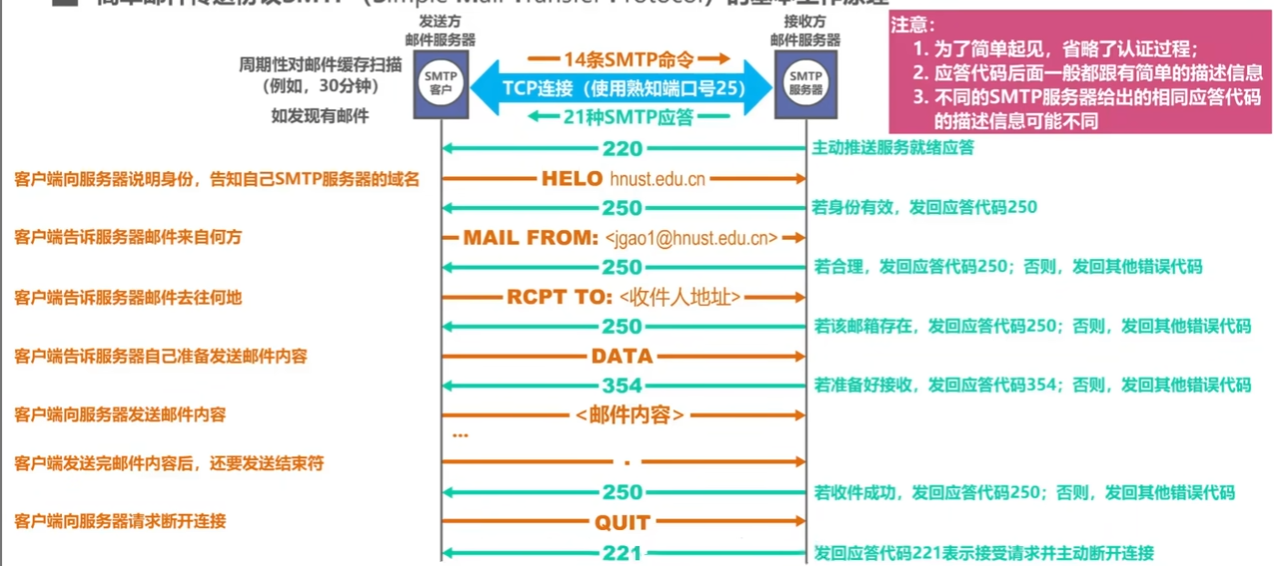
建立连接后SMTP客户就可以基于这条命令通道给SMTP服务器发送SMTP命令,SMTP服务器也会给予相应的应答
常用的两个邮件读取协议
邮局协议 POP(Post Office Protocol),POP3 是其第三个版本,是因特网正式标准。
- 非常简单、功能有限的邮件读取协议。用户只能以下载并删除方式或下载并保留方式从邮件服务器下载邮件到用户方计算机。不允许用户在邮件服务器上管理自己的邮件。(例如创建文件夹,对邮件进行分类管理等)。
因特网邮件访问协议 IMAP(Internet Message Access Protocol),IMAP4 是其第四个版本,目前还只是因特网建议标准。
- 功能比 POP3 强大的邮件读取协议。用户在自己的计算机上就可以操控邮件服务器中的邮箱,就像在本地操控一样,因此 IMAP 是一个联机协议。
POP3 和 IMAP4 都采用基于 TCP 连接的客户 / 服务器方式。POP3 使用熟知端口 110,IMAP4 使用熟知端口 143。
电子邮件格式
电子邮件的信息格式并不是由SMTP定义的,而是在RFC 822中单独定义的。这个RFC文档已在2008年更新为RFC 5322。一个电子邮件有信封和内容两部分。而内容又由首部和主体两部分构成。
示意图
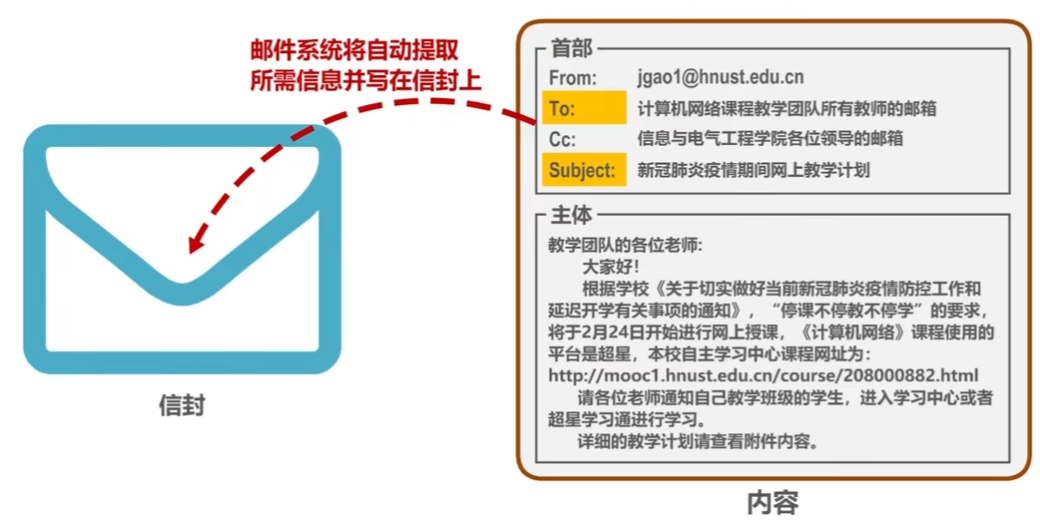
SMTP协议只能传送ASCII码文本数据,不能传送可执行文件或其他的二进制对象。
SMTP不能满足传送多媒体邮件(例如带有图片、音频或视频数据)的需要。并且许多其他非英语国家的文字(例如中文、俄文、甚至带有重音符号的法文或德文)也无法用SMTP传送。
为解决SMTP传送非ASCII码文本的问题,提出了多用途因特网邮件扩展MIME(Multipurpose Internet Mail Extensions)
示意图
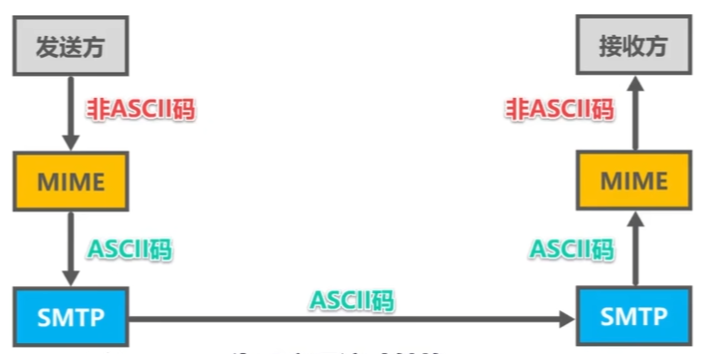
增加了5 个新的邮件首部字段,这些字段提供了有关邮件主体的信息。
定义了许多邮件内容的格式,对多媒体电子邮件的表示方法进行了标准化。
定义了传送编码,可对任何内容格式进行转换,而不会被邮件系统改变。
实际上,MIME不仅用于SMTP,也用于后来的同样面向ASCII字符的HTTP。
基于万维网的电子邮件
通过浏览器登录(提供用户名和口令)邮件服务器万维网网站就可以撰写、收发、阅读和管理电子邮件。这种工作模式与IMAP很类似,不同的是用户计算机无需安装专门的用户代理程序,只需要使用通用的万维网浏览器。
邮件服务器网站通常都提供非常强大和方便的邮件管理功能,用户可以在邮件服务器网站上管理和处理自己的邮件,而不需要将邮件下载到本地进行管理。
示意图
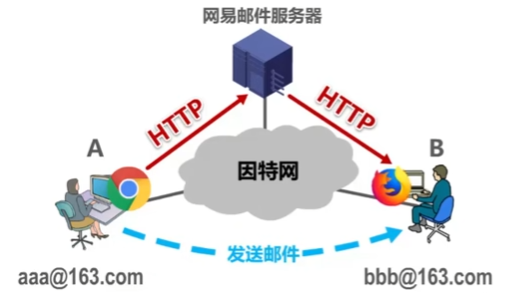

电子邮件习题
习题1
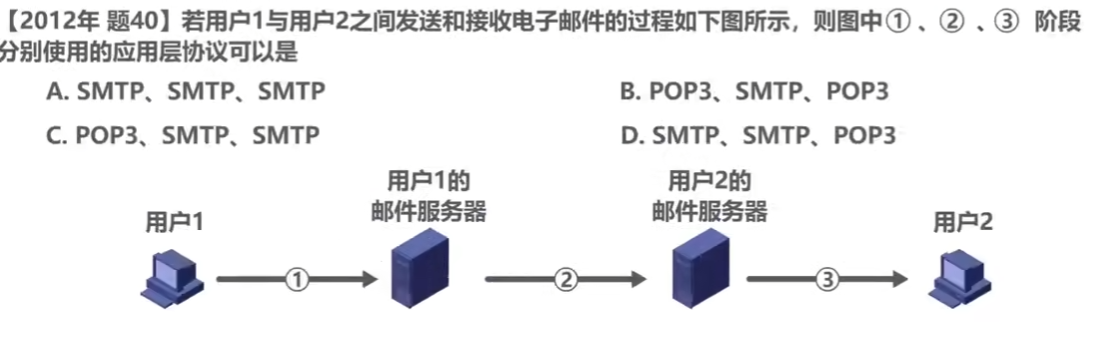
D
习题2
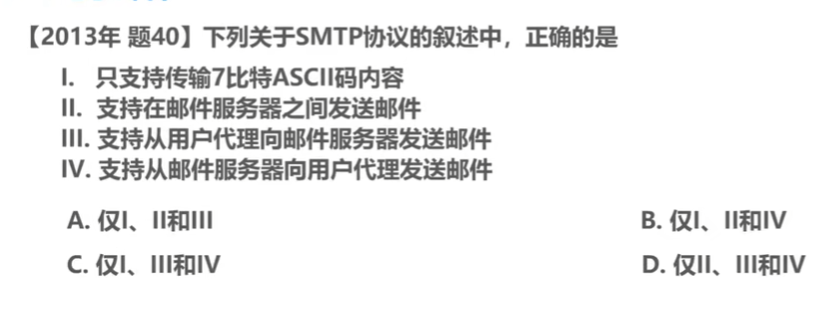
A 邮件服务器不能向用户代理发送邮件,只可用POP3协议接收
习题3
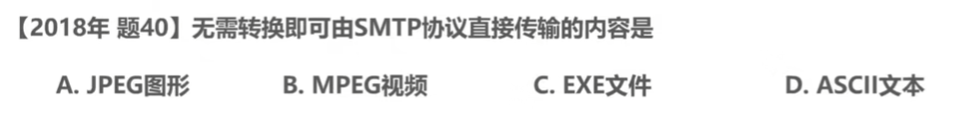
D
7.万维网WWW
简介
万维网WWW(World Wide Web)并非某种特殊的计算机网络。它是一个大规模的、联机式的信息储藏所,是运行在因特网上的一个分布式应用。
万维网利用网页之间的超链接将不同网站的网页链接成一张逻辑上的信息网。
浏览器最重要的部分是渲染引擎,也就是浏览器内核。负责对网页内容进行解析和显示。
- 不同的浏览器内核对网页内容的解析也有不同,因此同一网页在不同内核的浏览器里的显示效果可能不同;
- 网页编写者需要在不同内核的浏览器中测试网页显示效果。
万维网相关概念
URL
为了方便地访问在世界范围的文档,万维网使用统一资源定位符 URL来指明因特网上任何种类 “资源” 的位置。
URL 的一般形式由以下四个部分组成:
<协议>://<主机>:<端口>/<路径>
万维网文档
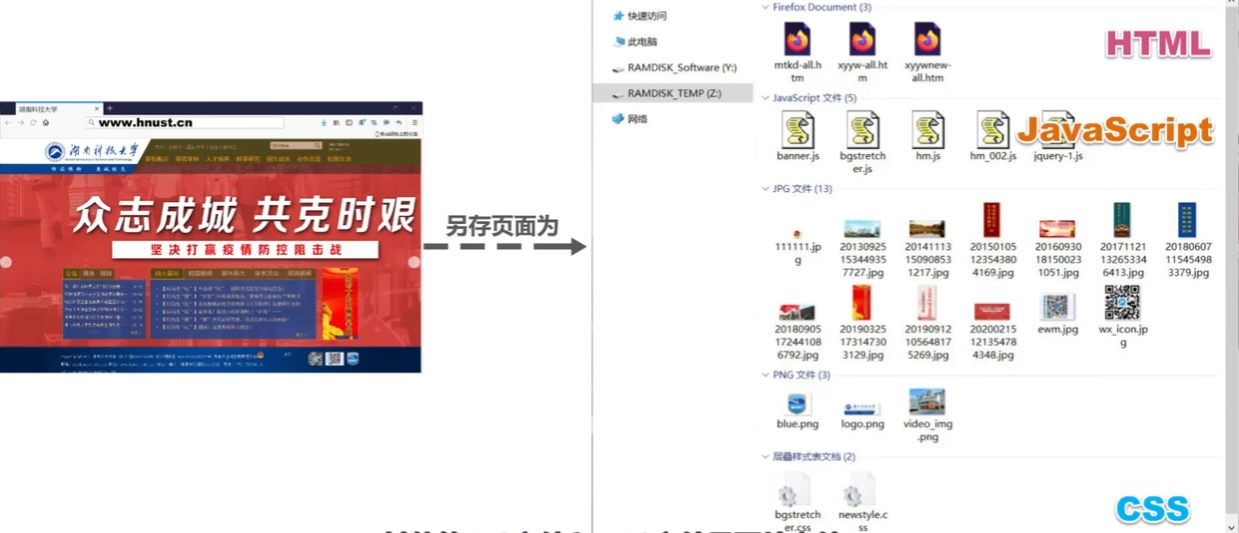
超文本标记语言 HTML(HyperText Markup Language)
使用多种 “标签” 来描述网页的结构和内容
示意图
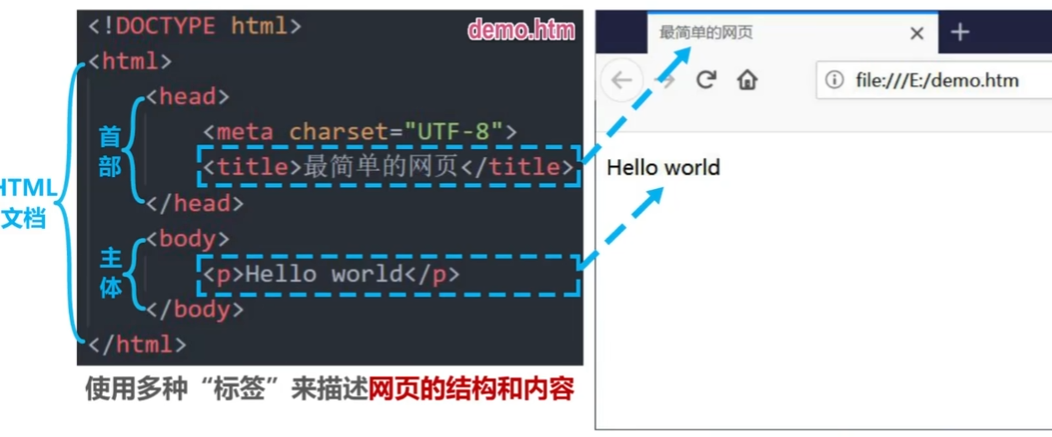
层叠样式表 CSS(Cascading Style Sheets)
从审美的角度来描述网页的样式
示意图
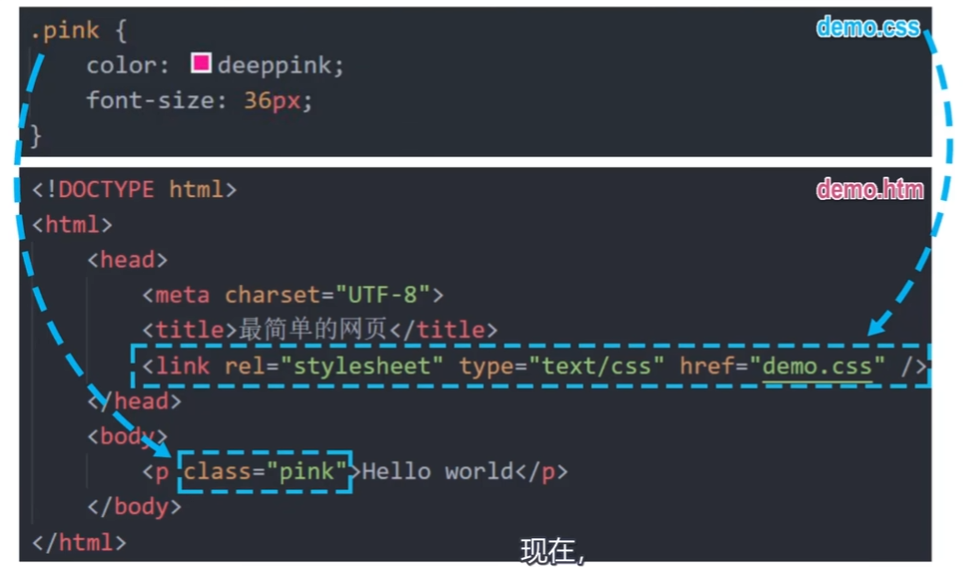
CSS文档中可以定义字体颜色、字体大小等
在HTML文档首部通过link引入CSS 在body中通过class=“xxx”使用CSS
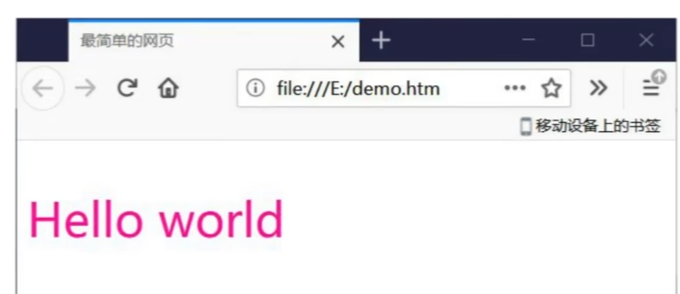
JavaScript一种脚本语言
控制网页的行为
示意图
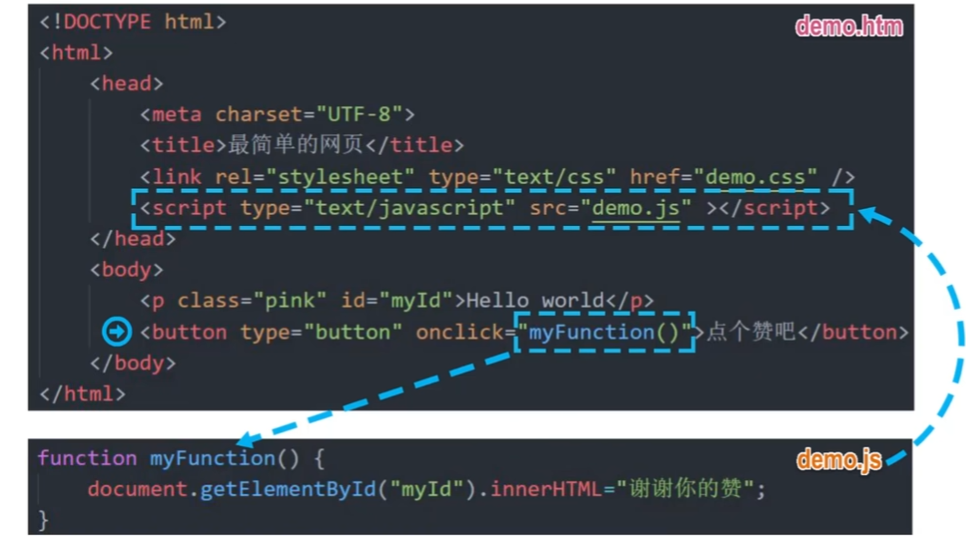
如图所示,在HTML文档中创建了一个按钮(button),若想要实现点击按钮后出现某一效果,就需要JavaScript脚本
首部中用标签引入脚本。
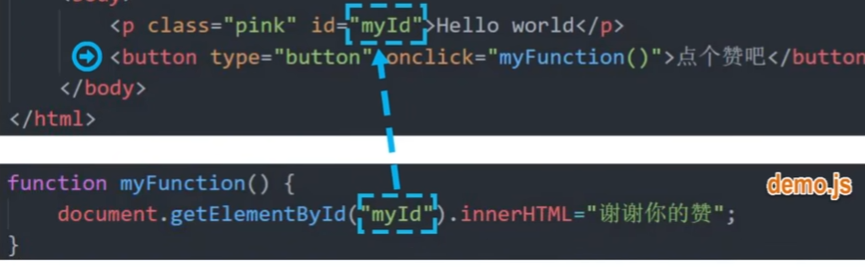
这段脚本的功能是:通过getElementById函数找到需要修改的内容的ID,并将其修改为“谢谢你的赞”
超文本传输协议HTTP(HyperText Transfer Protocol)
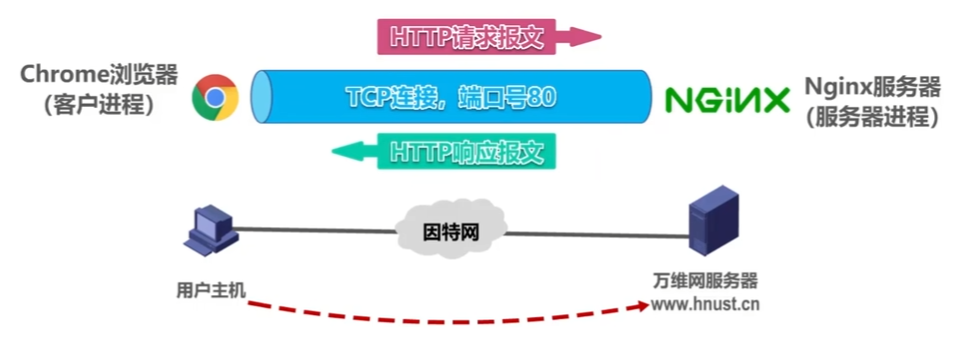
HTTP定义了浏览器(即万维网客户进程)怎样向万维网服务器请求万维网文档,以及万维网服务器怎样把万维网文档传送给浏览器。
工作原理示意图
HTTP的连接方式
HTTP/1.0 采用非持续连接方式。在该方式下,每次浏览器要请求一个文件都要与服务器建立 TCP 连接,当收到响应后就立即关闭连接。
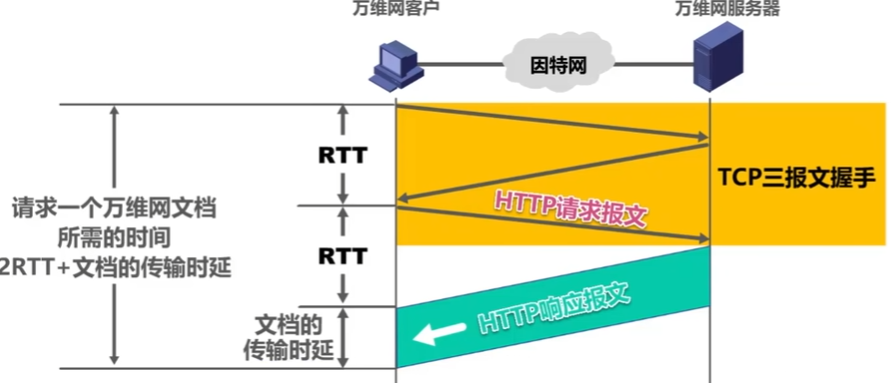
- 每请求一个文档就要有两倍的 RTT 的开销。若一个网页上有很多引用对象(例如图片等),那么请求每一个对象都需要花费 2RTT 的时间。
- 为了减小时延,浏览器通常会建立多个并行的 TCP 连接同时请求多个对象。但是,这会大量占用万维网服务器的资源,特别是万维网服务器往往要同时服务于大量客户的请求,这会使其负担很重。
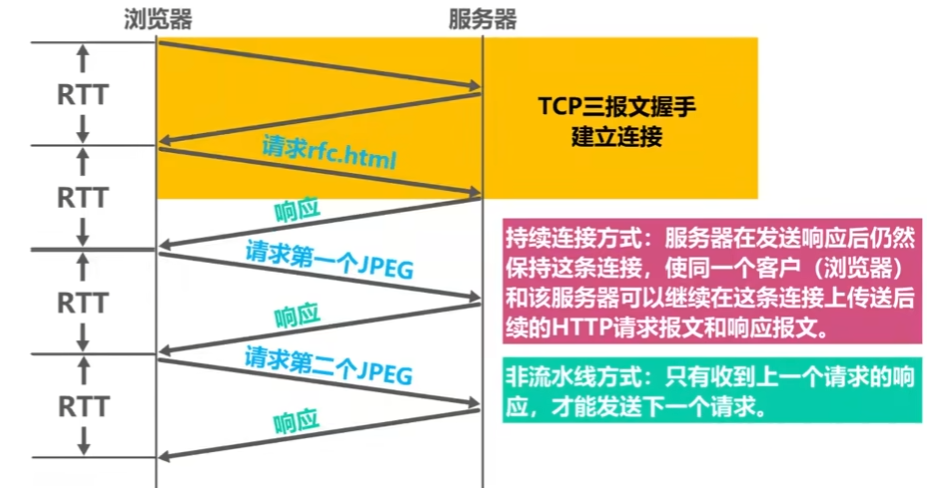
HTTP/1.1 采用持续连接方式。在该方式下,万维网服务器在发送响应后仍然保持这条连接,使同一个客户(浏览器)和该服务器可以继续在这条连接上传送后续的 HTTP 请求报文和响应报文。这并不局限于传送同一个页面上引用的对象,而是只要这些文档都在同一个服务器上就行。
- 为了进一步提高效率,HTTP/1.1 的持续连接还可以使用流水线方式工作,即浏览器在收到 HTTP 的响应报文之前就能够连续发送多个请求报文。这样的一个接一个的请求报文到达服务器后,服务器就发回一个接一个的响应报文。这样就节省了很多个 RTT 时间,使 TCP 连接中的空闲时间减少,提高了下载文档的效率。
HTTP报文格式
HTTP请求报文格式
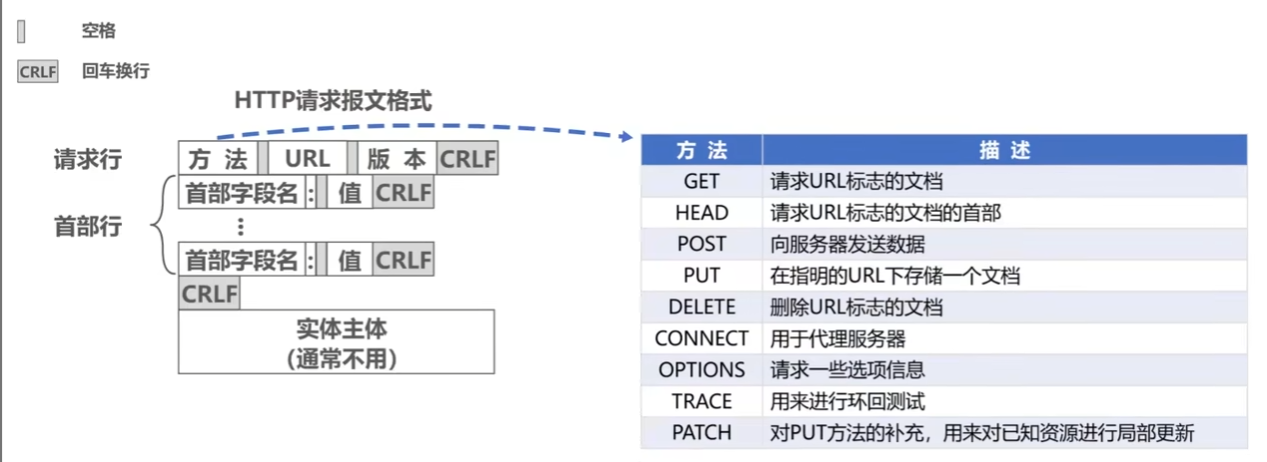
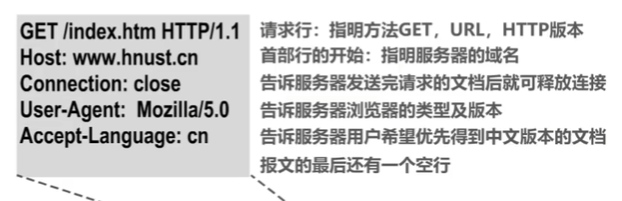
实例
HTTP响应报文格式
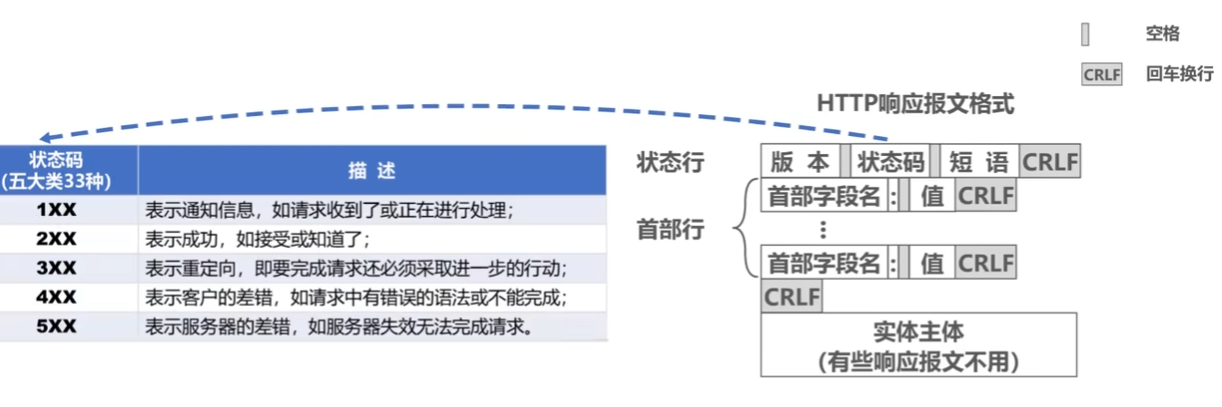
- 常见状态行
HTTP/1.1 202 Accepted:接受请求HTTP/1.1 400 Bad Request:错误的请求HTTP/1.1 404 Not Found:找不到页面
Cookie(记录用户信息)
早期的万维网应用非常简单,仅仅是用户查看存放在不同服务器上的各种静态的文档。因此 HTTP 被设计为一种无状态的协议。这样可以简化服务器的设计。
现在,用户可以通过万维网实现各种复杂的应用,如网上购物、电子商务等。这些应用往往需要万维网服务器能够识别用户。
Cookie 提供了一种机制使得万维网服务器能够 “记住” 用户,而无需用户主动提供用户标识信息。也就是说,Cookie 是一种对无状态的 HTTP 进行状态化的技术。
示意
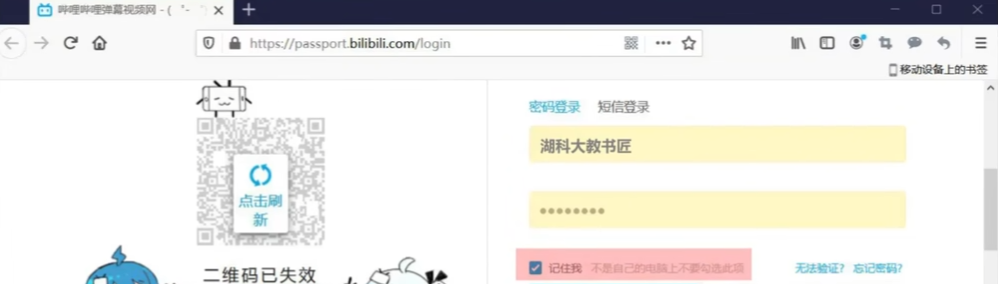
bilibili登陆选项中的“记住我”
Cookie工作原理
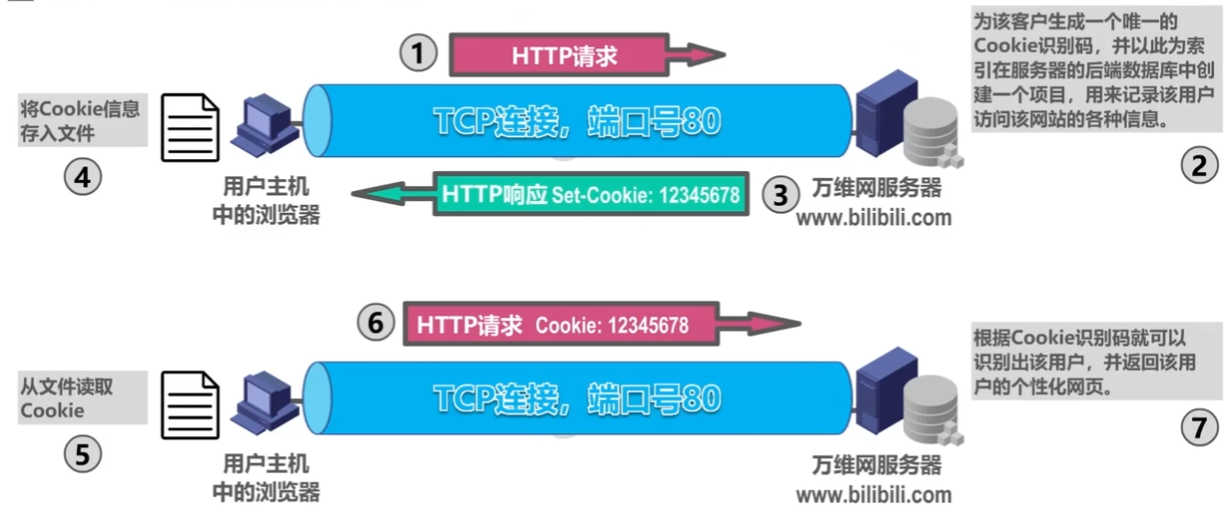
步骤①:首次发送 HTTP 请求
用户主机中的浏览器,向万维网服务器发起HTTP 请求,通过 TCP 连接(端口号 80)传输。
步骤②:服务器生成 Cookie 标识
服务器为该客户生成一个唯一的Cookie 识别码,并以此为索引,在后端数据库中创建记录项目,用来记录该用户访问网站的各种信息。
步骤③:服务器返回 Set-Cookie 响应
服务器通过 HTTP 响应,向浏览器发送带有
Set-Cookie:xxxxx的报文,将 Cookie 识别码传回用户主机。步骤④:浏览器存储 Cookie
用户主机中的浏览器,将收到的 Cookie 信息存入本地文件。
步骤⑤:后续请求读取 Cookie
当用户再次访问同一网站时,浏览器会从本地文件中读取已存储的 Cookie。
步骤⑥:浏览器发送带 Cookie 的 HTTP 请求
浏览器向服务器发起新的 HTTP 请求时,会在请求报文中携带
Cookie: xxxxx字段,通过 TCP 连接(端口号 80)发送给服务器。步骤⑦:服务器识别用户并返回响应
服务器根据请求中的 Cookie 识别码,识别出该用户,并从数据库中读取用户信息,返回对应的个性化网页。
万维网缓存与代理服务器
在万维网中还可以使用缓存机制以提高万维网的效率。
万维网缓存又称为Web 缓存(Web Cache),可位于客户机,也可位于中间系统上,位于中间系统上的 Web 缓存又称为代理服务器(Proxy Server)。
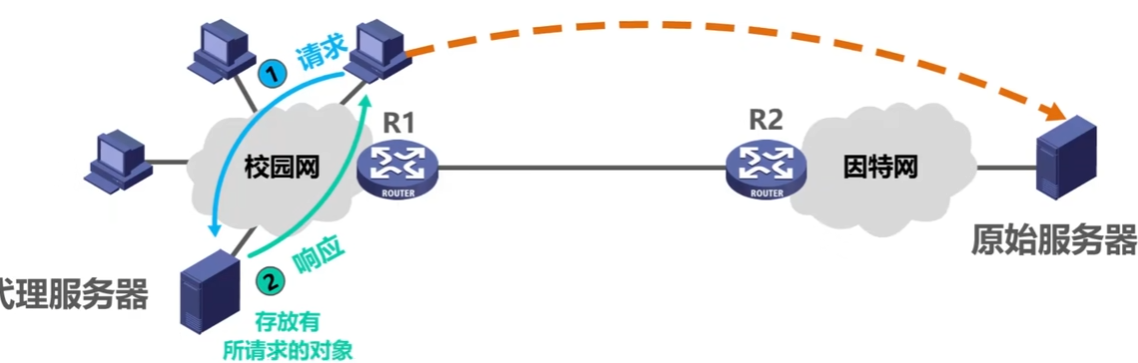
Web 缓存把最近的一些请求和响应暂存在本地磁盘中。当新请求到达时,若发现这个请求与暂时存放的请求相同,就返回暂存的响应,而不需要按 URL 的地址再次去因特网访问该资源。
示意图
命中缓存
未命中缓存
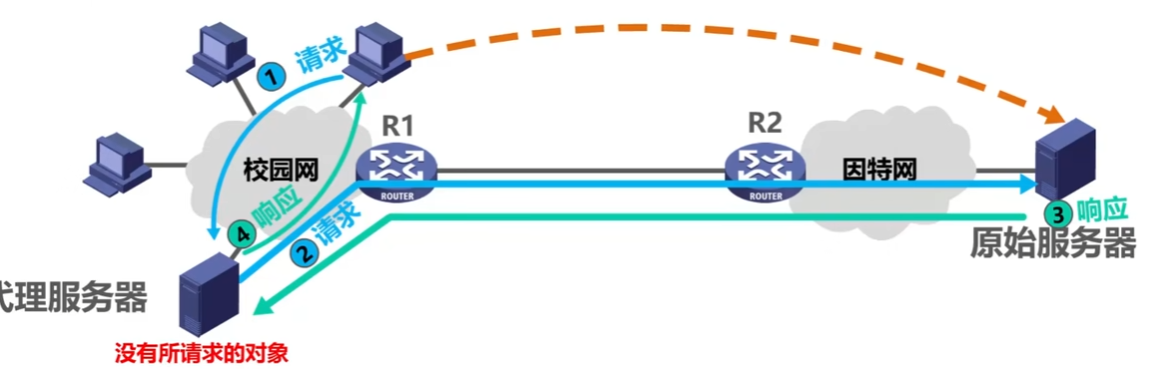
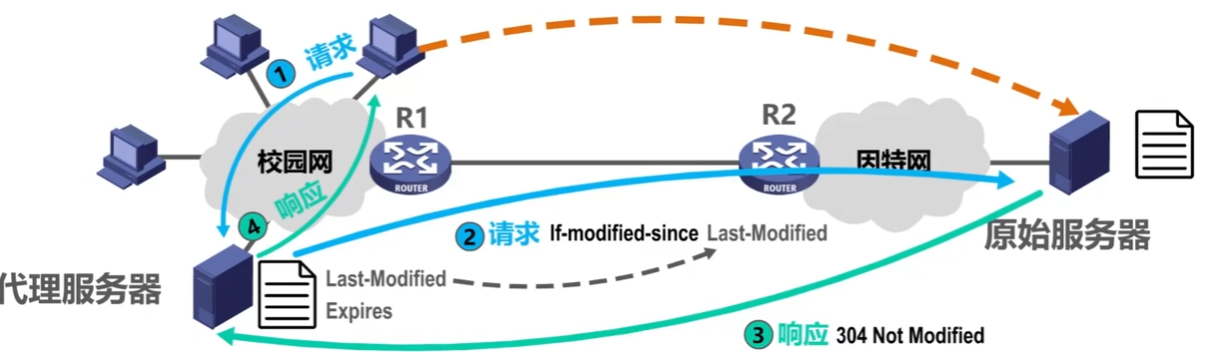
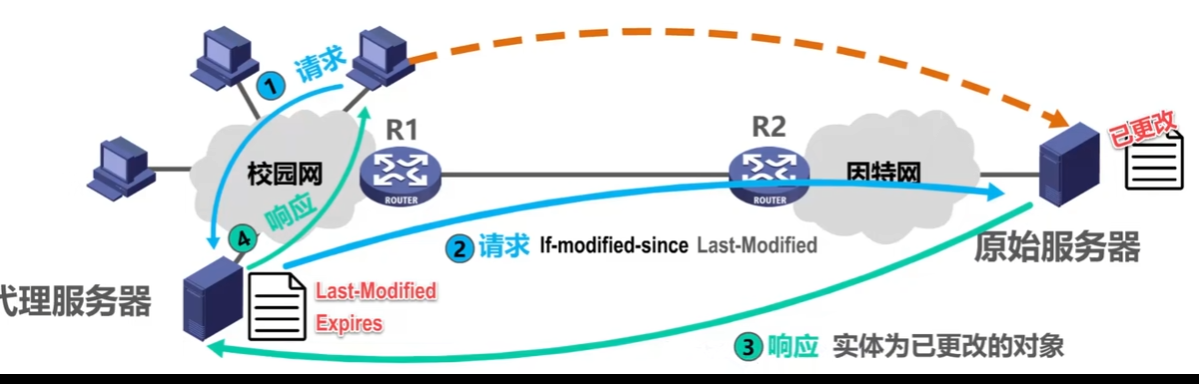
为了确保代理服务器缓存的内容与原始服务器的内容一致,代理服务器设置了过期时间。当文件过期了,代理服务器会向原始服务器发送请求,通过比较If-modified-since来确定文档有无被修改,若被修改则重新向原始服务器发送请求获取文档
文档过期但在原始服务器中未被修改的情况
文档过期且已被修改的情况
万维网习题
习题1
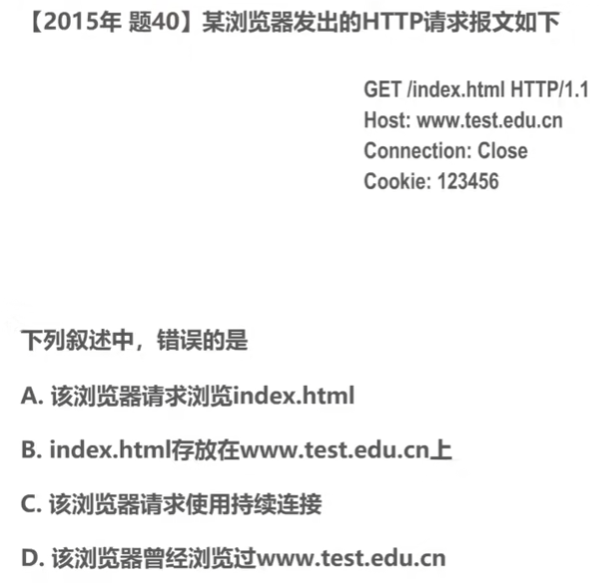
C 第三行的Connection:Close表示发送完文档后就断开连接,若为持续连接应为:Connection:keep-alive
习题2

4RTT
Footnotes
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!