

Hot100
LeetCode_Hot 100
哈希
1. 两数之和
-
题目
给定一个整数数组
nums和一个整数目标值target,请你在该数组中找出 和为目标值target的那 两个 整数,并返回它们的数组下标。你可以假设每种输入只会对应一个答案,并且你不能使用两次相同的元素。
你可以按任意顺序返回答案。
示例 1:
输入:nums = [2,7,11,15], target = 9输出:[0,1]解释:因为 nums[0] + nums[1] == 9 ,返回 [0, 1] 。示例 2:
输入:nums = [3,2,4], target = 6输出:[1,2]示例 3:
输入:nums = [3,3], target = 6输出:[0,1] -
思路
构建哈希表,键:数组中的整数 值:该整数索引。
遍历nums数组,判断哈希表中是否存在 target-nums[i] 的整数,若存在则返回。若不存在则将当前整数及其索引存入哈希表供后续整数查询
时间复杂度O(n)
-
代码
class Solution {public int[] twoSum(int[] nums, int target) {HashMap<Integer,Integer> map = new HashMap<>();for(int i = 0;i<nums.length;i++){if(map.containsKey(target-nums[i])){int [] res = new int[]{i,map.get(target-nums[i])};return res;}map.put(nums[i],i);}return null;}}
2. 字母异位词分组
-
题目
给你一个字符串数组,请你将 字母异位词 组合在一起。可以按任意顺序返回结果列表。
示例 1:
输入: strs = [“eat”, “tea”, “tan”, “ate”, “nat”, “bat”]
输出: [[“bat”],[“nat”,“tan”],[“ate”,“eat”,“tea”]]
解释:
- 在 strs 中没有字符串可以通过重新排列来形成
"bat"。 - 字符串
"nat"和"tan"是字母异位词,因为它们可以重新排列以形成彼此。 - 字符串
"ate","eat"和"tea"是字母异位词,因为它们可以重新排列以形成彼此。
示例 2:
输入: strs = [""]
输出: ""
示例 3:
输入: strs = [“a”]
输出: “a”
提示:
1 <= strs.length <= 1040 <= strs[i].length <= 100strs[i]仅包含小写字母
- 在 strs 中没有字符串可以通过重新排列来形成
-
思路
- 若两个词是字母异位词,则这两个词的字母可以一一对应,也就是说,当对其字母进行排序后得到的字符串是一致的
- 定义一个hashMap,键为字符串排序后的串,值为List
用于存储相同的异位词 - 遍历String数组,并对每一个String都进行排序,拿到排序后的结果查看hashMap中是否已经存在了排序后的串,若存在则说明两词互为异位词,直接将该字符串添加进该List中;若不存在则说明其异位词仍未出现,将其put进hashMap供后续的String比较
-
代码
class Solution {public List<List<String>> groupAnagrams(String[] strs) {//键:排好序后的字符串 值:所有排好序后与键相同的字符串原串HashMap<String,List<String>> hashMap = new HashMap<>();for(String s:strs){//遍历字符串数组//将字符串取出并转换为char数组排序,排序后重新转为字符串char[] arr = s.toCharArray();Arrays.sort(arr);String SortedString = new String(arr);//若有则加入hashMap中的List列表中//若没有则put进hashMap供后续String使用if(hashMap.containsKey(SortedString)){hashMap.get(SortedString).add(s);}else{List<String> newList = new ArrayList<>();newList.add(s);hashMap.put(SortedString,newList);}}//hashMap.values()用于取出所有valuereturn new ArrayList<List<String>>(hashMap.values());}}
3. 最长连续序列
-
题目
给定一个未排序的整数数组
nums,找出数字连续的最长序列(不要求序列元素在原数组中连续)的长度。请你设计并实现时间复杂度为
O(n)的算法解决此问题。示例 1:
输入:nums = [100,4,200,1,3,2]输出:4解释:最长数字连续序列是 [1, 2, 3, 4]。它的长度为 4。示例 2:
输入:nums = [0,3,7,2,5,8,4,6,0,1]输出:9示例 3:
输入:nums = [1,0,1,2]输出:3提示:
0 <= nums.length <= 105-109 <= nums[i] <= 109
-
思路
- 先将nums中所有的元素放入Set中进行去重(后续遍历Set即可,降低时间复杂度)
- 找到第一个元素(!hashSet.contains(i-1)) 如:[100,4,200,1,3,2]中 100-1=99不在集合中所以是第一个元素,同理200 1 都是第一个元素
- 找到第一个元素x后循环找寻 x+1,x+2,x+3…是否存在,在此过程中计数即可算出以x开头的序列长度
- 从所有序列长度中找到最长的那个
-
代码
class Solution {public int longestConsecutive(int[] nums) {int MaxCount = 0;HashSet<Integer> hashSet = new HashSet<>();for(int i:nums){//放入Set中,去重hashSet.add(i);}for(int i:hashSet){if(!hashSet.contains(i-1)){//判断是否为序列开头的元素int count = 1;int temp = i;//若是则循环向后查找while(hashSet.contains(temp+1)){count++;temp++;}//更新最大值if(count>MaxCount)MaxCount = count;}}return MaxCount;}}
双指针
4. 移动零
-
题目
给定一个数组
nums,编写一个函数将所有0移动到数组的末尾,同时保持非零元素的相对顺序。请注意 ,必须在不复制数组的情况下原地对数组进行操作。
示例 1:
输入: nums = [0,1,0,3,12]输出: [1,3,12,0,0]示例 2:
输入: nums = [0]输出: [0]提示:
- 1 <= nums.length <= 10^4^
- -2^31^ <= nums[i] <= 2^31^ - 1
-
思路
双指针,left为慢指针,right为快指针。有点类似于快排,right每次向前移动一格,当找到非零的时候就将其与left位置上的数交换。 如:[x,0,y,0,z,0], left,right起初都指向x,x为非零,left right交换后都向前一格。接着left不懂right去找非0,找到y后与left的位置进行交换。如法炮制,这样子非零元素之间的相对顺序就不会乱
-
代码
class Solution {public void moveZeroes(int[] nums) {int left = 0,right=0;while(right<nums.length){if(nums[right]!=0){int temp = nums[right];nums[right] = nums[left];nums[left] = temp;left++;}right++;}}}
5. 盛最多水的容器
-
题目
给定一个长度为
n的整数数组height。有n条垂线,第i条线的两个端点是(i, 0)和(i, height[i])。找出其中的两条线,使得它们与
x轴共同构成的容器可以容纳最多的水。返回容器可以储存的最大水量。
**说明:**你不能倾斜容器。
示例 1:
 输入:[1,8,6,2,5,4,8,3,7]输出:49解释:图中垂直线代表输入数组 [1,8,6,2,5,4,8,3,7]。在此情况下,容器能够容纳水(表示为蓝色部分)的最大值为 49。
示例 2:
输入:height = [1,1]输出:1提示:
n == height.length2 <= n <= 1050 <= height[i] <= 104
-
思路
对于两板中较短的那一个板而言,若从两板中间找到另一个板与其构成新的容器。分三种情况讨论 — 设两板较长的为A,较短的为B,即从AB中间找到C板与B构成新容器
V(AB) = length(AB)*h(B)
- C比B短时,length(BC)<length(AB), V(BC) = length(BC)*h(C) < V(AB)
- C比B长时,V(BC) = length(BC)*h(B) < V(AB)
- C与B等长时,V(BC)=length(BC)*h(B)<V(AB)
由上可见,不可能找到板C,使得其与B构成的容器容积变大 ——— 即:若想要找到更大容积的容器,我们只能舍弃B,找板C与A构成一个新容器( 且板C要长于板B)
由上述结论,我们可以定义双指针l,r l指向最左边,r指向最右边。每次都抛弃l,r中较短的那一个(设为min,较长的设为max),向中间找一个板子与max构成新容器才有可能扩大容积
-
代码
class Solution {public int maxArea(int[] height) {//初始化指针int left = 0,right = height.length-1;int MaxValue = 0;while(left<right){//向中间找板子int value = (right-left)*Math.min(height[left],height[right]);MaxValue = Math.max(value,MaxValue);//更新MaxValue//抛弃left,right中较短的那一个板if(height[left]<height[right]){left++;}else{right--;}}return MaxValue;}}
6. 三数之和
-
题目
给你一个整数数组
nums,判断是否存在三元组[nums[i], nums[j], nums[k]]满足i != j、i != k且j != k,同时还满足nums[i] + nums[j] + nums[k] == 0。请你返回所有和为0且不重复的三元组。**注意:**答案中不可以包含重复的三元组。
示例 1:
输入:nums = [-1,0,1,2,-1,-4]输出:[[-1,-1,2],[-1,0,1]]解释:nums[0] + nums[1] + nums[2] = (-1) + 0 + 1 = 0 。nums[1] + nums[2] + nums[4] = 0 + 1 + (-1) = 0 。nums[0] + nums[3] + nums[4] = (-1) + 2 + (-1) = 0 。不同的三元组是 [-1,0,1] 和 [-1,-1,2] 。注意,输出的顺序和三元组的顺序并不重要。示例 2:
输入:nums = [0,1,1]输出:[]解释:唯一可能的三元组和不为 0 。示例 3:
输入:nums = [0,0,0]输出:[[0,0,0]]解释:唯一可能的三元组和为 0 。提示:
3 <= nums.length <= 3000-105 <= nums[i] <= 105
-
思路
nums[i] + nums[j] + nums[k] == 0可以视为 nums[j]+nums[k] = -nums[i] 其中-nums[i] 为target。 当一个数组排好序后我们想要挑选其中两个数之和为target时 如:[1,2,3,4,5,6] 想要挑选两个数之和为5。 我们从1 6开始,由于1+6=7>5 且1是最小的数了,说明6无法和其他数相加成为5。 所以右指针向左移一格。 同理,当指向3,1时,1+3=4<5,左指针右移到2 3+2=5
- 给数组排序
- 循环整个数组每次都取出nums[i]作为target
- 定义j,k双指针,其中j=i+1,k=nums.length-1; 在这个范围内向中间缩进根据上述思路找寻符合条件的 nums[j] nums[k]
- 注意:查询途中不允许重复的三元组出现,所以有重复的数字出现时我们应跳过
- 此外,还有两个优化。
- 当nums[j]+nums[j+1]>-nums[i]时,即两个最小的相加都大于target时,说明当前轮的i不符合条件了
- 当nums[k]+nums[k-1]<-nums[i]时,即两个最大的相加都小于target,说明当前轮的i不符合条件了
-
代码
class Solution {public List<List<Integer>> threeSum(int[] nums) {List<List<Integer>> ans = new ArrayList<>();Arrays.sort(nums);int n = nums.length;for (int i = 0; i < n; i++) {if (i > 0 && nums[i] == nums[i - 1])//防止重复continue;int target = -nums[i];//l = i+1 防止重复int l = i+1, r = n - 1;while (l < r) {int sum = nums[l] + nums[r];if (sum > target) {r--;} else if (sum < target) {l++;} else {List<Integer> temp = new ArrayList<>();temp.add(nums[i]);temp.add(nums[l]);temp.add(nums[r]);ans.add(temp);//不能直接break 还有可能有其他可能l++;r--;//防止重复//注意此处:nums[l]==nums[l-1] nums[r]==nums[r+1]//由于l是要向右动的,所以要和i-1比较,不然可能会遗漏//r同理//[-2,0,1,1,2]while(l<r && nums[l]==nums[l-1])l++;while(l<r && nums[r]==nums[r+1])r--;}}}return ans;}}
7. 接雨水
-
题目
给定
n个非负整数表示每个宽度为1的柱子的高度图,计算按此排列的柱子,下雨之后能接多少雨水。示例 1:
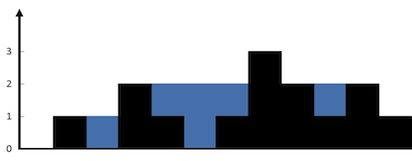 输入:height = [0,1,0,2,1,0,1,3,2,1,2,1]输出:6解释:上面是由数组 [0,1,0,2,1,0,1,3,2,1,2,1] 表示的高度图,在这种情况下,可以接 6 个单位的雨水(蓝色部分表示雨水)。
示例 2:
输入:height = [4,2,0,3,2,5]输出:9提示:
n == height.length1 <= n <= 2 * 1040 <= height[i] <= 105
-
思路
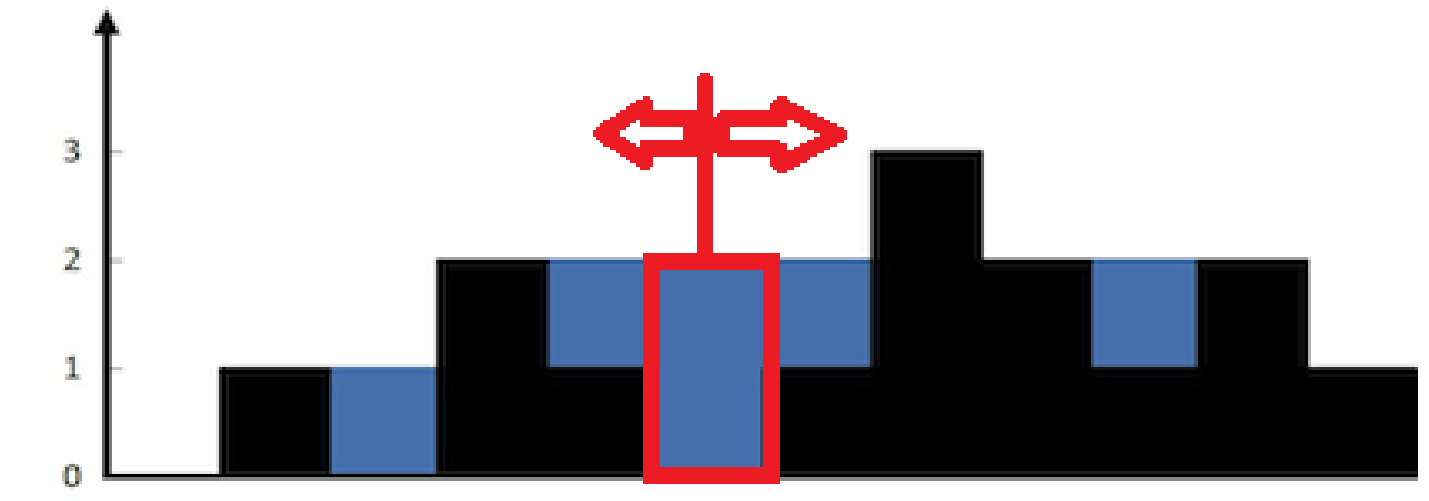
如图所示,对于我们用红色框出来的这个坑洼,分别向左向右看去,可以看到,左边的最大高度为2右边的最大高度为3。由此可知,对于一个坑洼来说,可以接到的水量就为
min(左边最大高度,右边最大高度)-当前坑洼本身高度
所以可以维护两个数组,一个数组为:每一格向左看去的最大高度(最大前缀),另一个数组为每一格向右看去的最大高度(最大后缀)。 随后根据水量关系即可得出梅格可以积多少水
空间复杂度的优化<相向指针法>
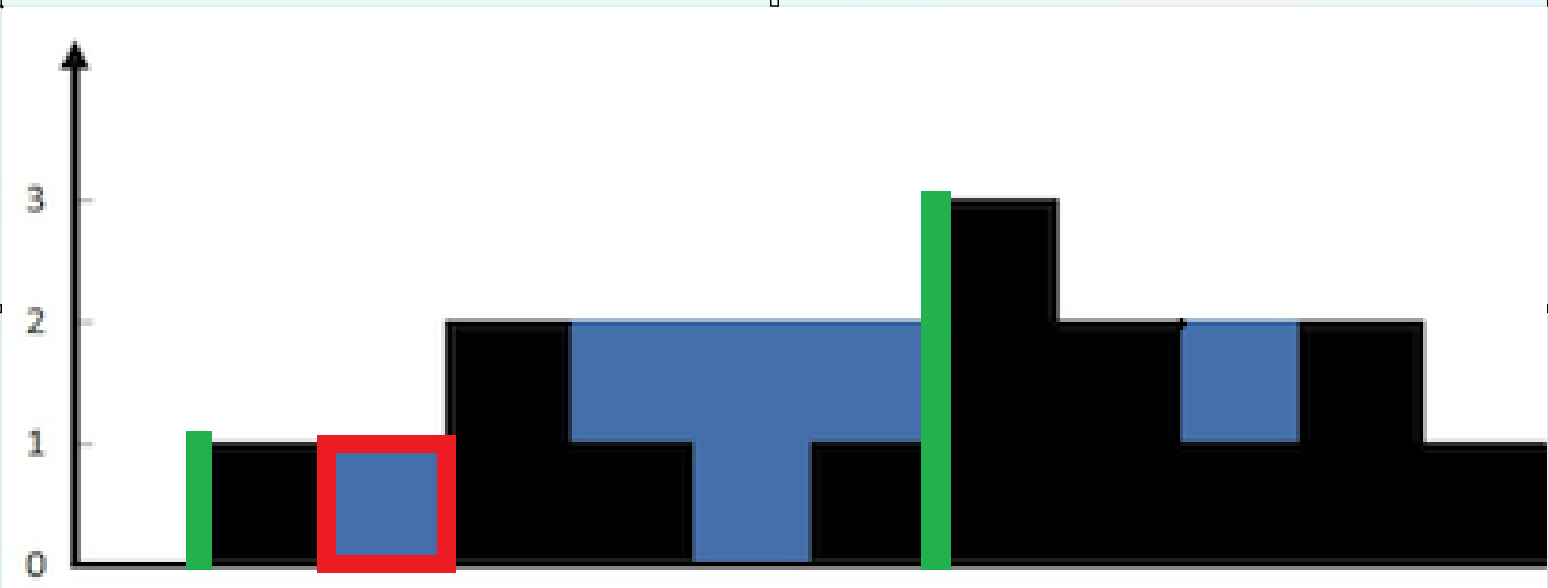
如图所示,两个绿柱分别为已经算出来的前后缀最大值,由于前后缀最大值只会变大不会变小,所以可知红框这格的最大后缀至少为3,那么其最大后缀>最大前缀,所以可以直接拿其最大前缀去计算
详见:视频
-
代码
-
优化前
class Solution {public int trap(int[] height) {int n = height.length;int[] pre_max = new int[n];int[] post_max = new int[n];int sum = 0;pre_max[0] = height[0];post_max[n-1] = height[n-1];//求前后缀最大值for(int i = 1;i<n;i++){pre_max[i] = Math.max(pre_max[i-1],height[i]);}for(int i = n-2;i>=0;i--){post_max[i] = Math.max(post_max[i+1],height[i]);}for(int i = 0;i<n;i++){int h = Math.min(pre_max[i],post_max[i]);sum+=h-height[i];}return sum;}} -
优化后
class Solution {public int trap(int[] height) {int n = height.length;int pre_max = height[0];int post_max = height[n-1];int sum = 0;int left = 0;int right = n-1;while(left<right){//更新最大前后缀pre_max = Math.max(pre_max,height[left]);post_max = Math.max(post_max,height[right]);//若此时前缀高度<后缀高度,说明这个格的前缀高度肯定是短板if(pre_max<post_max){sum+=pre_max-height[left++];}//反之则后缀高度是短板else{sum+=post_max-height[right--];}}return sum;}}
-
5. 最长回文子串
-
题目
给你一个字符串
s,找到s中最长的 回文 子串。示例 1:
输入:s = "babad"输出:"bab"解释:"aba" 同样是符合题意的答案。示例 2:
输入:s = "cbbd"输出:"bb"提示:
1 <= s.length <= 1000s仅由数字和英文字母组成
-
思路
若是枚举左右边界以枚举所有子串O(n^2^),再判断该子串是否为回文子串O(n),总时间复杂度为O(n^3^)
-
代码
class Solution {public String longestPalindrome(String s) {char[] str = s.toCharArray();int n = str.length;int ansLeft = 0;int ansRight = 0;//奇回文串for(int i = 0;i<n;i++){int l = i;int r = i;while(l>=0 && r<n && str[l] == str[r]){l--;r++;}if(r-l-1 > ansRight - ansLeft){ansLeft = l+1;ansRight = r;}}//偶回文串for(int i = 0;i<n-1;i++){int l = i;int r = i+1;while(l>=0 && r<n && str[l] == str[r]){l--;r++;}if(r-l-1 > ansRight - ansLeft){ansLeft = l+1;ansRight = r;}}return s.substring(ansLeft,ansRight);}}
滑动窗口
-
滑动窗口是双指针的高阶应用,总体而言就是通过左右指针维护一个窗口,右指针扩大窗口,左指针缩小窗口。常用于最大/最小子串的求解
以下三个问题是很好的思路
- 何时增大窗口?
- 何时减小窗口?
- 何时更新结果?
8. 无重复字符的最长子串
-
题目
给定一个字符串
s,请你找出其中不含有重复字符的 最长 子串 的长度。示例 1:
输入: s = "abcabcbb"输出: 3解释: 因为无重复字符的最长子串是 "abc",所以其长度为 3。注意 "bca" 和 "cab" 也是正确答案。示例 2:
输入: s = "bbbbb"输出: 1解释: 因为无重复字符的最长子串是 "b",所以其长度为 1。示例 3:
输入: s = "pwwkew"输出: 3解释: 因为无重复字符的最长子串是 "wke",所以其长度为 3。请注意,你的答案必须是 子串 的长度,"pwke" 是一个子序列,不是子串。提示:
0 <= s.length <= 5 * 104s由英文字母、数字、符号和空格组成
-
思路
滑动窗口+哈希表。哈希表用于记录窗口中的字符,以判断窗口中是否有重复的字符
-
代码
class Solution {public int lengthOfLongestSubstring(String s) {int left = 0,right = 0;char []str = s.toCharArray();int len = str.length;int MaxLen = 0;HashSet<Character> hs = new HashSet<>();while(right < len){//当右指针前移过程中,发现在哈希表中已经有过这个字符时,//1.统计结果 2.左指针开始前移缩小窗口范围if(hs.contains(str[right])){MaxLen = Math.max(MaxLen,right-left);while(hs.contains(str[right])){//左指针前移过程中,将排出窗口外的字符移出哈希表hs.remove(str[left++]);}}//右指针前移扩大窗口hs.add(str[right++]);}//最后算一遍,通过字符串长度为1或空串的特例MaxLen = Math.max(MaxLen,right-left);return MaxLen;}}
9. 找到字符串中所有字母异位词
-
题目
给定两个字符串
s和p,找到s中所有p的 异位词 的子串,返回这些子串的起始索引。不考虑答案输出的顺序。示例 1:
输入: s = "cbaebabacd", p = "abc"输出: [0,6]解释:起始索引等于 0 的子串是 "cba", 它是 "abc" 的异位词。起始索引等于 6 的子串是 "bac", 它是 "abc" 的异位词。示例 2:
输入: s = "abab", p = "ab"输出: [0,1,2]解释:起始索引等于 0 的子串是 "ab", 它是 "ab" 的异位词。起始索引等于 1 的子串是 "ba", 它是 "ab" 的异位词。起始索引等于 2 的子串是 "ab", 它是 "ab" 的异位词。提示:
1 <= s.length, p.length <= 3 * 104s和p仅包含小写字母
-
思路:定长滑动窗口 ,由于要查找的串长度是确定的,所以使用定长滑动窗口解决。统计窗口内字母的个数,当窗口长度到达查找串的长度时进行检验并缩短窗口
-
代码
class Solution {public List<Integer> findAnagrams(String s, String p) {int[] cntP = new int[26];char[] strp = p.toCharArray();for(char c:strp){cntP[c-'a']++;//统计各单词个数}List<Integer> res = new ArrayList<>();int[] cntW = new int[26];int left = 0,right = 0;while(right<s.length()){//当窗口尺寸<查找串长度时进行窗口的扩容while(right<s.length()&& right-left<strp.length){cntW[s.charAt(right++)-'a']++;}//长度到达后,检验if(Arrays.equals(cntP,cntW)){res.add(left);}//缩短窗口cntW[s.charAt(left++)-'a']--;}return res;}}
额外. 定长子串中元音的最大数目
-
题目
给你字符串
s和整数k。请返回字符串
s中长度为k的单个子字符串中可能包含的最大元音字母数。英文中的 元音字母 为(
a,e,i,o,u)。示例 1:
输入:s = "abciiidef", k = 3输出:3解释:子字符串 "iii" 包含 3 个元音字母。示例 2:
输入:s = "aeiou", k = 2输出:2解释:任意长度为 2 的子字符串都包含 2 个元音字母。示例 3:
输入:s = "leetcode", k = 3输出:2解释:"lee"、"eet" 和 "ode" 都包含 2 个元音字母。示例 4:
输入:s = "rhythms", k = 4输出:0解释:字符串 s 中不含任何元音字母。示例 5:
输入:s = "tryhard", k = 4输出:1提示:
1 <= s.length <= 10^5s由小写英文字母组成1 <= k <= s.length
-
思路
定长滑窗
-
代码
class Solution {public int maxVowels(String s, int k) {int ans = 0;char[] str = s.toCharArray();int count = 0;for(int r = 0,l = 0;r<str.length;r++){if(str[r]=='a'||str[r]=='e'||str[r]=='i'||str[r]=='o'||str[r]=='u'){count++;}while(r-l+1>=k){ans = Math.max(ans,count);if(str[l]=='a'||str[l]=='e'||str[l]=='i'||str[l]=='o'||str[l]=='u'){count--;}l++;}}return ans;}}
额外. 替换后的最长重复字符
-
题目
给你一个字符串
s和一个整数k。你可以选择字符串中的任一字符,并将其更改为任何其他大写英文字符。该操作最多可执行k次。在执行上述操作后,返回 包含相同字母的最长子字符串的长度。
示例 1:
输入:s = "ABAB", k = 2输出:4解释:用两个'A'替换为两个'B',反之亦然。示例 2:
输入:s = "AABABBA", k = 1输出:4解释:将中间的一个'A'替换为'B',字符串变为 "AABBBBA"。子串 "BBBB" 有最长重复字母, 答案为 4。可能存在其他的方法来得到同样的结果。提示:
1 <= s.length <= 105s仅由大写英文字母组成0 <= k <= s.length
-
代码
class Solution {public int characterReplacement(String s, int k) {char[] str = s.toCharArray();int[] cnt = new int[26];//统计窗口中字符个数int res = 0;for(int left=0,right=0;right<str.length;right++){//扩窗cnt[str[right]-'A']++;//检查while(!check(cnt,k)){//若检查不通过:即当前窗口无法构成连续字符//缩小窗口cnt[str[left++]-'A']--;}res = Math.max(res,right-left+1);}return res;}public boolean check(int[] cnt,int k){int max = 0;int sum = 0;for(int i = 0;i<26;i++){//找到当前窗口中最多的字符的个数max = Math.max(max,cnt[i]);//统计窗口中字符总个数sum+=cnt[i];}//容错肯定是给窗口中出现的最多的字符的//这里计算除去窗口出现最多次数的其他字符的个数int remain = sum-max;//若其他字符个数>容错个数,说明无法使当前窗口所有字符相同return remain<=k;}}
额外. 和相同的二元子数组
-
题目
给你一个二元数组
nums,和一个整数goal,请你统计并返回有多少个和为goal的 非空 子数组。子数组 是数组的一段连续部分。
示例 1:
输入:nums = [1,0,1,0,1], goal = 2输出:4解释:有 4 个满足题目要求的子数组:[1,0,1]、[1,0,1,0]、[0,1,0,1]、[1,0,1]示例 2:
输入:nums = [0,0,0,0,0], goal = 0输出:15提示:
1 <= nums.length <= 3 * 104nums[i]不是0就是10 <= goal <= nums.length
-
思路
- 可以用前缀和解 详见:[10](#10. 和为 K 的子数组)
- 但是不同于[10](#10. 和为 K 的子数组),这一题是没有负数存在的,满足滑窗要求的单调性 ,所以可以使用恰好型滑窗来优化内存
-
恰好型滑窗:用于解决求取和恰好为k的子数组的个数。如:[left,right]这个区间内都满足 sum>=k (sum为子数组的和) 也就是说[left-1,right] … [0,right] 都是满足sum<=k的 共left个(tip:此处使用的是<=k 因为可能会出现0) ** 同理,我们也可以找到 [left2,right2]共left2个满足sum>=k+1** 的 left1-left2即为所求
tip:由于sum>=k的范围比sum>=k+1的范围更大,所以满足sum>=k的子数组个数肯定更多
-
代码
class Solution {public int numSubarraysWithSum(int[] nums, int goal) {int sum1 = 0,sum2 = 0;int ans = 0;for(int r = 0,l1 = 0,l2=0;r<nums.length;r++){sum1+=nums[r];sum2+=nums[r];//限制l1<=r 防止中间全是0的情况导致越界while(l1<=r && sum1>=goal){sum1-=nums[l1++];}//加上满足>=goal的ans+=l1;//限制l2<=r 防止中间全是0的情况导致越界while(l2<=r && sum2>=goal+1){sum2-=nums[l2++];}//减去满足>=goal+1的ans-=l2;}return ans;}}
12. 最小覆盖子串
-
题目
给定两个字符串
s和t,长度分别是m和n,返回 s 中的 最短窗口 子串,使得该子串包含t中的每一个字符(包括重复字符)。如果没有这样的子串,返回空字符串""。测试用例保证答案唯一。
示例 1:
输入:s = "ADOBECODEBANC", t = "ABC"输出:"BANC"解释:最小覆盖子串 "BANC" 包含来自字符串 t 的 'A'、'B' 和 'C'。示例 2:
输入:s = "a", t = "a"输出:"a"解释:整个字符串 s 是最小覆盖子串。示例 3:
输入: s = "a", t = "aa"输出: ""解释: t 中两个字符 'a' 均应包含在 s 的子串中,因此没有符合条件的子字符串,返回空字符串。提示:
m == s.lengthn == t.length1 <= m, n <= 105s和t由英文字母组成
-
思路
本质滑动窗口 需要注意以下几点
- check函数使用遍历a-z A-Z 而不是遍历t[]数组里的字符,原因是t数组里的字符很有可能>52 这样一来运行效率大大减慢
- 应该使用check函数来判断是否符合要求,而非
Arrays.equals,原因:,答案为,可见,题目要求的“覆盖”,不能等价于“与子串中字母一一对应”
-
扩容与缩容
-
扩容
自然扩容,每有一个就纳入,无限制条件
-
缩容
可以覆盖时,持续缩容,直至不可以覆盖。注意在缩容过程中记录最小值
-
-
代码
class Solution {public String minWindow(String S, String T) {char[] s = S.toCharArray();char[] t = T.toCharArray();int m = s.length;int n = t.length;if (n > m) {return "";}int cnt[] = new int[128];int win[] = new int[128];for (char ch : t) {cnt[ch]++;}int min = Integer.MAX_VALUE;int ansLeft = 0;int ansRight = 0;for (int right = 0, left = 0; right < m; right++) {win[s[right]]++;//check函数检验是否覆盖,注意覆盖!= 一一对应while (check(cnt, win)) {win[s[left++]]--;if (right - left + 1 < min) {min = right - left + 1;ansLeft = left - 1;ansRight = right + 1;}}}return S.substring(ansLeft, ansRight);}//check函数,用于检验win(窗口中的字母统计)是否覆盖了cnt(子串的字母统计)private boolean check(int[] cnt, int[] win) {for (int c = 'a'; c <= 'z'; c++) {if (cnt[c] > win[c]) {return false;}}for (int c = 'A'; c <= 'Z'; c++) {if (cnt[c] > win[c]) {return false;}}return true;}}
前缀和
额外(模板题) 区域和检索 - 数组不可变
-
题目
给定一个整数数组
nums,处理以下类型的多个查询:- 计算索引
left和right(包含left和right)之间的nums元素的 和 ,其中left <= right
实现
NumArray类:NumArray(int[] nums)使用数组nums初始化对象int sumRange(int left, int right)返回数组nums中索引left和right之间的元素的 总和 ,包含left和right两点(也就是nums[left] + nums[left + 1] + ... + nums[right])
示例 1:
输入:["NumArray", "sumRange", "sumRange", "sumRange"][[[-2, 0, 3, -5, 2, -1]], [0, 2], [2, 5], [0, 5]]输出:[null, 1, -1, -3]解释:NumArray numArray = new NumArray([-2, 0, 3, -5, 2, -1]);numArray.sumRange(0, 2); // return 1 ((-2) + 0 + 3)numArray.sumRange(2, 5); // return -1 (3 + (-5) + 2 + (-1))numArray.sumRange(0, 5); // return -3 ((-2) + 0 + 3 + (-5) + 2 + (-1))提示:
1 <= nums.length <= 104-105 <= nums[i] <= 1050 <= left <= right < nums.length- 最多调用
104次sumRange方法
- 计算索引
-
思路
-
暴力解法
class NumArray {public int[] nums;public NumArray(int[] nums) {this.nums = nums;}public int sumRange(int left, int right) {int sum = 0;for(int i = left;i<=right;i++){sum+=nums[i];}return sum;}} -
前缀和解法:创建一个数组sum[] sum[i] 代表着nums[0]+nums[1]+…+nums[i] 那么计算left~right之和只需计算sum[right]-sum[left] O(1) ,有点类似于记忆化
-
560. 和为 K 的子数组
-
题目
给你一个整数数组
nums和一个整数k,请你统计并返回 该数组中和为k的子数组的个数 。子数组是数组中元素的连续非空序列。
示例 1:
输入:nums = [1,1,1], k = 2输出:2示例 2:
输入:nums = [1,2,3], k = 3输出:2提示:
1 <= nums.length <= 2 * 104-1000 <= nums[i] <= 1000-107 <= k <= 107
-
思路
- 初始想法 — 滑窗。但是由于给出的数组中会出现负数,就无法保证 右指针移动窗口内总和变大,左指针移动窗口内总和变小这种线性关系了。滑窗只适用于给出数组内所有数字同号的情况
- 解决方法 — 前缀和 定义数组sum 记录sum[i]代表0
i的nums之和。如此一来问题就转为了 寻找right,left(right>left)使得sum[right] - sum[left] = target 变形得到 sum[right]+(-sum[left]) = target。 如此一来问题就转换为了两数之和 即寻找:sum[left] = sum[right] - target 假设我们for循环到了i 也就是说我们要从sum[0] ~ sum[i-1] 里面寻找合适的数 因为此时我们已经将sum[0] ~ sum[i-1] 进行了统计,那么此刻的i就相当于公式中的right 我们需要在0i-1中找left
综上:这种方式也被简称为:前缀和 枚举右 维护左
-
代码
class Solution {public int subarraySum(int[] nums, int k) {int n = nums.length;int[] sum = new int[n+1];for(int i = 0;i<n;i++){//sum[1] = nums[0] sum[2] = nums[0] + nums[1] ...sum[i+1] = sum[i] + nums[i];}HashMap<Integer,Integer> hm = new HashMap<>();int ans = 0;//sum[0]也要算上 注意此处是n+1---sum[n] = nums[0]+... +nums[n-1]for(int i = 0;i<n+1;i++){//找i左边的符合条件的 --- i左边的元素已经被统计进hashMap//sum[i] - sum[j] = k i>j//注意i>j,所以需要在遍历的过程中去记录,记录到map里的就是j,当前遍历到的元素就是i//如此一来j都存入了map,都是已知的。从map中找j即可int target = sum[i]-k;ans+=hm.getOrDefault(target,0);if(hm.containsKey(sum[i])){hm.put(sum[i],hm.get(sum[i])+1);}else{hm.put(sum[i],1);}}return ans;}}
53(思路1). 最大子数组和
-
题目
给你一个整数数组
nums,请你找出一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。子数组是数组中的一个连续部分。
示例 1:
输入:nums = [-2,1,-3,4,-1,2,1,-5,4]输出:6解释:连续子数组 [4,-1,2,1] 的和最大,为 6 。示例 2:
输入:nums = [1]输出:1示例 3:
输入:nums = [5,4,-1,7,8]输出:23提示:
1 <= nums.length <= 105-104 <= nums[i] <= 104
-
思路1:前缀和+贪心。要求的是子数组的和,根据前缀和可知,[left,right]的和=right的前缀和-left的前缀和 ** 。这样一来问题就转换成了求前缀和数组中任意两数相减的最大值** ,tip:任意两数必须是索引大的减索引小的(只有sum[right]-sum[left] 才可以得到[left,right]的和) 。 有了这层限制条件后,我们就可以使用贪心的策略解决:对于一个确定的right,我们只需要寻找[0,left]中最小的那个数去相减即可。 此时算法的时间复杂度就变为了O(n) 【只需要遍历一遍sum,找出每个right的最大值并取出里面最大的那个】
-
[思路2](#53(思路2). 最大子数组和)
-
代码
class Solution {public int maxSubArray(int[] nums) {int n = nums.length;int sum[] = new int[n+1];if(n==1){return nums[0];}//min用于记录[0,i]中的最小值int min = 0;//ans需设置的小一点,题目中会出现负数int ans = -1000000;for(int i = 0;i<n;i++){sum[i+1] = sum[i] + nums[i];min = Math.min(min,sum[i]);ans = Math.max(ans,sum[i+1]-min);}return ans;}}
单调队列
11. 滑动窗口最大值
-
题目
给你一个整数数组
nums,有一个大小为k的滑动窗口从数组的最左侧移动到数组的最右侧。你只可以看到在滑动窗口内的k个数字。滑动窗口每次只向右移动一位。返回 滑动窗口中的最大值 。
示例 1:
输入:nums = [1,3,-1,-3,5,3,6,7], k = 3输出:[3,3,5,5,6,7]解释:滑动窗口的位置 最大值--------------- -----[1 3 -1] -3 5 3 6 7 31 [3 -1 -3] 5 3 6 7 31 3 [-1 -3 5] 3 6 7 51 3 -1 [-3 5 3] 6 7 51 3 -1 -3 [5 3 6] 7 61 3 -1 -3 5 [3 6 7] 7示例 2:
输入:nums = [1], k = 1输出:[1]提示:
1 <= nums.length <= 105-104 <= nums[i] <= 1041 <= k <= nums.length
-
思路
维护一个双端队列
当滑动窗口移动时,队列需进行以下操作
- 将出窗口的最左端元素移出队列(从队列左端移除),保证队列内的数据肯定在窗口内
- 将新加入窗口的元素加入队列,同时要维护队列的单调性 (即:从队列的最右端新增该元素,注意新增时若队列最右端元素小于等于该元素,则移除最右端元素再插入。以此保证队列单调性)
- 从队列最左端取答案
-
tip:放入队列的是元素的下标,这样可以用于判断队列最左边的元素是否已经不在窗口中了
若想提升效率,可以不用封装好的双端队列,直接用数组模拟双端队列
-
代码
class Solution {public int[] maxSlidingWindow(int[] nums, int k) {//双端队列:存的是下标!!!!!!!!!!!!!Deque<Integer> q = new ArrayDeque<>();//对于长度为n,窗口长度为k的数组,每个窗口产生一个最大值//所以其最大值个数=n-k+1int[]ans = new int[nums.length-k+1];int count = 0;for(int r = 0,l = 0;r<nums.length;r++){//维护双端队列左端://最左端的下标<l时,说明最左端的元素已经不在窗口中,需移除if(!q.isEmpty() &&q.getFirst()<l){q.removeFirst();}//维护双端队列右端://当窗口中有新元素进来时,将队列右端小于等于它的值删除,并插入while(!q.isEmpty() && nums[q.getLast()]<=nums[r]){q.removeLast();}q.addLast(r);//当窗口元素满k个时,从单调队列中取答案并维护窗口:缩窗if(r-l+1 == k){ans[count++] = nums[q.getFirst()];l++;}}return ans;}}
动态规划
53(思路2). 最大子数组和
-
题目
给你一个整数数组
nums,请你找出一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。子数组是数组中的一个连续部分。
示例 1:
输入:nums = [-2,1,-3,4,-1,2,1,-5,4]输出:6解释:连续子数组 [4,-1,2,1] 的和最大,为 6 。示例 2:
输入:nums = [1]输出:1示例 3:
输入:nums = [5,4,-1,7,8]输出:23提示:
1 <= nums.length <= 105-104 <= nums[i] <= 104
-
思路2:动态规划
定义表示以结尾的最大子数组和。
对于 ,若 那么直接把 纳入即可;反之,
状态转换表达式:
最终的结果为最大的那个
-
代码
class Solution {public int maxSubArray(int[] nums) {int[] dp = new int[nums.length];int ans = -10000000;for(int i = 0;i<nums.length;i++){if(i==0){dp[i] = nums[i];}else{dp[i] = Math.max(dp[i-1],0)+nums[i];}ans = Math.max(ans,dp[i]);}return ans;}}
数组
56. 合并区间
-
题目
以数组
intervals表示若干个区间的集合,其中单个区间为intervals[i] = [starti, endi]。请你合并所有重叠的区间,并返回 一个不重叠的区间数组,该数组需恰好覆盖输入中的所有区间 。示例 1:
输入:intervals = [[1,3],[2,6],[8,10],[15,18]]输出:[[1,6],[8,10],[15,18]]解释:区间 [1,3] 和 [2,6] 重叠, 将它们合并为 [1,6].示例 2:
输入:intervals = [[1,4],[4,5]]输出:[[1,5]]解释:区间 [1,4] 和 [4,5] 可被视为重叠区间。示例 3:
输入:intervals = [[4,7],[1,4]]输出:[[1,7]]解释:区间 [1,4] 和 [4,7] 可被视为重叠区间。提示:
1 <= intervals.length <= 104intervals[i].length == 20 <= starti <= endi <= 104
-
思路:先排序后合并,具体的合并思路在代码注解中
-
代码
class Solution {public int[][] merge(int[][] intervals) {//按照左端点排序Arrays.sort(intervals,(int[]p,int[]q)->{return p[0]-q[0];});//Lambda表达式指定排序规则//先放入链表中,因为不知道答案具体的尺寸List<int[]> ans = new ArrayList<>();for(int[]t : intervals){int left = t[0];int right = t[1];int size = ans.size();//由于排序后,i+1的左端点肯定是大于i的左端点的//所以我们只需要去比较i+1的左端点是否小于i的右端点//若i+1的左端点小于i的右端点,说明i+1这个区间肯定有一部分在i这个区间内部if(size>0 && ans.get(size-1)[1]>= left){//若区间有部分重合,则合并区间//此处还需进行分类//1.i+1区间只有一部分在i区间内,需要将原先的右端点更新为i+1的右端点//2.i+1区间整个被包含在i区间内,则无需更新ans.get(size-1)[1] = Math.max(right,ans.get(size-1)[1]);}//若不是上述情况说明该区间为独立区间或该区间为第一个区间else{ans.add(t);}}//List的toArray方法,需要指定转换为的数组类型,否则为Object[]return ans.toArray(new int[ans.size()][]);}}
189. 轮转数组
-
题目
给定一个整数数组
nums,将数组中的元素向右轮转k个位置,其中k是非负数。示例 1:
输入: nums = [1,2,3,4,5,6,7], k = 3输出: [5,6,7,1,2,3,4]解释:向右轮转 1 步: [7,1,2,3,4,5,6]向右轮转 2 步: [6,7,1,2,3,4,5]向右轮转 3 步: [5,6,7,1,2,3,4]示例 2:
输入:nums = [-1,-100,3,99], k = 2输出:[3,99,-1,-100]解释:向右轮转 1 步: [99,-1,-100,3]向右轮转 2 步: [3,99,-1,-100]提示:
1 <= nums.length <= 105-231 <= nums[i] <= 231 - 10 <= k <= 105
-
思路
如:对于 nums = [1,2,3,4,5,6,7], k = 3 我们将[1,2,3,4]看为一个整体A[5,6,7]看为一个整体
B即:nums = [A,B] 所需的结果为:[B,A] 那么只要对其reverse一下即可。注意:当我们将其看为一个整体reverse后其内部顺序也会被reverse ,所以我们要对A、B分别reverse一次

-
代码
class Solution {public void rotate(int[] nums, int k) {int n = nums.length;k%=n;reverse(nums,0,n-1);reverse(nums,0,k-1);reverse(nums,k,n-1);}public void reverse(int[]nums,int start,int end){int left = start;int right = end;while(left<right){int temp = nums[left];nums[left] = nums[right];nums[right] = temp;left++;right--;}}}
238. 除了自身以外数组的乘积
-
题目
给你一个整数数组
nums,返回 数组answer,其中answer[i]等于nums中除了nums[i]之外其余各元素的乘积 。题目数据 保证 数组
nums之中任意元素的全部前缀元素和后缀的乘积都在 32 位 整数范围内。请 **不要使用除法,**且在
O(n)时间复杂度内完成此题。示例 1:
输入: nums = [1,2,3,4]输出: [24,12,8,6]示例 2:
输入: nums = [-1,1,0,-3,3]输出: [0,0,9,0,0]提示:
2 <= nums.length <= 105-30 <= nums[i] <= 30- 输入 保证 数组
answer[i]在 32 位 整数范围内
-
思路
求出i的前缀乘积和后缀乘积,乘起来就行
-
代码
tip:下面代码可进一步优化空间复杂度:将数组换为一个变量
由于每次的前后缀乘积只依赖于上一次的前后缀乘积,所以可以直接用一个变量记录
class Solution {public int[] productExceptSelf(int[] nums) {int n = nums.length;int[] prefix = new int[n+1];int[] suffix = new int[n+1];int ans[] = new int[n];prefix[0] = 1;for(int i = 0;i<n;i++){//求前缀乘积prefix[i+1] = prefix[i]*nums[i];}suffix[n-1] = 1;for(int i = n-1;i>0;i--){//求后缀乘积suffix[i-1] = suffix[i] * nums[i];}for(int i = 0;i<n;i++){ans[i] = prefix[i]*suffix[i];}return ans;}}
41. 缺失的第一个正数
-
题目
给你一个未排序的整数数组
nums,请你找出其中没有出现的最小的正整数。请你实现时间复杂度为
O(n)并且只使用常数级别额外空间的解决方案。示例 1:
输入:nums = [1,2,0]输出:3解释:范围 [1,2] 中的数字都在数组中。示例 2:
输入:nums = [3,4,-1,1]输出:2解释:1 在数组中,但 2 没有。示例 3:
输入:nums = [7,8,9,11,12]输出:1解释:最小的正数 1 没有出现。提示:
1 <= nums.length <= 105-231 <= nums[i] <= 231 - 1
-
思路
- 想象在教室里,学生都有自己的学号(1,2,3,4,5….) 但是学生的顺序被打乱了,限制有n个座位。要找出1-n里面没有到场的学生的最小学号。 我们只需要将对应学号的学生安排到对应座位上(1号安排到1号 2号安排到2号…) 排完之后1-n中没来的位置就会空出来,从左到右数哪个是最先空出来的即可
- 优化:题目要求常数级别的空间复杂度,那么我们可以只在原数组内进行操作,将没来的学生逻辑上的“空出来” — 即:从前向后遍历数组 如:遍历到1时应该是2号同学坐在上面**(索引从0开始,所以0索引代表着1号座位),那我们就将现在坐在1上的同学调到其应该去的座位上(若该同学学号在1-n内的话)**,如此循环直到将2号同学调过来为止 , 若把1-n之外的学号调过来了就向后遍历,**因为2号有可能没来,也有可能没被我们调遣到,**若是后面那个可能性,我们向后遍历总会遇到2号
- 示例中会给出重复的数字,也就是会有重复学号的同学。 那么我们在判断时就不应该判断当前座位和当前学生的学号是否相同,而应该判断当前学生对应的正确座位上是否已经坐了人(可能是学号相同的人坐了)
-
例子
为方便描述思路,假设数组的下标是从 1 开始的。
假设 nums=[2,3,1]。
从 nums[1] 开始。这个座位上的学生,学号是 2,他应当坐在 nums[2] 上,所以他和 nums[2] 交换。交换后 nums=[3,2,1]。 仍然看 nums[1],这个座位上的学生,学号是 3,他应当坐在 nums[3] 上,所以他和 nums[3] 交换。交换后 nums=[1,2,3]。 仍然看 nums[1],这个座位上的学生,学号是 1,他坐在正确的座位上。 向后遍历,nums[2]=2,他坐在正确的座位上。 向后遍历,nums[3]=3,他坐在正确的座位上。 换座位过程结束。 再次遍历 nums,发现 nums[i]=i 都满足,说明数组中 1,2,3 都有,所以缺失的第一个正数是 4。
-
代码
class Solution {public int firstMissingPositive(int[] nums) {int n = nums.length;for(int i = 0;i<n;i++){//若当前标号在[1,n]中但是并没有在正确的位置上// nums[nums[i] - 1] != nums[i]表示当前数字的正确位置上是否已经被成功匹配(防止重复数字的出现导致死循环)while(nums[i]>=1 && nums[i]<=n && nums[nums[i] - 1] != nums[i]){int index = nums[i] - 1;//当前数字应该在的位置int temp = nums[i];nums[i] = nums[index];nums[index] = temp;}}for(int i = 0;i<n;i++){if(nums[i] != i+1){return i+1;}}return n+1;}}
矩阵
73. 矩阵置零
-
题目
给定一个
*m* x *n*的矩阵,如果一个元素为 0 ,则将其所在行和列的所有元素都设为 0 。请使用 原地 算法**。**示例 1:
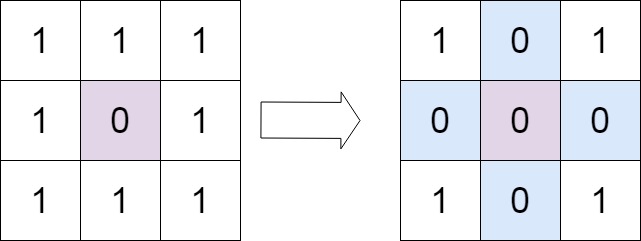 输入:matrix = [[1,1,1],[1,0,1],[1,1,1]]输出:[[1,0,1],[0,0,0],[1,0,1]]
示例 2:
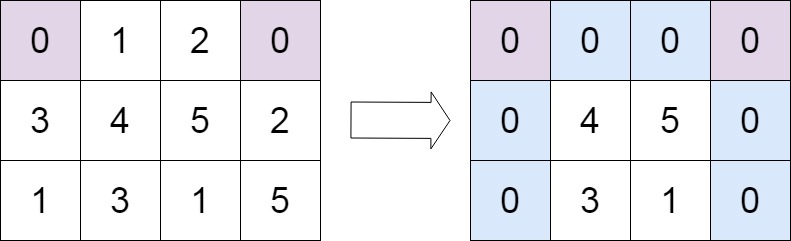 输入:matrix = [[0,1,2,0],[3,4,5,2],[1,3,1,5]]输出:[[0,0,0,0],[0,4,5,0],[0,3,1,0]]
提示:
m == matrix.lengthn == matrix[0].length1 <= m, n <= 200-231 <= matrix[i][j] <= 231 - 1
-
思路
两次遍历整个二维数组,第一次标记哪些行、列应该被修改第二次根据第一次的标记去修改
-
代码
class Solution {public void setZeroes(int[][] matrix) {int n = matrix[0].length;int m = matrix.length;boolean[] row_flag = new boolean[m];boolean[] col_flag = new boolean[n];for(int i = 0;i<m;i++){for(int j = 0;j<n;j++){if(matrix[i][j]==0){row_flag[i] = true;col_flag[j] = true;}}}for(int i = 0;i<m;i++){for(int j = 0;j<n;j++){if(row_flag[i] || col_flag[j]){matrix[i][j] = 0;}}}}}
54. 螺旋矩阵
-
题目
给你一个
m行n列的矩阵matrix,请按照 顺时针螺旋顺序 ,返回矩阵中的所有元素。示例 1:
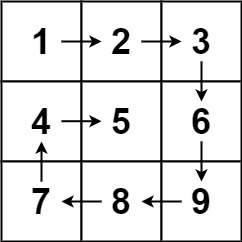 输入:matrix = [[1,2,3],[4,5,6],[7,8,9]]输出:[1,2,3,6,9,8,7,4,5]
示例 2:
 输入:matrix = [[1,2,3,4],[5,6,7,8],[9,10,11,12]]输出:[1,2,3,4,8,12,11,10,9,5,6,7]
提示:
m == matrix.lengthn == matrix[i].length1 <= m, n <= 10-100 <= matrix[i][j] <= 100
-
思路: 本质可以用递归去解,但此处为了降低时间复杂度使用模拟法解决。
类似于递归走迷宫,但此处的走法有迹可循 — 遵循右下左上,越界了就换方向
-
代码
下面解法中还可以对空间进行优化:不额外开辟一个loop数组记录有无走过,而是在原地图上修改,将走过的路修改为一个不太可能出现的值进行区分有无走过
class Solution {//上下左右private static final int[][] dir = {{0,1},{1,0},{0,-1},{-1,0}};public List<Integer> spiralOrder(int[][] matrix) {List<Integer> ans = new ArrayList<>();int m = matrix.length;int n = matrix[0].length;int cur_row = 0;int cur_col = 0;//控制行进状态int status = 0;//记录是否走过boolean[][] loop = new boolean[m][n];while(ans.size()<m*n){if(!loop[cur_row][cur_col]){ans.add(matrix[cur_row][cur_col]);loop[cur_row][cur_col] = true;}int nx = cur_row + dir[status][0];int ny = cur_col + dir[status][1];//判断是否越界//若没越界则更新cur_row 和 cur_colif(nx>=0 && nx<m && ny>=0 && ny<n && !loop[nx][ny]){cur_row = nx;cur_col = ny;}//越界则更换方向else{status = (status+1)%4;}}return ans;}}
48. 旋转图像
-
题目
给定一个 n × n 的二维矩阵
matrix表示一个图像。请你将图像顺时针旋转 90 度。你必须在** 原地** 旋转图像,这意味着你需要直接修改输入的二维矩阵。请不要 使用另一个矩阵来旋转图像。
示例 1:
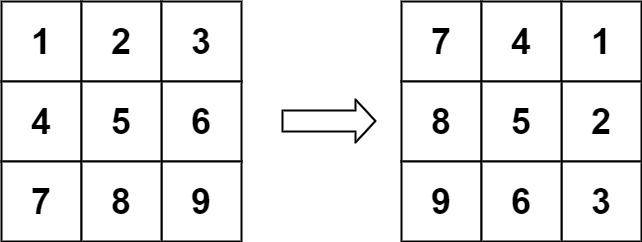 输入:matrix = [[1,2,3],[4,5,6],[7,8,9]]输出:[[7,4,1],[8,5,2],[9,6,3]]
示例 2:
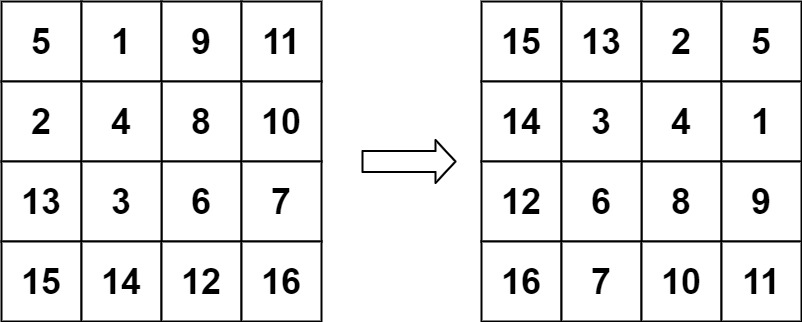 输入:matrix = [[5,1,9,11],[2,4,8,10],[13,3,6,7],[15,14,12,16]]输出:[[15,13,2,5],[14,3,4,1],[12,6,8,9],[16,7,10,11]]
提示:
n == matrix.length == matrix[i].length1 <= n <= 20-1000 <= matrix[i][j] <= 1000
-
思路: 本质数学题。 坐标为 的索引在转换后就变为了
为简化思考我们将其分为两步
两步分别对应着转置矩阵、将矩阵根据轴对称转换 都只需要O(1)的空间复杂度
-
代码
class Solution {public void rotate(int[][] matrix) {int n = matrix.length;//[i][j] --> [j][n-1-i]//[i][j] --> [j][i] 转置for(int i = 0;i<n;i++){for(int j = 0;j<i;j++){int temp = matrix[i][j];matrix[i][j] = matrix[j][i];matrix[j][i] = temp;}}//[j][i] --> [j][n-1-i] 对每行进行轴对称变化//此处为了方便理解,ij的命名与公式中一致for(int j = 0;j<n;j++){for(int i = 0;i<n/2;i++){int temp = matrix[j][i];matrix[j][i] = matrix[j][n-1-i];matrix[j][n-1-i] = temp;}}}}
240. 搜索二维矩阵 II
-
题目
编写一个高效的算法来搜索
*m* x *n*矩阵matrix中的一个目标值target。该矩阵具有以下特性:- 每行的元素从左到右升序排列。
- 每列的元素从上到下升序排列。
示例 1:
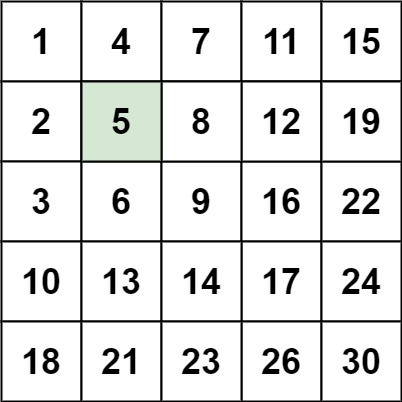 输入:matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 5输出:true
示例 2:
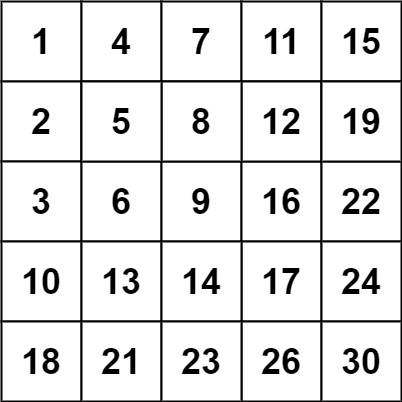 输入:matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 20输出:false
提示:
m == matrix.lengthn == matrix[i].length1 <= n, m <= 300-109 <= matrix[i][j] <= 109- 每行的所有元素从左到右升序排列
- 每列的所有元素从上到下升序排列
-109 <= target <= 109
-
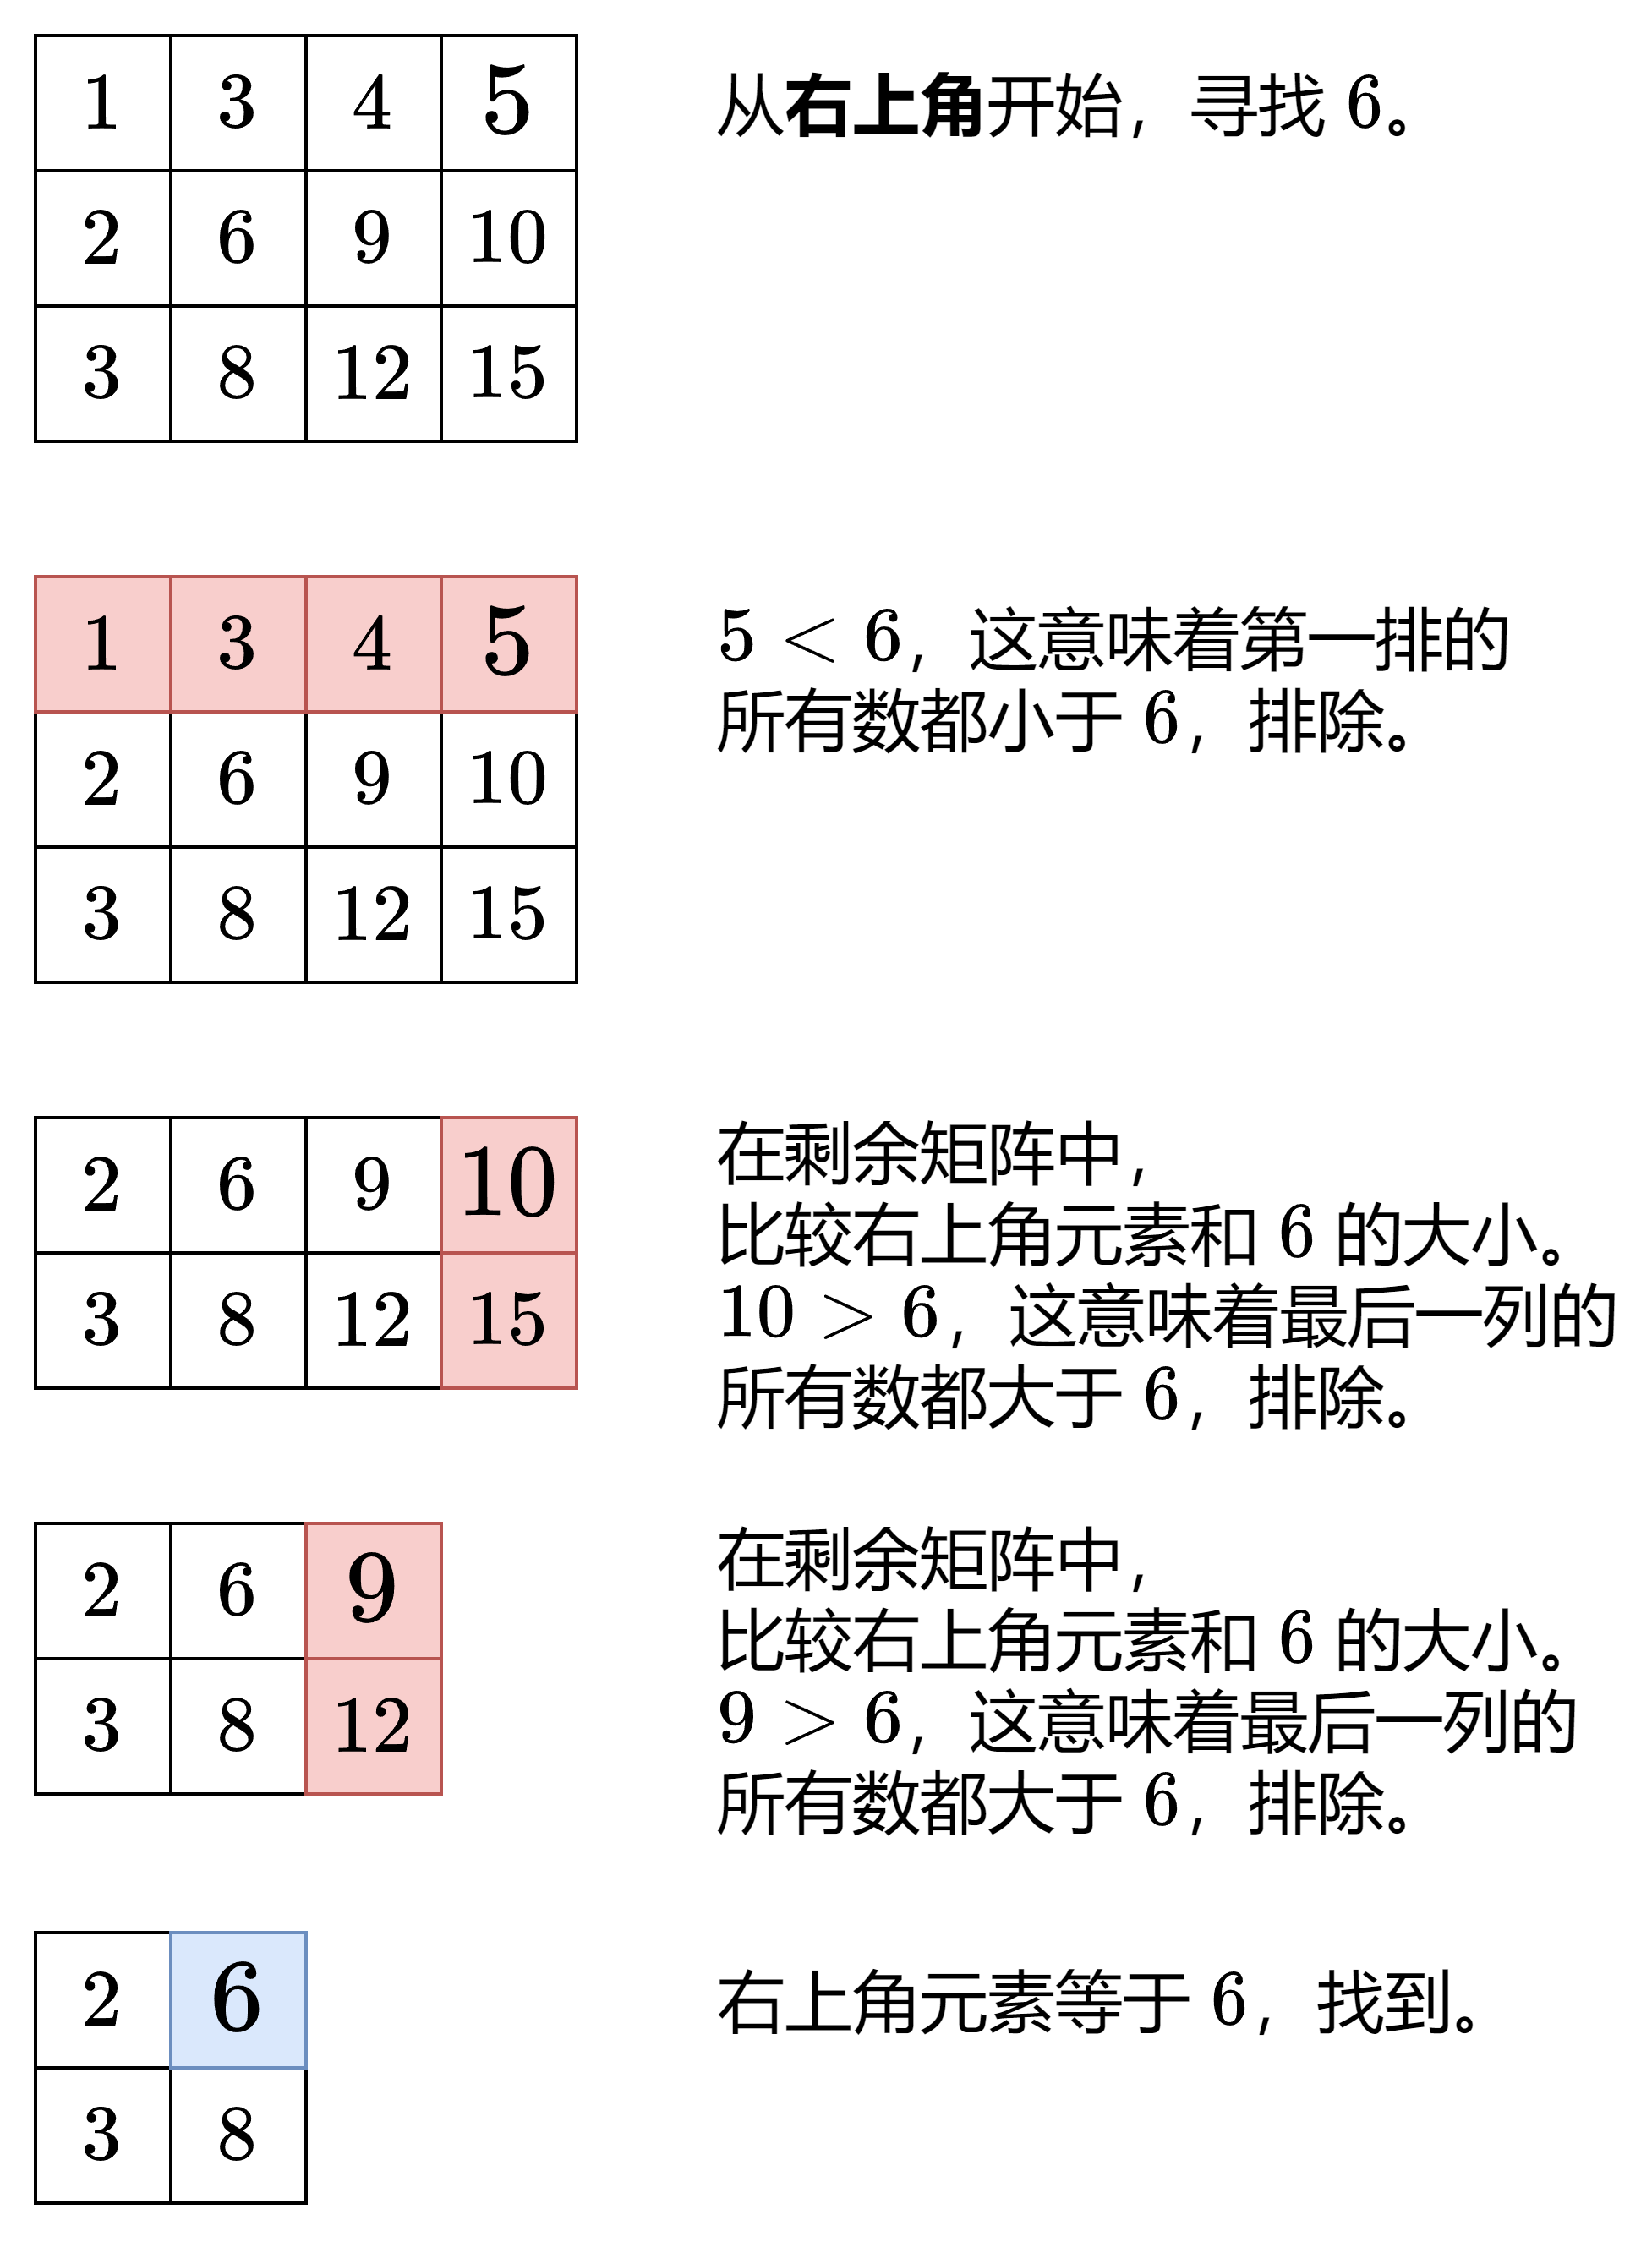
思路:矩阵中最右上角 / 最左下角的数字蕴含的信息是最多的。以最右上角举例:同行数字全都小于它、同列数字全都大于它 如此一来我们就可以用O(1)的比较获取O(n)的信息。若target小于它说明这一列都没有可能了、若target大于它说明这一行都没可能了
-
图解
-
-
代码
class Solution {public boolean searchMatrix(int[][] matrix, int target) {int i = 0;int j = matrix[0].length - 1; // 从右上角开始while (i < matrix.length && j >= 0) { // 还有剩余元素if (matrix[i][j] == target) {return true; // 找到 target}if (matrix[i][j] < target) {i++; // 这一行剩余元素全部小于 target,排除} else {j--; // 这一列剩余元素全部大于 target,排除}}return false;}}
链表
160. 相交链表
-
题目
给你两个单链表的头节点
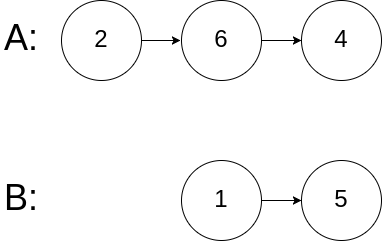
headA和headB,请你找出并返回两个单链表相交的起始节点。如果两个链表不存在相交节点,返回null。图示两个链表在节点
c1开始相交**:**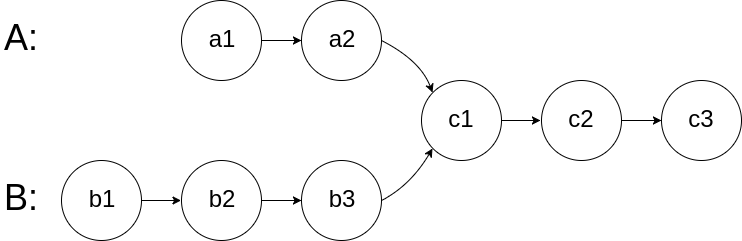
题目数据 保证 整个链式结构中不存在环。
注意,函数返回结果后,链表必须 保持其原始结构 。
自定义评测:
评测系统 的输入如下(你设计的程序 不适用 此输入):
intersectVal- 相交的起始节点的值。如果不存在相交节点,这一值为0listA- 第一个链表listB- 第二个链表skipA- 在listA中(从头节点开始)跳到交叉节点的节点数skipB- 在listB中(从头节点开始)跳到交叉节点的节点数
评测系统将根据这些输入创建链式数据结构,并将两个头节点
headA和headB传递给你的程序。如果程序能够正确返回相交节点,那么你的解决方案将被 视作正确答案 。示例 1:
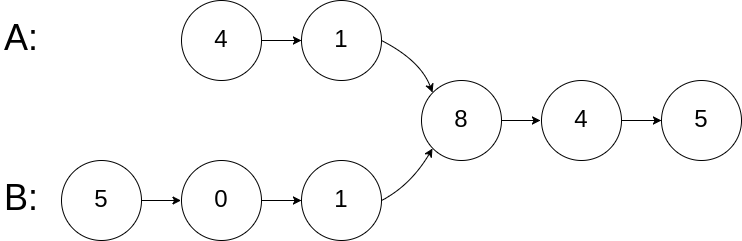
 输入:intersectVal = 8, listA = [4,1,8,4,5], listB = [5,6,1,8,4,5], skipA = 2, skipB = 3输出:Intersected at '8'解释:相交节点的值为 8 (注意,如果两个链表相交则不能为 0)。从各自的表头开始算起,链表 A 为 [4,1,8,4,5],链表 B 为 [5,6,1,8,4,5]。在 A 中,相交节点前有 2 个节点;在 B 中,相交节点前有 3 个节点。— 请注意相交节点的值不为 1,因为在链表 A 和链表 B 之中值为 1 的节点 (A 中第二个节点和 B 中第三个节点) 是不同的节点。换句话说,它们在内存中指向两个不同的位置,而链表 A 和链表 B 中值为 8 的节点 (A 中第三个节点,B 中第四个节点) 在内存中指向相同的位置。
示例 2:
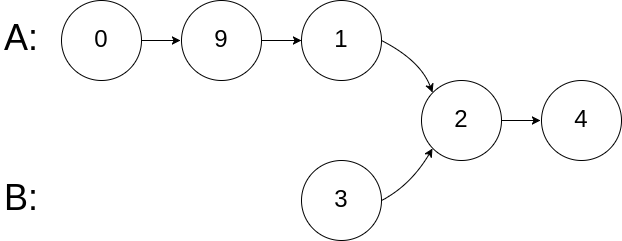
 输入:intersectVal = 2, listA = [1,9,1,2,4], listB = [3,2,4], skipA = 3, skipB = 1输出:Intersected at '2'解释:相交节点的值为 2 (注意,如果两个链表相交则不能为 0)。从各自的表头开始算起,链表 A 为 [1,9,1,2,4],链表 B 为 [3,2,4]。在 A 中,相交节点前有 3 个节点;在 B 中,相交节点前有 1 个节点。
示例 3:
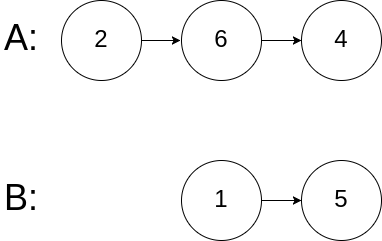 输入:intersectVal = 0, listA = [2,6,4], listB = [1,5], skipA = 3, skipB = 2输出:No intersection解释:从各自的表头开始算起,链表 A 为 [2,6,4],链表 B 为 [1,5]。由于这两个链表不相交,所以 intersectVal 必须为 0,而 skipA 和 skipB 可以是任意值。这两个链表不相交,因此返回 null 。
提示:
listA中节点数目为mlistB中节点数目为n1 <= m, n <= 3 * 1041 <= Node.val <= 1050 <= skipA <= m0 <= skipB <= n- 如果
listA和listB没有交点,intersectVal为0 - 如果
listA和listB有交点,intersectVal == listA[skipA] == listB[skipB]
-
思路
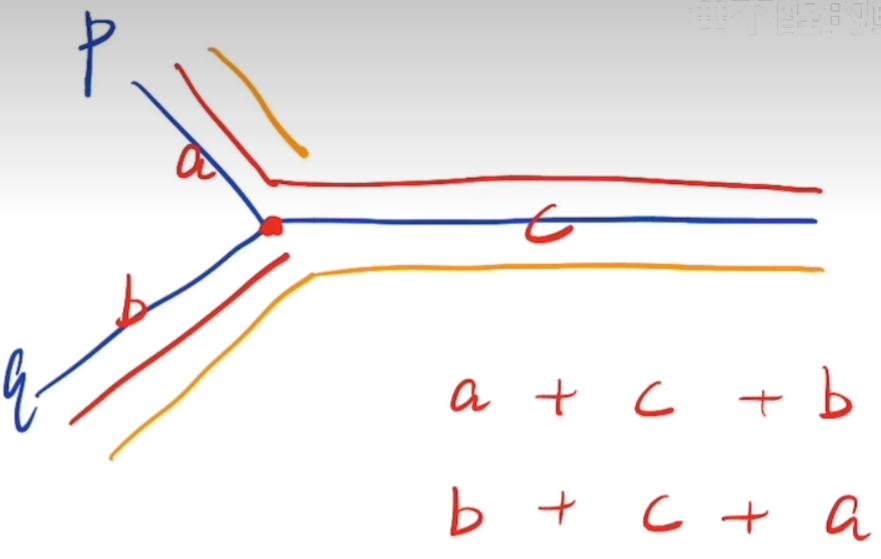
两个头结点p、q 每次走一格。当走各自的路走到头后换到另一方的路上走,
若存在交点则p、q走到交点所需的步数是一致的
若不存在交点,p、q走到null所需的步数也是一致的(两链表长度之和)、
-
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode(int x) {* val = x;* next = null;* }* }*/public class Solution {public ListNode getIntersectionNode(ListNode headA, ListNode headB) {ListNode p = headA;ListNode q = headB;while(p!=q){//由题目中的例1可知,从相交点开始都共用一个地址,所以此处判断地址是否相同p = p==null?headB:p.next;q = q==null?headA:q.next;}return p;}}
206. 反转链表
-
题目
给你单链表的头节点
head,请你反转链表,并返回反转后的链表。示例 1:
 输入:head = [1,2,3,4,5]输出:[5,4,3,2,1]
示例 2:
 输入:head = [1,2]输出:[2,1]
示例 3:
输入:head = []输出:[]提示:
- 链表中节点的数目范围是
[0, 5000] -5000 <= Node.val <= 5000
- 链表中节点的数目范围是
-
思路
pre指针、cur指针、next指针,从前向后遍历的同时完成链表的逆置

-
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode reverseList(ListNode head) {if(head==null){//特殊情况处理return null;}ListNode pre = null;ListNode cur = head;ListNode next = cur.next;while(next!=null){cur.next = pre;pre = cur;cur = next;next = next.next;}cur.next = pre;return cur;}}
234. 回文链表
-
题目
给你一个单链表的头节点
head,请你判断该链表是否为回文链表。如果是,返回true;否则,返回false。示例 1:
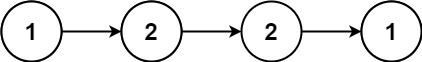 输入:head = [1,2,2,1]输出:true
示例 2:
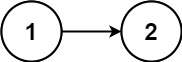 输入:head = [1,2]输出:false
提示:
- 链表中节点数目在范围
[1, 105]内 0 <= Node.val <= 9
- 链表中节点数目在范围
-
思路1
使用递归,将right指针递到最右边后再在归的过程中与left比较
-
代码1
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {private ListNode left;public boolean isPalindrome(ListNode head) {left = head;return isPal(head);}public boolean isPal(ListNode right){//【递】 将right移到链表末尾if(right.next!=null && !isPal(right.next)){return false;}//【归】的过程中若发现左右不一致说明不是回文链表if(left.val!=right.val){return false;}//归的过程中left不断向右走left = left.next;return true;}} -
思路2
找到链表结点(快慢指针)后将链表的后半部分逆置。逆置后两个指针(head1、head2)相向而行。判断是否为回文链表
-
代码2
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {private ListNode left;public boolean isPalindrome(ListNode head) {ListNode Midnode = MidNode(head);ListNode head2 = reverse(Midnode);while(head2!=null){if(head.val!=head2.val){return false;}head = head.next;head2 = head2.next;}return true;}//快慢指针找寻中间节点public ListNode MidNode(ListNode head){ListNode fast = head;ListNode slow = head;while(fast!=null&& fast.next!=null){fast = fast.next.next;slow = slow.next;}return slow;}//逆置链表public ListNode reverse(ListNode head){ListNode pre = null;ListNode cur = head;while(cur!=null){ListNode next = cur.next;cur.next = pre;pre = cur;cur = next;}return pre;}}
141. 环形链表
-
题目
给你一个链表的头节点
head,判断链表中是否有环。如果链表中有某个节点,可以通过连续跟踪
next指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数pos来表示链表尾连接到链表中的位置(索引从 0 开始)。注意:pos不作为参数进行传递 。仅仅是为了标识链表的实际情况。如果链表中存在环 ,则返回
true。 否则,返回false。示例 1:
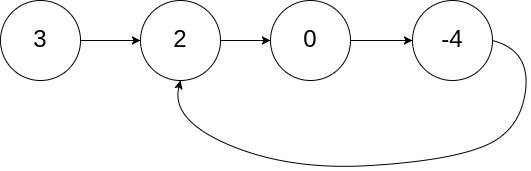 输入:head = [3,2,0,-4], pos = 1输出:true解释:链表中有一个环,其尾部连接到第二个节点。
示例 2:
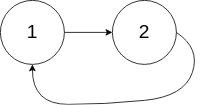 输入:head = [1,2], pos = 0输出:true解释:链表中有一个环,其尾部连接到第一个节点。
示例 3:
 输入:head = [1], pos = -1输出:false解释:链表中没有环。
提示:
- 链表中节点的数目范围是
[0, 104] -105 <= Node.val <= 105pos为-1或者链表中的一个 有效索引 。
- 链表中节点的数目范围是
-
思路
快慢指针。快指针一次走两格,慢指针一次走一格。若快慢指针相遇说明有环的存在
-
代码
/*** Definition for singly-linked list.* class ListNode {* int val;* ListNode next;* ListNode(int x) {* val = x;* next = null;* }* }*/public class Solution {public boolean hasCycle(ListNode head) {ListNode fast = head;ListNode slow = head;while(fast!=null && fast.next!=null){fast = fast.next.next;slow = slow.next;if(fast==slow){return true;}}return false;}}
142. 环形链表 II
-
题目
给定一个链表的头节点
head,返回链表开始入环的第一个节点。 如果链表无环,则返回null。如果链表中有某个节点,可以通过连续跟踪
next指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数pos来表示链表尾连接到链表中的位置(索引从 0 开始)。如果pos是-1,则在该链表中没有环。注意:pos不作为参数进行传递,仅仅是为了标识链表的实际情况。不允许修改 链表。
示例 1:
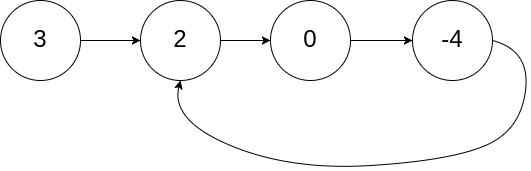 输入:head = [3,2,0,-4], pos = 1输出:返回索引为 1 的链表节点解释:链表中有一个环,其尾部连接到第二个节点。
示例 2:
输入:head = [1,2], pos = 0输出:返回索引为 0 的链表节点解释:链表中有一个环,其尾部连接到第一个节点。示例 3:
输入:head = [1], pos = -1输出:返回 null解释:链表中没有环。提示:
- 链表中节点的数目范围在范围
[0, 104]内 -105 <= Node.val <= 105pos的值为-1或者链表中的一个有效索引
- 链表中节点的数目范围在范围
-
思路
弗洛伊德判圈法
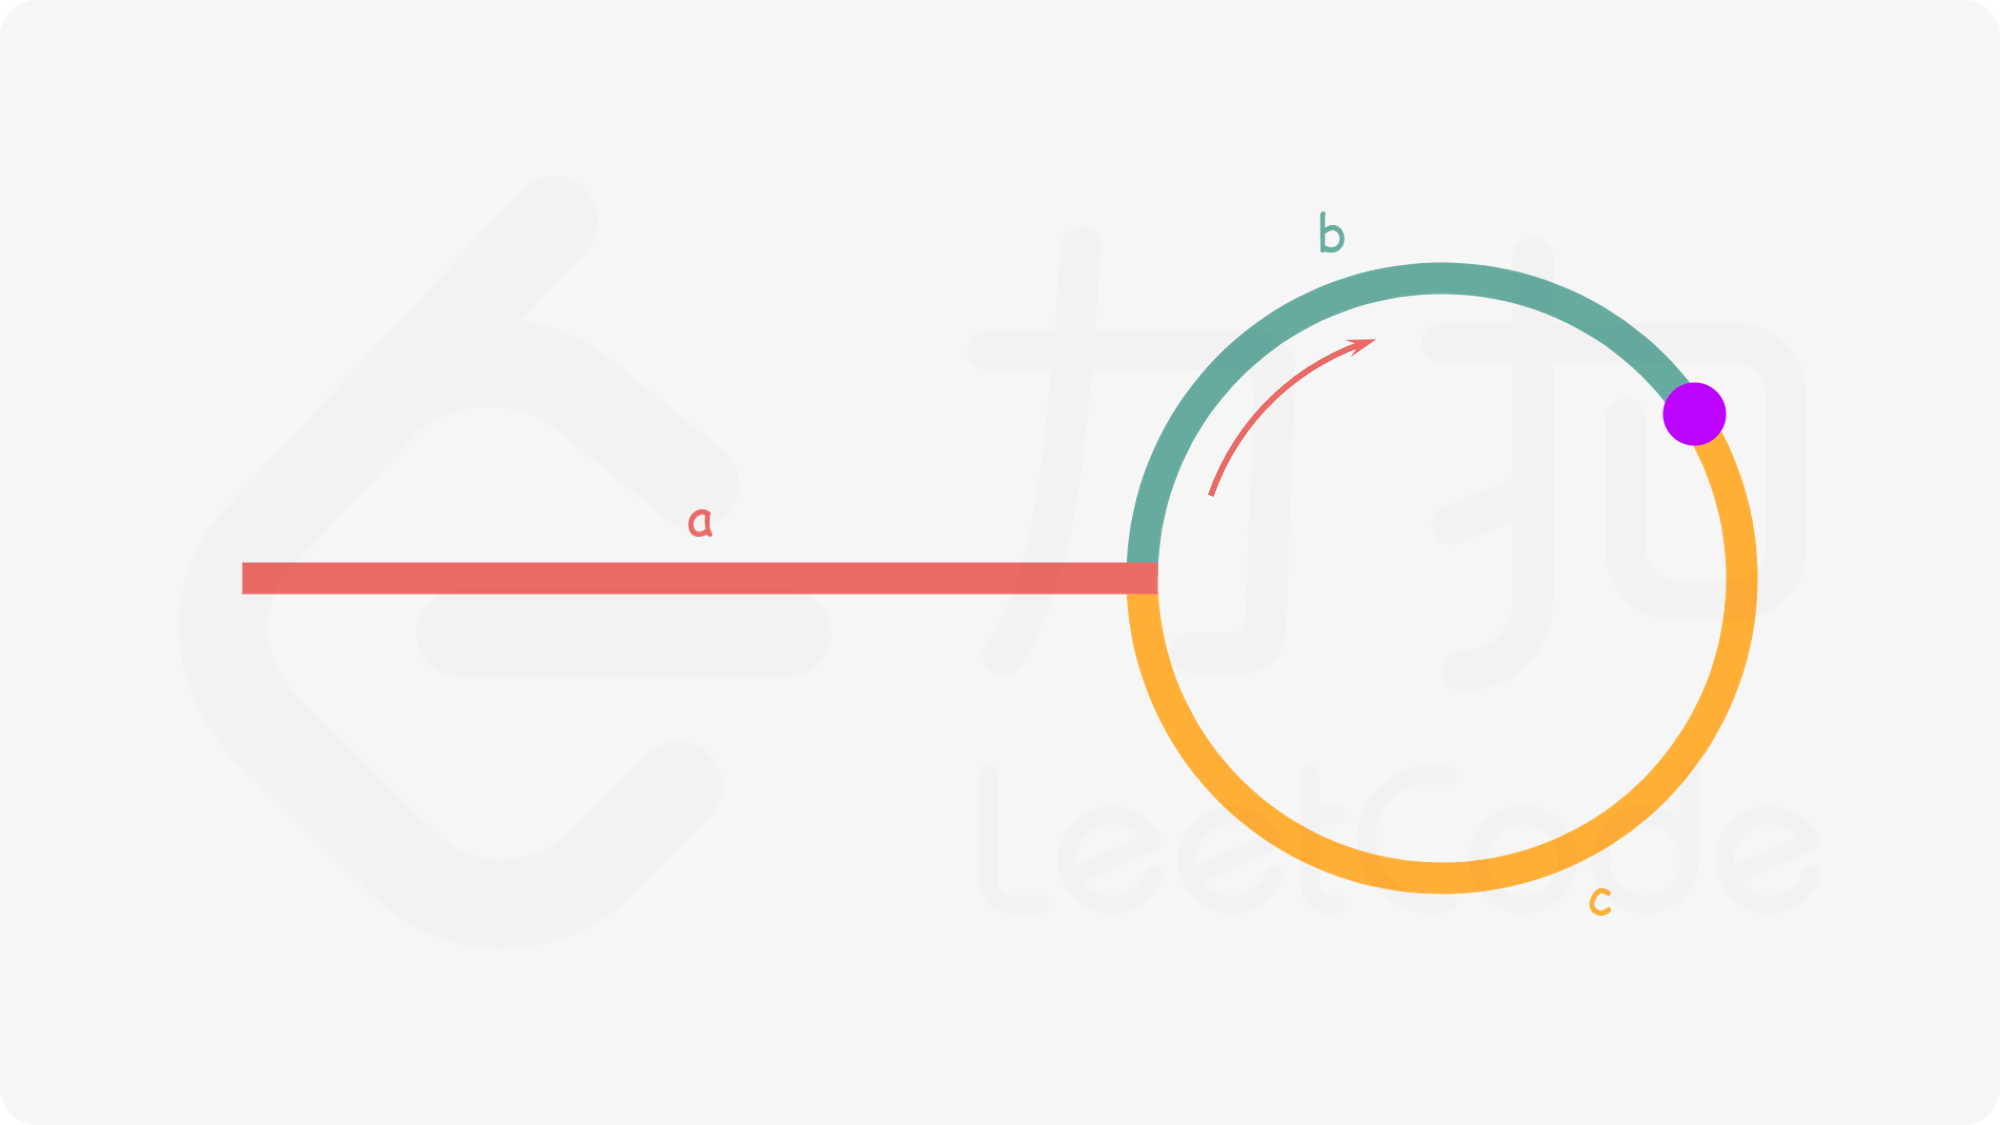
如上图。使用快慢指针法可以找到有环(设紫色点为相遇点)
此时慢指针走了 快指针走了 也可以表示为 二者之差为 也为
所以可以列出等式: 变形可得
可以看出,若我们从出发点与紫色相遇点各放一个指针,每次走一格,那么必定会在环的起点处相遇
-
代码
/*** Definition for singly-linked list.* class ListNode {* int val;* ListNode next;* ListNode(int x) {* val = x;* next = null;* }* }*/public class Solution {public ListNode detectCycle(ListNode head) {ListNode fast = head;ListNode slow = head;while(fast!=null && fast.next!=null){fast = fast.next.next;slow = slow.next;//相遇,说明有环if(fast==slow){//从起点开始的指针,开始找环的起点ListNode temp = head;while(temp!=slow){temp = temp.next;slow = slow.next;}return slow;}}return null;}}
21. 合并两个有序链表
-
题目
将两个升序链表合并为一个新的 升序 链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的。
示例 1:
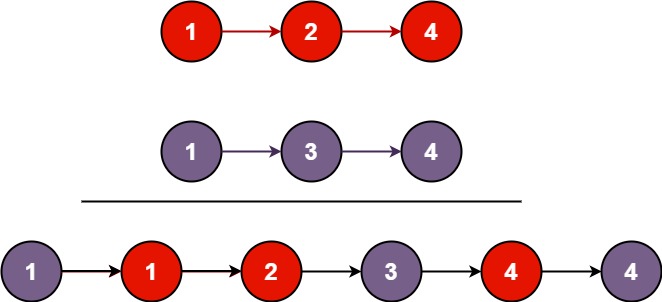 输入:l1 = [1,2,4], l2 = [1,3,4]输出:[1,1,2,3,4,4]
示例 2:
输入:l1 = [], l2 = []输出:[]示例 3:
输入:l1 = [], l2 = [0]输出:[0]提示:
- 两个链表的节点数目范围是
[0, 50] -100 <= Node.val <= 100l1和l2均按 非递减顺序 排列
- 两个链表的节点数目范围是
-
思路
本质merge
-
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode mergeTwoLists(ListNode list1, ListNode list2) {//答案头结点ListNode ans = new ListNode();//merge过程中的temp指针ListNode temp = ans;while(list1!=null && list2!=null){if(list1.val<list2.val){temp.next = list1;list1 = list1.next;}else{temp.next = list2;list2 = list2.next;}temp = temp.next;}//补全while(list1!=null){temp.next = list1;list1 = list1.next;temp = temp.next;}while(list2!=null){temp.next = list2;list2 = list2.next;temp = temp.next;}//返回头结点.nextreturn ans.next;}}
2. 两数相加
-
题目
给你两个 非空 的链表,表示两个非负的整数。它们每位数字都是按照 逆序 的方式存储的,并且每个节点只能存储 一位 数字。
请你将两个数相加,并以相同形式返回一个表示和的链表。
你可以假设除了数字 0 之外,这两个数都不会以 0 开头。
示例 1:
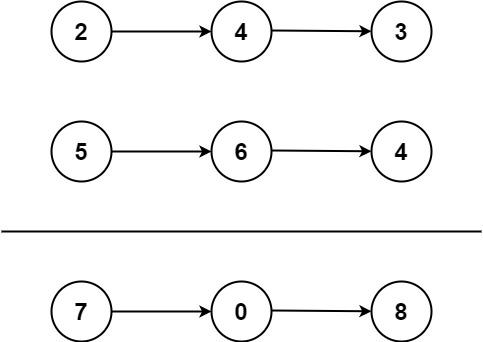 输入:l1 = [2,4,3], l2 = [5,6,4]输出:[7,0,8]解释:342 + 465 = 807.
示例 2:
输入:l1 = [0], l2 = [0]输出:[0]示例 3:
输入:l1 = [9,9,9,9,9,9,9], l2 = [9,9,9,9]输出:[8,9,9,9,0,0,0,1]提示:
- 每个链表中的节点数在范围
[1, 100]内 0 <= Node.val <= 9- 题目数据保证列表表示的数字不含前导零
- 每个链表中的节点数在范围
-
思路
大数加法,用一个变量记录进位,随后双指针,过程类似归并(若两个数位数不同会有剩余,要将剩余的数再存入新链表)
-
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode addTwoNumbers(ListNode l1, ListNode l2) {//头结点ListNode head = new ListNode();ListNode idx = head;int up = 0;//用于进位while(l1!=null && l2!=null){int sum = l1.val+l2.val+up;l1=l1.next;l2=l2.next;//当前位结果int cur_res = sum%10;//下一位的进位up = sum/10;//存储ListNode newNode = new ListNode(cur_res);idx.next = newNode;//插入idx = idx.next;}//处理剩余位数while(l1!=null){int sum = l1.val+up;int cur_res = sum%10;up = sum/10;ListNode newNode = new ListNode(cur_res);idx.next = newNode;idx = idx.next;l1 = l1.next;}while(l2!=null){int sum = l2.val+up;int cur_res = sum%10;up = sum/10;ListNode newNode = new ListNode(cur_res);idx.next = newNode;idx = idx.next;l2 = l2.next;}if(up!=0){ListNode newNode = new ListNode(up);idx.next = newNode;idx = idx.next;}return head.next;}}
19. 删除链表的倒数第 N 个结点
-
题目
给你一个链表,删除链表的倒数第
n个结点,并且返回链表的头结点。示例 1:
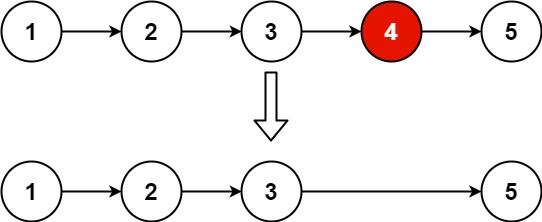 输入:head = [1,2,3,4,5], n = 2输出:[1,2,3,5]
示例 2:
输入:head = [1], n = 1输出:[]示例 3:
输入:head = [1,2], n = 1输出:[1]提示:
- 链表中结点的数目为
sz 1 <= sz <= 300 <= Node.val <= 1001 <= n <= sz
- 链表中结点的数目为
-
思路
双指针,left、right left置于起始位置,right置于整数第n个位置。当right移到链表末尾时left就指向倒数第n个位置了 — 为方便实现(头结点也有可能被删除)所以添加一个哨兵结点(专用头结点)
-
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode removeNthFromEnd(ListNode head, int n) {//添加哨兵(专用头结点)ListNode dummy = new ListNode(0,head);ListNode left = dummy;ListNode right = dummy;//将right置于正数第n个位置for(int i = 0;i<=n;i++){right = right.next;}//left、right一起前进while(right!=null){left = left.next;right = right.next;}left.next = left.next.next;return dummy.next;}}
24. 两两交换链表中的节点
-
题目
给你一个链表,两两交换其中相邻的节点,并返回交换后链表的头节点。你必须在不修改节点内部的值的情况下完成本题(即,只能进行节点交换)。
示例 1:
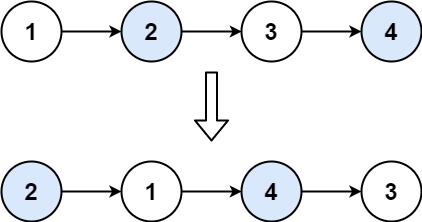 输入:head = [1,2,3,4]输出:[2,1,4,3]
示例 2:
输入:head = []输出:[]示例 3:
输入:head = [1]输出:[1]提示:
- 链表中节点的数目在范围
[0, 100]内 0 <= Node.val <= 100
- 链表中节点的数目在范围
-
思路

-
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode swapPairs(ListNode head) {ListNode dummy = new ListNode(0,head);ListNode node0 = dummy;ListNode node1 = head;//需要操作的为node1和node1.next 所以这两个不为null即可。//node3为null没事 直接接上nullwhile(node1!=null && node1.next!=null){ListNode node2 = node1.next;ListNode node3 = node2.next;//0->1->2->3->4node0.next = node2;node2.next = node1;node1.next = node3;//0->2->1->3->4//1、2交换成功后交换3、4node0 = node1;node1 = node3;}return dummy.next;}}
25. K 个一组翻转链表
-
题目
给你链表的头节点
head,每k个节点一组进行翻转,请你返回修改后的链表。k是一个正整数,它的值小于或等于链表的长度。如果节点总数不是k的整数倍,那么请将最后剩余的节点保持原有顺序。你不能只是单纯的改变节点内部的值,而是需要实际进行节点交换。
示例 1:
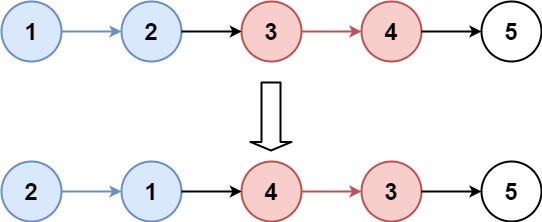 输入:head = [1,2,3,4,5], k = 2输出:[2,1,4,3,5]
示例 2:
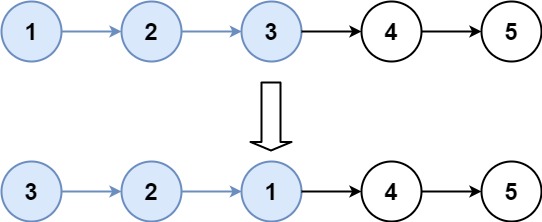 输入:head = [1,2,3,4,5], k = 3输出:[3,2,1,4,5]
提示:
- 链表中的节点数目为
n 1 <= k <= n <= 50000 <= Node.val <= 1000
- 链表中的节点数目为
-
思路
- 求长度
- 对部分反转并减去长度(若长度不足则不进行反转操作)
部分反转的细节:
-
初始状态:0、1、2、4 k=2
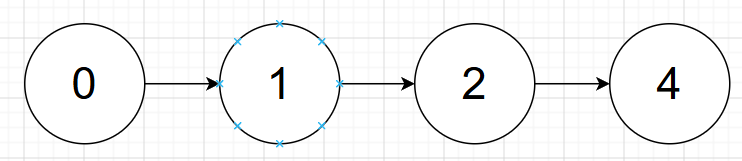
-
反转部分(反转1、2)后
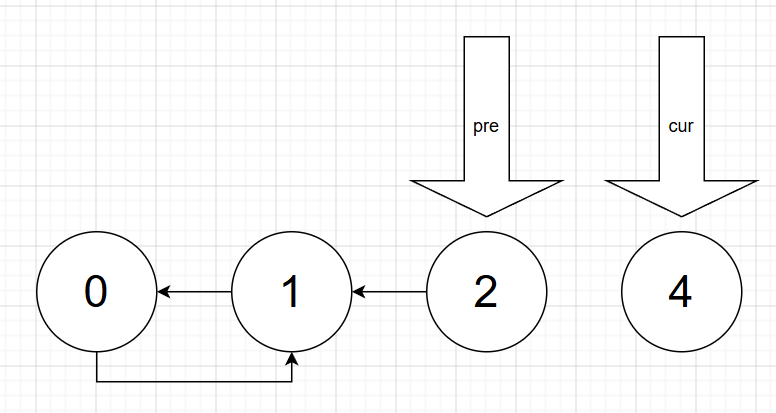
-
最终状态
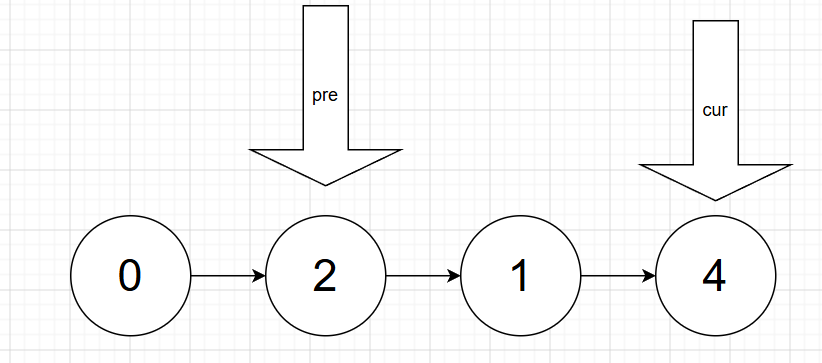
对比可知,node0 .next= pre node1.next =node4
最终需要返回node1(下一次反转的pre)
-
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode reverseKGroup(ListNode head, int k) {int length = 0;ListNode temp = head;while(temp!=null){temp = temp.next;length++;}//哨兵结点,方便操作ListNode dummy = new ListNode(0,head);ListNode pre = dummy;ListNode cur = head;while(length>=k){System.out.println(pre.val);pre = reverse(pre,cur,k);cur = pre.next;length-=k;}return dummy.next;}public ListNode reverse(ListNode pre,ListNode cur,int k){int count = 0;//记录初始pre、cur位置ListNode node0 = pre;ListNode node1 = cur;while(count<k){ListNode next = cur.next;cur.next = pre;pre = cur;cur = next;count++;}//k=2//0->1->2->3 0<-> 1 <- 2 3 cur:3 pre:2node0.next = pre;node1.next = cur;//0->2->1->3 cur:3 pre:2//返回用于更新pre和curreturn node1;}}
138. 随机链表的复制
-
题目
给你一个长度为
n的链表,每个节点包含一个额外增加的随机指针random,该指针可以指向链表中的任何节点或空节点。构造这个链表的 深拷贝。 深拷贝应该正好由
n个 全新 节点组成,其中每个新节点的值都设为其对应的原节点的值。新节点的next指针和random指针也都应指向复制链表中的新节点,并使原链表和复制链表中的这些指针能够表示相同的链表状态。复制链表中的指针都不应指向原链表中的节点 。例如,如果原链表中有
X和Y两个节点,其中X.random --> Y。那么在复制链表中对应的两个节点x和y,同样有x.random --> y。返回复制链表的头节点。
用一个由
n个节点组成的链表来表示输入/输出中的链表。每个节点用一个[val, random_index]表示:val:一个表示Node.val的整数。random_index:随机指针指向的节点索引(范围从0到n-1);如果不指向任何节点,则为null。
你的代码 只 接受原链表的头节点
head作为传入参数。示例 1:
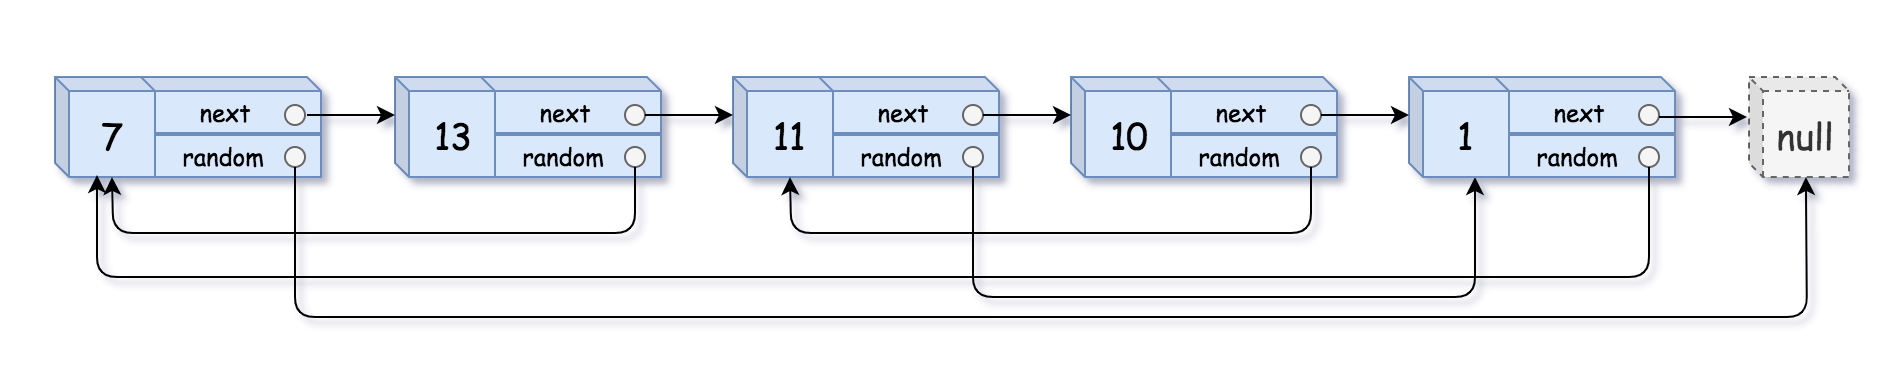 输入:head = [[7,null],[13,0],[11,4],[10,2],[1,0]]输出:[[7,null],[13,0],[11,4],[10,2],[1,0]]
示例 2:
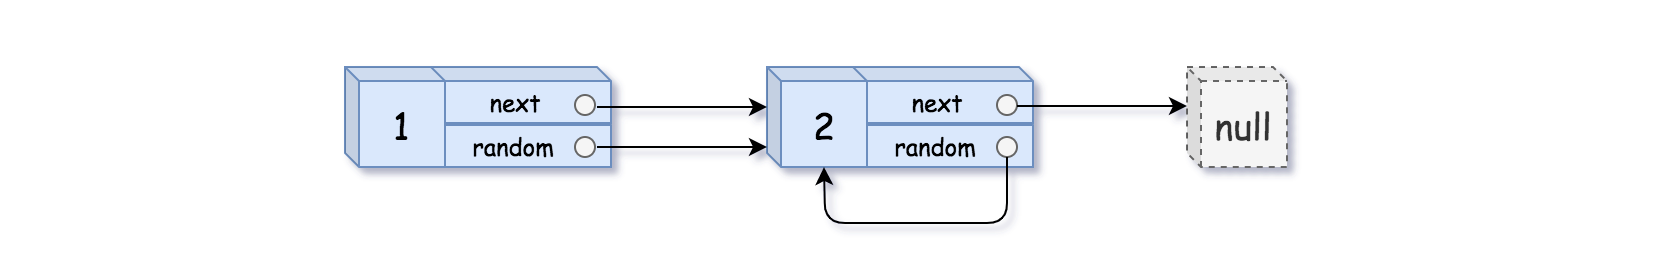 输入:head = [[1,1],[2,1]]输出:[[1,1],[2,1]]
示例 3:
 输入:head = [[3,null],[3,0],[3,null]]输出:[[3,null],[3,0],[3,null]]
提示:
0 <= n <= 1000-104 <= Node.val <= 104Node.random为null或指向链表中的节点。
-
思路
题目的难点在于对于random关系的深拷贝 ,若只对next关系进行深拷贝只要遍历即可。但是random关系的指向是没有顺序的,也就是说我们无法直接找到random所对应的结点地址
解决思路:使用哈希表来记录新旧链表之间的映射关系,在构建好最基本的next关系后再遍历一遍寻找random关系在新链表中的映射
优化思路:可以不使用hash表进行映射关系的记录,而是直接在旧链表每个结点后复制一个相同的结点作为新链表结点,直接通过旧链表的结点位置去映射新链表的结点位置,进行空间上的优化
例如链表 1→2→3,依次复制每个节点(创建新节点并复制 val 和 next),把新节点直接插到原节点的后面,形成一个交错链表:
1→1 ′ →2→2 ′ →3→3 ′
如此一来,原链表节点的下一个节点,就是其对应的新链表节点了!
然后遍历这个交错链表,假如节点 1 的 random 指向节点 3,那么就把新节点 1 ′ 的 random 指向节点 3 的下一个节点 3 ′ ,这样就完成了对 random 指针的复制。最后,从交错链表中分离出 1 ′→2 ′→3 ′ ,即为深拷贝后的链表。
-
代码
/*// Definition for a Node.class Node {int val;Node next;Node random;public Node(int val) {this.val = val;this.next = null;this.random = null;}}*/class Solution {public Node copyRandomList(Node head) {//哈希表,用于记录新旧链表之间的映射关系HashMap<Node,Node> map = new HashMap<>();Node temp = head;Node dummy = new Node(0);Node cur = dummy;//构建新链表的next关系并存储新旧链表的映射关系while(temp!=null){Node newNode = new Node(temp.val);cur.next = newNode;cur = cur.next;map.put(temp,cur);temp = temp.next;}temp = head;cur = dummy.next;//哨兵结点,方便插入操作//构建新链表的random关系while(temp!=null){//找到新链表中对应的random指向Node r = temp.random;Node nr = map.get(r);cur.random = nr;cur = cur.next;temp = temp.next;}return dummy.next;}}优化版本
/*// Definition for a Node.class Node {int val;Node next;Node random;public Node(int val) {this.val = val;this.next = null;this.random = null;}}*/class Solution {public Node copyRandomList(Node head) {//构建交叉链表//由于插入后会多一个所以一次跳两个结点//如: 1-2-3 1-2-2’-3 需跳过2’到3for(Node temp = head;temp!=null;temp = temp.next.next){Node newNode = new Node(temp.val);newNode.next = temp.next;temp.next = newNode;}//构建random关系//cur永远指向旧链表结点for(Node cur = head;cur!=null;cur = cur.next.next){//cur永远指向旧链表结点,所以cur.random也是旧链表结点//同理cur.next永远是新链表结点,映射到cur.random.nextif(cur.random!=null){cur.next.random = cur.random.next;}}//抽离新链表Node dummy = new Node(0);Node temp = dummy;//此时因为新链表会被抽离出去,所以一次只要跳一个结点即可//1-2-2’-3-3’ 1-2-3-3’for(Node cur = head;cur!=null;cur = cur.next,temp = temp.next){Node newNode = cur.next;//新链表的结点temp.next = newNode;//还原旧链表cur.next = newNode.next;}return dummy.next;}}
148. 排序链表
-
题目
给你链表的头结点
head,请将其按 升序 排列并返回 排序后的链表 。示例 1:
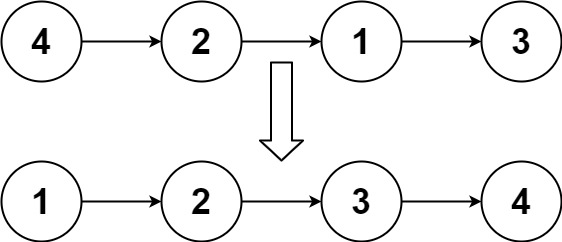 输入:head = [4,2,1,3]输出:[1,2,3,4]
示例 2:
 输入:head = [-1,5,3,4,0]输出:[-1,0,3,4,5]
示例 3:
输入:head = []输出:[]提示:
- 链表中节点的数目在范围
[0, 5 * 104]内 -105 <= Node.val <= 105
- 链表中节点的数目在范围
-
思路
链表的归并排序 时间复杂度O(nlog
n) -
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode sortList(ListNode head) {//二分链表,若链表为空或链表只有一个元素,无需合并,返回if(head==null||head.next==null){return head;}//找到中间节点ListNode mid = findMid(head);//递归拆分链表//返回值需要接收:此递归函数是值传递,若不接收递归修改后是不变的head = sortList(head);//左半部分mid = sortList(mid);//右半部分//归并return merge(head,mid);}//快慢指针找中间节点,并二分链表//如:1-2-3-4 --> 1-2 3-4private ListNode findMid(ListNode head){ListNode slow = head,fast = head,pre = head;while(fast!=null && fast.next!=null){pre = slow;//记录slow的前一个slow = slow.next;fast = fast.next.next;}//断开链表pre.next = null;return slow;}private ListNode merge(ListNode l1,ListNode l2){//哨兵结点简化操作ListNode dummy = new ListNode();ListNode cur = dummy;while(l1!=null && l2!=null){if(l1.val<l2.val){cur.next = l1;l1 = l1.next;}else{cur.next = l2;l2 = l2.next;}cur = cur.next;}if(l1!=null){cur.next = l1;}if(l2!=null){cur.next = l2;}return dummy.next;}}
23. 合并 K 个升序链表
-
题目
给你一个链表数组,每个链表都已经按升序排列。
请你将所有链表合并到一个升序链表中,返回合并后的链表。
示例 1:
输入:lists = [[1,4,5],[1,3,4],[2,6]]输出:[1,1,2,3,4,4,5,6]解释:链表数组如下:[1->4->5,1->3->4,2->6]将它们合并到一个有序链表中得到。1->1->2->3->4->4->5->6示例 2:
输入:lists = []输出:[]示例 3:
输入:lists = [[]]输出:[]提示:
k == lists.length0 <= k <= 10^40 <= lists[i].length <= 500-10^4 <= lists[i][j] <= 10^4lists[i]按 升序 排列lists[i].length的总和不超过10^4
-
思路
暴力解法:提供一个ans,遍历链表数组,将其中的每一个都和ans进行一个merge
优化思路:将数组内的链表两两进行merge
- 两两合并:把 lists[0] 和 lists[1] 合并,合并后的链表保存在 lists[0] 中;把 lists[2] 和 lists[3] 合并,合并后的链表保存在 lists[2] 中;
- 四四合并:把 lists[0] 和 lists[2] 合并(相当于合并前四条链表),合并后的链表保存在 lists[0] 中;把 lists[4] 和 lists[6] 合并,合并后的链表保存在 lists[4] 中;
- 八八合并:把 lists[0] 和 lists[4] 合并(相当于合并前八条链表),合并后的链表保存在 lists[0] 中;把 lists[8] 和 lists[12] 合并,合并后的链表保存在 lists[8] 中
- 依此类推,直到所有链表都合并到 lists[0] 中。最后返回 lists[0]。

-
代码
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode mergeKLists(ListNode[] lists) {//由于ans一直在参与merge过程所以若是ans中的值过大会导致其排在后面//此处设置一个很小的负值,确保其merge后都排在第一个,//这样返回ans.next就不会将其包括在内ListNode ans = new ListNode(-100000);for(int i =0;i<lists.length;i++){ListNode list = lists[i];ans = merge(ans,list);}return ans.next;}private ListNode merge(ListNode l1,ListNode l2){ListNode dummy = new ListNode();ListNode cur = dummy;while(l1!=null && l2!=null){if(l1.val<l2.val){cur.next = l1;l1 = l1.next;}else{cur.next = l2;l2 = l2.next;}cur = cur.next;}cur.next = l1!=null?l1:l2;return dummy.next;}}优化版本
/*** Definition for singly-linked list.* public class ListNode {* int val;* ListNode next;* ListNode() {}* ListNode(int val) { this.val = val; }* ListNode(int val, ListNode next) { this.val = val; this.next = next; }* }*/class Solution {public ListNode mergeKLists(ListNode[] lists) {int l = lists.length;if(l==0){return null;}for(int step = 1;step<l;step*=2){for(int i = 0;i<l-step;i+=step*2){lists[i] = merge(lists[i],lists[i+step]);}}return lists[0];}private ListNode merge(ListNode l1,ListNode l2){ListNode dummy = new ListNode();ListNode cur = dummy;while(l1!=null && l2!=null){if(l1.val<l2.val){cur.next = l1;l1 = l1.next;}else{cur.next = l2;l2 = l2.next;}cur = cur.next;}cur.next = l1!=null?l1:l2;return dummy.next;}}
146. LRU 缓存
-
题目
请你设计并实现一个满足 LRU (最近最少使用) 缓存 约束的数据结构。
实现
LRUCache类:LRUCache(int capacity)以 正整数 作为容量capacity初始化 LRU 缓存int get(int key)如果关键字key存在于缓存中,则返回关键字的值,否则返回-1。void put(int key, int value)如果关键字key已经存在,则变更其数据值value;如果不存在,则向缓存中插入该组key-value。如果插入操作导致关键字数量超过capacity,则应该 逐出 最久未使用的关键字。
函数
get和put必须以O(1)的平均时间复杂度运行。示例:
输入["LRUCache", "put", "put", "get", "put", "get", "put", "get", "get", "get"][[2], [1, 1], [2, 2], [1], [3, 3], [2], [4, 4], [1], [3], [4]]输出[null, null, null, 1, null, -1, null, -1, 3, 4]解释LRUCache lRUCache = new LRUCache(2);lRUCache.put(1, 1); // 缓存是 {1=1}lRUCache.put(2, 2); // 缓存是 {1=1, 2=2}lRUCache.get(1); // 返回 1lRUCache.put(3, 3); // 该操作会使得关键字 2 作废,缓存是 {1=1, 3=3}lRUCache.get(2); // 返回 -1 (未找到)lRUCache.put(4, 4); // 该操作会使得关键字 1 作废,缓存是 {4=4, 3=3}lRUCache.get(1); // 返回 -1 (未找到)lRUCache.get(3); // 返回 3lRUCache.get(4); // 返回 4提示:
1 <= capacity <= 30000 <= key <= 100000 <= value <= 105- 最多调用
2 * 105次get和put
-
解释:LRU(最近最少使用缓存策略),当查询某缓存时会将其放到链表头部,当插入数据量大于capacity的时候会将链表末尾的结点(最少使用的结点)删除
-
思路
使用双向链表+哈希表实现。双向链表保证了操作链表头、尾,以及链表中间节点的修改的时间复杂度为O(1) , 哈希表实现了查询数据时的时间复杂度为O(1)
-
代码
class LRUCache {//双向链表 每个结点都是一个键值对private static class Node{int key,val;Node pre,next;Node(int k,int v){key = k;val = v;}}//哨兵结点private final Node dummy = new Node(0,0);//容量private final int capacity;//哈希表,用于存储key对应的结点,从而实现O(1)的查找时间复杂度private final Map<Integer,Node> keyToNode = new HashMap<>();public LRUCache(int capacity) {//初始化容量this.capacity = capacity;//初始化链表dummy.pre = dummy;dummy.next = dummy;}//删除结点private void remove(Node node){node.pre.next = node.next;node.next.pre = node.pre;}//在链表头插入结点private void pushFront(Node node){node.pre = dummy;node.next = dummy.next;node.pre.next = node;node.next.pre = node;}//获取结点并将其插入到链表表头private Node getNode(int key){//哈希表中查找if(!keyToNode.containsKey(key)){//若不存在则返回空return null;}//存在则将结点插入表头并返回Node tar = keyToNode.get(key);remove(tar);pushFront(tar);return tar;}public int get(int key) {Node res = getNode(key);return res!=null?res.val:-1;}public void put(int key, int value) {//查看链表中是否已经有了Node node = getNode(key);if(node!=null){//已存在,更新值node.val = value;return;//结束方法}//若不存在,开始插入//查看哈希表尺寸,判断是否溢出if(keyToNode.size()==capacity){//若溢出则移除最后一个结点Node lastNode = dummy.pre;keyToNode.remove(lastNode.key);remove(lastNode);}//插入 (是否溢出都要插入,若溢出上面已经将其移除)Node newNode = new Node(key,value);pushFront(newNode);keyToNode.put(key,newNode);}}
二叉树
94. 二叉树的中序遍历
-
题目
给定一个二叉树的根节点
root,返回 它的 中序 遍历 。示例 1:
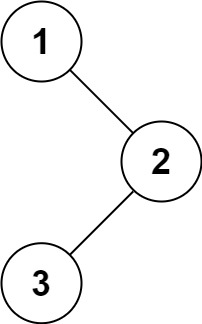 输入:root = [1,null,2,3]输出:[1,3,2]
示例 2:
输入:root = []输出:[]示例 3:
输入:root = [1]输出:[1]提示:
- 树中节点数目在范围
[0, 100]内 -100 <= Node.val <= 100
- 树中节点数目在范围
-
思路
二叉树中序遍历
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {private List<Integer> ans = new ArrayList<>();private void inOrder(TreeNode root){if(root!=null){inOrder(root.left);ans.add(root.val);inOrder(root.right);}}public List<Integer> inorderTraversal(TreeNode root) {inOrder(root);return ans;}}
104. 二叉树的最大深度
-
题目
给定一个二叉树
root,返回其最大深度。二叉树的 最大深度 是指从根节点到最远叶子节点的最长路径上的节点数。
示例 1:
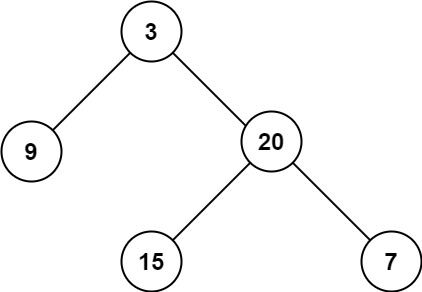 输入:root = [3,9,20,null,null,15,7]输出:3
示例 2:
输入:root = [1,null,2]输出:2提示:
- 树中节点的数量在
[0, 104]区间内。 -100 <= Node.val <= 100
- 树中节点的数量在
-
思路
以当前节点为根结点的最大深度=max(左子树最大深度,右子树最大深度)+1
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {public int maxDepth(TreeNode root) {if(root==null){return 0;}int ld = maxDepth(root.left);int rd = maxDepth(root.right);return ld>rd?ld+1:rd+1;}}
226. 翻转二叉树
-
题目
给你一棵二叉树的根节点
root,翻转这棵二叉树,并返回其根节点。示例 1:
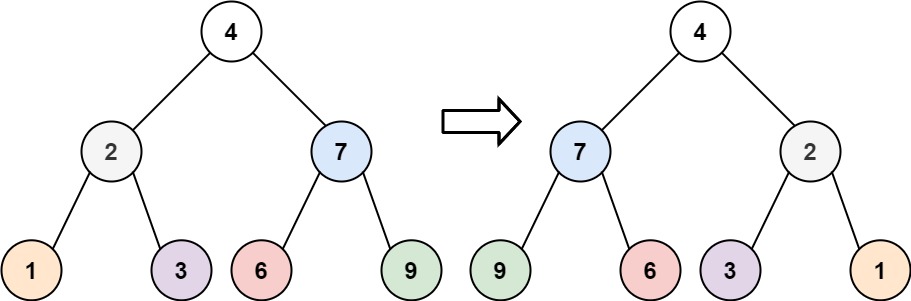 输入:root = [4,2,7,1,3,6,9]输出:[4,7,2,9,6,3,1]
示例 2:
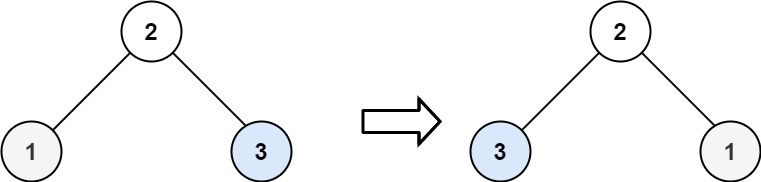 输入:root = [2,1,3]输出:[2,3,1]
示例 3:
输入:root = []输出:[]提示:
- 树中节点数目范围在
[0, 100]内 -100 <= Node.val <= 100
- 树中节点数目范围在
-
思路
递归,先分后治 — 对于每一棵子树而言,都需要进行反转,而我们每次做的操作只是反转挂在当前根结点下那两个结点进行反转,所以要先分,分到最小单位的子树后进行交换,如此一来每次的反转都在前一次的基础上
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {public TreeNode invertTree(TreeNode root) {if(root==null){return null;}invertTree(root.left);invertTree(root.right);TreeNode lchild = root.left;TreeNode rchild = root.right;root.left = rchild;root.right = lchild;return root;}}
101. 对称二叉树
-
题目
给你一个二叉树的根节点
root, 检查它是否轴对称。示例 1:
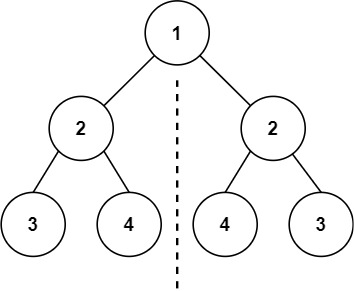 输入:root = [1,2,2,3,4,4,3]输出:true
示例 2:
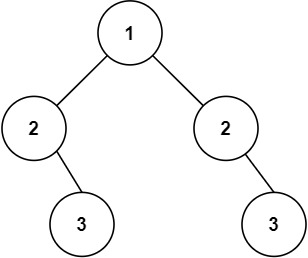 输入:root = [1,2,2,null,3,null,3]输出:false
提示:
- 树中节点数目在范围
[1, 1000]内 -100 <= Node.val <= 100
- 树中节点数目在范围
-
思路
满足镜像的条件:
p.val 等于 q.val。 p 的左儿子与 q 的右儿子互为镜像。这是一个和原问题相似的子问题,可以递归判断。 p 的右儿子与 q 的左儿子互为镜像。这是一个和原问题相似的子问题,可以递归判断。
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {public boolean judge(TreeNode l,TreeNode r){if(l==null || r==null){return l==r;//当l或r等于null时分两种情况//1.l、r均为null 此时满足镜像 且l==r==null//2.l、r中的一个为null 此时不满足镜像 且l!=r (一个有地址一个地址为null)}//镜像条件://1.两个结点的值相同//2.两个结点的子树也是镜像return l.val==r.val && judge(l.left,r.right) && judge(l.right,r.left);}public boolean isSymmetric(TreeNode root) {return judge(root.left,root.right);}}
543. 二叉树的直径
-
题目
给你一棵二叉树的根节点,返回该树的 直径 。
二叉树的 直径 是指树中任意两个节点之间最长路径的 长度 。这条路径可能经过也可能不经过根节点
root。两节点之间路径的 长度 由它们之间边数表示。
示例 1:
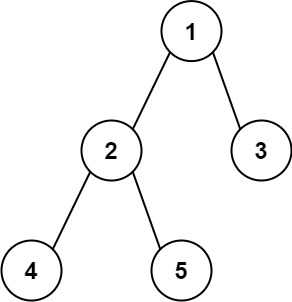 输入:root = [1,2,3,4,5]输出:3解释:3 ,取路径 [4,2,1,3] 或 [5,2,1,3] 的长度。
示例 2:
输入:root = [1,2]输出:1提示:
- 树中节点数目在范围
[1, 104]内 -100 <= Node.val <= 100
- 树中节点数目在范围
-
思路
对于一个结点root,经过该结点构成的“直径”为 root左子树中的最大深度+右子树最大深度
由此,我们只要在求根结点最大深度的时候(根结点求最大深度时会求出每一个结点的深度)用一个全局变量记录最大值即可
tip:实际的“直径”应该是一条链路上的边数,如示例1中,[4,2,1,3]这条路径,就是以1为转折点,左边两条+右边1条,而此条数恰好和深度一致
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {private int ans;public int diameterOfBinaryTree(TreeNode root) {dfs(root);return ans;}//求最大深度的函数,最大深度=节点数=边数+1public int dfs(TreeNode root){if(root == null){return 0;}int lh = dfs(root.left);int rh = dfs(root.right);//结果不一定经过根结点,所以用ans记录最大值ans = Math.max(ans,lh+rh);return lh>rh?lh+1:rh+1;}}
102. 二叉树的层序遍历
-
题目
给你二叉树的根节点
root,返回其节点值的 层序遍历 。 (即逐层地,从左到右访问所有节点)。示例 1:
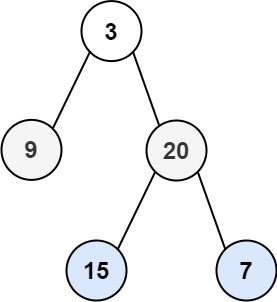 输入:root = [3,9,20,null,null,15,7]输出:[[3],[9,20],[15,7]]
示例 2:
输入:root = [1]输出:[[1]]示例 3:
输入:root = []输出:[]提示:
- 树中节点数目在范围
[0, 2000]内 -1000 <= Node.val <= 1000
- 树中节点数目在范围
-
思路
BFS,里面的队列的一些API注意一下
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {public List<List<Integer>> levelOrder(TreeNode root) {if(root==null){return Collections.emptyList();}Queue<TreeNode> q = new ArrayDeque<>();List<List<Integer>> ans = new ArrayList<>();q.add(root);while(!q.isEmpty()){int n = q.size();List<Integer> tmp = new ArrayList<>(n);for(int i = 0;i<n;i++){TreeNode t = q.remove();if(t.left!=null){q.add(t.left);}if(t.right!=null){q.add(t.right);}tmp.add(t.val);}ans.add(tmp);}return ans;}}
108. 将有序数组转换为二叉搜索树
-
题目
给你一个整数数组
nums,其中元素已经按 升序 排列,请你将其转换为一棵 平衡 二叉搜索树。示例 1:
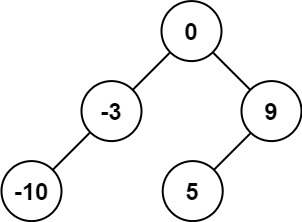 输入:nums = [-10,-3,0,5,9]输出:[0,-3,9,-10,null,5]解释:[0,-10,5,null,-3,null,9] 也将被视为正确答案:
示例 2:
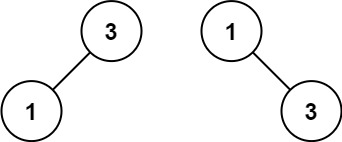 输入:nums = [1,3]输出:[3,1]解释:[1,null,3] 和 [3,1] 都是高度平衡二叉搜索树。
提示:
1 <= nums.length <= 104-104 <= nums[i] <= 104nums按 严格递增 顺序排列
-
思路
数组升序排序,要转成平衡二叉树,每个结点的左子树都小于它右子树都大于它,在递归时取中间元素插入即可
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {public TreeNode sortedArrayToBST(int[] nums) {return dfs(nums,0,nums.length);}public TreeNode dfs(int nums[],int l,int r){if(l==r){return null;}int m = (l+r)/2;TreeNode root = new TreeNode(nums[m]);root.left = dfs(nums,l,m);root.right = dfs(nums,m+1,r);return root;}}
98. 验证二叉搜索树
-
题目
给你一个二叉树的根节点
root,判断其是否是一个有效的二叉搜索树。有效 二叉搜索树定义如下:
- 节点的左子树只包含 严格小于 当前节点的数。
- 节点的右子树只包含 严格大于 当前节点的数。
- 所有左子树和右子树自身必须也是二叉搜索树。
示例 1:
 输入:root = [2,1,3]输出:true
示例 2:
 输入:root = [5,1,4,null,null,3,6]输出:false解释:根节点的值是 5 ,但是右子节点的值是 4 。
提示:
- 树中节点数目范围在
[1, 104]内 -231 <= Node.val <= 231 - 1
-
思路
二叉搜索树天生满足中序遍历升序排列的特点,我们只需要在中序遍历的过程中不断判断其是否有序即可(当前结点是否大于上一个结点)
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {private long pre = Long.MIN_VALUE;//使用long的最小值,防止出现int的最小值private boolean ans = true; //用于记录答案public boolean isValidBST(TreeNode root) {judge(root);return ans;}public void judge(TreeNode root){if(root!=null){judge(root.left);if(root.val <= pre){//判断当前结点是否大于上一结点ans = false;//若不满足则更新为false}pre = root.val;judge(root.right);}}}
230. 二叉搜索树中第 K 小的元素
-
题目
给定一个二叉搜索树的根节点
root,和一个整数k,请你设计一个算法查找其中第k小的元素(k从 1 开始计数)。示例 1:
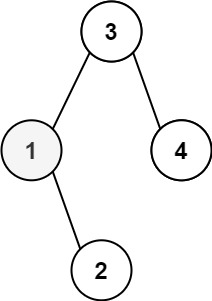 输入:root = [3,1,4,null,2], k = 1输出:1
示例 2:
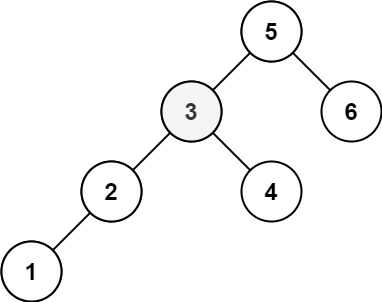 输入:root = [5,3,6,2,4,null,null,1], k = 3输出:3
提示:
- 树中的节点数为
n。 1 <= k <= n <= 1040 <= Node.val <= 104
- 树中的节点数为
-
思路
中序遍历过程中进行计数,当计数==k时结束递归并记录结果
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {private int ans;private int count = 0;private void inOrder(TreeNode root,int k){if(root!=null){inOrder(root.left,k);count++;if(count==k){ans = root.val;return;}inOrder(root.right,k);}}public int kthSmallest(TreeNode root, int k) {inOrder(root,k);return ans;}}
199. 二叉树的右视图
-
题目
给定一个二叉树的 根节点
root,想象自己站在它的右侧,按照从顶部到底部的顺序,返回从右侧所能看到的节点值。示例 1:
**输入:**root = [1,2,3,null,5,null,4]
输出:[1,3,4]
解释:
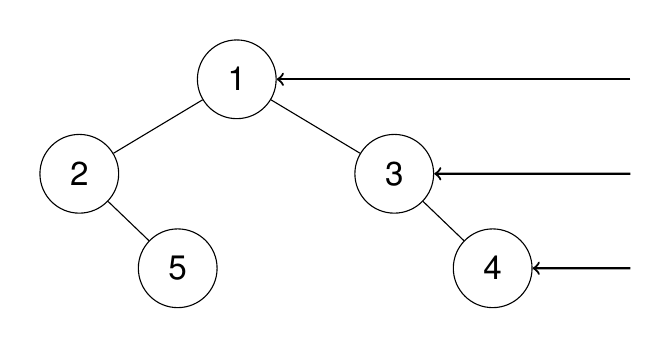
示例 2:
**输入:**root = [1,2,3,4,null,null,null,5]
输出:[1,3,4,5]
解释:

示例 3:
**输入:**root = [1,null,3]
输出:[1,3]
示例 4:
**输入:**root = []
输出:[]
提示:
- 二叉树的节点个数的范围是
[0,100] -100 <= Node.val <= 100
- 二叉树的节点个数的范围是
-
思路
层次遍历,取出每层的最后一个元素
Tip<队列>(Deque)操作中,offer() > add() poll()>remove()
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {public List<Integer> rightSideView(TreeNode root) {if(root==null){return Collections.emptyList();}List<Integer> ans = new ArrayList<>();Queue<TreeNode> q = new ArrayDeque<>();q.offer(root);while(!q.isEmpty()){int n = q.size();for(int i = 0;i<n;i++){TreeNode cur = q.poll();if(cur.left!=null){q.offer(cur.left);}if(cur.right!=null){q.offer(cur.right);}if(i==n-1){ans.add(cur.val);}}}return ans;}}
114. 二叉树展开为链表
-
题目
给你二叉树的根结点
root,请你将它展开为一个单链表:- 展开后的单链表应该同样使用
TreeNode,其中right子指针指向链表中下一个结点,而左子指针始终为null。 - 展开后的单链表应该与二叉树 先序遍历 顺序相同。
示例 1:
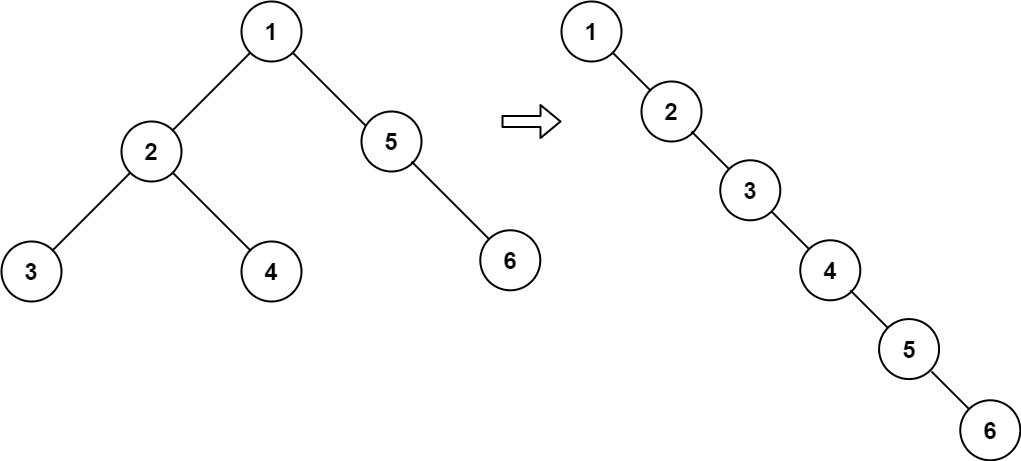 输入:root = [1,2,5,3,4,null,6]输出:[1,null,2,null,3,null,4,null,5,null,6]
示例 2:
输入:root = []输出:[]示例 3:
输入:root = [0]输出:[0]提示:
- 树中结点数在范围
[0, 2000]内 -100 <= Node.val <= 100
- 展开后的单链表应该同样使用
-
思路
以示例1为例,此树的先序遍历为[1,2,3,4,5,6], 我们只需反着遍历**(右、左、根)** ,并将每个结点插到上一个结点前面 —
将上一个结点变为当前结点的儿子结点
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {private TreeNode pre;public void flatten(TreeNode root) {if(root!=null){flatten(root.right);flatten(root.left);root.left = null;root.right = pre;pre = root;}}}
105. 从前序与中序遍历序列构造二叉树
-
题目
给定两个整数数组
preorder和inorder,其中preorder是二叉树的先序遍历,inorder是同一棵树的中序遍历,请构造二叉树并返回其根节点。示例 1:
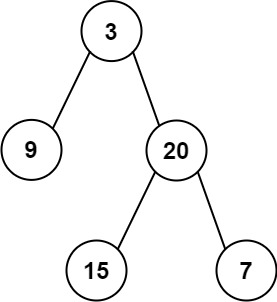 输入: preorder = [3,9,20,15,7], inorder = [9,3,15,20,7]输出: [3,9,20,null,null,15,7]
示例 2:
输入: preorder = [-1], inorder = [-1]输出: [-1]提示:
1 <= preorder.length <= 3000inorder.length == preorder.length-3000 <= preorder[i], inorder[i] <= 3000preorder和inorder均 无重复 元素inorder均出现在preorderpreorder保证 为二叉树的前序遍历序列inorder保证 为二叉树的中序遍历序列
-
思路
先序加中序创建二叉树,其中在中序遍历中寻找根结点的位置可以用哈希表优化
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {//哈希表用于存储元素和其索引对应关系private Map<Integer,Integer> map = new HashMap<>();public TreeNode buildTree(int[] preorder, int[] inorder) {int len = preorder.length;for(int i = 0;i<len;i++){map.put(inorder[i],i);}return createTree(preorder,0,len-1,inorder,0,len-1);}private TreeNode createTree(int[] preorder,int l1,int r1,int[] inorder,int l2,int r2){if(l1>r1){return null;}TreeNode root = new TreeNode(preorder[l1]);//此处用哈希表优化,使得查找root在inorder中的索引时间复杂度变为O(1)int index = map.get(root.val);int L_Len = index-l2;root.left = createTree(preorder,l1+1,l1+L_Len,inorder,l2,index-1);root.right = createTree(preorder,l1+1+L_Len,r1,inorder,index+1,r2);return root;}}
437. 路径总和 III
-
题目
给定一个二叉树的根节点
root,和一个整数targetSum,求该二叉树里节点值之和等于targetSum的 路径 的数目。路径 不需要从根节点开始,也不需要在叶子节点结束,但是路径方向必须是向下的(只能从父节点到子节点)。
示例 1:
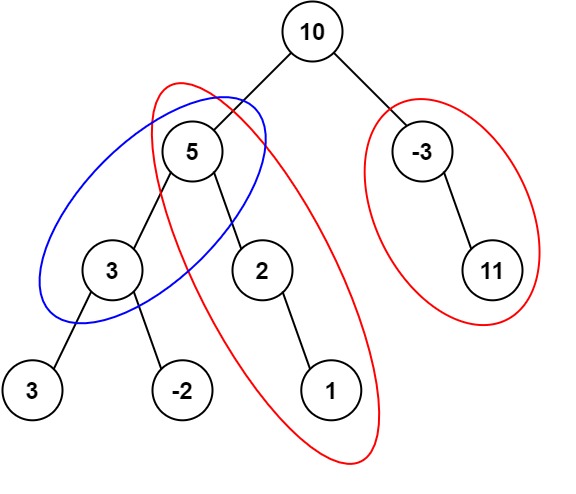 输入:root = [10,5,-3,3,2,null,11,3,-2,null,1], targetSum = 8输出:3解释:和等于 8 的路径有 3 条,如图所示。
示例 2:
输入:root = [5,4,8,11,null,13,4,7,2,null,null,5,1], targetSum = 22输出:3提示:
- 二叉树的节点个数的范围是
[0,1000] -109 <= Node.val <= 109-1000 <= targetSum <= 1000
- 二叉树的节点个数的范围是
-
思路
题目中规定了路径方向必须是向下的(只能从父节点到子节点)。 由此限制以及targetSum可以联想到[560](#560. 和为 K 的子数组)本质还是子数组问题,利用前缀和+HashMap,HashMap记录dfs走过的路径的前缀和将查找效率压缩到O(1)
时间复杂度O(n),n为结点个数
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {private int ans = 0;//key:前缀和的值 value:出现的次数private Map<Long,Integer> map = new HashMap<>();public int pathSum(TreeNode root, int targetSum) {map.put(0L,1);dfs(root,0,targetSum);return ans;}//sum表示根结点到当前节点的父结点的和//此处使用long类型计算sum --- int会溢出private void dfs(TreeNode root,long sum,int targetSum){if(root == null){return;}sum+=root.val;//当前节点的前缀和//将当前节点当作路径终点,查看有多少个符合条件的前缀和,加入答案ans += map.getOrDefault((sum-targetSum),0);map.merge(sum,1,Integer::sum); //map[sum]++dfs(root.left,sum,targetSum);dfs(root.right,sum,targetSum);map.merge(sum,-1,Integer::sum);//map[sum]-- 回溯}}//若想要提高效率可以将merge换为put和get结合
236. 二叉树的最近公共祖先
-
题目
给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。
百度百科中最近公共祖先的定义为:“对于有根树 T 的两个节点 p、q,最近公共祖先表示为一个节点 x,满足 x 是 p、q 的祖先且 x 的深度尽可能大(一个节点也可以是它自己的祖先)。”
示例 1:
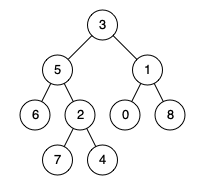 输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 1输出:3解释:节点 5 和节点 1 的最近公共祖先是节点 3 。
示例 2:
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 4输出:5解释:节点 5 和节点 4 的最近公共祖先是节点 5 。因为根据定义最近公共祖先节点可以为节点本身。示例 3:
输入:root = [1,2], p = 1, q = 2输出:1提示:
- 树中节点数目在范围
[2, 105]内。 -109 <= Node.val <= 109- 所有
Node.val互不相同。 p != qp和q均存在于给定的二叉树中。
- 树中节点数目在范围
-
思路
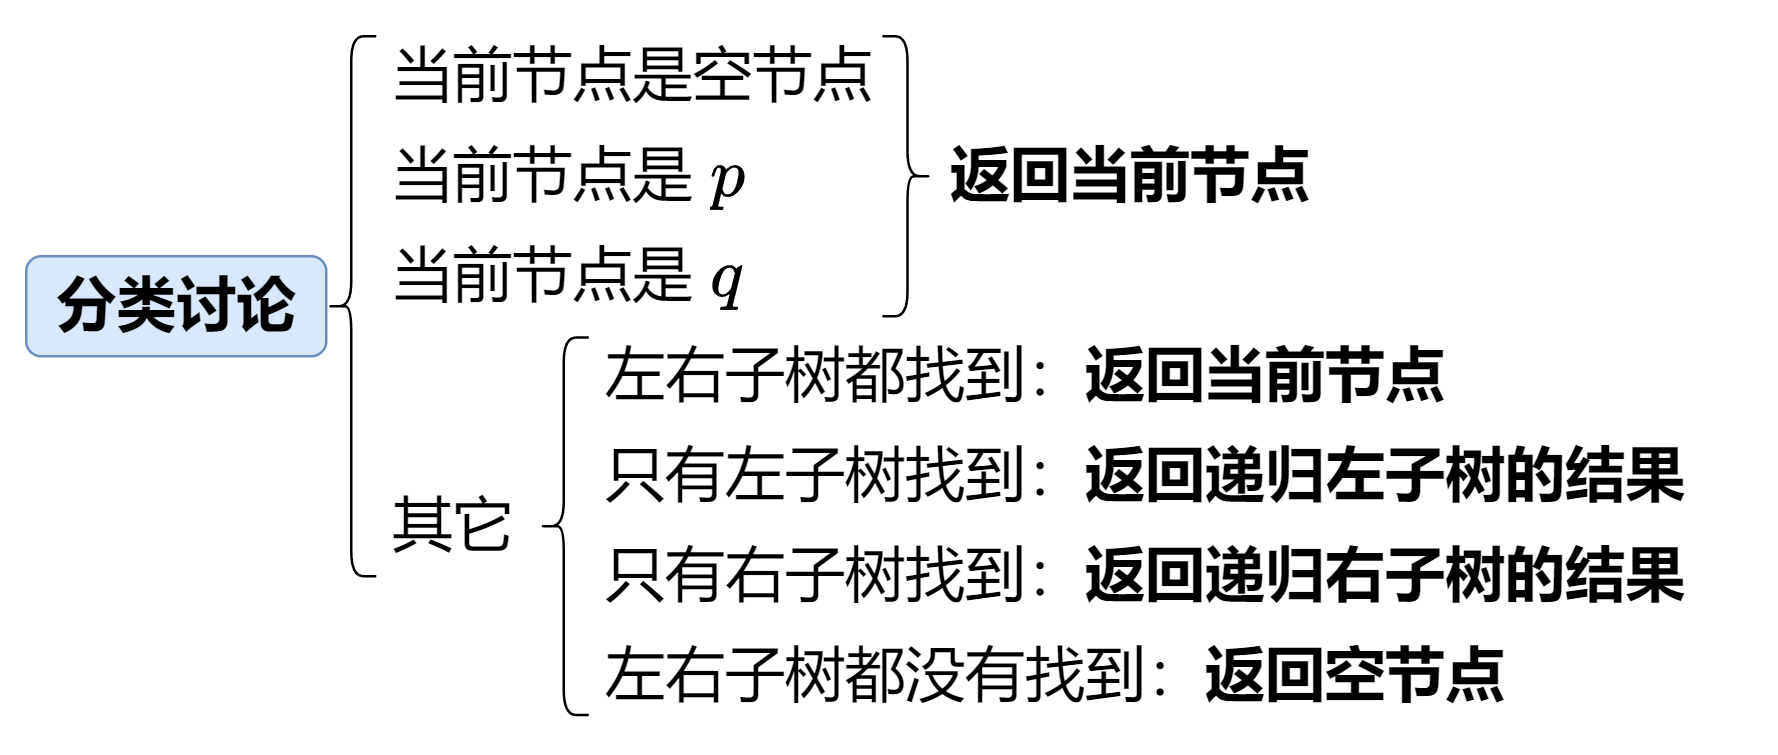
答疑 问:lowestCommonAncestor 函数的返回值是什么意思?
答:返回值的准确含义是**「最近公共祖先的候选项」。对于最外层的递归调用者来说,返回值是最近公共祖先的意思。但是,在递归过程中,返回值可能是最近公共祖先**,也可能是空节点(表示子树内没找到任何有用信息)、节点 p 或者节点 q(可能成为最近公共祖先,或者用来辅助判断上面的某个节点是否为最近公共祖先)。
问:为什么发现当前节点是 p 或者 q 就不再往下递归了?万一下面有 q 或者 p 呢?
答:如果下面有 q 或者 p,那么当前节点就是最近公共祖先,直接返回当前节点。如果下面没有,那既然都没有要找的节点了,也不需要递归,直接返回当前节点。(注意题目保证 p 和 q 都在二叉树中)
-
递归到p或q时
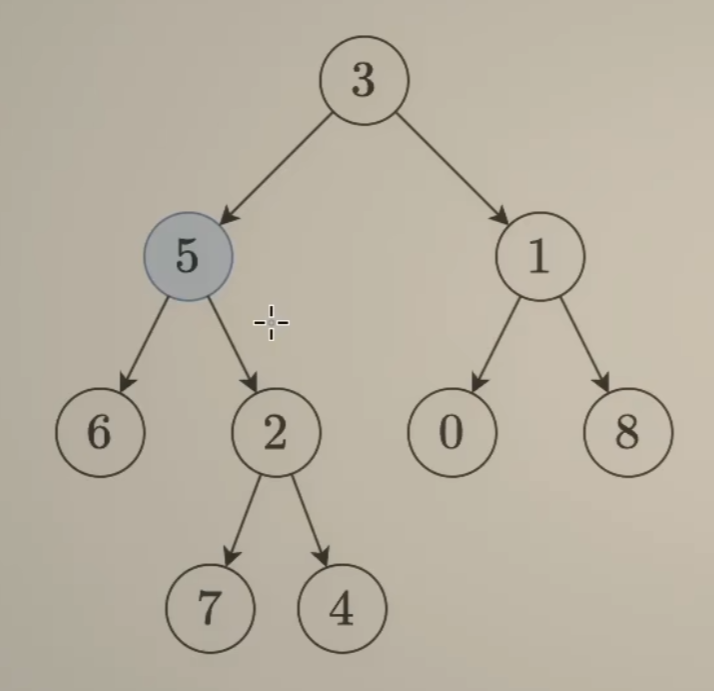
假设递归找到了p此时有两种可能
- q在p的下面,那么最近公共祖先就为p
- q不在p的子树下面,那么无需继续递归(剪枝)
综上无需继续向下递归,直接返回p即可。若是情况2,返回p给上面的递归用于判断公共祖先**(下面的情况)**
-
递归得知p、q分别存在于当前节点的左右子树中
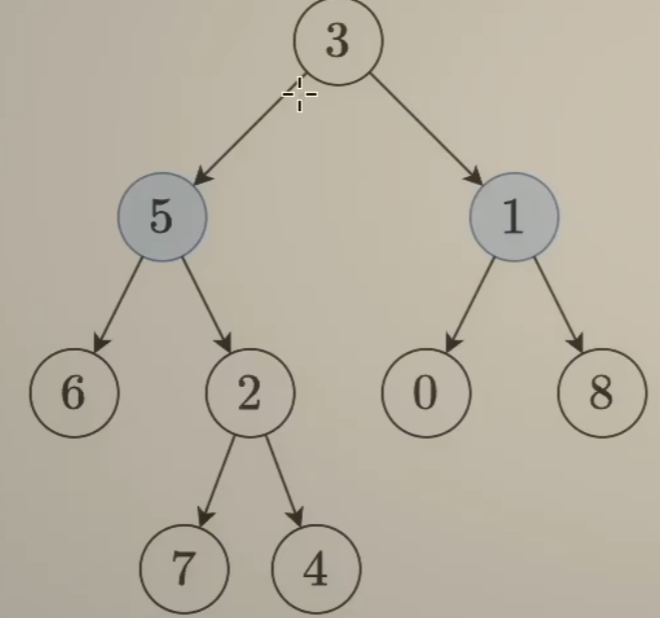
说明当前结点就是最近公共祖先
-
递归得知p、q都存在于当前左子树(或右子树)中
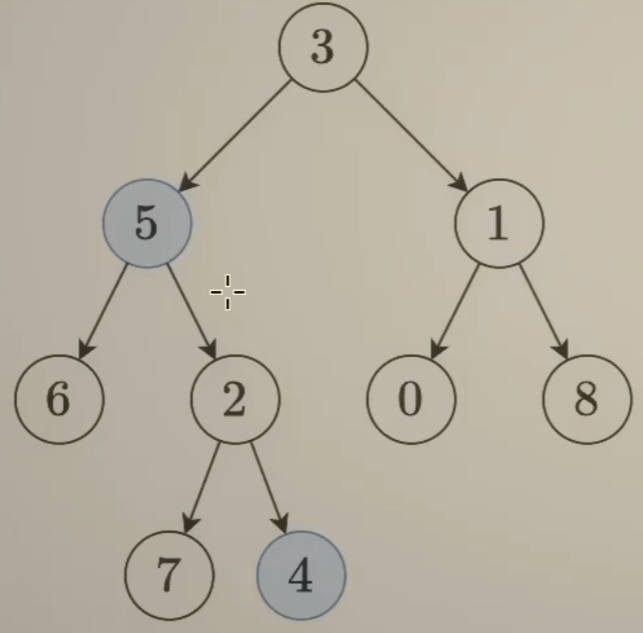
这种情况其实是上一种情况的广义版本,这种情况说明当前结点是p、q的公共结点,但不是最近公共结点,最近公共结点还需要去左(右)子树中寻找
-
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode(int x) { val = x; }* }*/class Solution {public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) {if(root==null || root==p || root==q){return root;}TreeNode left = lowestCommonAncestor(root.left,p,q);TreeNode right = lowestCommonAncestor(root.right,p,q);if(left!=null && right!=null){return root;}// 如果只有左子树找到,就返回左子树的返回值// 如果只有右子树找到,就返回右子树的返回值// 如果左右子树都没有找到,就返回 null(注意此时 right = null)return left!=null? left:right;}}
124. 二叉树中的最大路径和
-
题目
二叉树中的 路径 被定义为一条节点序列,序列中每对相邻节点之间都存在一条边。同一个节点在一条路径序列中 至多出现一次 。该路径 至少包含一个 节点,且不一定经过根节点。
路径和 是路径中各节点值的总和。
给你一个二叉树的根节点
root,返回其 最大路径和 。示例 1:
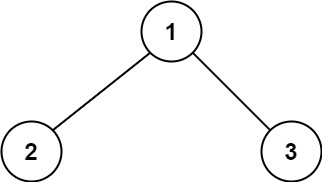 输入:root = [1,2,3]输出:6解释:最优路径是 2 -> 1 -> 3 ,路径和为 2 + 1 + 3 = 6
示例 2:
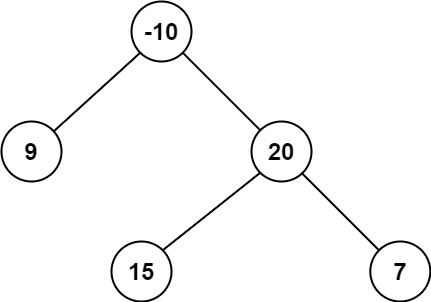 输入:root = [-10,9,20,null,null,15,7]输出:42解释:最优路径是 15 -> 20 -> 7 ,路径和为 15 + 20 + 7 = 42
提示:
- 树中节点数目范围是
[1, 3 * 104] -1000 <= Node.val <= 1000
- 树中节点数目范围是
-
思路
本体同[543](#543. 二叉树的直径)都是树型DP问题
这类问题的基本思路:
- 递归树,并计算以当前结点为根结点的树可提供的最大贡献
- 使用ans全局变量记录答案(不断与当前值比较取最大值)
那么本题的思路就是:
- 递归树,并计算以当前节点为根结点的树可提供的最大路径
- 使用ans全局变量记录答案(不断与当前值比较取最大值)
-
代码
/*** Definition for a binary tree node.* public class TreeNode {* int val;* TreeNode left;* TreeNode right;* TreeNode() {}* TreeNode(int val) { this.val = val; }* TreeNode(int val, TreeNode left, TreeNode right) {* this.val = val;* this.left = left;* this.right = right;* }* }*/class Solution {private int ans = Integer.MIN_VALUE;public int maxPathSum(TreeNode root) {dfs(root);return ans;}public int dfs(TreeNode root){if(root==null){return 0;}int lVal = dfs(root.left);int rVal = dfs(root.right);//当前路径的最长路径:lVal+rVal+root.valans = Math.max(lVal+rVal+root.val,ans);//Math.max(lVal,rVal)+root.val:路径定义:树中任意节点出发,沿着父子相连走任意节点,只能往下走、不能折返,一条路径不会出现分叉;所以以当前结点为根结点可以构成的路径只有两条:当前节点+左子树的一条路||右子树的一条路//前面已经计算出了左右子树分别能够达到的最大贡献,所以取二者最大值即可//由于Math.max(lVal,rVal)+root.val可能为负数,所以要和0取Maxreturn Math.max(Math.max(lVal,rVal)+root.val,0);}}
图论
200. 岛屿数量
-
题目
给你一个由
'1'(陆地)和'0'(水)组成的的二维网格,请你计算网格中岛屿的数量。岛屿总是被水包围,并且每座岛屿只能由水平方向和/或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
示例 1:
输入:grid = [['1','1','1','1','0'],['1','1','0','1','0'],['1','1','0','0','0'],['0','0','0','0','0']]输出:1示例 2:
输入:grid = [['1','1','0','0','0'],['1','1','0','0','0'],['0','0','1','0','0'],['0','0','0','1','1']]输出:3提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 300grid[i][j]的值为'0'或'1'
-
思路
连通块问题
-
代码
class Solution {private boolean[][] flag;private int[] dx = {-1,0,1,0};private int[] dy = {0,1,0,-1};int r;int c;public int numIslands(char[][] grid) {int ans = 0;r = grid.length;c = grid[0].length;flag = new boolean[r][c];for(int i = 0;i<r;i++){for(int j = 0;j<c;j++){if(flag[i][j]==false && grid[i][j]=='1'){ans++;dfs(grid,i,j);}}}return ans;}public void dfs(char[][] grid,int x,int y){for(int i = 0;i<4;i++){int nx = x+dx[i];int ny = y+dy[i];if(nx<0 || nx>=r || ny<0 || ny>=c) continue;if(grid[nx][ny]=='0') continue;if(flag[nx][ny]==true) continue;flag[nx][ny] = true;dfs(grid,nx,ny);}}}
994. 腐烂的橘子
-
题目
在给定的
m x n网格grid中,每个单元格可以有以下三个值之一:- 值
0代表空单元格; - 值
1代表新鲜橘子; - 值
2代表腐烂的橘子。
每分钟,腐烂的橘子 周围 4 个方向上相邻 的新鲜橘子都会腐烂。
返回 直到单元格中没有新鲜橘子为止所必须经过的最小分钟数。如果不可能,返回
-1。示例 1:
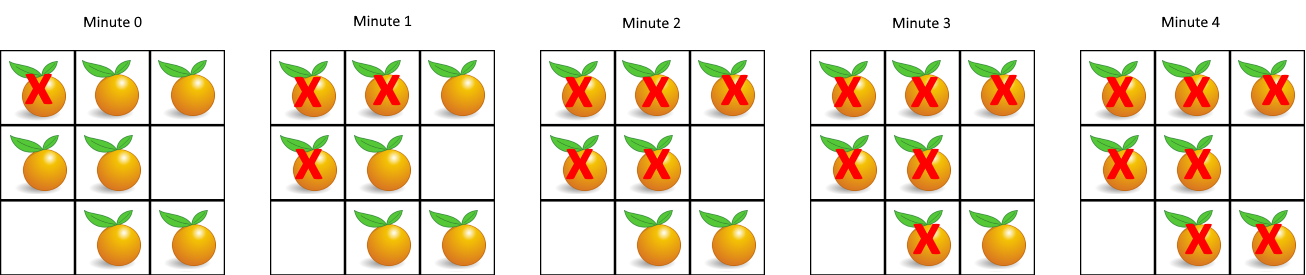 输入:grid = [[2,1,1],[1,1,0],[0,1,1]]输出:4
示例 2:
输入:grid = [[2,1,1],[0,1,1],[1,0,1]]输出:-1解释:左下角的橘子(第 2 行, 第 0 列)永远不会腐烂,因为腐烂只会发生在 4 个方向上。示例 3:
输入:grid = [[0,2]]输出:0解释:因为 0 分钟时已经没有新鲜橘子了,所以答案就是 0 。提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 10grid[i][j]仅为0、1或2
- 值
-
思路
多源BFS,开始前将所有符合条件的都加入队列作为起点。不过题目中有许多细节
-
代码
class Solution {private int[] dx = {-1,0,1,0};private int[] dy = {0,1,0,-1};public int orangesRotting(int[][] grid) {Queue<int[]> q = new ArrayDeque<>();int r = grid.length;int c = grid[0].length;int goodOrange = 0;for(int i = 0;i<r;i++){for(int j = 0;j<c;j++){if(grid[i][j]==2){//通过创建匿名内部类放入坐标q.offer(new int[]{i,j});}if(grid[i][j]==1){goodOrange++;//统计好橘子数量}}}int goodToBad = 0;int ans = 0;while(!q.isEmpty()){boolean flag = false;//size一定要拿出来!!!,直接写在循环里的话,size会变int size = q.size();for(int j = 0;j<size;j++){int[] temp = q.poll();int x = temp[0];int y = temp[1];for(int i = 0;i<4;i++){int nx = x + dx[i];int ny = y + dy[i];if(nx<0 || nx>=r || ny<0 || ny>=c)continue;if(grid[nx][ny]!=1)continue;goodToBad++;grid[nx][ny]=2;q.offer(new int[]{nx,ny});flag = true;}}//只有成功感染了才进行计数if(flag==true)ans++;if(goodOrange==goodToBad)return ans;}//判断goodOrange是否等于goodToBad,若不等则说明有橘子未被感染if(goodOrange!=goodToBad)return -1;//若相等则说明0分钟时就以及没有好橘子了(没有进while循环)return 0;}}
207. 课程表
-
题目
你这个学期必须选修
numCourses门课程,记为0到numCourses - 1。在选修某些课程之前需要一些先修课程。 先修课程按数组
prerequisites给出,其中prerequisites[i] = [ai, bi],表示如果要学习课程ai则 必须 先学习课程bi。- 例如,先修课程对
[0, 1]表示:想要学习课程0,你需要先完成课程1。
请你判断是否可能完成所有课程的学习?如果可以,返回
true;否则,返回false。示例 1:
输入:numCourses = 2, prerequisites = [[1,0]]输出:true解释:总共有 2 门课程。学习课程 1 之前,你需要完成课程 0 。这是可能的。示例 2:
输入:numCourses = 2, prerequisites = [[1,0],[0,1]]输出:false解释:总共有 2 门课程。学习课程 1 之前,你需要先完成课程 0 ;并且学习课程 0 之前,你还应先完成课程 1 。这是不可能的。提示:
1 <= numCourses <= 20000 <= prerequisites.length <= 5000prerequisites[i].length == 20 <= ai, bi < numCoursesprerequisites[i]中的所有课程对 互不相同
- 例如,先修课程对
-
思路
本质上就是找拓扑图中有无环的存在。可以使用List<List
>结构来模拟拓扑图结合BFS解决 ,用于存储边的指向。并使用int数组来记录各个结点的入度,每当有课被学了就自减。当课程入度为0时入队 -
代码
class Solution {public boolean canFinish(int numCourses, int[][] prerequisites) {int[] indegree = new int[numCourses];//使用链表模拟图List<List<Integer>> adj = new ArrayList<>();//初始化入度统计表和出度关系for(int i = 0;i<numCourses;i++){adj.add(new ArrayList<>());}int n = prerequisites.length;for(int i = 0;i<n;i++){//当前课程int cur = prerequisites[i][0];//先导课程int pre = prerequisites[i][1];indegree[cur]++;adj.get(pre).add(cur);//添加先导课程 --> 当先课程的边}Queue<Integer> q = new ArrayDeque<>();int count = 0;//统计学了的课程数量for(int i = 0;i<numCourses;i++){if(indegree[i]==0) {q.offer(i);//将无先导课程的课程入队}}while(!q.isEmpty()){int course = q.poll();count++;List<Integer> courses = adj.get(course);int size = courses.size();//将该先导课关联的课入度--for(int i = 0;i<size;i++){int temp = courses.get(i);indegree[temp]--;//无入度时入队if(indegree[temp] == 0){q.add(temp);}}}return count==numCourses;}}
208. 实现 Trie (前缀树)
-
题目
Trie(发音类似 “try”)或者说 前缀树 是一种树形数据结构,用于高效地存储和检索字符串数据集中的键。这一数据结构有相当多的应用情景,例如自动补全和拼写检查。
请你实现 Trie 类:
Trie()初始化前缀树对象。void insert(String word)向前缀树中插入字符串word。boolean search(String word)如果字符串word在前缀树中,返回true(即,在检索之前已经插入);否则,返回false。boolean startsWith(String prefix)如果之前已经插入的字符串word的前缀之一为prefix,返回true;否则,返回false。
示例:
输入["Trie", "insert", "search", "search", "startsWith", "insert", "search"][[], ["apple"], ["apple"], ["app"], ["app"], ["app"], ["app"]]输出[null, null, true, false, true, null, true]解释Trie trie = new Trie();trie.insert("apple");trie.search("apple"); // 返回 Truetrie.search("app"); // 返回 Falsetrie.startsWith("app"); // 返回 Truetrie.insert("app");trie.search("app"); // 返回 True提示:
1 <= word.length, prefix.length <= 2000word和prefix仅由小写英文字母组成insert、search和startsWith调用次数 总计 不超过3 * 104次
-
思路
构造一个**“二十六叉树”**,每个单词后面的单词都有二十六种可能性,所以构建一个二十六叉树(初始所有节点为null),存入时为对应字母的位置new一个Node出来,这样在查询的时候只要后面的字母不是null就可以继续向后走。
若循环结束且走到单词的最后一个字母则说明完全匹配
若循环过程中走到null则说明不匹配
若循环结束但没有走到单词末尾则说明是前缀
-
代码
class Trie {private static class Node{Node[] sons = new Node[26];boolean end = false;//标记当前结点是否为该单词的最后一个字母}private final Node root;public Trie() {root = new Node();}public void insert(String word) {char[] words = word.toCharArray();int n = words.length;Node cur = root;for(int i = 0;i<n;i++){int idx = words[i]-'a';if(cur.sons[idx] == null){cur.sons[idx] = new Node();}cur = cur.sons[idx];}cur.end = true;//将单词最后一个单词标为true}public boolean search(String word) {char[] words = word.toCharArray();int n = words.length;Node cur = root;for(int i = 0;i<n;i++){int idx = words[i]-'a';if(cur.sons[idx] == null){return false;}cur = cur.sons[idx];}return cur.end;//只有到达最后一个字母才算匹配成功}public boolean startsWith(String prefix) {char[] words = prefix.toCharArray();int n = words.length;Node cur = root;for(int i = 0;i<n;i++){int idx = words[i]-'a';if(cur.sons[idx] == null){return false;}cur = cur.sons[idx];}return true;//只要匹配完了就算成功}}/*** Your Trie object will be instantiated and called as such:* Trie obj = new Trie();* obj.insert(word);* boolean param_2 = obj.search(word);* boolean param_3 = obj.startsWith(prefix);*/
回溯
46. 全排列
-
题目
给定一个不含重复数字的数组
nums,返回其 所有可能的全排列 。你可以 按任意顺序 返回答案。示例 1:
输入:nums = [1,2,3]输出:[[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2],[3,2,1]]示例 2:
输入:nums = [0,1]输出:[[0,1],[1,0]]示例 3:
输入:nums = [1]输出:[[1]]提示:
1 <= nums.length <= 6-10 <= nums[i] <= 10nums中的所有整数 互不相同
-
思路
回溯算法全排列,注意Java中的一些书写方法即可
-
代码
class Solution {private List<List<Integer>> ans = new ArrayList<>();private int n;private boolean[] visited;private List<Integer> temp = new ArrayList<>();public List<List<Integer>> permute(int[] nums) {n = nums.length;visited = new boolean[n];dfs(nums,n);return ans;}private void dfs(int[] nums,int n){if(temp.size()>=n){if(temp.size()==n){//要新new一个对象,如果直接add temp的话全都指向一份内存了ans.add(new ArrayList(temp));}return;}for(int i = 0;i<n;i++){if(!visited[i]){visited[i] = true;temp.add(nums[i]);dfs(nums,n);visited[i] = false;temp.remove(Integer.valueOf(nums[i]));}}}}
78. 子集
-
题目
给你一个整数数组
nums,数组中的元素 互不相同 。返回该数组所有可能的子集(幂集)。解集 不能 包含重复的子集。你可以按 任意顺序 返回解集。
示例 1:
输入:nums = [1,2,3]输出:[[],[1],[2],[1,2],[3],[1,3],[2,3],[1,2,3]]示例 2:
输入:nums = [0]输出:[[],[0]]提示:
1 <= nums.length <= 10-10 <= nums[i] <= 10nums中的所有元素 互不相同
-
思路
组合问题,0~n的全部组合可能性
-
代码
class Solution {private int n;private List<List<Integer>> ans = new ArrayList<>();public List<List<Integer>> subsets(int[] nums) {n = nums.length;for(int k = 0;k<=n;k++){List<Integer> temp = new ArrayList<>();dfs(nums,0,k,temp);}return ans;}private void dfs(int[] nums,int start,int k,List<Integer> temp){if(temp.size()>=k){if(temp.size()==k){ans.add(new ArrayList<>(temp));}return;}for(int i = start;i<n;i++){temp.add(nums[i]);dfs(nums,i+1,k,temp);temp.remove(Integer.valueOf(nums[i]));}}}
17. 电话号码的字母组合
-
题目
给定一个仅包含数字
2-9的字符串,返回所有它能表示的字母组合。答案可以按 任意顺序 返回。给出数字到字母的映射如下(与电话按键相同)。注意 1 不对应任何字母。

示例 1:
输入:digits = "23"输出:["ad","ae","af","bd","be","bf","cd","ce","cf"]示例 2:
输入:digits = "2"输出:["a","b","c"]提示:
1 <= digits.length <= 4digits[i]是范围['2', '9']的一个数字。
-
思路
定义一个查询表MAPPING存储每个键上的字符串,随后在对应的每个字符串上选取一个字符,共选取k个
-
代码
class Solution {private static final String[] MAPPING = new String[]{"", "", "abc", "def", "ghi", "jkl", "mno", "pqrs", "tuv", "wxyz"};private List<String> ans = new ArrayList<>();private char[] temp;private int n;public List<String> letterCombinations(String digits) {char[] words = digits.toCharArray();int k = words.length;if(k==0){return Collections.emptyList();}temp = new char[k];dfs(0,k,words);return ans;}//在Mapping中符合的字符串中每个选一个private void dfs(int cur_pos,int k,char[] words){//填满了if(k==cur_pos){ans.add(new String(temp));return;}String str = MAPPING[words[cur_pos]-'0'];//符合要求的字符串char[] chars = str.toCharArray();for(char c : chars){temp[cur_pos] = c;dfs(cur_pos+1,k,words);temp[cur_pos] = 0;}}}
39. 组合总和
-
题目
给你一个 无重复元素 的整数数组
candidates和一个目标整数target,找出candidates中可以使数字和为目标数target的 所有 不同组合 ,并以列表形式返回。你可以按 任意顺序 返回这些组合。candidates中的 同一个 数字可以 无限制重复被选取 。如果至少一个数字的被选数量不同,则两种组合是不同的。对于给定的输入,保证和为
target的不同组合数少于150个。示例 1:
输入:candidates = [2,3,6,7], target = 7输出:[[2,2,3],[7]]解释:2 和 3 可以形成一组候选,2 + 2 + 3 = 7 。注意 2 可以使用多次。7 也是一个候选, 7 = 7 。仅有这两种组合。示例 2:
输入: candidates = [2,3,5], target = 8输出: [[2,2,2,2],[2,3,3],[3,5]]示例 3:
输入: candidates = [2], target = 1输出: []提示:
1 <= candidates.length <= 302 <= candidates[i] <= 40candidates的所有元素 互不相同1 <= target <= 40
-
思路
本质上还是组合问题,不过注意以下三点
- 所选取的数量是不受限制的,所以不用传k限制选取个数
- 所选取的是可以重复的,所以在dfs时start不用传i+1,而应该传i
- 需要设定一个形参sum计算和,当和大于target时进行剪枝
-
代码
class Solution {private List<List<Integer>> ans = new ArrayList<>();private List<Integer> path = new ArrayList<>();private int n;public List<List<Integer>> combinationSum(int[] candidates, int target) {n = candidates.length;dfs(candidates,target,0,0);return ans;}private void dfs(int[] candidates,int target,int sum,int start){if(sum>=target){if(sum==target){ans.add(new ArrayList<>(path));}return;//剪枝}for(int i = start;i<n;i++){path.add(candidates[i]);sum+=candidates[i];dfs(candidates,target,sum,i);//性能上removeLast() > remove(path.size()-1) > remove(Integer.valueOf(candidates[i]))path.removeLast();sum-=candidates[i];}}}
22. 括号生成
-
题目
数字
n代表生成括号的对数,请你设计一个函数,用于能够生成所有可能的并且 有效的 括号组合。示例 1:
输入:n = 3输出:["((()))","(()())","(())()","()(())","()()()"]示例 2:
输入:n = 1输出:["()"]提示:
1 <= n <= 8
-
选或不选的回溯算法。
可以选左括号的条件:只要左括号数量小于n都可以选
可以选右括号的条件:右括号的数量要小于左括号的数量才可以选
-
代码
class Solution {private List<String> ans = new ArrayList<>();private char[] path;public List<String> generateParenthesis(int n) {path = new char[2*n];dfs(0,n,0,0);return ans;}private void dfs(int cur_pos,int n,int left,int right){if(cur_pos == 2*n){//填满了ans.add(new String(path));return;}if(left<n){//可以填左括号path[cur_pos] = '(';dfs(cur_pos+1,n,left+1,right);}if(right<left){//可以填右括号path[cur_pos] = ')';//此处为隐式回溯,直接将当前位置原本的(覆盖dfs(cur_pos+1,n,left,right+1);}}}
79. 单词搜索
-
题目
给定一个
m x n二维字符网格board和一个字符串单词word。如果word存在于网格中,返回true;否则,返回false。单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中“相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母不允许被重复使用。
示例 1:
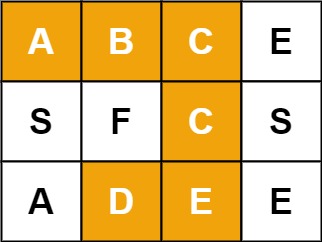 输入:board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "ABCCED"输出:true
示例 2:
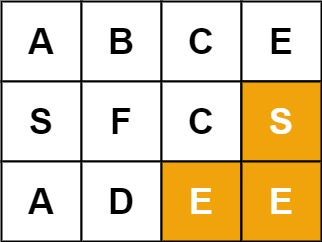 输入:board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "SEE"输出:true
示例 3:
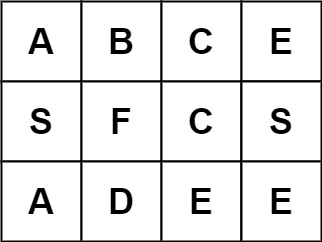 输入:board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "ABCB"输出:false
提示:
m == board.lengthn = board[i].length1 <= m, n <= 61 <= word.length <= 15board和word仅由大小写英文字母组成
-
思路
dfs走迷宫,有一些要注意的点在代码中标注出来了
-
代码
class Solution {private int[] dx = {0,1,0,-1};private int[] dy = {-1,0,1,0};private int m;private int n;private boolean ans = false;public boolean exist(char[][] board, String word) {char[] words = word.toCharArray();//转字符数组加快访问速度m = board.length;n = board[0].length;for(int i = 0;i<m;i++){for(int j = 0;j<n;j++){if(board[i][j]==words[0]){System.out.println(i+" "+j);boolean[][] visited = new boolean[m][n];visited[i][j] = true;//标记起点!!dfs(board,i,j,words,visited,0);if(ans==true){return ans;}}}}return ans;}private void dfs(char[][]board,int x,int y,char[] words,boolean[][] visited,int idx){if(idx>=words.length-1){if(idx==words.length-1){ans = true;}return;}for(int i = 0;i<4;i++){int nx = x+dx[i];int ny = y+dy[i];if(nx<0||nx>=m||ny<0||ny>=n)continue;if(visited[nx][ny])continue;//注意:nx ny对应的是idx+1 !!!if(board[nx][ny]!=words[idx+1])continue;visited[nx][ny] = true;dfs(board,nx,ny,words,visited,idx+1);visited[nx][ny] = false;}}}
131. 分割回文串
-
题目
给你一个字符串
s,请你将s分割成一些 子串,使每个子串都是 回文串 。返回s所有可能的分割方案。示例 1:
输入:s = "aab"输出:[["a","a","b"],["aa","b"]]示例 2:
输入:s = "a"输出:[["a"]]提示:
1 <= s.length <= 16s仅由小写英文字母组成
-
思路
dfs时传递一个start作为子串开始的位置,for循环遍历,i作为子串结束位置,判断构成的子串是否为回文串,若是则dfs找下一个切割点。若不是则不需要dfs — 题目要求每一个子串都是回文串
-
代码
class Solution {private List<List<String>> ans = new ArrayList<>();private List<String> path = new ArrayList<>();private int n;public List<List<String>> partition(String s) {char[] words = s.toCharArray();n = words.length;dfs(0,words);return ans;}private void dfs(int start,char[] words){if(start >= n){ans.add(new ArrayList<>(path));return;}//start为开始位置i为结束位置for(int i = start;i<n;i++){//如果是回文,则加入path并递归//要求每一个子串都是回文的,所以若当前字串不构成回文就无需找下一个切割点了if(judge(words,start,i)){path.add(new String(words,start,i-start+1));dfs(i+1,words);path.removeLast();//回溯}}}private boolean judge(char[] words,int left,int right){while(left < right){if(words[left++]!=words[right--])return false;}return true;}}
51. N 皇后
-
题目
按照国际象棋的规则,皇后可以攻击与之处在同一行或同一列或同一斜线上的棋子。
n 皇后问题 研究的是如何将
n个皇后放置在n×n的棋盘上,并且使皇后彼此之间不能相互攻击。给你一个整数
n,返回所有不同的 n 皇后问题 的解决方案。每一种解法包含一个不同的 n 皇后问题 的棋子放置方案,该方案中
'Q'和'.'分别代表了皇后和空位。示例 1:
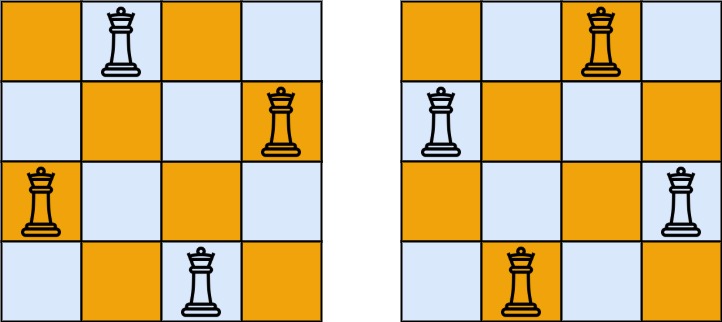 输入:n = 4输出:[[".Q..","...Q","Q...","..Q."],["..Q.","Q...","...Q",".Q.."]]解释:如上图所示,4 皇后问题存在两个不同的解法。
示例 2:
输入:n = 1输出:[["Q"]]提示:
1 <= n <= 9
-
思路
N皇后问题,dfs+回溯,每层的dfs中遍历当前行的所有列,判断有无可以放的位置,若有则放置并dfs下一行。当所有行都dfs完后则说明是一种解决方法。
判断条件:由于dfs以“行”为标准,所以需要判断的有 列、主对角线、副对角线
-
列:定义一个boolean数组标记列
-
主对角线:定义一个boolean数组,对于[i,j]放置了皇后,那么 都无法放置皇后了
观察可得横纵坐标相减恒为 取值范围是
-
负对角线同理,有着横纵坐标相加恒为 的规律,取值范围是
由上述判断条件可得各布尔数组的大小
列:n
主副对角线:2n(防越界)
-
-
代码
class Solution {private List<List<String>> ans = new ArrayList<>();boolean[] flag;//第i列的标记boolean[] diag1;//主对角线的标记boolean[] diag2;//主对角线的标记char[][] board;//棋盘public List<List<String>> solveNQueens(int n) {flag = new boolean[n];diag1 = new boolean[2*n];diag2 = new boolean[2*n];board = new char[n][n];//提前创建棋盘,代码美观且效率好for(int i = 0;i<n;i++){for(int j = 0;j<n;j++){board[i][j] = '.';}}dfs(n,0);return ans;}private void dfs(int n,int cur_row){if(cur_row>=n){//需要临时变量temp将每行的状态拷贝List<String> temp = new ArrayList<>();for(char[] c:board){temp.add(new String(c));}ans.add(new ArrayList<>(temp));//最后写入ansreturn;}//枚举某一行的每一列for(int i = 0;i<n;i++){int idx1 = cur_row-i+n;//加n使得idx1偏移到正数int idx2 = cur_row+i;//当前行、列、正负对角线都能占皇后的话if(flag[i]==false && diag1[idx1]==false && diag2[idx2]==false){flag[i] = diag1[idx1] = diag2[idx2] = true;board[cur_row][i] = 'Q';dfs(n,cur_row+1);board[cur_row][i] = '.';flag[i] = diag1[idx1] = diag2[idx2] = false;//回溯}}}}
二分查找
35. 搜索插入位置
-
题目
给定一个排序数组和一个目标值,在数组中找到目标值,并返回其索引。如果目标值不存在于数组中,返回它将会被按顺序插入的位置。
请必须使用时间复杂度为
O(log n)的算法。示例 1:
输入: nums = [1,3,5,6], target = 5输出: 2示例 2:
输入: nums = [1,3,5,6], target = 2输出: 1示例 3:
输入: nums = [1,3,5,6], target = 7输出: 4提示:
1 <= nums.length <= 104-104 <= nums[i] <= 104nums为 无重复元素 的 升序 排列数组-104 <= target <= 104
-
思路
二分查找,注意while条件left<=right
-
代码
class Solution {public int searchInsert(int[] nums, int target) {int left = 0;int right = nums.length-1;while(left<=right){int mid = (right-left)/2+left;if(nums[mid] > target){right = mid-1;}else if(nums[mid] < target){left = mid+1;}else{return mid;}}return left;}}
74. 搜索二维矩阵
-
题目
给你一个满足下述两条属性的
m x n整数矩阵:- 每行中的整数从左到右按非严格递增顺序排列。
- 每行的第一个整数大于前一行的最后一个整数。
给你一个整数
target,如果target在矩阵中,返回true;否则,返回false。你必须编写一个时间复杂度为
O(log(m * n))的解决方案。示例 1:
 输入:matrix = [[1,3,5,7],[10,11,16,20],[23,30,34,60]], target = 3输出:true
示例 2:
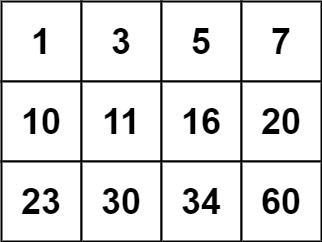 输入:matrix = [[1,3,5,7],[10,11,16,20],[23,30,34,60]], target = 13输出:false
提示:
m == matrix.lengthn == matrix[i].length1 <= m, n <= 100-104 <= matrix[i][j], target <= 104
-
思路
题目同[240](#240. 搜索二维矩阵 II),但是本题要求的时间复杂度是 所以可以将二维数组逻辑上拉成一维的,再使用二分查找
-
代码
class Solution {public boolean searchMatrix(int[][] matrix, int target) {int m = matrix.length;int n = matrix[0].length;int left = 0;int right = m*n-1;while(left<=right){int mid = (right-left)/2+left;int r = mid/n;int c = mid%n;if(matrix[r][c] < target){left = mid+1;}else if(matrix[r][c] > target){right = mid-1;}else{return true;}}return false;}}
34. 在排序数组中查找元素的第一个和最后一个位置
-
题目
给你一个按照非递减顺序排列的整数数组
nums,和一个目标值target。请你找出给定目标值在数组中的开始位置和结束位置。如果数组中不存在目标值
target,返回[-1, -1]。你必须设计并实现时间复杂度为
O(log n)的算法解决此问题。示例 1:
输入:nums = [5,7,7,8,8,10], target = 8输出:[3,4]示例 2:
输入:nums = [5,7,7,8,8,10], target = 6输出:[-1,-1]示例 3:
输入:nums = [], target = 0输出:[-1,-1]提示:
0 <= nums.length <= 105-109 <= nums[i] <= 109nums是一个非递减数组-109 <= target <= 109
-
思路
二分查找,不过在找到目标后不立即返回,而是接着将范围向左缩小,这样如果有结果,最后返回的值恰好是第一个target的位置。同理再找一遍target+1,返回的值-1恰好为最后一个target的位置
-
代码
class Solution {public int[] searchRange(int[] nums, int target) {int[] ans = new int[2];int start = biSearch(nums,target);if(start==nums.length || nums[start]!=target){ans[0] = ans[1] = -1;return ans;}int end = biSearch(nums,target+1);ans[0] = start;ans[1] = end-1;return ans;}private int biSearch(int[] nums,int target){int left = 0;int right = nums.length-1;while(left<=right){int mid = (right-left)/2+left;if(nums[mid]<target){left = mid+1;}else if(nums[mid]>target){right = mid-1;}else{right = mid-1;}//此处可简写为//else right = mid-1; 为了方便理解拆开来写了}return left;}}
33. 搜索旋转排序数组
-
题目
整数数组
nums按升序排列,数组中的值 互不相同 。在传递给函数之前,
nums在预先未知的某个下标k(0 <= k < nums.length)上进行了 向左旋转,使数组变为[nums[k], nums[k+1], ..., nums[n-1], nums[0], nums[1], ..., nums[k-1]](下标 从 0 开始 计数)。例如,[0,1,2,4,5,6,7]下标3上向左旋转后可能变为[4,5,6,7,0,1,2]。给你 旋转后 的数组
nums和一个整数target,如果nums中存在这个目标值target,则返回它的下标,否则返回-1。你必须设计一个时间复杂度为
O(log n)的算法解决此问题。示例 1:
输入:nums = [4,5,6,7,0,1,2], target = 0输出:4示例 2:
输入:nums = [4,5,6,7,0,1,2], target = 3输出:-1示例 3:
输入:nums = [1], target = 0输出:-1提示:
1 <= nums.length <= 5000-104 <= nums[i] <= 104nums中的每个值都 独一无二- 题目数据保证
nums在预先未知的某个下标上进行了旋转 -104 <= target <= 104
-
思路
旋转后的数组的大小关系如图所示。第一段的最小值要大于第二段的最大值,且两端都是递增趋势
如此一来,我们若正常二分,得到的mid有两种可能
- 是连续的,不连续,此时的mid在第一段内
- 若target在 之间,令 继续二分
- 若target在之间,令 继续二分
- 是不连续的,连续,此时的mid在第二段内
- 若target在之间,令 继续二分
- 若target在 之间,令 继续二分
编写代码时注意边界条件
- 是连续的,不连续,此时的mid在第一段内
-
代码
class Solution {public int search(int[] nums, int target) {int left = 0;int right = nums.length-1;while(left<=right){int mid = (right-left)/2+left;if(nums[mid] == target){return mid;}if(nums[mid]>=nums[left]){//mid落在第一段内if(target>=nums[left] && target<nums[mid]){right = mid-1;}else{left = mid+1;}}else{//mid落在第二段内if(target>nums[mid] && target<=nums[right]){left = mid+1;}else{right = mid-1;}}}return -1;}}
153. 寻找旋转排序数组中的最小值
-
题目
已知一个长度为
n的数组,预先按照升序排列,经由1到n次 旋转 后,得到输入数组。例如,原数组nums = [0,1,2,4,5,6,7]在变化后可能得到:- 若旋转
4次,则可以得到[4,5,6,7,0,1,2] - 若旋转
7次,则可以得到[0,1,2,4,5,6,7]
注意,数组
[a[0], a[1], a[2], ..., a[n-1]]旋转一次 的结果为数组[a[n-1], a[0], a[1], a[2], ..., a[n-2]]。给你一个元素值 互不相同 的数组
nums,它原来是一个升序排列的数组,并按上述情形进行了多次旋转。请你找出并返回数组中的 最小元素 。你必须设计一个时间复杂度为
O(log n)的算法解决此问题。示例 1:
输入:nums = [3,4,5,1,2]输出:1解释:原数组为 [1,2,3,4,5] ,旋转 3 次得到输入数组。示例 2:
输入:nums = [4,5,6,7,0,1,2]输出:0解释:原数组为 [0,1,2,4,5,6,7] ,旋转 4 次得到输入数组。示例 3:
输入:nums = [11,13,15,17]输出:11解释:原数组为 [11,13,15,17] ,旋转 4 次得到输入数组。提示:
n == nums.length1 <= n <= 5000-5000 <= nums[i] <= 5000nums中的所有整数 互不相同nums原来是一个升序排序的数组,并进行了1至n次旋转
- 若旋转
-
思路
原理同上一题
当mid落在第一段内时,最小值肯定在右边,left = mid+1
当mid落在第二段内时,最小值在左边,或最小值在mid上 ,right = mid
Tip:当mid落在第二段里时,mid可能指向最小值,所以right = mid 而非mid-1
按照上述两个步骤循环后,left、right都会一直向中间缩,当第一次为单调区间时,此时left的值肯定是最小值
原因:
只有当mid在第一段内时,left才有可能移动,且每次移动都只是比mid多走一个索引而已,所以当区间恰好(第一次)是单调区间,则left只有可能在那个交界点
-
代码
class Solution {public int findMin(int[] nums) {int left = 0,right = nums.length-1;while(left<=right){int mid = (right-left)/2+left;if(nums[left]<=nums[right]){return nums[left];}if(nums[mid]>=nums[left]){left = mid+1;}else{right = mid;}}return -1;}}
4. 寻找两个正序数组的中位数
-
题目
给定两个大小分别为
m和n的正序(从小到大)数组nums1和nums2。请你找出并返回这两个正序数组的 中位数 。算法的时间复杂度应该为
O(log (m+n))。示例 1:
输入:nums1 = [1,3], nums2 = [2]输出:2.00000解释:合并数组 = [1,2,3] ,中位数 2示例 2:
输入:nums1 = [1,2], nums2 = [3,4]输出:2.50000解释:合并数组 = [1,2,3,4] ,中位数 (2 + 3) / 2 = 2.5提示:
nums1.length == mnums2.length == n0 <= m <= 10000 <= n <= 10001 <= m + n <= 2000-106 <= nums1[i], nums2[i] <= 106
-
思路
视频 多看多消化!!!
-
中位数即两个数组合并后大小在中间的那个数,若总长度为奇数,则中位数恰好在中间;若长度为偶数,中位数则是两数之和/2
-
由此我们可以在较短的那个数组上不断地去寻找切割点,将数组切割为两份。再由较短数组切割后两份的个数去得出较长数组的切割点。使得切割后左半部分与右半部分的数字个数一致 (若为奇数则左半部分多一个)
-
切割完成后,只要满足左半部分所有数都小于右半部分的任意一个数即可。由于两个数组本身是有序的,所以我们只需要考虑切割点的四个数之间的大小关系:left1、right1、left2、right2,由于这个是一定的。所以只需要满足 即可
-
为方便理解,可以将两个数组切割出来的左半部分假想成用绳子串起来。绳子的两个端点即为切割点
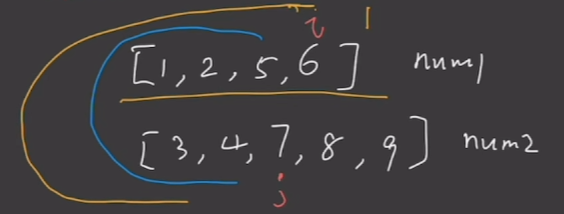
如图:蓝色部分是正确的两个端点,绳长为 。在绳长不变的情况下,我们需要在数组中找到正确的切割点,当时,则说明当前切割点太靠后了;反之太靠前了。这个寻找切割点的过程就可以使用二分,如此一来,时间复杂度 =
-
-
代码
class Solution {private static final int MAX = Integer.MAX_VALUE;private static final int MIN = Integer.MIN_VALUE;public double findMedianSortedArrays(int[] nums1, int[] nums2) {if(nums1.length > nums2.length){int[] temp = nums1;nums1 = nums2;nums2 = temp;}//由于前面可能发生交换,所以应当在交换后再进行长度的计算int m = nums1.length;int n = nums2.length;int left = 0,right = m;while(left<=right){int mid1 = (right-left)/2+left;int mid2 = (m+n+1)/2 - mid1;int left1 = mid1==0?MIN:nums1[mid1-1];int right1 = mid1==m?MAX:nums1[mid1];int left2 = mid2==0?MIN:nums2[mid2-1];int right2 = mid2==n?MAX:nums2[mid2];if(left1<=right2 && left2<=right1){if((m+n)%2==1){return (double)Math.max(left1,left2);}return (Math.max(left1,left2)+Math.min(right1,right2))/2.0;}else if(left1>right2){right = mid1-1;}else{left = mid1+1;}}return 0;}}
栈
20. 有效的括号
-
题目
给定一个只包括
'(',')','{','}','[',']'的字符串s,判断字符串是否有效。有效字符串需满足:
- 左括号必须用相同类型的右括号闭合。
- 左括号必须以正确的顺序闭合。
- 每个右括号都有一个对应的相同类型的左括号。
示例 1:
**输入:**s = ”()”
**输出:**true
示例 2:
**输入:**s = ”()[]{}”
**输出:**true
示例 3:
**输入:**s = ”(]”
**输出:**false
示例 4:
**输入:**s = ”([])”
**输出:**true
示例 5:
**输入:**s = ”([)]”
**输出:**false
提示:
1 <= s.length <= 104s仅由括号'()[]{}'组成
-
思路
用Deque双端队列模拟栈。可以直接使用if else去判断括号是否匹配。这里采用HashMap存储映射关系的方法去判断括号是否匹配
-
代码
class Solution {public boolean isValid(String s) {if(s.length()%2==1){return false; //不可能为奇数}//用map存储合法的括号,用于映射右括号Map<Character,Character> map = new HashMap<>();map.put('(',')');map.put('[',']');map.put('{','}');Deque<Character> st = new ArrayDeque<>();//使用双端队列模拟栈for(char c : s.toCharArray()){if(map.containsKey(c)){//左括号st.push(map.get(c));//存入相应右括号}else if(st.isEmpty() || st.pop()!=c){//取到的是右括号时:栈为空或栈顶不是相匹配的时候,匹配失败return false;}}return st.isEmpty();//所有左括号匹配完毕}}
155. 最小栈
-
题目
设计一个支持
push,pop,top操作,并能在常数时间内检索到最小元素的栈。实现
MinStack类:MinStack()初始化堆栈对象。void push(int value)将元素value推入堆栈。void pop()删除堆栈顶部的元素。int top()获取堆栈顶部的元素。int getMin()获取堆栈中的最小元素。
示例 1:
输入:["MinStack","push","push","push","getMin","pop","top","getMin"][[],[-2],[0],[-3],[],[],[],[]]输出:[null,null,null,null,-3,null,0,-2]解释:MinStack minStack = new MinStack();minStack.push(-2);minStack.push(0);minStack.push(-3);minStack.getMin(); --> 返回 -3.minStack.pop();minStack.top(); --> 返回 0.minStack.getMin(); --> 返回 -2.提示:
-231 <= val <= 231 - 1pop、top和getMin操作总是在 非空栈 上调用push,pop,top, andgetMin最多被调用3 * 104次
-
思路
使用Deque模拟栈。
该题的难点在于记录最小值 — 当栈内元素进行push和pop时,最小元素都有可能变。如果要保持最小值与栈内元素实时对应的话,需要额外的空间去记录最小值
-
最小栈方法
除了记录数据的栈A以外,再来一个记录最小值的栈B,当栈A每push一个值,就将栈B的栈顶元素与其对比,若B的栈顶元素<=push进来的值,则入栈; 每当栈Apop一个值时,看看pop出去的是不是栈B的栈顶元素(当前最小值),若是,则将B也pop,实现最小值的实时更新
-
前缀和维护法
维护一个min变量。栈A内不再直接存储元素的值。而是存储元素值-最小值。
-
push元素时
将value-min存入栈中
- 若value-min>0,说明当前value比min大,无需更新最小值
- 若value-min<0,更新最小值
-
pop元素时
弹出栈顶元素
- 若栈顶元素>0,也就是value-min>0,说明弹出的元素不是最小值,无需更新min
- 若栈顶元素<0,也就是value-min<0 ,说明弹出的元素是最小值,此时我们就需要更新min为当前弹出的value了,即:min = min-栈顶元素
-
top查看栈顶元素时
- 若栈顶元素>0,也就是value-min>0,说明栈顶的元素不是最小值,返回的value = min+栈顶元素值
- 若栈顶元素<0,也就是value-min<0 ,说明栈顶的元素是最小值,返回min。 — 由于存储时遇到最小值value更新前会将 value - 上一个min 存入。然后将 min更新为当前的value,所以真正的value应该就是当前的min
-
-
-
代码
class MinStack {private long min = Long.MAX_VALUE/2; //防止value-min溢出,此处/2private final Deque<Long> st = new ArrayDeque<>(); //存储Long类型的,防止存入Integer的最值public MinStack() {}public void push(int value) {st.push(value-min);min = Math.min(min,value);//更新最小值}public void pop() {min-=Math.min(st.pop(),0);//更新最小值(//弹出的差值<0时说明弹出的是最小值,需要将当前最小值更新为上一个最小值)}public int top() {return (int)(min+Math.max(st.peek(),0));//peek()取出栈顶元素}public int getMin() {return (int)min;}}/*** Your MinStack object will be instantiated and called as such:* MinStack obj = new MinStack();* obj.push(value);* obj.pop();* int param_3 = obj.top();* int param_4 = obj.getMin();*/
394. 字符串解码
-
题目
给定一个经过编码的字符串,返回它解码后的字符串。
编码规则为:
k[encoded_string],表示其中方括号内部的encoded_string正好重复k次。注意k保证为正整数。你可以认为输入字符串总是有效的;输入字符串中没有额外的空格,且输入的方括号总是符合格式要求的。
此外,你可以认为原始数据不包含数字,所有的数字只表示重复的次数
k,例如不会出现像3a或2[4]的输入。测试用例保证输出的长度不会超过
105。示例 1:
输入:s = "3[a]2[bc]"输出:"aaabcbc"示例 2:
输入:s = "3[a2[c]]"输出:"accaccacc"示例 3:
输入:s = "2[abc]3[cd]ef"输出:"abcabccdcdcdef"示例 4:
输入:s = "abc3[cd]xyz"输出:"abccdcdcdxyz"提示:
1 <= s.length <= 30s由小写英文字母、数字和方括号'[]'组成s保证是一个 有效 的输入。s中所有整数的取值范围为[1, 300]
-
思路
栈要定义为存储String类型的栈 — 拼接完字符串后还要放回栈中
- 在碰到
‘]’前,直接入栈 - 碰到
‘]’时,进行以下操作- 弹栈并拼接,直到遇见
‘[’,这一步相当于将“[]”中的字符都取出来,将“[]”中的字符串拼接出来 - 弹栈,判断是否为数字,若是则进行拼接。这一步是为了拼接出要重复的次数
- 得到字符串和需要重复的次数后,进行重复的处理后再次入栈
- 弹栈并拼接,直到遇见
以
“3[a2[bc]]”为例-
一直入栈直到遇到第一个
‘]’,此时栈中有“3”,"[","a","2","[","b","c"。 -
遇到
‘]’时-
使用StringBuilder开始拼接
[]中的字符串,得到“cb” -
使用StringBuilder拼接重复次数,得到
“2”,调用String的repeat API得到“cbcb”Tip:若为重复次数为20,得到的字符串就是
“02”,所以此处注意reverse才能得到真正的重复次数 -
得到
“cbcb”后重新压入栈中,此时栈中有“3”,"[","a","cbcb" -
后续同理可得
“bcbca|bcbca|bcbca”(为方便查看使用|隔开) -
将结果从栈中弹出并reverse
Tip:如果遇到
"3[a]2[bc]"这样的用例,最后栈中应当是“aaa”,"cbcb"这样多个平级的结果,所以最后要用while循环把栈弹空,都拼接到StringBuilder上得到“bcbcaaa”再reverse -
- 在碰到
-
代码
多看看,掌握String、StringBuilder、Character相关的API!!!
class Solution {public String decodeString(String s) {Deque<String> st = new ArrayDeque<>();for(char c : s.toCharArray()){if(c!=']'){st.push(c+"");}else{StringBuilder sb = new StringBuilder();//拼接字符//注意:比较字符串使用equals!!!while(!st.peek().equals("[")){sb.append(st.pop());}st.pop();//弹出左括号//重复次数StringBuilder num = new StringBuilder();while(!st.isEmpty() && isDigit(st.peek())){num.append(st.pop());}//注意逆置int sum = Integer.valueOf(num.reverse().toString());//将结果重新入栈st.push(sb.toString().repeat(sum));//repeat API, "abc".repeat(2) ---> "abcabc"}}StringBuilder ans = new StringBuilder();while(!st.isEmpty()){ans.append(st.pop());}return ans.reverse().toString();}//针对 "1" "2" ... 判断是否为数字private boolean isDigit(String str){return Character.isDigit(str.charAt(0));}}
739. 每日温度
-
题目
给定一个整数数组
temperatures,表示每天的温度,返回一个数组answer,其中answer[i]是指对于第i天,下一个更高温度出现在几天后。如果气温在这之后都不会升高,请在该位置用0来代替。示例 1:
输入: temperatures = [73,74,75,71,69,72,76,73]输出: [1,1,4,2,1,1,0,0]示例 2:
输入: temperatures = [30,40,50,60]输出: [1,1,1,0]示例 3:
输入: temperatures = [30,60,90]输出: [1,1,0]提示:
1 <= temperatures.length <= 105- `30 <= temperatures[i] <= 100
-
思路
单调栈。下标入栈,维护栈的单调性
以上图为例,从右向左遍历,结果存入ans数组,为方便理解,此处直接以数字入栈为例,代码中需要是下标入栈 — 下标入栈的话就可以直接根据下标去计算出中间相隔的天数,且可以通过下标找到气温用以比较
6,栈为空,代表后面没有比起温度更高的了,所以ans[7] = 0,6入栈3,栈顶元素6大于它,下标相减得到结果存入ans[6],3入栈2,栈顶元素3大于它,下标相减得到结果存入ans[5],2入栈5,栈顶元素2小于它,弹出,弹出后3仍小于它,弹出。直到栈顶元素为6大于它,下标相减得到结果存入ans[4],5入栈5,栈顶元素5等于它,弹出。弹出后栈顶元素为6大于它,下标相减得到结果存入ans[3],5入栈3,栈顶元素5大于它,下标相减得到结果存入ans[2],3入栈4,弹出3后栈顶元素5大于它,下标相减得到结果存入ans[1],3入栈1,栈顶元素4大于它,下标相减得到结果存入ans[0],1入栈
-
代码
class Solution {public int[] dailyTemperatures(int[] temperatures) {Deque<Integer> st = new ArrayDeque<>();int n = temperatures.length;int[] ans = new int[n];for(int i = n-1;i>=0;i--){int t = temperatures[i];//temperatures[st.peek()]得到栈顶下标气温while(!st.isEmpty() && temperatures[st.peek()]<=t){st.pop();}if(st.isEmpty()){//栈为空说明后面没有更高温的了ans[i] = 0;}else{//下标相减得到天数ans[i] = st.peek()-i;}st.push(i);}return ans;}}
84. 柱状图中最大的矩形
-
题目
给定 n 个非负整数,用来表示柱状图中各个柱子的高度。每个柱子彼此相邻,且宽度为 1 。
求在该柱状图中,能够勾勒出来的矩形的最大面积。
示例 1:
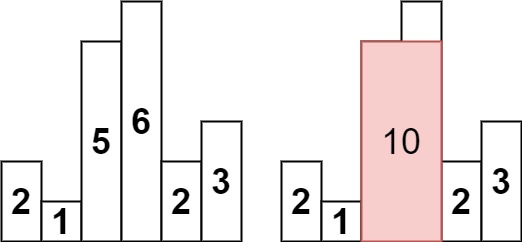 输入:heights = [2,1,5,6,2,3]输出:10解释:最大的矩形为图中红色区域,面积为 10
示例 2:
 输入: heights = [2,4]输出: 4
提示:
1 <= heights.length <=1050 <= heights[i] <= 104
-
思路
以此为例
-
如何计算下标为i的格子可以达到的最大面积?
以上图为例。下标为2的格子(也就是高度为5的那个格子),向左找到第一个比他矮的格子(下标为1,高度为1);向右找到第一个比它矮的格子(下标为4,高度为2)。如此一来就可以求出最大面积:
由此可以推断出一般式为 其中 分别为下标为i的格子左边第一个比它矮的格子下标和右边第一个比它矮的格子下标
-
有了这个式子后只需求出每个格所能构成的最大面积取最大值(即求取数组),但是如何更高效地求取?
可以使用单调栈 ,达成一次遍历就可以求出
同样以此图为例,当向右遍历时按照 的顺序。
-
2的左边没有格子,所以应当初始化数组为-1,这样计算长度的时候才不会出错;同理3的右边没有格子,所以初始化数组为 长度才不会出错
-
遍历过程中维护单调栈
- 若当前格子高度 >= 栈顶的格子高度。则说明当前格子是栈顶那个格子的“右边界”,将当前格子索引填入栈顶格子的 中 , 并且将栈顶元素弹出 — 原因:当前元素比栈顶格子更矮,且当前格子的位置在栈顶格子的右边,后面的格子找 时有可能找到当前格子而不可能找到栈顶格子
- 若当前格子高度< 栈顶格子高度。则说明栈顶格子是当前这个格子的“左边界”,将栈顶格子索引填入当前格子的 中
最后别忘了将当前格子的索引入栈
-
-
-
代码
class Solution {public int largestRectangleArea(int[] heights) {Deque<Integer> st = new ArrayDeque<>();//保存下标int ans = -1;int n = heights.length;int[] left = new int[n];int[] right = new int[n];//初始化数组for(int i = 0;i<n;i++){left[i] = -1;right[i] = n;}for(int i = 0;i<n;i++){while(!st.isEmpty() && heights[st.peek()]>= heights[i]){int idx = st.pop();right[idx] = i;}if(!st.isEmpty()){//栈为空说明左边没有比i更短的,非空说明有比i更短的left[i] = st.peek();}st.push(i);}for(int i = 0;i<n;i++){int len = right[i] - left[i] -1;ans = Math.max(ans,len*heights[i]);}return ans;}}
32. 最长有效括号
-
题目
给你一个只包含
'('和')'的字符串,找出最长有效(格式正确且连续)括号 子串 的长度。左右括号匹配,即每个左括号都有对应的右括号将其闭合的字符串是格式正确的,比如
"(()())"。示例 1:
输入:s = "(()"输出:2解释:最长有效括号子串是 "()"示例 2:
输入:s = ")()())"输出:4解释:最长有效括号子串是 "()()"示例 3:
输入:s = ""输出:0提示:
0 <= s.length <= 3 * 104s[i]为'('或')'
-
思路
使用栈,存储左括号,遇到右括号弹出。不过有以下几点需要注意
-
因为要知道有效括号的长度,所以此处用左括号的索引入栈。如此一来,当栈空了后可以根据索引计算有效长度
-
栈底需要有一个哨兵索引 — 当出现
“()()()()…”这样多个连续括号出现时,若没有栈底哨兵,每匹配一个括号,栈就会变空。但如果有了栈底哨兵,就算匹配了一个括号,栈中依旧有哨兵的存在。方便计算有效长度“… 有效括号部分….”,在有效括号部分
‘('、')'的数量一定是相等的。也就是说在**出有效部分之前,栈底的哨兵一直在。**只有在出了有效部分(左右括号数量失衡)时,栈底哨兵才会被弹出 -
当匹配一个括号后(遇到
)并弹栈后)- 若栈为空,并且则压入新的哨兵,代表着这个有效部分已经结束了,开始计算下一个有效部分的长度
- 若栈不为空,更新长度, 注意是栈顶!!!
-
例子
s = ")()())"为例- 栈中为空压入哨兵索引(默认-1) 栈:
-1 - 遍历s,为右括号,弹栈,栈为空,压入作为新哨兵
- 为左括号,压栈。为右括号弹栈 ,栈不为空,更新长度;压栈,弹栈,栈不为空,更新长度
- 为右括号,弹栈,栈为空,新哨兵入栈
,遇到这种情况时,匹配一个右括号后,哨兵仍为-1。所以更新长度需要用
- 栈中为空压入哨兵索引(默认-1) 栈:
-
-
代码
class Solution {public int longestValidParentheses(String s) {char[] str = s.toCharArray();int n = str.length;Deque<Integer> st = new ArrayDeque<>();st.push(-1);int ans = 0;for(int i = 0;i<n;i++){char c = str[i];if(c=='('){st.push(i);}else{int t = st.pop();if(st.isEmpty()){st.push(i);}else{ans = Math.max(ans,i-st.peek());}}}return ans;}}
堆
215. 数组中的第K个最大元素
-
题目
给定整数数组
nums和整数k,请返回数组中第**k**个最大的元素。请注意,你需要找的是数组排序后的第
k个最大的元素,而不是第k个不同的元素。你必须设计并实现时间复杂度为
O(n)的算法解决此问题。示例 1:
输入: [3,2,1,5,6,4], k = 2输出: 5示例 2:
输入: [3,2,3,1,2,4,5,5,6], k = 4输出: 4提示:
1 <= k <= nums.length <= 105
-
-104 <= nums[i] <= 104 -
思路
- 堆排序,大根堆,直到找到第k大的,不过此处下标从0开始,注意一下下标之间的变化
- 快速排序思想,但是实现复杂,若是遇到相对有序的数组,时间复杂度容易变为O(n^2^),灵神的题解后续可以研究一下,它的解法可以使得整个排序过程保持随机,partition后pivot两侧的数字分布均匀随机
Tip:使用堆排的好处:堆排的时间复杂度不受数据有序性的干扰,可以使得最后的时间稳定在30ms左右
但是使用堆派无法到达O(n)的时间复杂度,时间复杂度只能在O(nlogn)左右
但是使用快排又需要可以维护数据的随机性
-
代码
class Solution {private void heapAdjust(int[] nums,int s,int len){int temp = nums[s];//下标从0开始,注意这里是 i = i*2+1for(int i = s*2+1 ;i<len;i = i*2+1){if(i<len-1 && nums[i+1] > nums[i])i++;if(temp>nums[i]){break;}nums[s] = nums[i];s = i;}nums[s] = temp;}private void heapCreate(int[] nums){int n = nums.length;for(int i = (n-2)/2;i>=0;i--){heapAdjust(nums,i,n);}}public int findKthLargest(int[] nums, int k) {heapCreate(nums);int n = nums.length;for(int i = 0;i<k-1;i++){int temp = nums[0];nums[0] = nums[n-1-i];nums[n-1-i] = temp;heapAdjust(nums,0,n-1-i);}return nums[0];}}
347. 前 K 个高频元素
-
题目
给你一个整数数组
nums和一个整数k,请你返回其中出现频率前k高的元素。你可以按 任意顺序 返回答案。示例 1:
**输入:**nums = [1,1,1,2,2,3], k = 2
输出:[1,2]
示例 2:
**输入:**nums = [1], k = 1
输出:[1]
示例 3:
**输入:**nums = [1,2,1,2,1,2,3,1,3,2], k = 2
输出:[1,2]
提示:
1 <= nums.length <= 105-104 <= nums[i] <= 104k的取值范围是[1, 数组中不相同的元素的个数]- 题目数据保证答案唯一,换句话说,数组中前
k个高频元素的集合是唯一的
**进阶:**你所设计算法的时间复杂度 必须 优于
O(n log n),其中n是数组大小。 -
思路
-
大根堆排序。 使用哈希表记录各个数字出现的次数后,存入堆(优先队列实现)中,最后取出前k个
注意:此处的堆使用优先队列这个类实现,可以熟悉一下API
-
桶排序,使用哈希表记录各个数字出现的次数后,将出现次数相同的key存入同一个桶。取的时候从后往前取出k个
-
-
代码
大根堆(优先队列)
class Solution {public int[] topKFrequent(int[] nums, int k) {Map<Integer,Integer> cnt = new HashMap<>();for(int x: nums){cnt.merge(x,1,Integer::sum); //cnt[x]++ 统计出现次数}//大根堆//排序规则:从hash表中取出出现次数并排序Queue<Integer> q = new PriorityQueue<>((a,b)->cnt.get(b) - cnt.get(a));cnt.forEach((key,value)->{q.offer(key);});int[] ans = new int[k];for(int i = 0;i<k;i++){ans[i] = q.poll();}return ans;}}桶排序
class Solution {public int[] topKFrequent(int[] nums, int k) {Map<Integer,Integer> cnt = new HashMap<>();for(int x: nums){cnt.merge(x,1,Integer::sum); //cnt[x]++ 统计出现次数}int maxCnt = Collections.max(cnt.values()); //最大出现次数//桶,一个桶里面有多个链表 --- 会有出现次数相同的数字List<Integer>[] bucket = new ArrayList[maxCnt+1];for(int i = 0;i<maxCnt+1;i++){//桶的初始化bucket[i] = new ArrayList<>();}cnt.forEach((key,value)->{bucket[value].add(key); //出现次数为value的桶内添加key});int[] ans = new int[k];int count = 0;for(int i = maxCnt;count<k;i--){for(int j : bucket[i]){ans[count++] = j;}}return ans;}}
295. 数据流的中位数
-
题目
中位数是有序整数列表中的中间值。如果列表的大小是偶数,则没有中间值,中位数是两个中间值的平均值。
- 例如
arr = [2,3,4]的中位数是3。 - 例如
arr = [2,3]的中位数是(2 + 3) / 2 = 2.5。
实现 MedianFinder 类:
MedianFinder()初始化MedianFinder对象。void addNum(int num)将数据流中的整数num添加到数据结构中。double findMedian()返回到目前为止所有元素的中位数。与实际答案相差10-5以内的答案将被接受。
示例 1:
输入["MedianFinder", "addNum", "addNum", "findMedian", "addNum", "findMedian"][[], [1], [2], [], [3], []]输出[null, null, null, 1.5, null, 2.0]解释MedianFinder medianFinder = new MedianFinder();medianFinder.addNum(1); // arr = [1]medianFinder.addNum(2); // arr = [1, 2]medianFinder.findMedian(); // 返回 1.5 ((1 + 2) / 2)medianFinder.addNum(3); // arr[1, 2, 3]medianFinder.findMedian(); // return 2.0提示:
-105 <= num <= 105- 在调用
findMedian之前,数据结构中至少有一个元素 - 最多
5 * 104次调用addNum和findMedian
- 例如
-
思路
使用两个堆 — , 需满足以下几点
- 与存储的数字个数相等(偶数情况下),或多一个(奇数情况下)
- 中的任意一个元素都要比中的任意一个元素小,即:中的最大值要小于中的最小值 — 这一点通过堆就能很好地去判断、实现 — 以此可知,为了方便操作,需要是大根堆需要是小根堆
- 添加元素时,假设现在已经有了
- 如果当前 left 的大小和 right 的大小相等:
- 如果添加的数字 num 比较大,比如添加 7,那么把 7 加到 right 中。现在 left 比 right 少 1 个数,不符合前文的规定,所以必须把 right 的最小值从 right 中去掉,添加到 left 中。如此操作后,可以保证 left 的所有元素都小于等于 right 的所有元素。
- 如果添加的数字 **num 比较小,**比如添加 0,那么把 0 加到 left 中。
- 这两种情况可以合并:无论 num 是大是小,都可以先把 num 加到 right 中,然后把 right 的最小值从 right 中去掉,并添加到 left 中。
- 如果当前 left 比 right 多 1 个数:
- 如果添加的数字 num 比较大,比如添加 7,那么把 7 加到 right 中。
- 如果添加的数字 num 比较小,比如添加 0,那么把 0 加到 left 中。现在 left 比 right 多 2 个数,不符合前文的规定,所以必须把 left 的最大值从 left 中去掉,添加到 right 中。如此操作后,可以保证 left 的所有元素都小于等于 right 的所有元素。
- 这两种情况可以合并:无论 num 是大是小,都可以先把 num 加到 left 中,然后把 left 的最大值从 left 中去掉,并添加到 right 中。
- 如果当前 left 的大小和 right 的大小相等:
- 返回答案时
- 如果当前有奇数个元素,中位数是 left 的堆顶。
- 如果当前有偶数个元素,中位数是 left 的堆顶和 right 的堆顶的平均值。
-
代码
class MedianFinder {private final PriorityQueue<Integer> left = new PriorityQueue<>((a,b)->b-a);private final PriorityQueue<Integer> right = new PriorityQueue<>();public MedianFinder() {}public void addNum(int num) {if(left.size()==right.size()){//left、right个数相同时,将新数据加入right,并将right中的最小值存入leftright.offer(num);left.offer(right.poll());}else{//left个数比right多一个时,将新数据加入left,并将left中的最大值存入rightleft.offer(num);right.offer(left.poll());}}public double findMedian() {if(left.size()>right.size()){return left.peek();}return (left.peek()+right.peek())/2.0;}}/*** Your MedianFinder object will be instantiated and called as such:* MedianFinder obj = new MedianFinder();* obj.addNum(num);* double param_2 = obj.findMedian();*/
贪心
121. 买卖股票的最佳时机
-
题目
给定一个数组
prices,它的第i个元素prices[i]表示一支给定股票第i天的价格。你只能选择 某一天 买入这只股票,并选择在 未来的某一个不同的日子 卖出该股票。设计一个算法来计算你所能获取的最大利润。
返回你可以从这笔交易中获取的最大利润。如果你不能获取任何利润,返回
0。示例 1:
输入:[7,1,5,3,6,4]输出:5解释:在第 2 天(股票价格 = 1)的时候买入,在第 5 天(股票价格 = 6)的时候卖出,最大利润 = 6-1 = 5 。注意利润不能是 7-1 = 6, 因为卖出价格需要大于买入价格;同时,你不能在买入前卖出股票。示例 2:
输入:prices = [7,6,4,3,1]输出:0解释:在这种情况下, 没有交易完成, 所以最大利润为 0。提示:
1 <= prices.length <= 1050 <= prices[i] <= 104
-
思路
贪心,要使得利润最大只需要满足
- 买入要在卖出前面
- 找到最大差值
如此一来,在遍历数组的过程中不断更新最小值,保证当前的min是 的最小值,再不断用得到第天卖可以获得的最大利润,从天内取到最大利润
-
代码
class Solution {public int maxProfit(int[] prices) {int min = Integer.MAX_VALUE;int ans = 0;for(int i = 0;i<prices.length;i++){min = Math.min(min,prices[i]);ans = Math.max(ans,prices[i] - min);}return ans;}}
55. 跳跃游戏
-
题目
给你一个非负整数数组
nums,你最初位于数组的 第一个下标 。数组中的每个元素代表你在该位置可以跳跃的最大长度。判断你是否能够到达最后一个下标,如果可以,返回
true;否则,返回false。示例 1:
输入:nums = [2,3,1,1,4]输出:true解释:可以先跳 1 步,从下标 0 到达下标 1, 然后再从下标 1 跳 3 步到达最后一个下标。示例 2:
输入:nums = [3,2,1,0,4]输出:false解释:无论怎样,总会到达下标为 3 的位置。但该下标的最大跳跃长度是 0 , 所以永远不可能到达最后一个下标。提示:
1 <= nums.length <= 1040 <= nums[i] <= 105
-
思路
贪心,在跳到第格的时候,计算从第格可以到达的最远的格,即:,并在遍历过程中记录可以到达的最远格数。若在遍历过程中发现则说明在的区间内,是不能跳到的,返回false
-
代码
class Solution {public boolean canJump(int[] nums) {int max = 0;for(int i = 0;i<nums.length;i++){if(i>max){return false;}max = Math.max(max,i+nums[i]);}return true;}}
45. 跳跃游戏 II
-
题目
给定一个长度为
n的 0 索引整数数组nums。初始位置在下标 0。每个元素
nums[i]表示从索引i向后跳转的最大长度。换句话说,如果你在索引i处,你可以跳转到任意(i + j)处:0 <= j <= nums[i]且i + j < n
返回到达
n - 1的最小跳跃次数。测试用例保证可以到达n - 1。示例 1:
输入: nums = [2,3,1,1,4]输出: 2解释: 跳到最后一个位置的最小跳跃数是 2。从下标为 0 跳到下标为 1 的位置,跳 1 步,然后跳 3 步到达数组的最后一个位置。示例 2:
输入: nums = [2,3,0,1,4]输出: 2提示:
1 <= nums.length <= 1040 <= nums[i] <= 1000- 题目保证可以到达
n - 1
-
思路

如图所示,对于,区间是都可以达到的,这个区间被称为自由区间
- 第一次最大自由的区间为,我们可以到达的最远的位置是 ,
- 第二次最大自由的区间是,在这个区间内我们更新我们可以跳到的最大距离 ,当我们走到时(无路可走了),就对
- 第三次最大自由的区间是,注意:由于题目是保证可以走到的,那么就分以下两种情况
- 的位置恰好是该段自由区间的终点,那么还需对
- 的位置不是该段自由区间的终点,那么无需对了。但是若恰好为该段自由区间终点,代码逻辑还是会对,所以只需遍历到即可
-
代码
class Solution {public int jump(int[] nums) {int ans = 0;int curEnd = 0;//当前可以到达的最远距离int nextEnd = 0;//记录当前自由区间内可以到达的最远距离for(int i = 0;i<nums.length-1;i++){nextEnd = Math.max(nextEnd,i+nums[i]);if(i==curEnd){//走到头了就ans++,并且更新可以到达的最远距离([i,nextEnd]即为下一段自由区间)curEnd = nextEnd;ans++;}}return ans;}}
763. 划分字母区间
-
题目
给你一个字符串
s。我们要把这个字符串划分为尽可能多的片段,同一字母最多出现在一个片段中。例如,字符串"ababcc"能够被分为["abab", "cc"],但类似["aba", "bcc"]或["ab", "ab", "cc"]的划分是非法的。注意,划分结果需要满足:将所有划分结果按顺序连接,得到的字符串仍然是
s。返回一个表示每个字符串片段的长度的列表。
示例 1:
输入:s = "ababcbacadefegdehijhklij"输出:[9,7,8]解释:划分结果为 "ababcbaca"、"defegde"、"hijhklij" 。每个字母最多出现在一个片段中。像 "ababcbacadefegde", "hijhklij" 这样的划分是错误的,因为划分的片段数较少。示例 2:
输入:s = "eccbbbbdec"输出:[10]提示:
1 <= s.length <= 500s仅由小写英文字母组成
-
思路
先用哈希表记录每个字母最右侧的坐标,然后枚举s中的字母,不断扩展当前能到达的最右侧坐标,如果当前字母坐标和当前最右侧坐标相同,则到达一个片段结尾
为什么当前字母坐标和当前最右侧坐标相同就是片段结尾?
以为例,一个片段的特点为:某片段内出现的所有字母在外面都不会出现,如:当我们遍历这个片段时,这里的所有字母(‘a’,‘b’,‘c’)可以到达的最远索引就是8,只要不出现新的字母当前最右坐标永远不会变,只能等着我们遍历过来
-
代码
class Solution {public List<Integer> partitionLabels(String s) {char[] str = s.toCharArray();int n = str.length;int[] last = new int[26];for(int i = 0;i<n;i++){last[str[i]-'a'] = i;//记录每个字母可以到达的最远距离}List<Integer> ans = new ArrayList<>();int maxDis = 0;int len = 0;for(int i = 0;i<n;i++){maxDis = Math.max(maxDis,last[str[i]-'a']);len++;if(i==maxDis){ans.add(len);len = 0;}}return ans;}}
动态规划
70. 爬楼梯
-
题目
假设你正在爬楼梯。需要
n阶你才能到达楼顶。每次你可以爬
1或2个台阶。你有多少种不同的方法可以爬到楼顶呢?示例 1:
输入:n = 2输出:2解释:有两种方法可以爬到楼顶。1. 1 阶 + 1 阶2. 2 阶示例 2:
输入:n = 3输出:3解释:有三种方法可以爬到楼顶。1. 1 阶 + 1 阶 + 1 阶2. 1 阶 + 2 阶3. 2 阶 + 1 阶提示:
1 <= n <= 45
-
思路
斐波那契
-
代码
class Solution {public int climbStairs(int n) {if(n==1 || n==2){return n;}int t1 = 1;int t2 = 2;int ans = 0;for(int i = 3;i<=n;i++){ans = t1+t2;t1 = t2;t2 = ans;}return ans;}}
118. 杨辉三角
-
题目
给定一个非负整数 *
numRows,*生成「杨辉三角」的前numRows行。在**「杨辉三角」**中,每个数是它左上方和右上方的数的和。
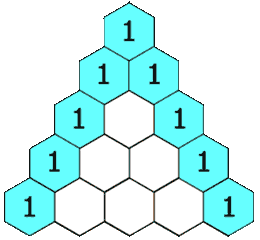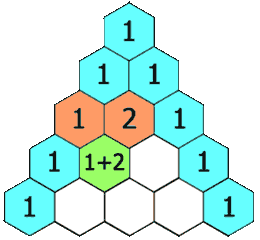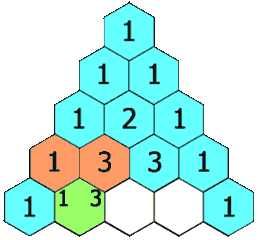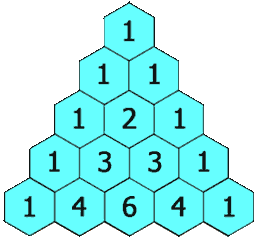
示例 1:
输入: numRows = 5输出: [[1],[1,1],[1,2,1],[1,3,3,1],[1,4,6,4,1]]示例 2:
输入: numRows = 1输出: [[1]]提示:
1 <= numRows <= 30
-
思路
杨辉三角,没啥好说的,注意一下Java中的List API即可
-
代码
class Solution {public List<List<Integer>> generate(int numRows) {List<List<Integer>> ans = new ArrayList<>();ans.add(List.of(1));for(int i = 2;i<=numRows;i++){List<Integer> curRow = new ArrayList<>();List<Integer> preRow = ans.get(i-2);//当前行的上一行for(int j = 0;j<i;j++){if(j==0 || j==i-1){curRow.add(1);}else{int a = preRow.get(j);int b = preRow.get(j-1);curRow.add(a+b);}}ans.add(curRow);}return ans;}}
198. 打家劫舍
-
题目
你是一个专业的小偷,计划偷窃沿街的房屋。每间房内都藏有一定的现金,影响你偷窃的唯一制约因素就是相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警。
给定一个代表每个房屋存放金额的非负整数数组,计算你 不触动警报装置的情况下 ,一夜之内能够偷窃到的最高金额。
示例 1:
输入:[1,2,3,1]输出:4解释:偷窃 1 号房屋 (金额 = 1) ,然后偷窃 3 号房屋 (金额 = 3)。偷窃到的最高金额 = 1 + 3 = 4 。示例 2:
输入:[2,7,9,3,1]输出:12解释:偷窃 1 号房屋 (金额 = 2), 偷窃 3 号房屋 (金额 = 9),接着偷窃 5 号房屋 (金额 = 1)。偷窃到的最高金额 = 2 + 9 + 1 = 12 。提示:
1 <= nums.length <= 1000 <= nums[i] <= 400
-
思路
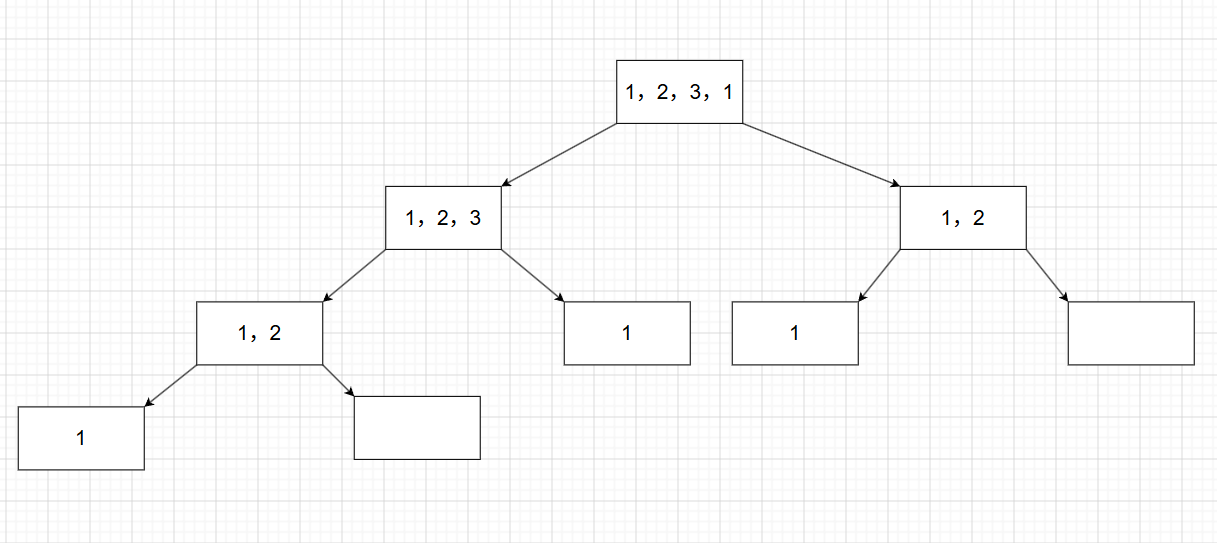
以为例,从右向左看(左向右也行)。可见每一位都有选或不选的两种可能。上图中左子树为
不选最后一位,右子树为选最后一位,由于选了不能选相邻的两位,所以若选了最后一位,那么倒数第二位就不能选了。该状态树有以下两个特点
- 递归结构
- 存在大量重复子问题
所以可以使用dp解决 ,由此可以得到状态转移方程
Tip:代表取i个物品可以获得的最大价值,由于坐标从0开始,所以对应着
-
代码
class Solution {public int rob(int[] nums) {int n = nums.length;int[]dp = new int[n+1];dp[0] = 0;dp[1] = nums[0];for(int i = 2;i<=n;i++){dp[i] = Math.max(dp[i-1],nums[i-1]+dp[i-2]);}return dp[n];}}
279. 完全平方数
-
题目
给你一个整数
n,返回 和为n的完全平方数的最少数量 。完全平方数 是一个整数,其值等于另一个整数的平方;换句话说,其值等于一个整数自乘的积。例如,
1、4、9和16都是完全平方数,而3和11不是。示例 1:
输入:n = 12输出:3解释:12 = 4 + 4 + 4示例 2:
输入:n = 13输出:2解释:13 = 4 + 9提示:
1 <= n <= 104
-
思路
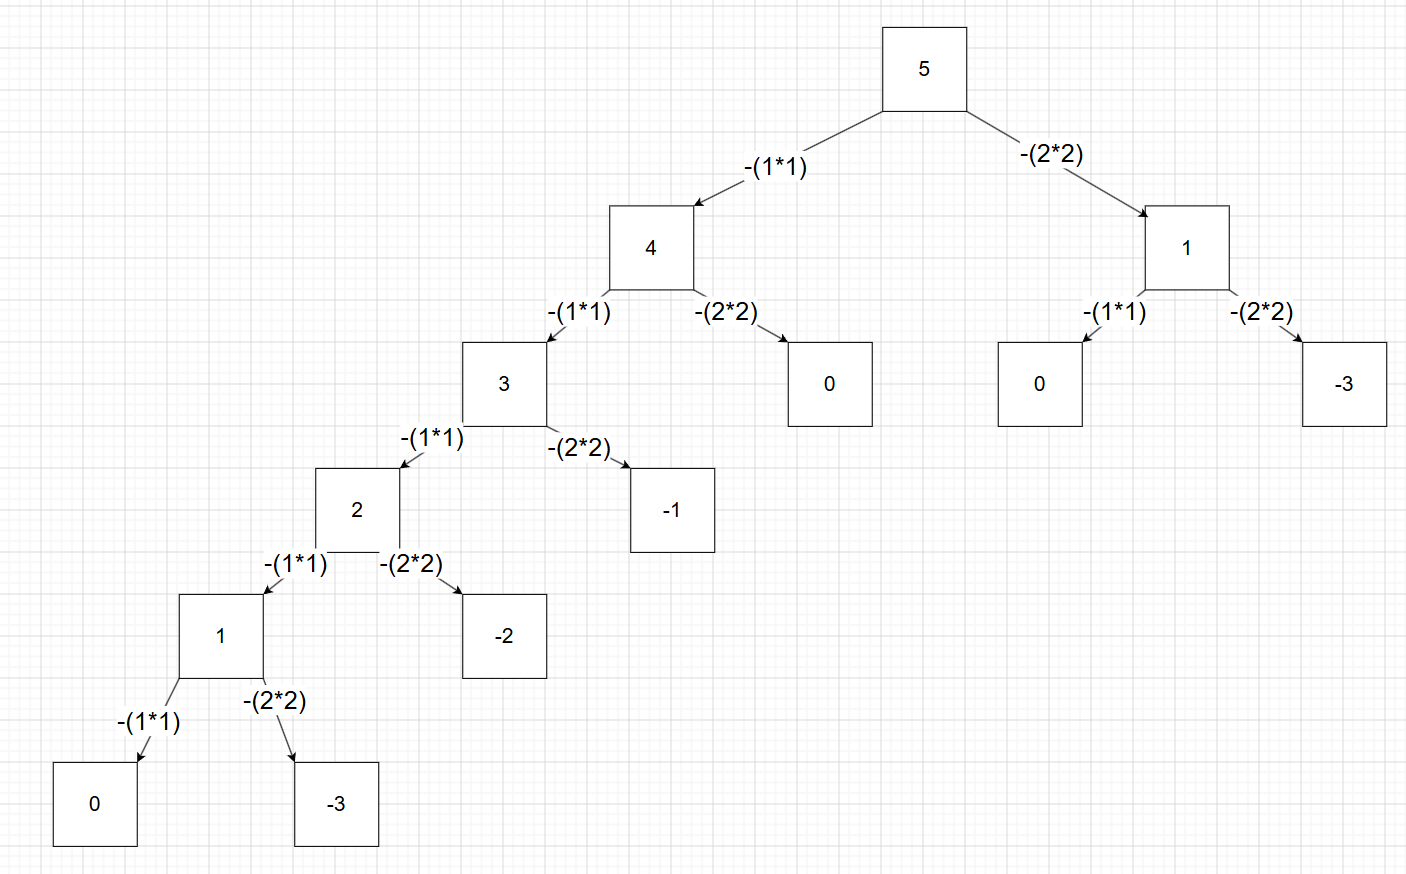
状态树如图所示,满足dp的两个条件(递归结构+重复子问题)
此处以5为例,小于5的完全平方数只有1、4,所以最后呈现出二叉树的形式,对于更大的数,会呈现出多叉树的形式
由此可以列出状态转换方程
-
代码
class Solution {public int numSquares(int n) {int[] dp = new int[n+1];//注意此处必须初始化,若不初始化,默认初始化都为0,这样在比较min的时候就会出错//Arrays.fill(dp,Integer.MAX_VALUE);Arrays.fill(dp,n);//最大的情况就是全部选 1 共选了n个dp[0] = 0;for(int i = 1;i<=n;i++){for(int j = 1;j*j<=i;j++){dp[i] = Math.min(dp[i],dp[i-j*j]+1);}}return dp[n];}}
322. 零钱兑换
-
题目
给你一个整数数组
coins,表示不同面额的硬币;以及一个整数amount,表示总金额。计算并返回可以凑成总金额所需的 最少的硬币个数 。如果没有任何一种硬币组合能组成总金额,返回
-1。你可以认为每种硬币的数量是无限的。
示例 1:
输入:coins = [1, 2, 5], amount = 11输出:3解释:11 = 5 + 5 + 1示例 2:
输入:coins = [2], amount = 3输出:-1示例 3:
输入:coins = [1], amount = 0输出:0提示:
1 <= coins.length <= 121 <= coins[i] <= 231 - 10 <= amount <= 104
-
思路
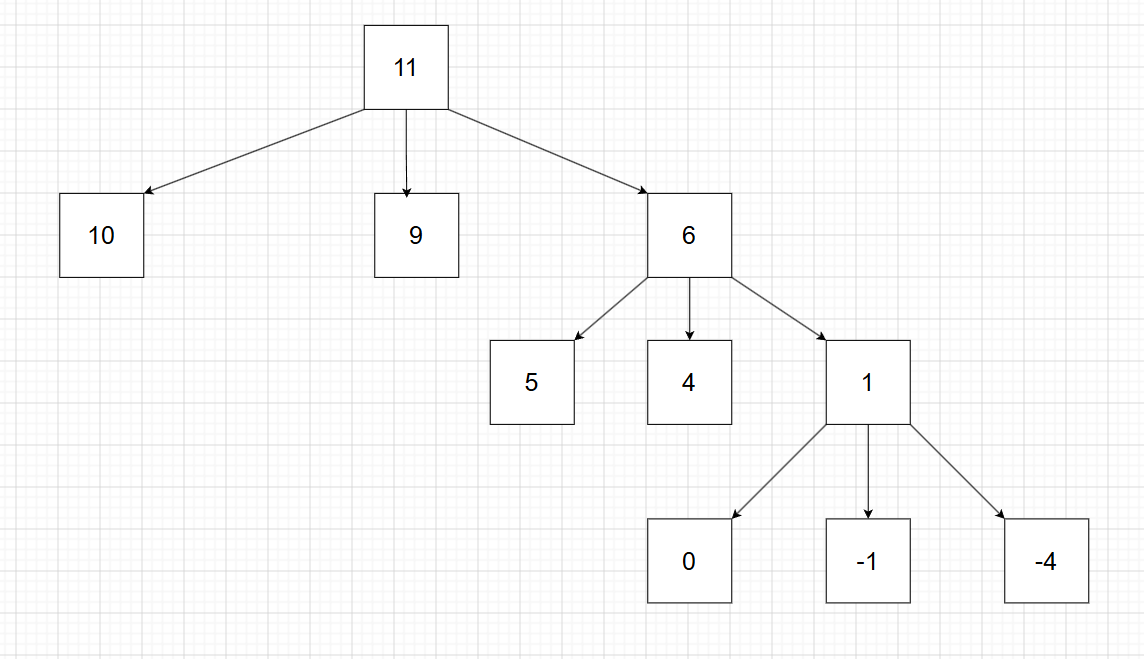
方便起见这里就不画完了,可见与上一题一致,同样呈现多叉树的形态,那么只要遍历coins取到最小的即可
状态转移方程
-
代码
class Solution {public int coinChange(int[] coins, int amount) {int n = coins.length;//初始化dp数组内元素为amount+1,原因:最小就只有1元,如果都选1元答案就是amountint[] dp = new int[amount+1];Arrays.fill(dp,amount+1);dp[0] = 0;for(int i = 1;i<=amount;i++){for(int j = 0;j<n;j++){int idx = i-coins[j];if(idx>=0){dp[i] = Math.min(dp[i],dp[idx]+1);}}}return dp[amount]==amount+1? -1:dp[amount];}}
139. 单词拆分
-
题目
给你一个字符串
s和一个字符串列表wordDict作为字典。如果可以利用字典中出现的一个或多个单词拼接出s则返回true。**注意:**不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
示例 1:
输入: s = "leetcode", wordDict = ["leet", "code"]输出: true解释: 返回 true 因为 "leetcode" 可以由 "leet" 和 "code" 拼接成。示例 2:
输入: s = "applepenapple", wordDict = ["apple", "pen"]输出: true解释: 返回 true 因为 "applepenapple" 可以由 "apple" "pen" "apple" 拼接成。注意,你可以重复使用字典中的单词。示例 3:
输入: s = "catsandog", wordDict = ["cats", "dog", "sand", "and", "cat"]输出: false提示:
1 <= s.length <= 3001 <= wordDict.length <= 10001 <= wordDict[i].length <= 20s和wordDict[i]仅由小写英文字母组成wordDict中的所有字符串 互不相同
-
思路
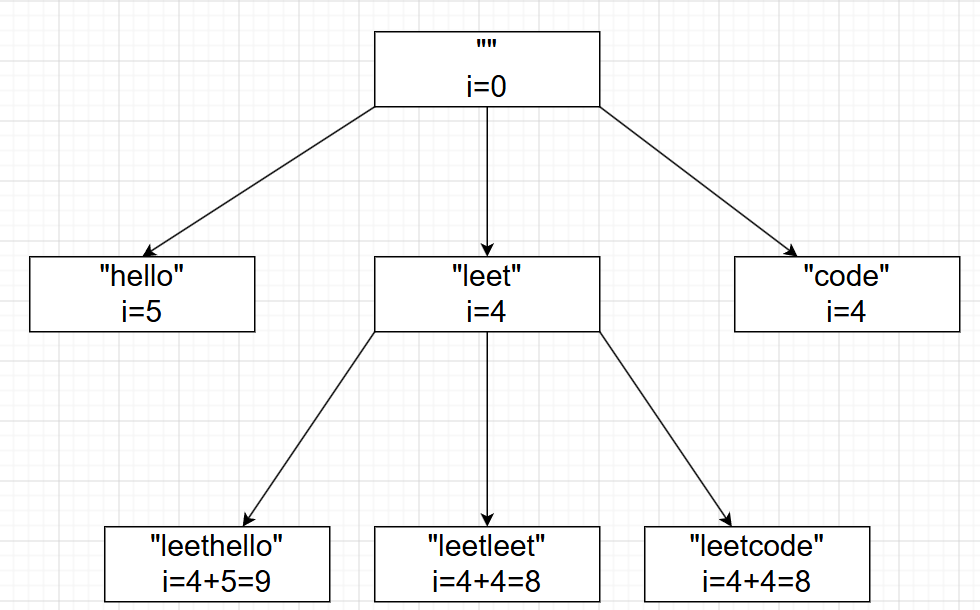
以
s = "leetcode", wordDict = [“hello”,"leet", "code"]为例。可以构成以上的状态树,维护的表示前i个字符是否能被wordDict里的单词匹配。若则说明整个字符串都可以被匹配。 由此可得状态转移方程为中的单个单词
解读:代表着能否找到单词拼接成的的子串。结合上图,
- 先遍历并截取出 ,若相同则标记,代表着可以找到以0索引开始的前缀单词。
- 找到后,继续遍历,等到时,,即这个范围的子串被成功匹配,可以在此基础上找后面的匹配单词。见上图,当找到时,发现与的部分完全一致,则
-
代码
class Solution {public boolean wordBreak(String s, List<String> wordDict) {int n = s.length();boolean[] dp = new boolean[n+1];dp[0] = true;for(int i = 0;i<n+1;i++){for(String word:wordDict){int len = word.length();if(dp[i]==true && i+len<=n && word.equals(s.substring(i,i+len))){dp[i+len] = true;}}}return dp[n];}}
300. 最长递增子序列
-
题目
给你一个整数数组
nums,找到其中最长严格递增子序列的长度。子序列 是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。例如,
[3,6,2,7]是数组[0,3,1,6,2,2,7]的子序列。示例 1:
输入:nums = [10,9,2,5,3,7,101,18]输出:4解释:最长递增子序列是 [2,3,7,101],因此长度为 4 。示例 2:
输入:nums = [0,1,0,3,2,3]输出:4示例 3:
输入:nums = [7,7,7,7,7,7,7]输出:1提示:
1 <= nums.length <= 2500-104 <= nums[i] <= 104
-
思路
表示以为结尾的子序列的最长长度
那么对于,遍历,找到其中最长的子序列再+1即为以为结尾的最长子序列
-
代码
class Solution {public int lengthOfLIS(int[] nums) {int n = nums.length;int[] dp = new int[n];Arrays.fill(dp,1);//所有数字刚开始都符合递增子序列,长度为1int ans = 0;for(int i = 0;i<n;i++){for(int j = 0;j<i;j++){if(nums[j]<nums[i]){dp[i] = Math.max(dp[i],dp[j]+1);}}ans = Math.max(ans,dp[i]);//记录最大值(最长子序列的结尾不一定是nums[n-1])}return ans;}}
152. 乘积最大子数组
-
题目
给你一个整数数组
nums,请你找出数组中乘积最大的非空连续 子数组(该子数组中至少包含一个数字),并返回该子数组所对应的乘积。测试用例的答案是一个 32-位 整数。
请注意,一个只包含一个元素的数组的乘积是这个元素的值。
示例 1:
输入: nums = [2,3,-2,4]输出: 6解释: 子数组 [2,3] 有最大乘积 6。示例 2:
输入: nums = [-2,0,-1]输出: 0解释: 结果不能为 2, 因为 [-2,-1] 不是子数组。提示:
1 <= nums.length <= 2 * 104-10 <= nums[i] <= 10nums的任何子数组的乘积都 保证 是一个 32-位 整数
-
思路
有点类似[53](#53(思路2). 最大子数组和),也有点类似[300](#300. 最长递增子序列),都表示以为结尾的满足题目要求的子数组/子序列
本题中都表示以为结尾的乘积最大子数组;都表示以为结尾的乘积最小子数组
分类讨论情况如下
-
初始化
-
若
-
若
-
若
维护两个dp数组的原因
若为负数,负数 * 较大数 < 负数 * 较小值,所以需要和最小值相乘才可以得到最大乘积
-
-
代码
class Solution {public int maxProduct(int[] nums) {int n = nums.length;int[] dp_max = new int[n];int[] dp_min = new int[n];int ans = nums[0];dp_max[0] = dp_min[0] = nums[0];for(int i = 1;i<n;i++){if(nums[i]>0){dp_max[i] = Math.max(nums[i],dp_max[i-1]*nums[i]);dp_min[i] = Math.min(nums[i],dp_min[i-1]*nums[i]);}else if(nums[i] < 0){dp_max[i] = Math.max(nums[i],dp_min[i-1]*nums[i]);dp_min[i] = Math.min(nums[i],dp_max[i-1]*nums[i]);}else{dp_max[i] = dp_min[i] = 0;}ans = Math.max(ans,dp_max[i]);}return ans;}}
416. 分割等和子集
-
题目
给你一个 只包含正整数 的 非空 数组
nums。请你判断是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。示例 1:
输入:nums = [1,5,11,5]输出:true解释:数组可以分割成 [1, 5, 5] 和 [11] 。示例 2:
输入:nums = [1,2,3,5]输出:false解释:数组不能分割成两个元素和相等的子集。提示:
1 <= nums.length <= 2001 <= nums[i] <= 100
-
思路
首先,分成子集后两个子集元素和要相等。即: 那么数组中所有元素之和应该为偶数,奇数不能被2整数。
所以我们就可以将问题转换成 :能否在nums中挑选子集合,子集合的和为 ,且每个元素最多只能被用一次。那么这个问题就变成了0-1背包问题
-
0-1背包最大值的状态转移方程
当我们决定第i个物品是否要选时,我们要更新前面的所有状态。即:背包容量为,此处的,若背包容量为时没有选第i个物品,那么容量为时的最大价值不变。若选了,那么容量为时的最大价值要,从选和不选两个可能性中选出最大值填入当前的,就更新了背包容量为时可产生的最大价值
如此一来我们就有两个思路解决这个问题
-
数组中的每一个数字的质量和价值都是,代表:容量为的背包可以装下的最大价值。由于每个数组元素的质量和价值相同,则。所以,若则说明可以找到子集合,其所有元素和为
-
状态转移方程
-
-
表示:能否找到子集和,其所有元素和为。Tip:数组类型为
-
状态转移方程
对于,若存在子集合的和为,那么纳入后,也就存在了一个子集合的和为
-
-
-
代码
class Solution {public boolean canPartition(int[] nums) {int sum = 0;int n = nums.length;for(int i = 0;i<n;i++){sum+=nums[i];}if(sum%2==1){return false;}boolean[] dp = new boolean[sum/2 + 1 ];dp[0] = true;for(int i = 0;i<n;i++){for(int j = sum/2 - nums[i];j>=0;j--){if(dp[j]){dp[j+nums[i]] = true;}}}return dp[sum/2];}}
62. 不同路径
-
题目
一个机器人位于一个
m x n网格的左上角 (起始点在下图中标记为 “Start” )。机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为 “Finish” )。
问总共有多少条不同的路径?
示例 1:
 输入:m = 3, n = 7输出:28
示例 2:
输入:m = 3, n = 2输出:3解释:从左上角开始,总共有 3 条路径可以到达右下角。1. 向右 -> 向下 -> 向下2. 向下 -> 向下 -> 向右3. 向下 -> 向右 -> 向下示例 3:
输入:m = 7, n = 3输出:28示例 4:
输入:m = 3, n = 3输出:6提示:
1 <= m, n <= 100- 题目数据保证答案小于等于
2 * 109
-
思路
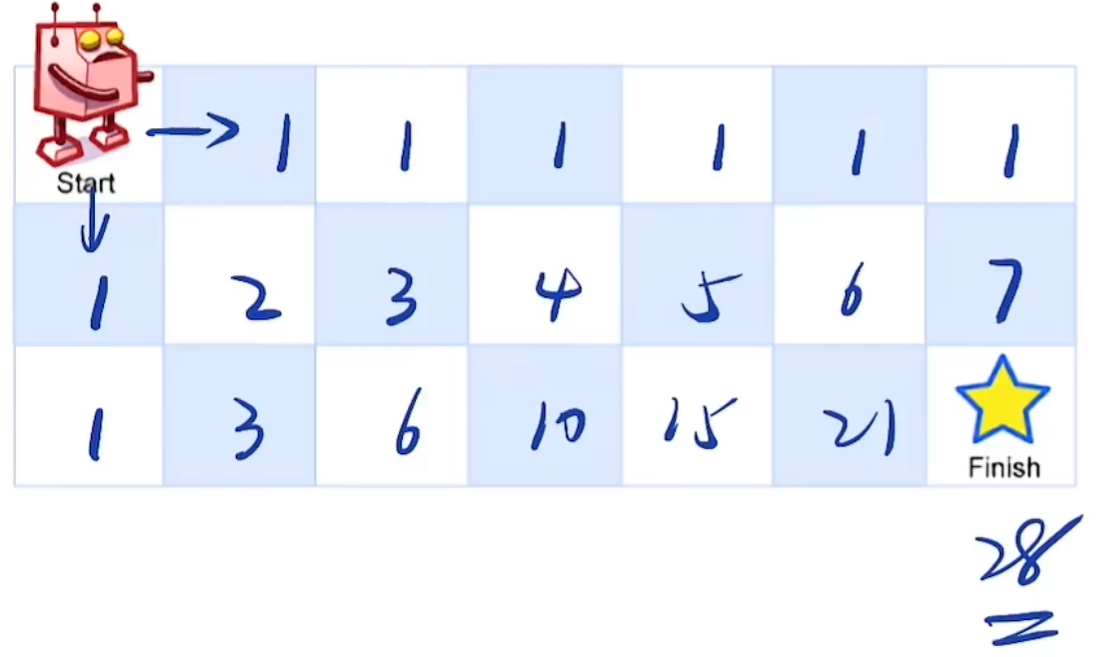
表示从出发到达的路径数量。由于机器人只能向右、下走。那么对于,只有可能从过来。所以。
又由于我们的计算顺序是从左向右、从上向下。所以可以将dp数组从二维压缩成一维,优化空间
如:我们现在遍历到第行,,在覆盖前,其值为。而覆盖后的值应该为:。那么我们就可以推出,压缩后的状态转换公式为:
为了防止越界可以写作
-
代码
class Solution {public int uniquePaths(int m, int n) {int[] dp = new int[n+1];//dp[1~n]为有效区域,且保证下方j+1不越界dp[1] = 1;for(int i = 0;i<m;i++){for(int j = 0;j<n;j++){//j<n,j+1最大值为ndp[j+1] +=dp[j];}}return dp[n];}}
64. 最小路径和
-
题目
给定一个包含非负整数的
*m* x *n*网格grid,请找出一条从左上角到右下角的路径,使得路径上的数字总和为最小。**说明:**每次只能向下或者向右移动一步。
示例 1:
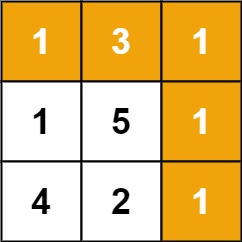 输入:grid = [[1,3,1],[1,5,1],[4,2,1]]输出:7解释:因为路径 1→3→1→1→1 的总和最小。
示例 2:
输入:grid = [[1,2,3],[4,5,6]]输出:12提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 2000 <= grid[i][j] <= 200
-
思路
基本思路同上题,不过状态转移方程为
同理可以压缩dp矩阵,空间优化后状态转移方程为
-
代码
优化前
class Solution {public int minPathSum(int[][] grid) {int m = grid.length;int n = grid[0].length;int[][] dp = new int[m][n];dp[0][0] = grid[0][0];for(int i = 1;i<n;i++){dp[0][i] = dp[0][i-1]+grid[0][i];}for(int i = 1;i<m;i++){dp[i][0] = dp[i-1][0]+grid[i][0];}for(int i = 1;i<m;i++){for(int j = 1;j<n;j++){dp[i][j] = Math.min(dp[i-1][j],dp[i][j-1])+grid[i][j];}}return dp[m-1][n-1];}}优化后
class Solution {public int minPathSum(int[][] grid) {int m = grid.length;int n = grid[0].length;int[] dp = new int[n+1];for(int i = 0;i<n;i++){//初始化dpdp[i+1] = grid[0][i] + dp[i];}//dp[0]置为最大值,防止后面比较出问题dp[0] = Integer.MAX_VALUE;for(int i = 1;i<m;i++){for(int j = 0;j<n;j++){dp[j+1] = Math.min(dp[j+1],dp[j])+grid[i][j];}}return dp[n];}}
1143. 最长公共子序列
-
题目
给定两个字符串
text1和text2,返回这两个字符串的最长 公共子序列 的长度。如果不存在 公共子序列 ,返回0。一个字符串的 子序列 是指这样一个新的字符串:它是由原字符串在不改变字符的相对顺序的情况下删除某些字符(也可以不删除任何字符)后组成的新字符串。
- 例如,
"ace"是"abcde"的子序列,但"aec"不是"abcde"的子序列。
两个字符串的 公共子序列 是这两个字符串所共同拥有的子序列。
示例 1:
输入:text1 = "abcde", text2 = "ace"输出:3解释:最长公共子序列是 "ace" ,它的长度为 3 。示例 2:
输入:text1 = "abc", text2 = "abc"输出:3解释:最长公共子序列是 "abc" ,它的长度为 3 。示例 3:
输入:text1 = "abc", text2 = "def"输出:0解释:两个字符串没有公共子序列,返回 0 。提示:
1 <= text1.length, text2.length <= 1000text1和text2仅由小写英文字符组成。
- 例如,
-
思路
-
当时,那么其对应的字母肯定在最长公共子序列中,纳入;问题就变为了的和的部分的最大公共子序列长度+1
-
当时,问题就转变为了
的和的部分的最大公共子序列长度
的和的部分的最大公共子序列长度
上述二者取最大值
-
状态转移方程:表示的和的部分的最大公共子序列长度
为了防止越界可以写为
-
-
代码
class Solution {public int longestCommonSubsequence(String text1, String text2) {char[] s1 = text1.toCharArray();int m = s1.length;char[] s2 = text2.toCharArray();int n = s2.length;int[][] dp = new int[m+1][n+1];for(int i = 0;i<m;i++){for(int j = 0;j<n;j++){dp[i+1][j+1] = s1[i]==s2[j]?dp[i][j]+1:Math.max(dp[i+1][j],dp[i][j+1]);}}return dp[m][n];}}
72. 编辑距离
-
题目
给你两个单词
word1和word2, 请返回将word1转换成word2所使用的最少操作数 。你可以对一个单词进行如下三种操作:
- 插入一个字符
- 删除一个字符
- 替换一个字符
示例 1:
输入:word1 = "horse", word2 = "ros"输出:3解释:horse -> rorse (将 'h' 替换为 'r')rorse -> rose (删除 'r')rose -> ros (删除 'e')示例 2:
输入:word1 = "intention", word2 = "execution"输出:5解释:intention -> inention (删除 't')inention -> enention (将 'i' 替换为 'e')enention -> exention (将 'n' 替换为 'x')exention -> exection (将 'n' 替换为 'c')exection -> execution (插入 'u')提示:
0 <= word1.length, word2.length <= 500word1和word2由小写英文字母组成
-
思路
表示:将的部分转换为的部分最少需要多少步
-
当时
可以理解为当时,可以直接将给消掉
-
当时,说明我们需要进行操作(新增、删除、替换 中的一种操作)
-
代表着替换
可以理解为,将的字母替换成后,,随后消除。但是这个过程中多了一步替换,所以要+1
-
代表着删除
可以理解为,将直接删除后,状态就变为了将的部分转换为的部分最少需要多少步。状态转移多了删除操作所以要+1
-
代表着增加
可以理解为,的位置新增字母后,就比差出了一个位置,所以状态将变为了将的部分转换为的部分最少需要多少步。状态转移多了新增操作所以+1
我们从这三种操作里选一种变化次数最少的即可
-
-
注意:表示将的部分转换为的部分最少需要多少步,一直新增即可
表示将的部分转换为的部分最少需要多少步,一直删除即可
-
-
代码
class Solution {public int minDistance(String word1, String word2) {char[] s1 = word1.toCharArray();int m = s1.length;char[] s2 = word2.toCharArray();int n = s2.length;int[][] dp = new int[m+1][n+1];dp[0][0] = 0;for(int i = 1;i<=m;i++){dp[i][0] = dp[i-1][0]+1;}for(int i = 1;i<=n;i++){dp[0][i] = dp[0][i-1]+1;}for(int i = 0;i<m;i++){for(int j = 0;j<n;j++){dp[i+1][j+1] = s1[i]==s2[j]?dp[i][j]:Math.min(Math.min(dp[i][j],dp[i+1][j]),dp[i][j+1])+1;}}return dp[m][n];}}
杂项
136. 只出现一次的数字
-
题目
给你一个 非空 整数数组
nums,除了某个元素只出现一次以外,其余每个元素均出现两次。找出那个只出现了一次的元素。你必须设计并实现线性时间复杂度的算法来解决此问题,且该算法只使用常量额外空间。
示例 1 :
**输入:**nums = [2,2,1]
**输出:**1
示例 2 :
**输入:**nums = [4,1,2,1,2]
**输出:**4
示例 3 :
**输入:**nums = [1]
**输出:**1
提示:
1 <= nums.length <= 3 * 104-3 * 104 <= nums[i] <= 3 * 104- 除了某个元素只出现一次以外,其余每个元素均出现两次。
-
思路
相同的数异或结果为0
-
代码
class Solution {public int singleNumber(int[] nums) {int ans = 0;for(int num : nums){ans ^= num;}return ans;}}
169. 多数元素
-
题目
给定一个大小为
n的数组nums,返回其中的多数元素。多数元素是指在数组中出现次数 大于⌊ n/2 ⌋的元素。你可以假设数组是非空的,并且给定的数组总是存在多数元素。
示例 1:
输入:nums = [3,2,3]输出:3示例 2:
输入:nums = [2,2,1,1,1,2,2]输出:2提示:
n == nums.length1 <= n <= 5 * 104-109 <= nums[i] <= 109- 输入保证数组中一定有一个多数元素。
**进阶:**尝试设计时间复杂度为 O(n)、空间复杂度为 O(1) 的算法解决此问题。
-
思路
打擂台
- 遍历数组,若数字和擂主一致,那么擂主生命+1。否则-1
- 若擂主生命为0,那么擂主转换
- 最后留下来的就是数组中的最多数
-
代码
class Solution {public int majorityElement(int[] nums) {int count = 0;int ans = 0;for(int num : nums){if(count==0){ans = num;}if(num == ans){count++;}else{count--;}}return ans;}}
75. 颜色分类
-
题目
给定一个包含红色、白色和蓝色、共
n个元素的数组nums,原地 对它们进行排序,使得相同颜色的元素相邻,并按照红色、白色、蓝色顺序排列。我们使用整数
0、1和2分别表示红色、白色和蓝色。必须在不使用库内置的 sort 函数的情况下解决这个问题。
示例 1:
输入:nums = [2,0,2,1,1,0]输出:[0,0,1,1,2,2]示例 2:
输入:nums = [2,0,1]输出:[0,1,2]提示:
n == nums.length1 <= n <= 300nums[i]为0、1或2
进阶:
- 你能想出一个仅使用常数空间的一趟扫描算法吗?
-
思路
三个指针,用于指向0,用于指向2。用于遍历。
- 时,把这个数向left那“搬”(与left交换)
- 时,把这个数向right那“搬”
- 时,不用管
全是0,全是1,是未知区域,全是2
因为永远走在前面,是“探路”的,所以肯定会比先遇到2。只要遇到2,就会把2归类到那边,所以不会存在指向2,指向0的情况。只有可能指向0或1。所以当时,交换后
但是当时,并进行交换后,由于是未知区,所以交换过来的数是没有检查过的,所以时,交换后不能++
-
代码
class Solution {public void sortColors(int[] nums) {int l = 0,r = nums.length-1,cur = 0;while(cur<=r){if(nums[cur]==0){swap(nums,l,cur);l++;cur++;}else if(nums[cur]==2){swap(nums,r,cur);r--;}else{cur++;}}}private void swap(int[] nums,int idx1,int idx2){int t = nums[idx1];nums[idx1] = nums[idx2];nums[idx2] = t;}}
31. 下一个排列
-
题目
整数数组的一个 排列 就是将其所有成员以序列或线性顺序排列。
- 例如,
arr = [1,2,3],以下这些都可以视作arr的排列:[1,2,3]、[1,3,2]、[3,1,2]、[2,3,1]。
整数数组的 下一个排列 是指其整数的下一个字典序更大的排列。更正式地,如果数组的所有排列根据其字典顺序从小到大排列在一个容器中,那么数组的 下一个排列 就是在这个有序容器中排在它后面的那个排列。如果不存在下一个更大的排列,那么这个数组必须重排为字典序最小的排列(即,其元素按升序排列)。
- 例如,
arr = [1,2,3]的下一个排列是[1,3,2]。 - 类似地,
arr = [2,3,1]的下一个排列是[3,1,2]。 - 而
arr = [3,2,1]的下一个排列是[1,2,3],因为[3,2,1]不存在一个字典序更大的排列。
给你一个整数数组
nums,找出nums的下一个排列。必须** 原地 **修改,只允许使用额外常数空间。
示例 1:
输入:nums = [1,2,3]输出:[1,3,2]示例 2:
输入:nums = [3,2,1]输出:[1,2,3]示例 3:
输入:nums = [1,1,5]输出:[1,5,1]提示:
1 <= nums.length <= 1000 <= nums[i] <= 100
- 例如,
-
思路
以为例。我们需要找此序列的下一个排列是什么。
-
若保持不变,重新排列为,这样子序列就变小了,所以不符合。 — 原因 4>2
-
若不变,重新排列,发现也无法找到更大的序列 — 原因 5是里面最大的
-
若不变,重新排列,由于3后面有比它大的数,只要把它和3的位置互换就可以得到一个更大的序列
-
应该选谁呢?
为了保证交换后为下一个序列,我们要挑选的数应当是3后面比3大的所有数里面最小的 即4
-
交换后结果为,但这仍不是最小的,因为交换后的序列,升序排列成才是最小的
所以最后结果应该是
-
综上,找到下一个排列的步骤如下
- 从右向左找到第一个小于相邻数的 — 由于在找到之前右侧都是递减的,所以越往左侧数字应当越大。若有一个数要小于其相邻数,那么说明这个数右侧肯定有比它大的数
- 从的右侧找到比它大的所有数里面最小的那个并交换二者顺序
- 交换后,将剩余序列升序排序,由于交换后的序列肯定还是降序的,所以直接反转即可
- 特别的,若第一步没有找到对应的,则说明序列是逆序的(也就是最大的),这种情况下我们直接反转整个序列即可
-
-
代码
class Solution {public void nextPermutation(int[] nums) {int x = -1;int min = Integer.MAX_VALUE;int minIndex = 0;for(int i = nums.length-2;i>=0;i--){if(nums[i]<nums[i+1]){x = i;break;}}if(x==-1){reverse(nums,0,nums.length-1);}else{for(int i = nums.length-1;i>x;i--){if(nums[i]>nums[x]){minIndex = nums[i]<min?i:minIndex;min = Math.min(min,nums[i]);}}swap(nums,x,minIndex);reverse(nums,x+1,nums.length-1);}}private void reverse(int[] nums,int l,int r){while(l<=r){swap(nums,l,r);l++;r--;}}private void swap(int[] nums,int idx1,int idx2){int t = nums[idx1];nums[idx1] = nums[idx2];nums[idx2] = t;}}
287. 寻找重复数
-
题目
给定一个包含
n + 1个整数的数组nums,其数字都在[1, n]范围内(包括1和n),可知至少存在一个重复的整数。假设
nums只有 一个重复的整数 ,返回 这个重复的数 。你设计的解决方案必须 不修改 数组
nums且只用常量级O(1)的额外空间。示例 1:
输入:nums = [1,3,4,2,2]输出:2示例 2:
输入:nums = [3,1,3,4,2]输出:3示例 3 :
输入:nums = [3,3,3,3,3]输出:3提示:
1 <= n <= 105nums.length == n + 11 <= nums[i] <= nnums中 只有一个整数 出现 两次或多次 ,其余整数均只出现 一次
进阶:
- 如何证明
nums中至少存在一个重复的数字? - 你可以设计一个线性级时间复杂度
O(n)的解决方案吗?
-
思路
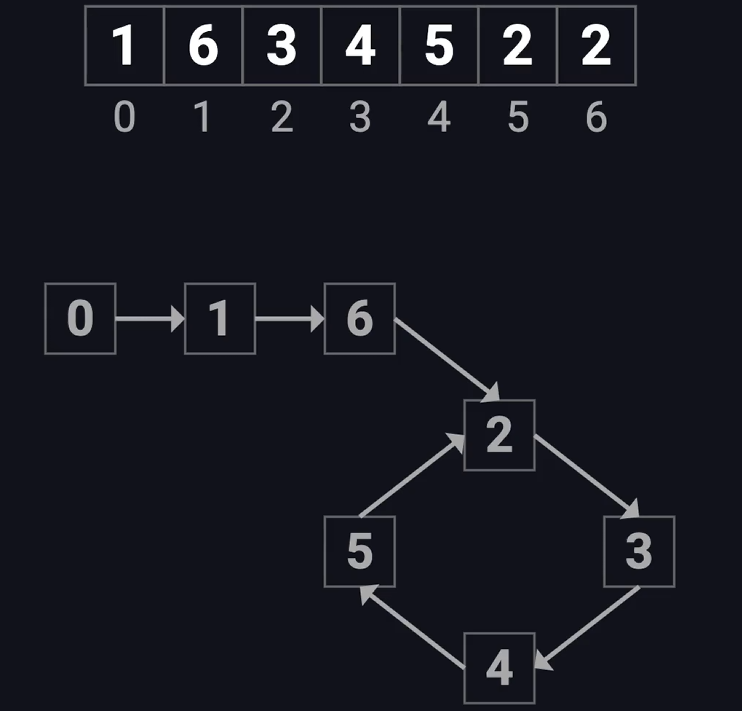
如此一来问题就变成了[142](#142. 环形链表 II)
-
代码
class Solution {public int findDuplicate(int[] nums) {int slow = 0,fast = 0;//不能写成whil(slow!=fast) 这样一来就直接不执行这个循环了while(true){fast = nums[fast];fast = nums[fast];slow = nums[slow];if(slow==fast){break;}}int temp = 0;while(nums[temp]!=nums[slow]){temp = nums[temp];slow = nums[slow];}return nums[slow];}}
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!