

MicroService
MicroServices
简介
-
微服务技术栈示意图
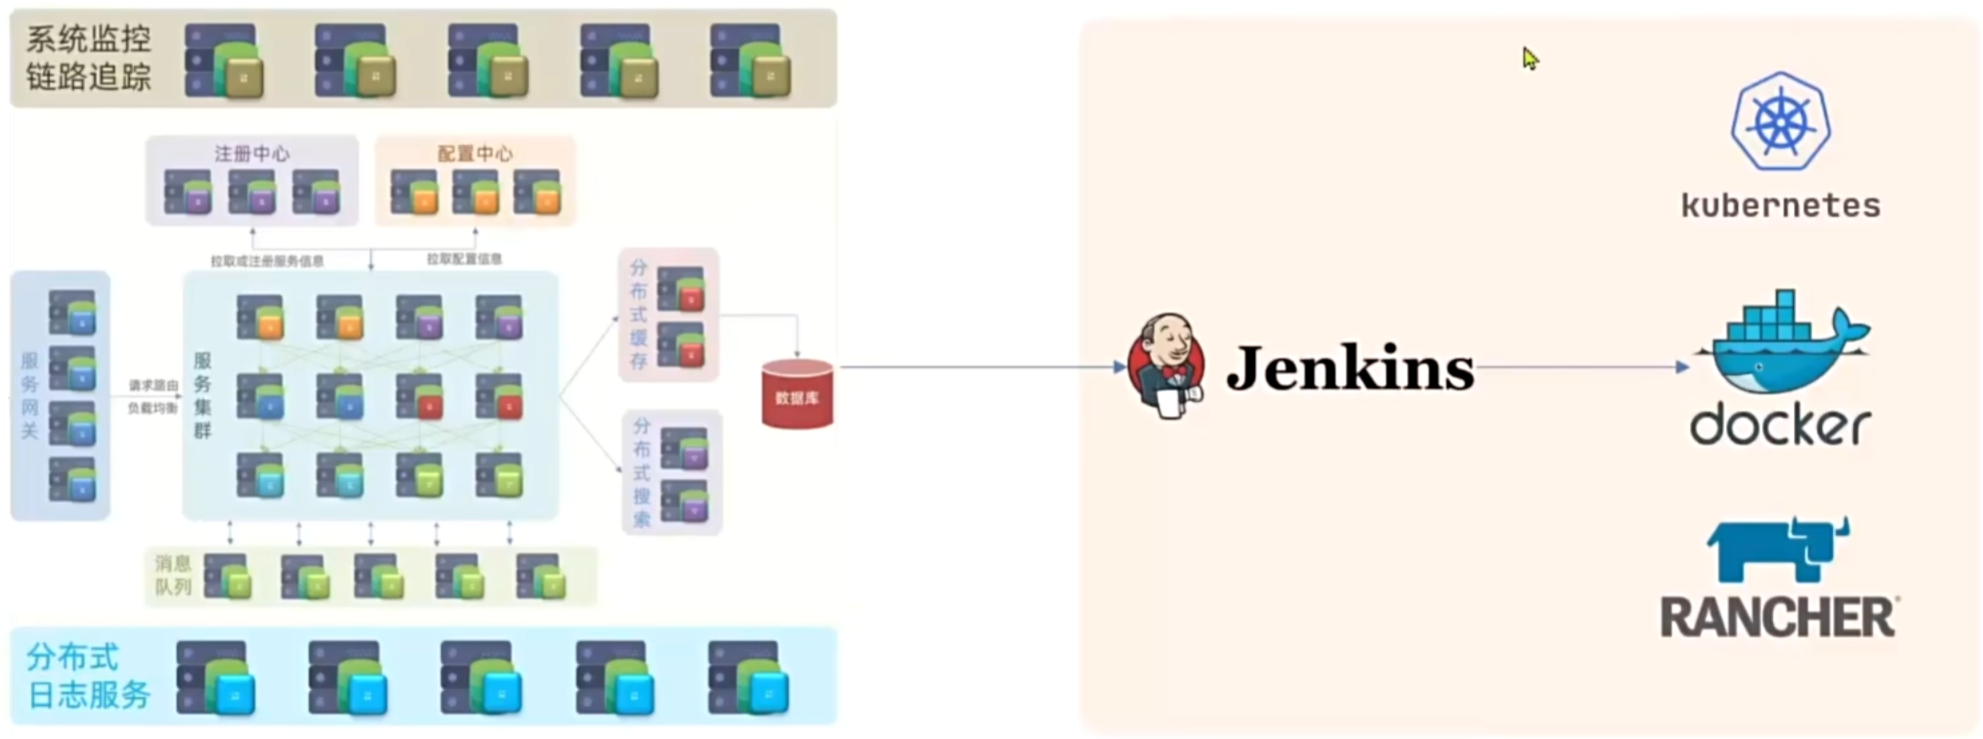
image-20260802132118500 -
微服务技术栈分类
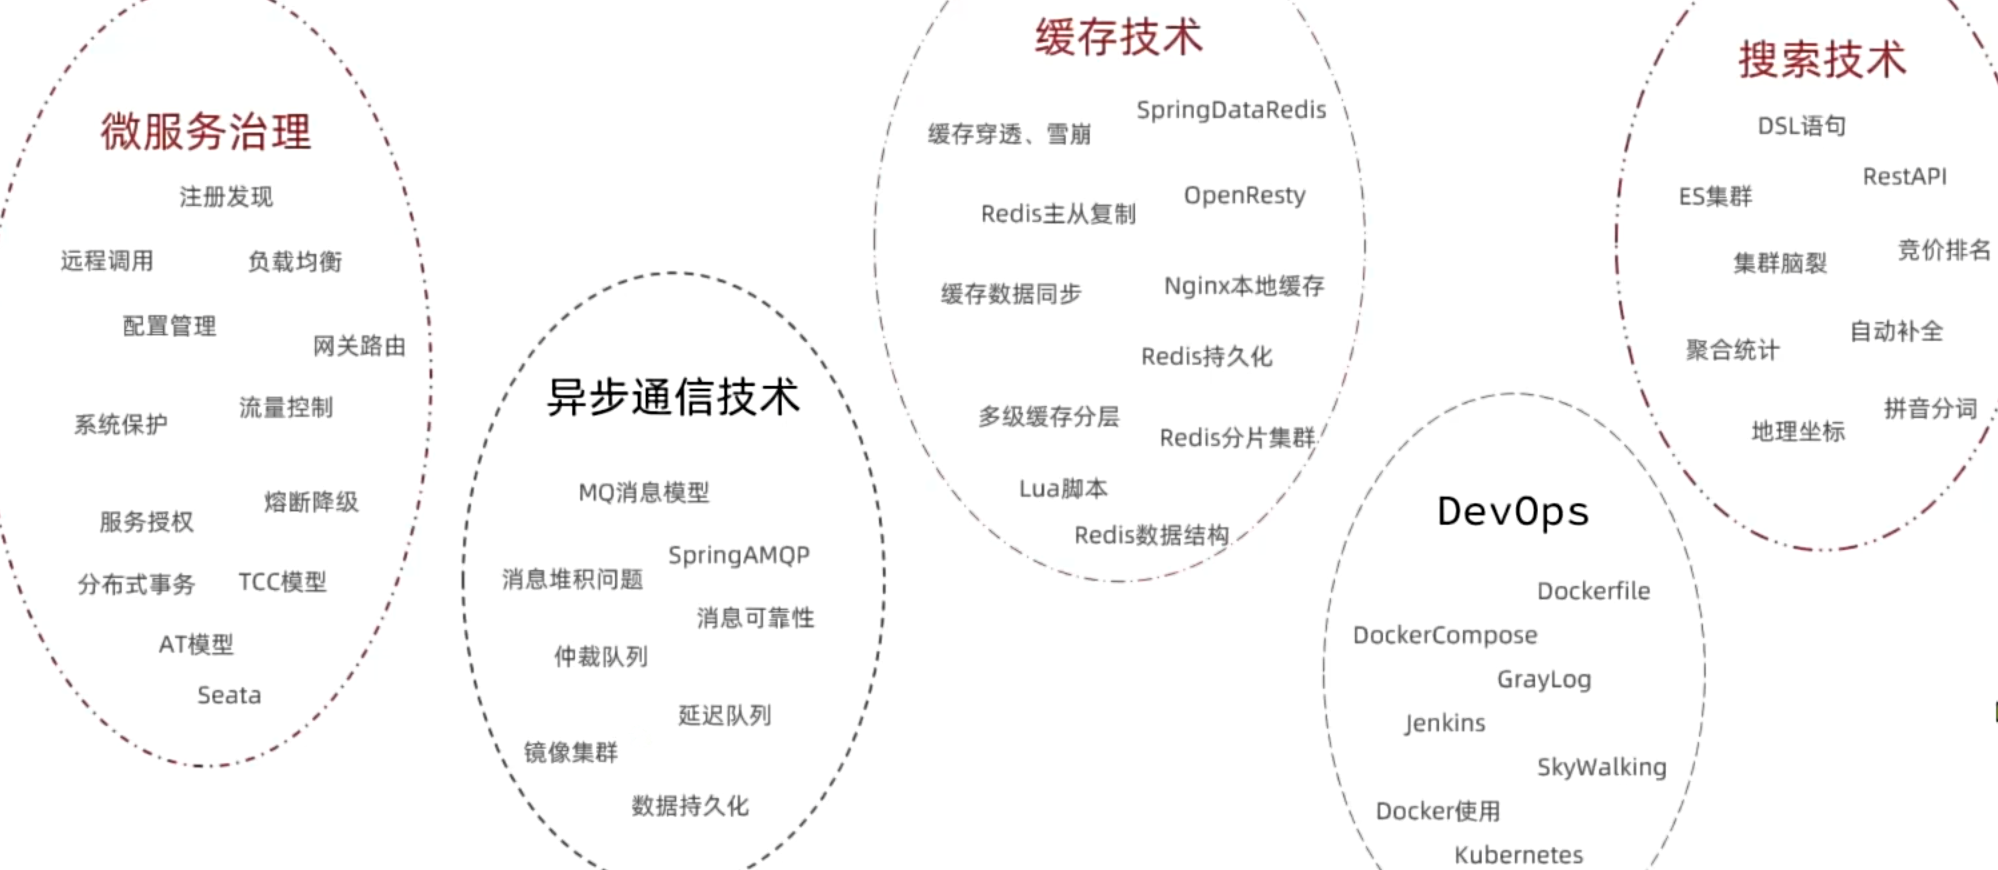
其中SpringCloud负责的是微服务治理部分
SpringCloud微服务框架
分布式架构
-
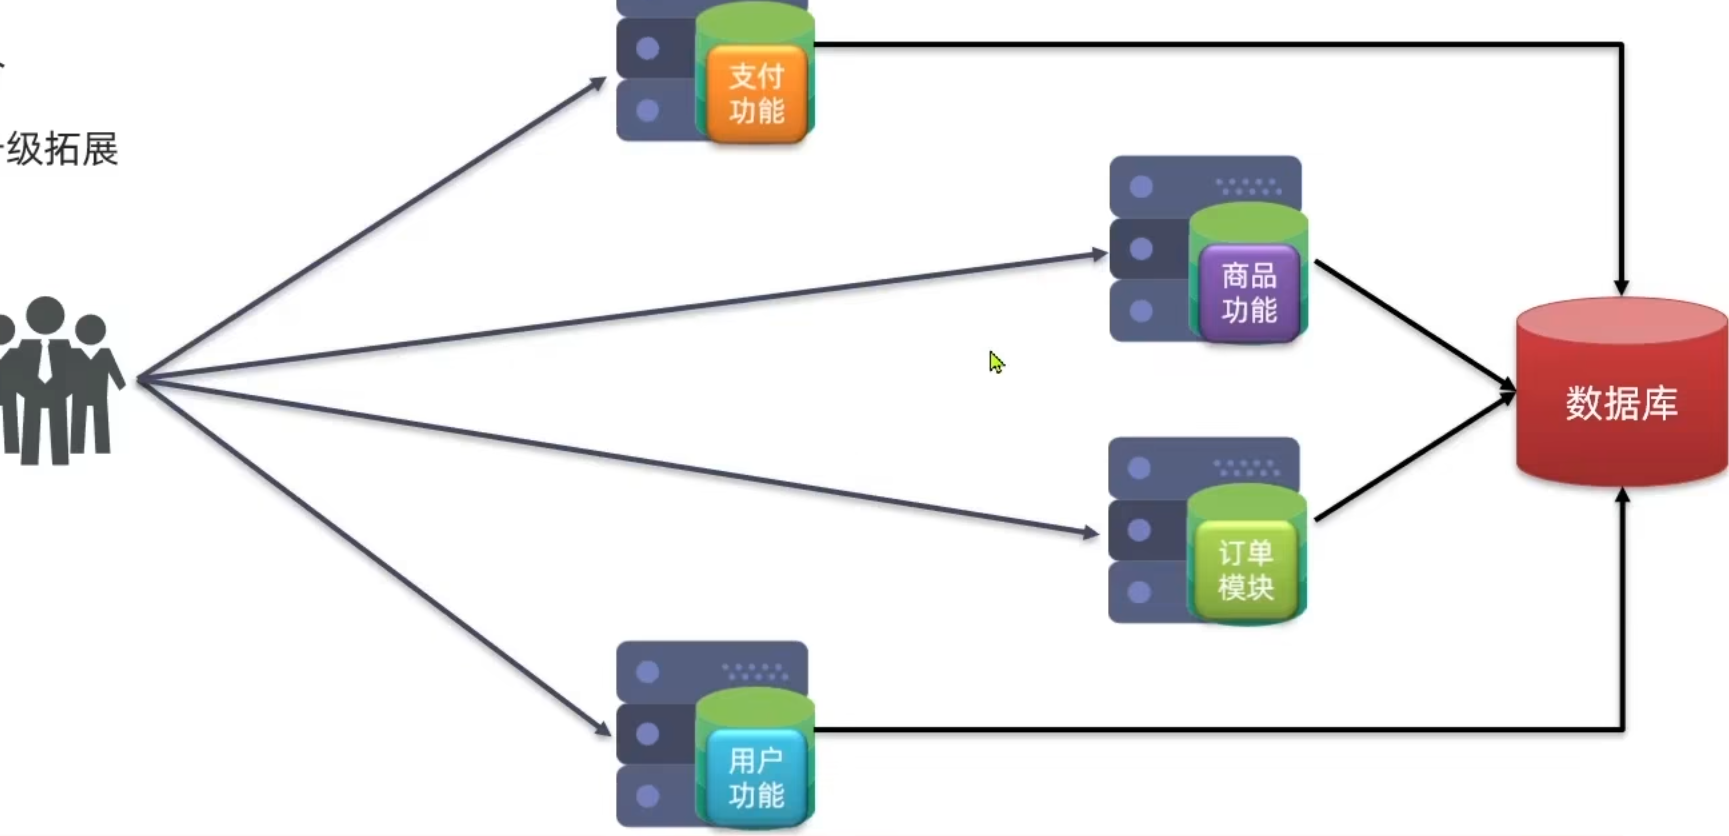
即根据业务功能对系统进行拆分,每个业务模块作为独立项目开发,称为一个服务
-
优点
降低耦合度
利于服务升级拓展
-
-
需要考虑的一些问题
- 服务拆分粒度如何?
- 服务集群地址如何维护?
- 服务之间如何实现远程调用?
- 服务健康状态如何感知?
-
微服务
一种经过良好架构设计的分布式架构方案
-
特征
-
单一职责
微服务拆分粒度更小,每个服务都对应唯一业务能力,做到单一职责,避免重复业务开发
-
面向服务
微服务需对外暴露业务接口
-
自治
团队独立、技术独立、数据独立、部署独立
-
隔离性强
服务调用做好隔离、容错、降级,避免出现级联问题
-
-
微服务方案需要技术框架落地,国内最知名的就是SpringCloud和阿里巴巴的Dubbo
-
微服务技术对比
模块 Dubbo SpringCloud SpringCloudAlibaba 注册中心 zookeeper、Redis Eureka、Consul Nacos、Eureka 服务远程调用 Dubbo 协议 Feign(http 协议) Dubbo、Feign 配置中心 无 SpringCloudConfig SpringCloudConfig、Nacos 服务网关 无 SpringCloudGateway、Zuul SpringCloudGateway、Zuul 服务监控和保护 dubbo-admin,功能弱 Hystrix Sentinel
-
-
SpringCloud
-
SpringCloud将微服务中的技术栈整合进了SpringBoot当中,使其可以进行自动装配,简化开发流程
SpringCloud和SpringBoot版本需要对应,课程所需SpringBoot版本为2.3.x
-
注意事项
- 不同的微服务,不要重复开发相同业务
- 微服务数据独立,不要访问其他微服务数据库
- 将自己的业务暴露为接口,供其他服务调用
-
demo
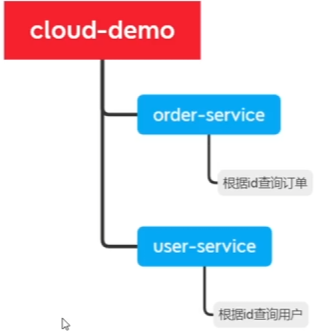
如此一来,order和user两个微服务就完全隔离了,user只能查询用户、order只能查询订单。若想要进行信息的联查则需要微服务向外暴露接口
-
远程调用分析
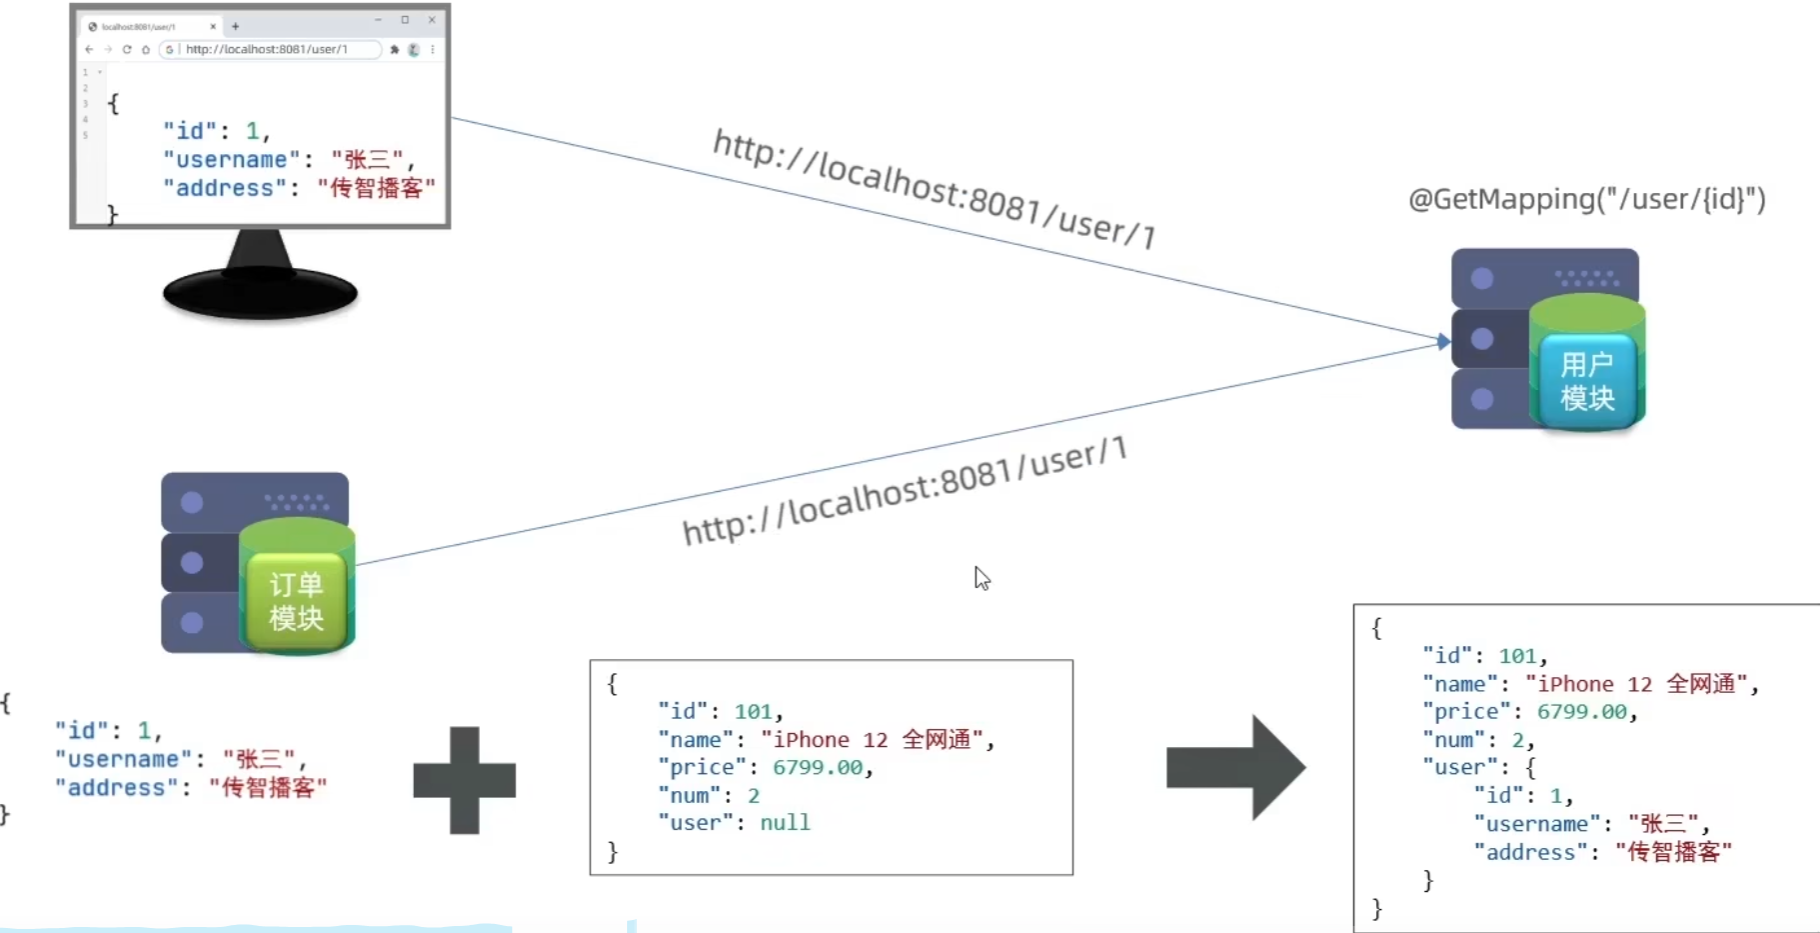
将用户模块暴露,模块与模块之间互相调用接口以获得信息
-
实现
-
注册RestTemplate(用于发起http请求)
@Configurationpublic class RestConfig {/*** 注册RestTemplate* */@Bean@LoadBalancedpublic RestTemplate restTemplate(){return new RestTemplate();}} -
编写代码跨服务查询
@Autowiredprivate OrderMapper orderMapper;@Autowiredprivate RestTemplate restTemplate;public Order queryOrderById(Long orderId) {// 1.查询订单Order order = orderMapper.findById(orderId);//2.RestTemplate发送请求String url = "http://localhost:8081/user/"+order.getUserId();User user = restTemplate.getForObject(url, User.class);//3.赋值order.setUser(user);// 4.返回return order;}
-
-
Eureka
-
微服务中的提供者和消费者
- 提供者:一次业务中,提供接口为其他微服务所调用的服务
- 消费者:一次业务中,调用其他微服务接口的服务
一个服务既可以是提供者也可以是消费者
Eureka原理
-
原先的服务调用存在的问题
- 硬编码
- 集群环境下不好管理到底向哪一台服务器发送请求
-
Eureka
- Eureka-server注册中心,所有的客户端都会在Eureka处注册信息
- 当其他服务想要消费时,会去Eureka中拉取对应的服务
- 拉取到服务后会负载均衡,从结果里面挑选一个对其进行远程调用
- 每个微服务都会运用心跳机制向Eureka展示健康状态
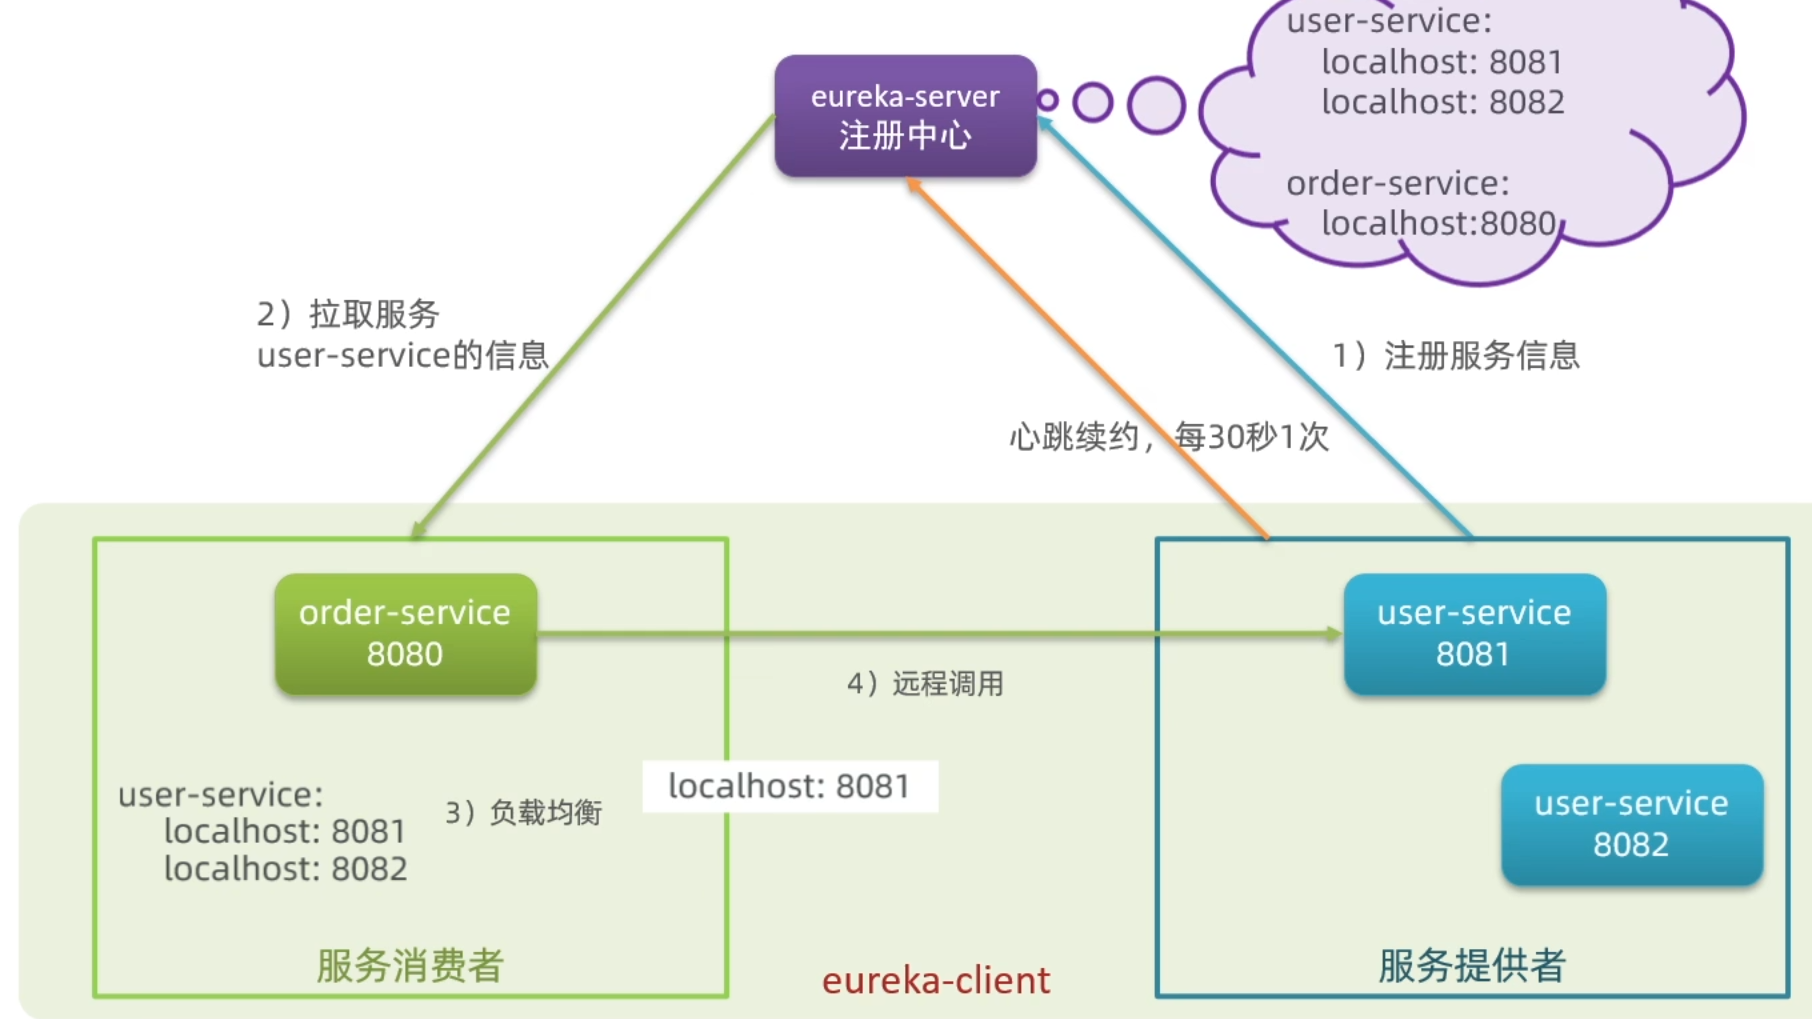
EurekaServer的搭建与服务注册
-
创建一个新模块,引入依赖
<dependency><groupId>org.springframework.cloud</groupId><artifactId>spring-cloud-starter-netflix-eureka-server</artifactId></dependency>//Tip:父工程中已经完成了版本管理 -
编写application启动类,并添加**@EnableEurekaServer使得Eureka可以被自动装配**
@SpringBootApplication@EnableEurekaServerpublic class EurekaApplication {public static void main(String[] args) {SpringApplication.run(EurekaApplication.class, args);}} -
配置application.yaml
server:port: 10086 #服务端口spring:application:name: eurekaserver #微服务名称eureka:client:service-url:defaultZone: http://127.0.0.1:10086/eureka #将eureka本身也注册进去,目的是为了集群时,eureka集群可以知道彼此
-
服务注册
-
在需要注册的模块中引入依赖
<dependency><groupId>org.springframework.cloud</groupId><artifactId>spring-cloud-starter-netflix-eureka-client</artifactId></dependency> -
配置application.yml
spring:application:name: #这里换成需要的服务名称eureka:client:service-url:defaultZone: http://127.0.0.1:10086/eureka #eureka地址 -
开启服务后自动注册
-
Eureka管理下的服务远程调用
-
写url时,可以直接用服务名称代替ip地址
String url = "http://userservice/user/"+order.getUserId(); -
为RestTemplate添加负载均衡注解 @LoadBalancerClient
@Bean@LoadBalancedpublic RestTemplate restTemplate(){return new RestTemplate();}
Ribbon负载均衡
-
负载均衡整体流程
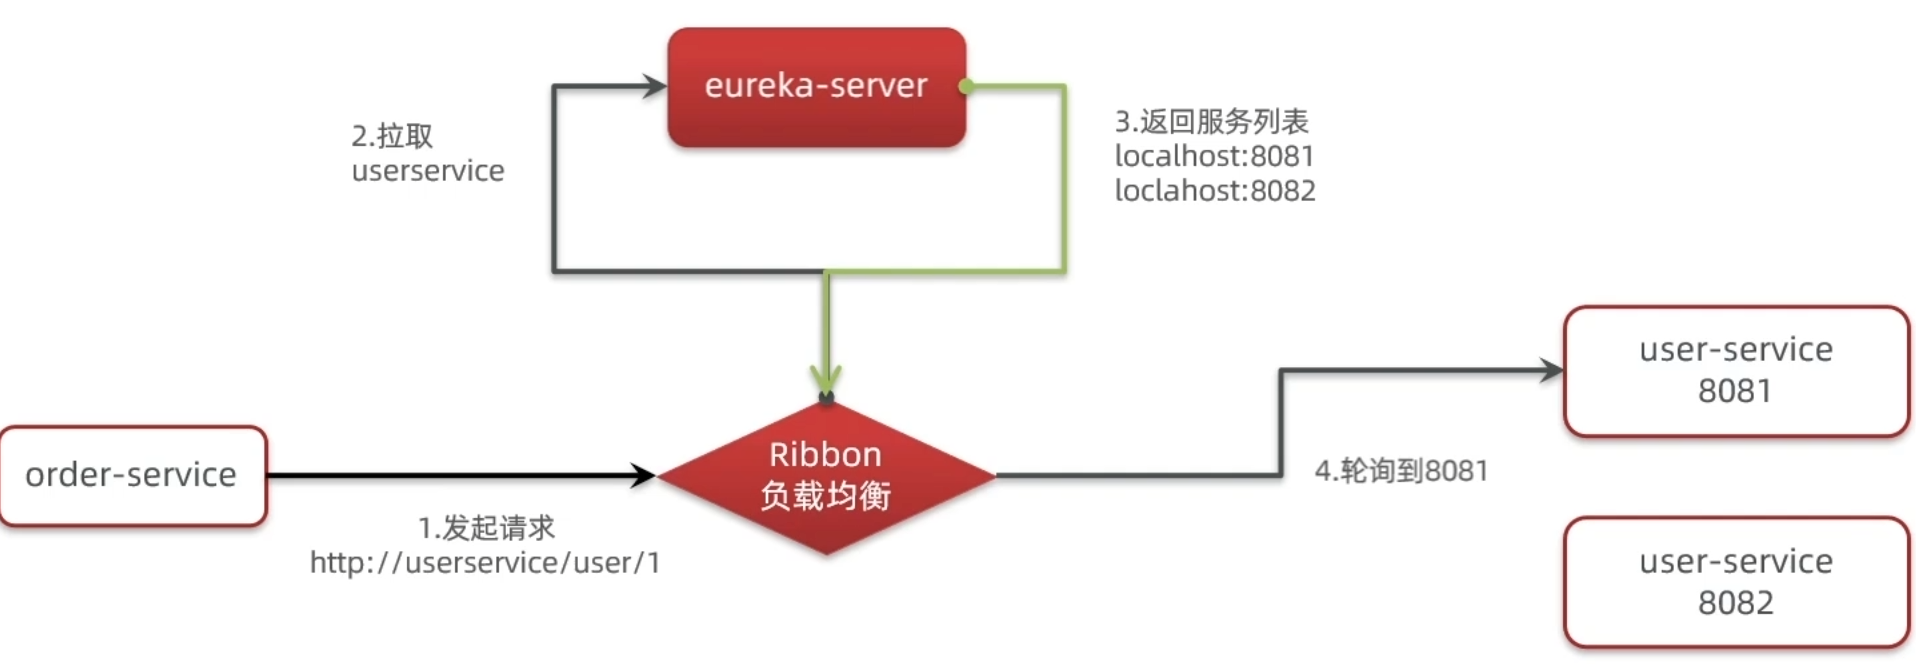
源码讲解:视频
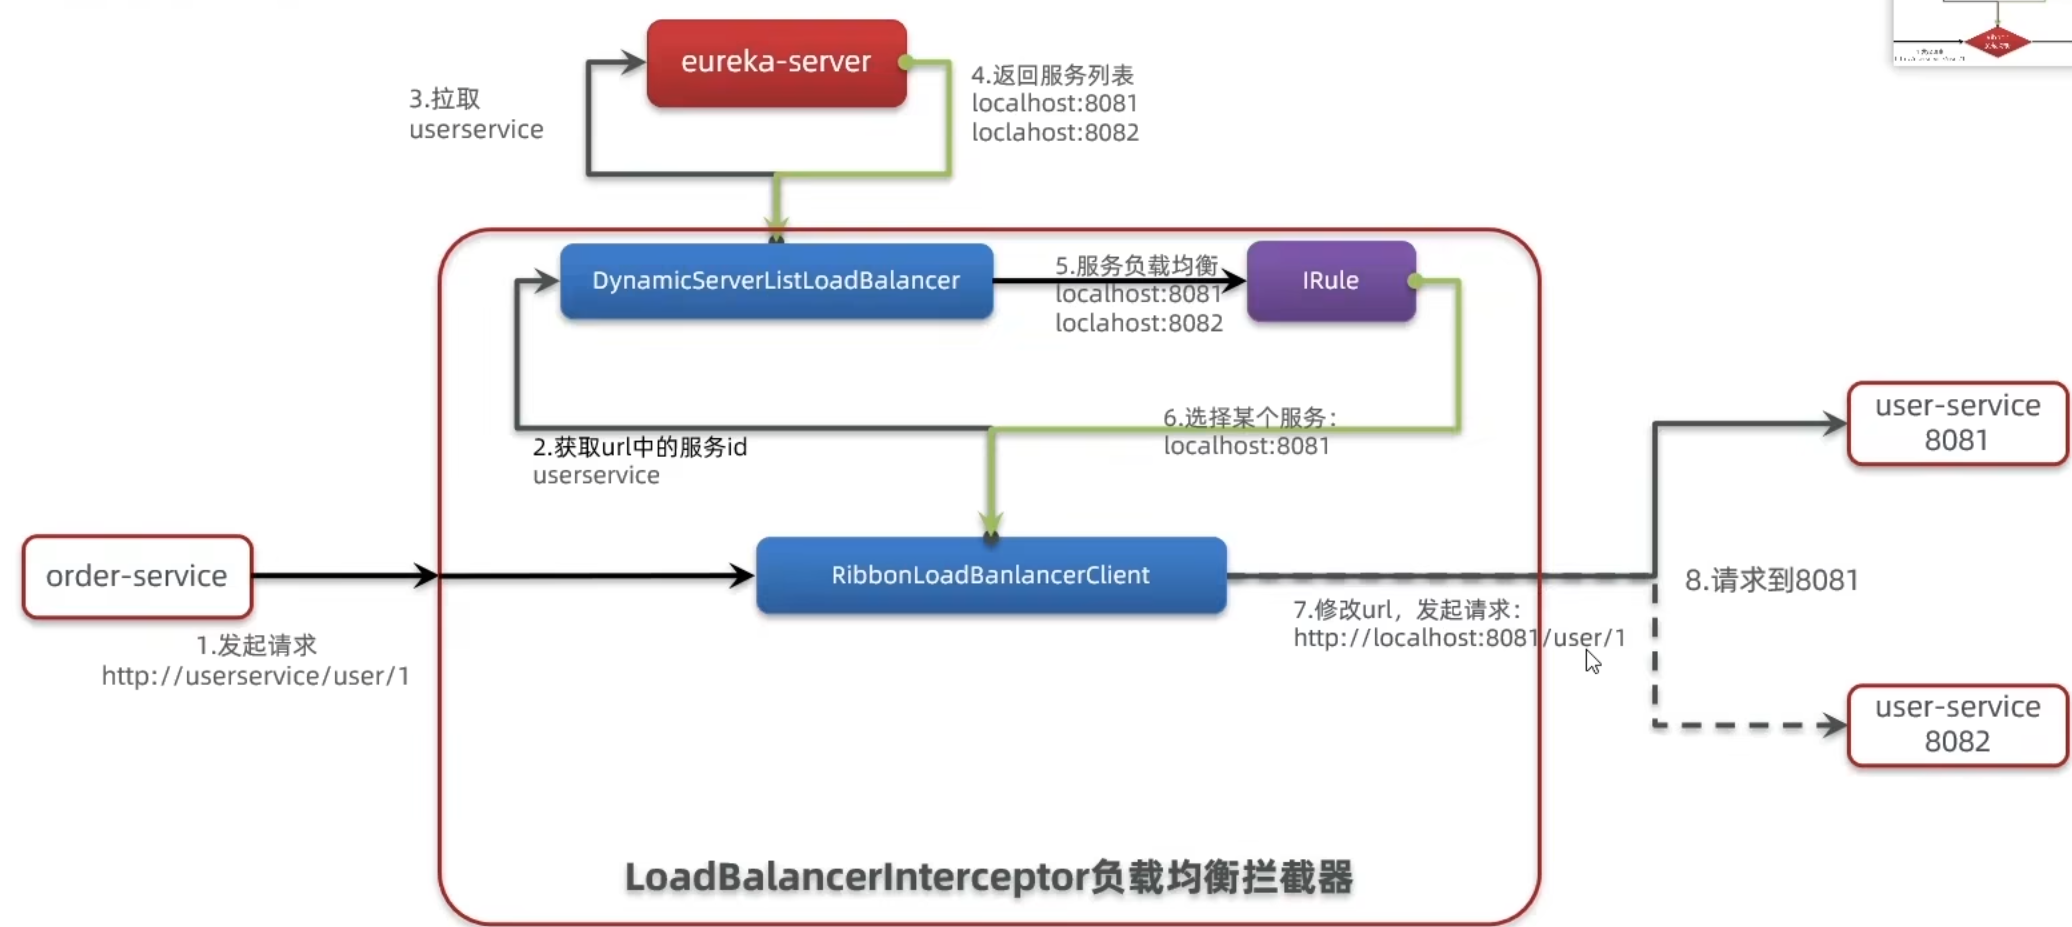
-
IRule接口中的负载均衡策略
通过定义IRule实现可以修改负载均衡规则(默认为轮询),有以下两种方式
-
代码方式:为IRule定义一个配置类
@Configurationpublic class IRuleConfig {@Beanpublic IRule RandomRule(){return new RandomRule();}} -
配置文件方式,在application.yml文件中,添加配置修改规则
优点:可以指定对某个微服务使用哪种负载均衡方式
userservice:ribbon:NFLoadBalancerRuleClassName: com.netflix.loadbalancer.RandomRule # 负载均衡规则
-
-
饥饿加载
Ribbon默认采用懒加载,即:第一次访问时才去创建LoadBalanceClient,请求时间较长。而饥饿加载会在项目启动时创建,降低第一次访问的耗时。通过application.yml开启
ribbon:eager-load:enabled: true #开启饥饿加载clients: userservice #指定开启饥饿加载的客户端
Nacos
- alibaba产品,现在是SpringCloud中的一个组件,与Eureka相同,也是一个注册中心,但是功能相对更加丰富
Ncos的安装与启动
-
安装
GitHub安装,此处选择的版本是1.4.1
-
启动
Terminal window startup.cmd -m standalone启动后点击给出的网址,账号密码都为nacos
快速入门
-
在cloud-demo父工程中添加spring-cloud-alibaba管理依赖
<dependency><groupId>com.alibaba.cloud</groupId><artifactId>spring-cloud-alibaba-dependencies</artifactId><version>2.2.5.RELEASE</version><type>pom</type><scope>import</scope></dependency> -
注释掉原有的eureka依赖
-
添加nacos客户端依赖
<!-- nacos客户端依赖 --><dependency><groupId>com.alibaba.cloud</groupId><artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId></dependency> -
修改原先客户端服务的application.yml中的地址(从eureka的地址改为nacos)
spring:cloud:nacos:server-addr: localhost:8848 # nacos 服务端地址
Nacos服务分级存储模型
-
示意图
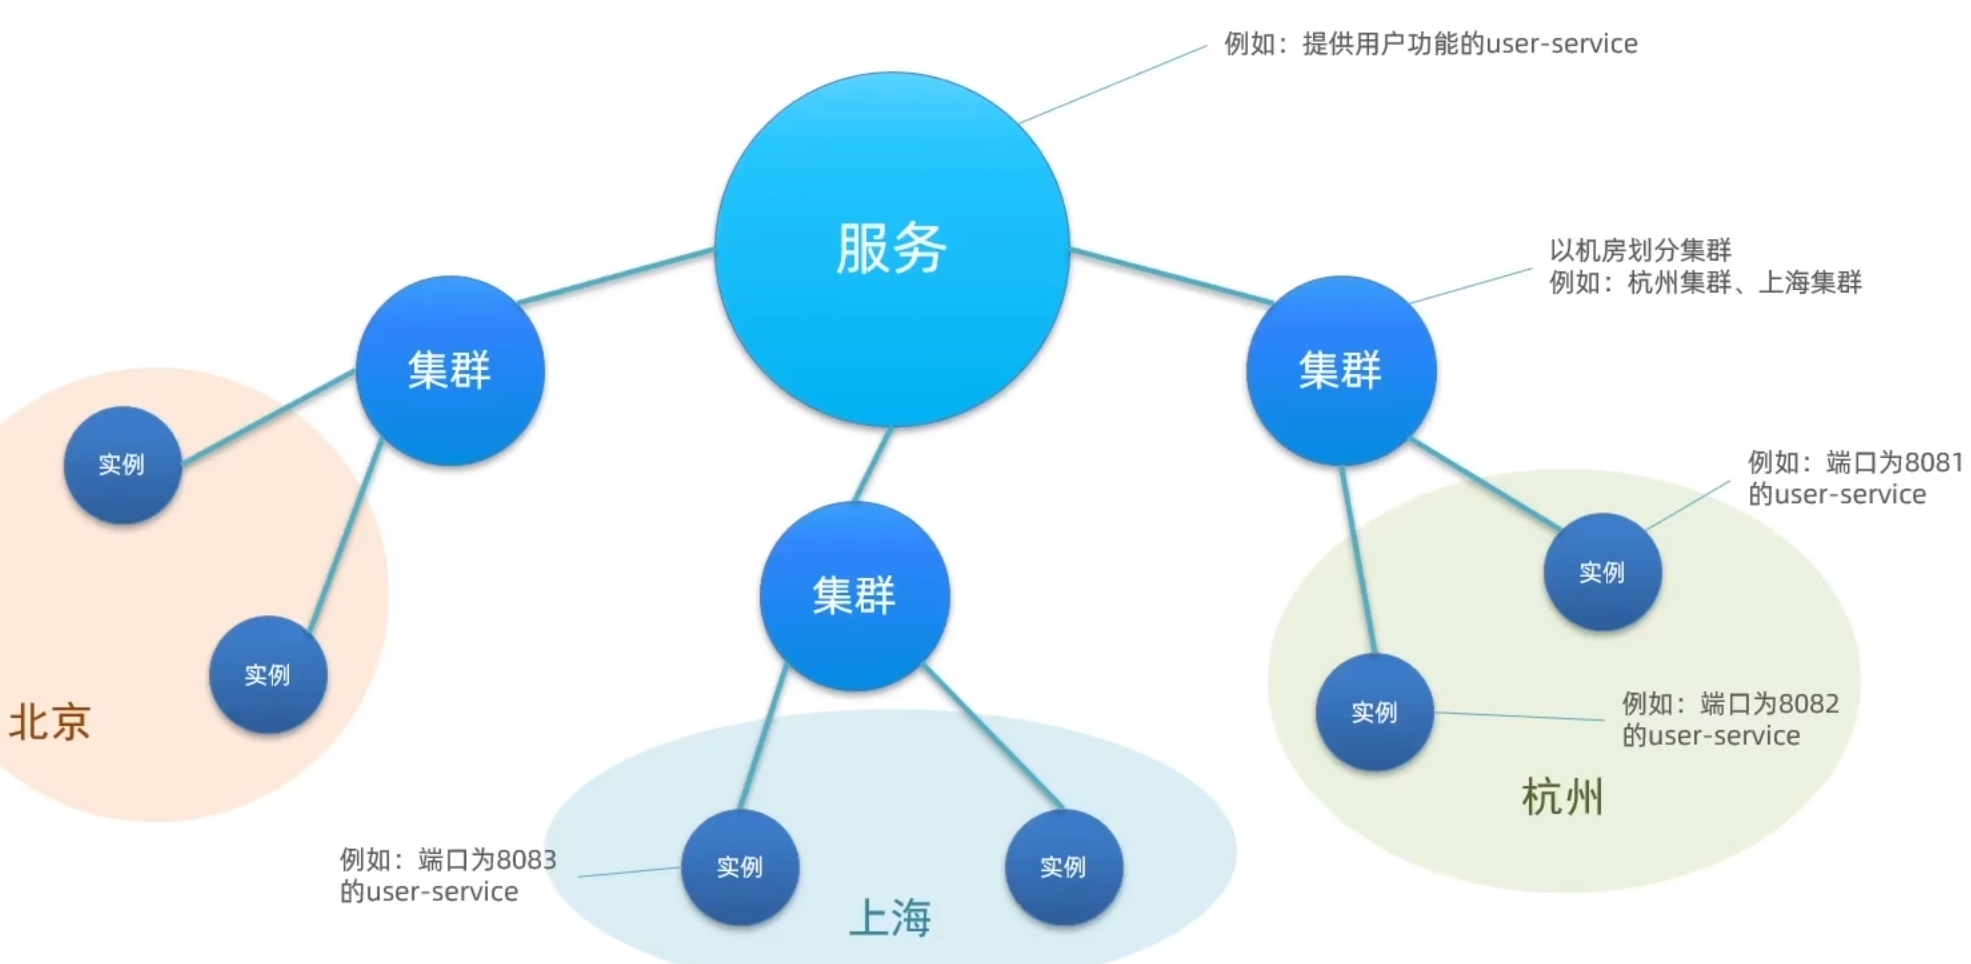
-
原因
在访问时,最好访问本地的服务器,这样速度快,Nacos服务分级存储模型就是为了尽可能地访问本地服务器
-
配置方法
修改application.yml
spring:nacos:server-addr: localhost:8848 #nacos服务地址discovery:cluster-name: TZ #集群名称如此一来就实现了不同微服务服务器的地域划分
NacosRule负载均衡
-
默认负载均衡为轮询方案。
若想要实现优先访问同集群内服务器的效果需要修改负载均衡方案
-
集群优先修改方法
在application.yml中添加
userservice:ribbon:NFLoadBalancerRuleClassName: com.alibaba.cloud.nacos.ribbon.NacosRule # 负载均衡规则NacosRule:优先选用本地集群,在本地集群内的多个服务器之间使用随机访问
-
根据权重负载均衡
可以通过权重配置来分担同个集群内,不同服务器的访问压力
在Nacos网页端可以直接编辑,将服务器的权重设为0后可以进行服务器的升级维护
环境隔离
-
namespace—命名空间
Nacos中服务存储和数据存储的最外层都是namespace,用于最外层的隔离
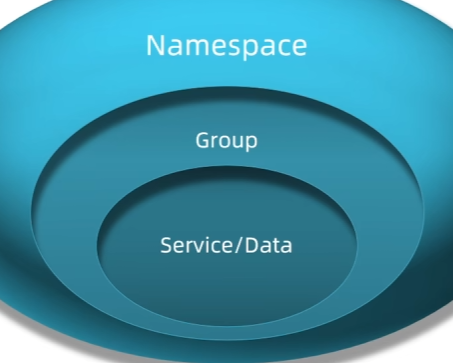
命名空间可以隔离不同环境(开发、测试、生产)
不同环境下的服务之间是不可见的,不可互相访问
-
操作
-
在Nacos网页端新建命名空间
-
在application.yml中添加命名空间,填入Nacos网页端生成的命名空间id,表示该服务被加入该命名空间
spring:nacos:server-addr: localhost:8848 #nacos服务地址discovery:cluster-name: TZ #集群名称namespace: ... #命名空间id
-
Nacos细节分析
-
示意图
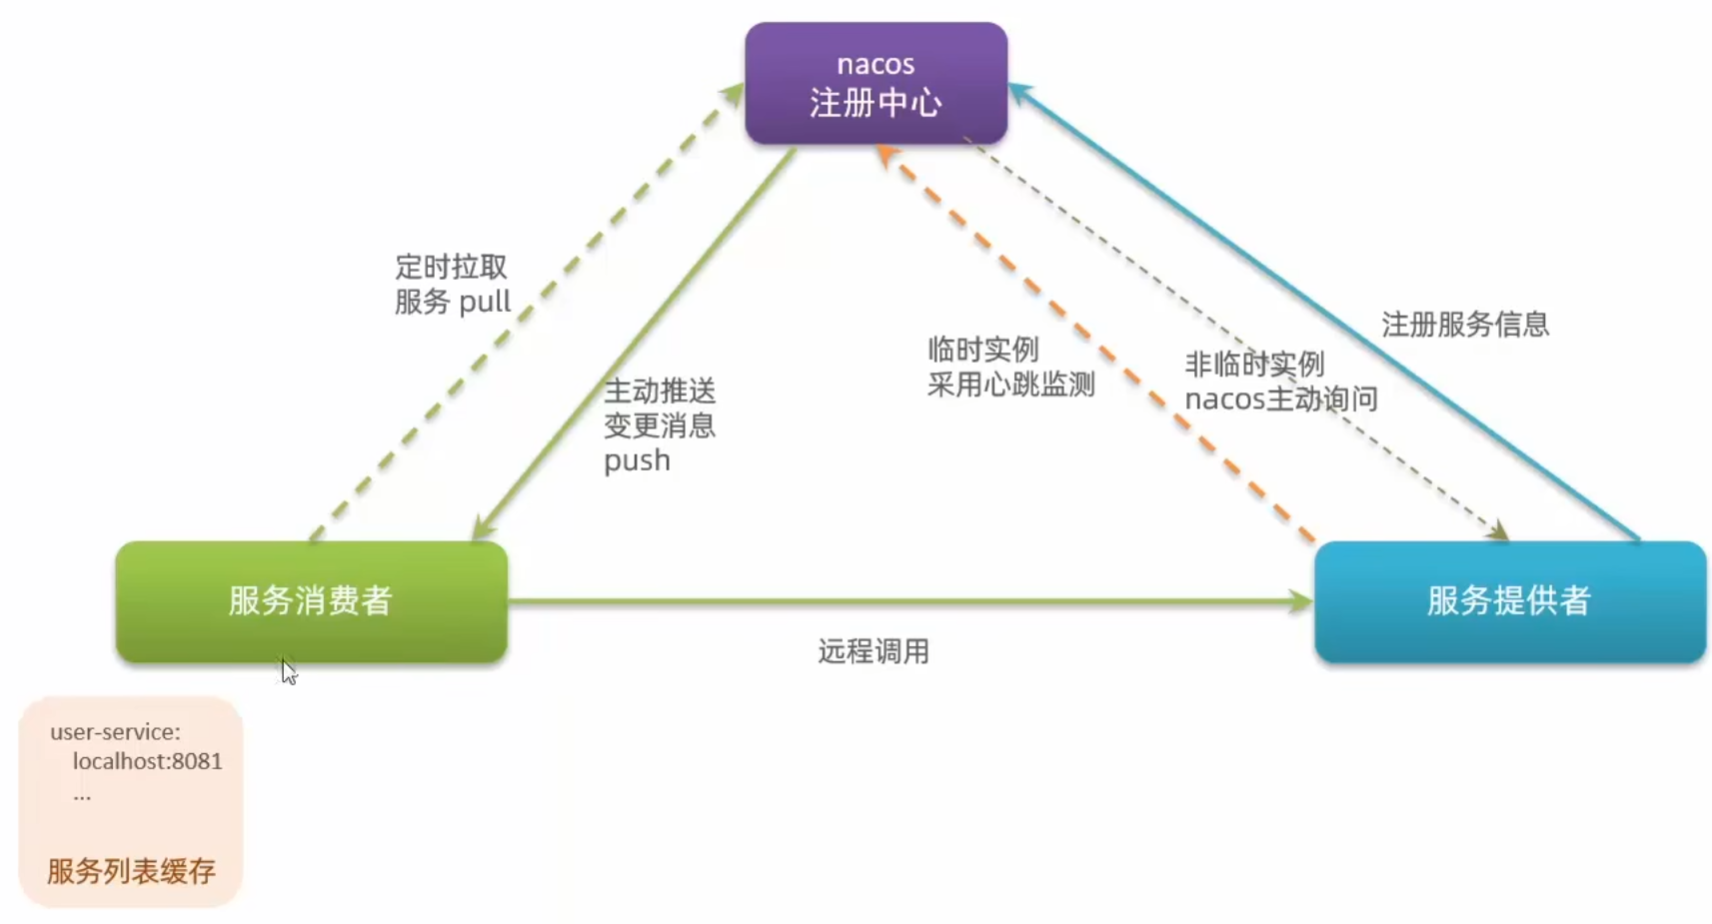
-
Nacos与Eureka的差别
-
对于服务消费者
nacos会主动推送变更消息给服务消费者,存入服务列表缓存
-
对于服务提供者
nacos中服务提供者分两种
-
临时实例:默认都为临时实例,通过心跳机制监测,服务宕机后立即踢除
-
非临时实例:需要在application.yml中配置,nacos主动询问监测,服务宕机后不会踢除
spring:nacos:server-addr: localhost:8848 #nacos服务地址discovery:cluster-name: TZ #集群名称namespace: ... #命名空间idephemeral: false #配置为非临时实例
-
-
Nacos配置管理
-
微服务架构中不仅有注册中心帮助管理提供者和消费者之间的远程调用。还有配置管理中心,可以实现多个微服务配置的统一管理和热更新
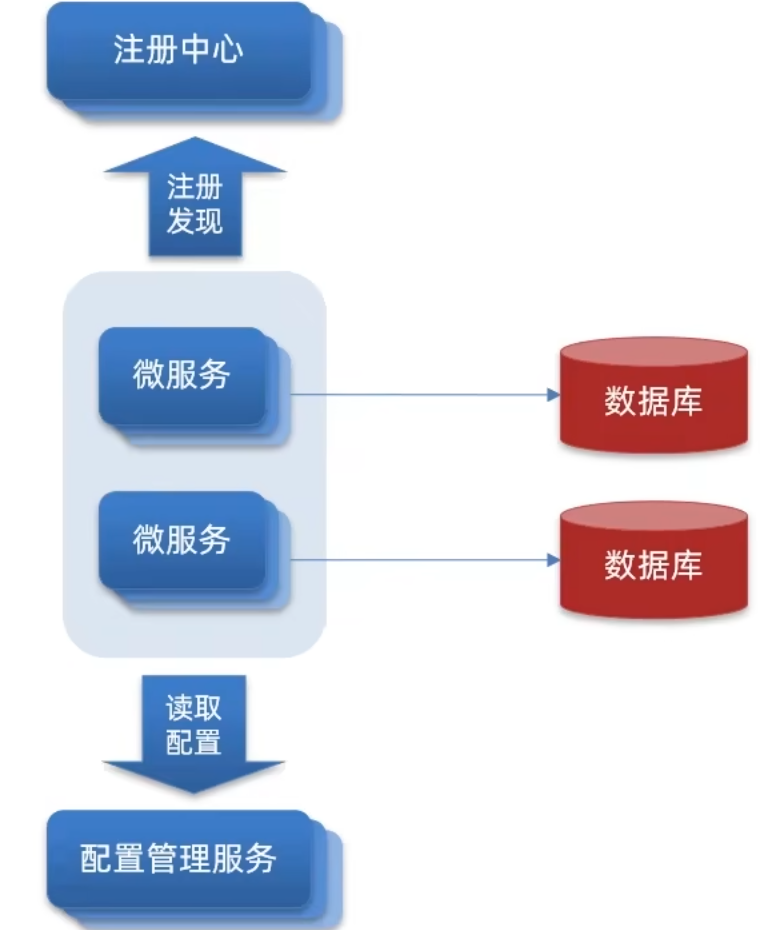
-
Nacos实现配置管理
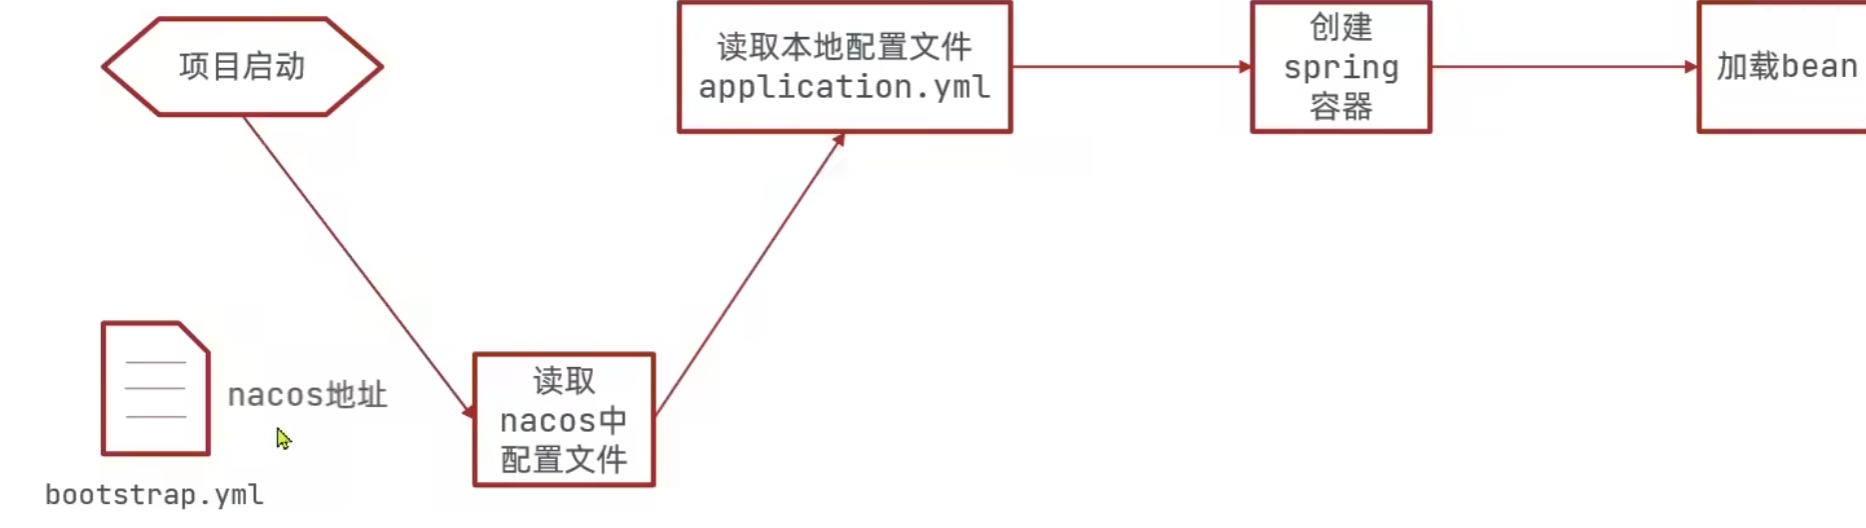
-
在Nacos网页端新建一个配置管理
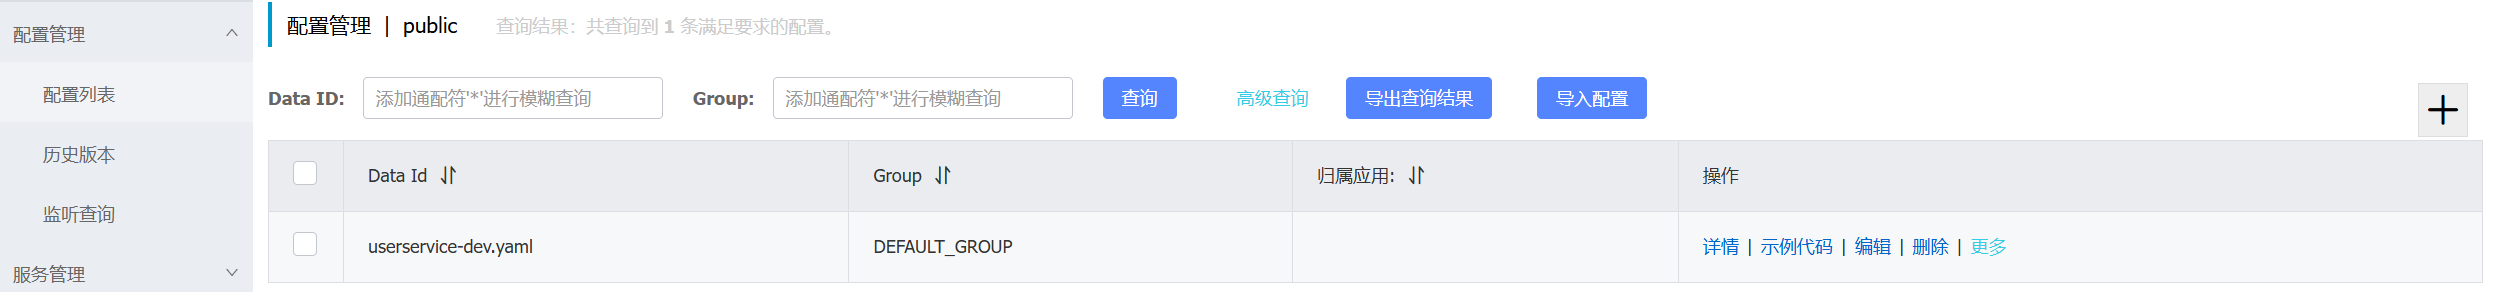
image-20260803104845189 -
引入Nacos配置管理的客户端依赖
<!-- nacos配置管理客户端依赖--><dependency><groupId>com.alibaba.cloud</groupId><artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId></dependency> -
在对应的微服务中配置bootstrap.yml配置文件
spring:application:name: userservice #服务名称profiles:active: dev #服务环境cloud:nacos:server-addr: localhost:8848 #nacos服务地址config:file-extension: yaml #后缀名# 其中服务名称、服务环境、后缀名 三者需要与创建的配置管理名一致Tip:application.yml中与bootstrap.yml中重复的部分可以注释掉了,因为bootstrap的优先级更高,且最后springCloud会对其进行合并
-
-
Nacos配置管理的热更新
-
方式一
在使用@Value注解读取配置时,还需在其所在类上加上**@RefreshScope**注解
@RefreshScopepublic class UserController {@Autowiredprivate UserService userService;@Value("${pattern.dateformat}")private String dateformat;@GetMapping("now")public String now(){//用于检验配置是否读取到return LocalDateTime.now().format(DateTimeFormatter.ofPattern(dateformat));} -
方式二:使用@ConfigurationProperties注解(将配置加载到一个对应实体类中)
@Data@Component@ConfigurationProperties(prefix = "pattern") //指定前缀public class PatternProperties {private String dateformat;//前缀和变量名拼接,拼接后相同的配置会被注入变量}
-
-
多环境配置共享
有一些配置在开发、生产、测试环境中是一致的,可以将这些不变的配置供多环境共享
-
原理
如:userservice-dev.yaml 和 userservice.yaml,第二者包含范围更大,也就是说在读取userservice-xxx(某环境的配置)之前一定会读取userservice.yaml。如此一来userservice.yaml就可以作为多环境下的共享配置供读取
-
实现
新建一个userservice.yaml将共享配置写入即可
优先级:带生产环境的远程配置(userservice-dev.yaml) > 共享远程配置(userservice.yaml) > 本地配置(application.yml)
-
Nacos集群搭建
-
集群结构图
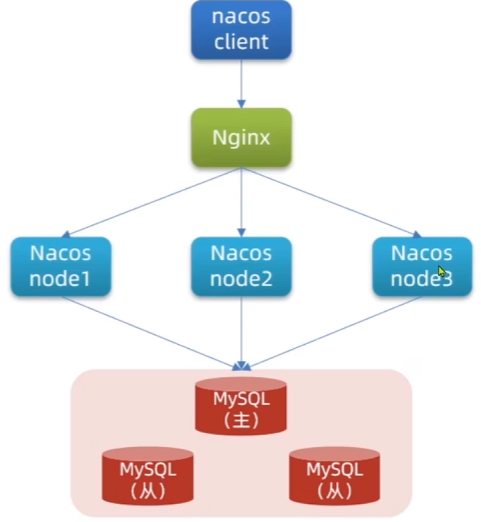
多个Nacos之间需要实现数据的共享,所以让多个Nacos去访问同一个MySQL集群中有关配置的表
-
实现
Feign
用于不同微服务之间的远程调用,相较于RestTemplate直接发送http请求更好
快速入门
-
RestTemplate存在的问题
- 代码可读性差
- 参数复杂的URL难以维护
-
Feign
声明式的http客户端
-
引入依赖
<dependency><groupId>org.springframework.cloud</groupId><artifactId>spring-cloud-starter-openfeign</artifactId></dependency> -
在对应微服务的启动类上添加@EnableFeignClients注解开启
@MapperScan("cn.itcast.order.mapper")@SpringBootApplication@EnableFeignClients //开启public class OrderApplication {public static void main(String[] args) {SpringApplication.run(OrderApplication.class, args);}} -
定义接口编写Feign客户端
@FeignClient("userservice")//声明向哪个服务发送请求public interface UserClient {@GetMapping("/user/{id}")//声明请求路径//利用一个函数声明返回值、传递参数User getUserById(@RequestParam("id") long id);} -
使用Feign远程调用
@Autowiredprivate UserClient userClient;public Order queryOrderById(Long orderId) {// 1.查询订单Order order = orderMapper.findById(orderId);// //2.RestTemplate发送请求// String url = "http://userservice/user/"+order.getUserId();// User user = restTemplate.getForObject(url, User.class);//// //3.赋值// order.setUser(user);//利用feign进行远程调用User user = userClient.getUserById(order.getUserId());order.setUser(user);// 4.返回return order;}
-
-
Feign一来内置Ribbon,默认支持负载均衡
Feign的自定义配置
-
Feign运行自定义配置来覆盖默认配置,可修改的配置如下
类型 作用 说明 feign.Logger.Level 修改日志级别 包含四种不同的级别:NONE、BASIC、HEADERS、FULL feign.codec.Decoder 响应结果的解析器 http 远程调用的结果做解析,例如解析 json 字符串为 java 对象 feign.codec.Encoder 请求参数编码 将请求参数编码,便于通过 http 请求发送 feign.Contract 支持的注解格式 默认是 SpringMVC 的注解 feign.Retryer 失败重试机制 请求失败的重试机制,默认是没有,不过会使用 Ribbon 的重试 一般我们需要配置的是日志
-
自定义日志
-
方式一:配置文件配置
-
全局配置
feign:client:config:default: # 这里用default就是全局配置,如果是写服务名称,则是针对某个微服务的配置loggerLevel: FULL # 日志级别 -
局部配置
feign:client:config:userservice: # 这里写服务名称,仅针对该微服务生效loggerLevel: FULL # 日志级别
-
-
方式二:Java代码
-
声明一个配置类(不要加@Configuration注解)
public class FeignClientConfiguration {@Beanpublic Logger.Level feignLogLevel(){return Logger.Level.BASIC;}} -
若是全局配置,则将这个类加到@EnableFeignClients
@EnableFeignClients(defaultConfiguration = FeignClientConfiguration.class) -
若是局部配置则加到@FeignClient注解中
@FeignClient(value = "userservice", configuration = FeignClientConfiguration.class)
-
-
Feign的性能优化
-
Feign的底层实现
Feign本身只做将声明转成Http请求的工作,发送Http请求还是会用到其他的客户端
- URLConnection:默认实现,不支持连接池
- Apache HttpClient:支持连接池
- OKHttp:支持连接池
-
切换Http客户端方法 (以HttpClient为例)
-
引入依赖
<dependency><groupId>io.github.openfeign</groupId><artifactId>feign-httpclient</artifactId></dependency><!-- 此依赖已经被spring管理,无需指定版本 --> -
配置连接池
feign:httpclient:enabled: true #开启Feign对HttpClient的支持max-connections: 200 #总最大连接数max-connections-per-route: 50 #每个路径的最大连接数
-
Feign的最佳实践
-
继承:给消费者的FeignClient和提供者的controller定义统一的父接口作为标准
原因:发送Http的方法(UserClient中的方法)和接口方法(Controller中的对应方法)的路径、返回值、参数必须都要一模一样,那么定义一个统一的父接口强制其一样就不容易出错
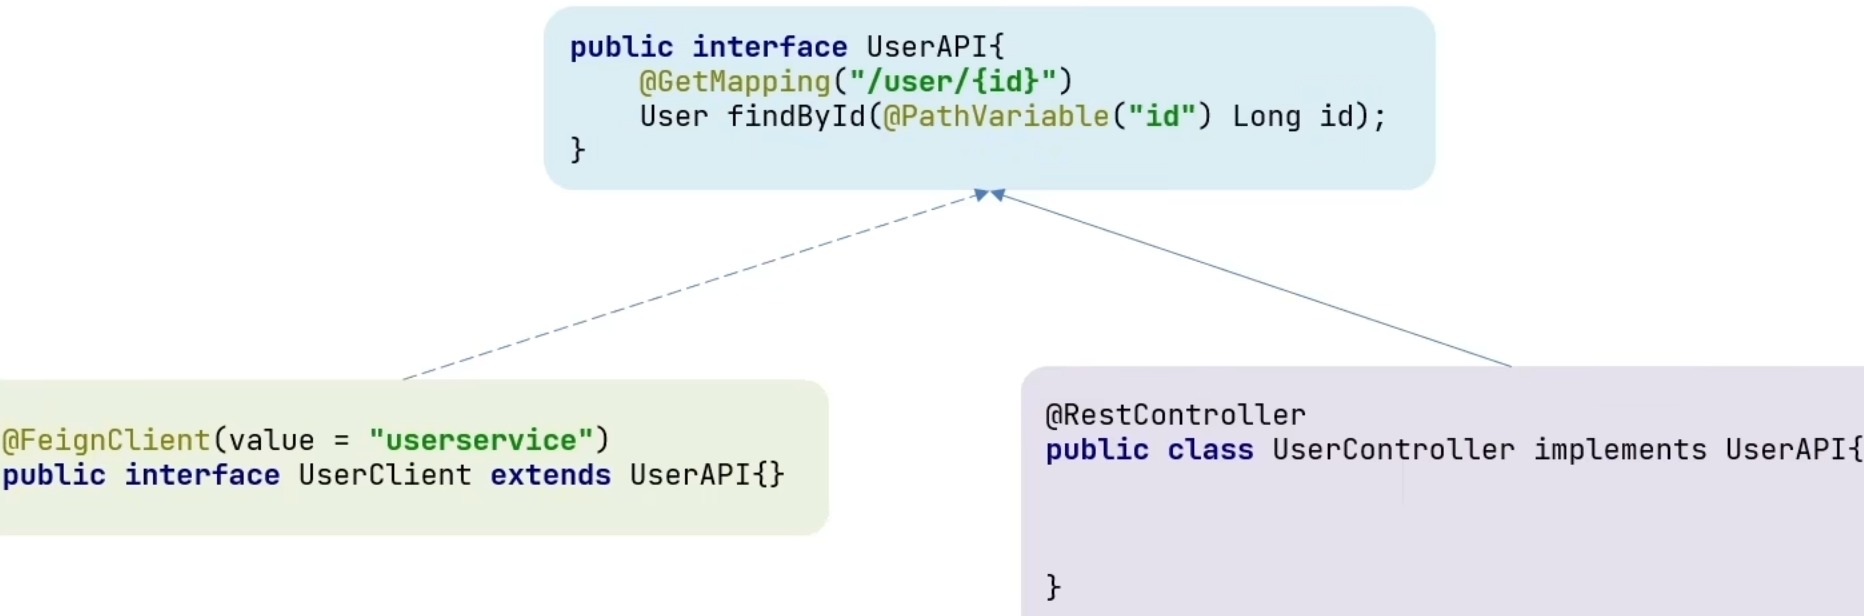
一般情况下不推荐这种方法,原因:1. 耦合太紧 2.声明对SpringMVC不起作用,如:@PathVariable是不能被继承下来的,在Controller里面还要重写方法
-
抽取:将FeignClient抽取为独立模块,并且把接口有关的Pojo、默认的Feign配置都放在这个模块中,提供给所有消费者使用
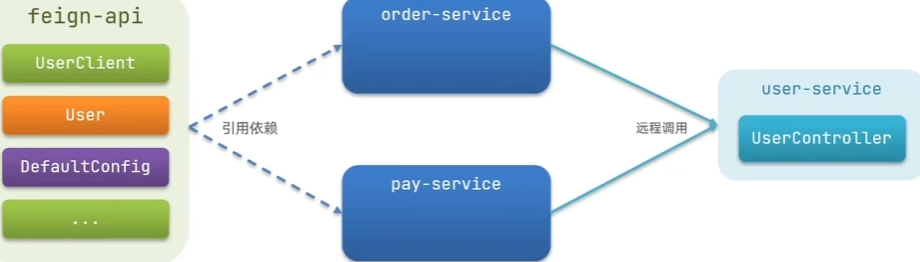
网关
基本概念
-
网关功能
- 身份认证和权限校验
- 服务路由、负载均衡
- 请求限流
-
SpringCloud中的网关包括两种
- getway
- zuul
zuul是基于Servlet实现的,属于阻塞式编程。gateway基于Spring5中的WebFlux,属于响应式编程,具备更好的性能
搭建网关服务
-
创建新的模块,引入gateway依赖和nacos服务发现依赖(将网关模块也注册进nacos)
<dependency><groupId>com.alibaba.cloud</groupId><artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId></dependency><dependency><groupId>org.springframework.cloud</groupId><artifactId>spring-cloud-starter-gateway</artifactId></dependency> -
编写路由及nacos地址
server:port: 10010 # 网关端口spring:application:name: gateway # 服务名称cloud:nacos:server-addr: localhost:8848 # nacos地址gateway:routes: # 网关路由配置- id: user-service # 路由id,自定义,只要唯一即可# uri: http://127.0.0.1:8081 # 路由的目标地址 http就是固定地址uri: lb://userservice # 路由的目标地址 lb就是负载均衡,后面跟服务名称predicates: # 路由断言,也就是判断请求是否符合路由规则的条件- Path=/user/** # 这个是按照路径匹配,只要以/user/开头就符合要求- id: order-serviceuri: lb://orderservicepredicates:- Path=/order/** -
配置网关后,需访问网关端口,由网关将请求进行路由
Nginx和GateWay的区别
Nginx也算是一种网关。通常被置于最外层,用来承接一些公网请求。当请求通过Nginx后再由GateWay将请求路由至指定的微服务
浏览器/手机用户 → 【Nginx(外层接入网关)】 → 【SpringCloud Gateway(微服务网关)】 → user服务/order服务
路由断言工厂
-
我们配置网关时写的断言规则时字符串,这些字符串会被Predicate Factory读取并处理,转变为路由判断的条件
-
SpringCloudGateWay有十几个断言工厂
名称 说明 示例 After 匹配指定时间点之后发起的请求 - After=2037-01-20T17:42:47.789-07:00[America/Denver]Before 匹配指定时间点之前发起的请求 - Before=2031-04-13T15:14:47.433+08:00[Asia/Shanghai]Between 匹配两个时间区间内发起的请求 - Between=2037-01-20T17:42:47.789-07:00[America/Denver],2037-01-21T17:42:47.789-07:00[America/Denver]Cookie 请求必须携带指定 Cookie(可正则匹配 Cookie 值) - Cookie=chocolate, ch.pHeader 请求必须携带指定请求头,可正则匹配头值 - Header=X-Request-Id, \d+Host 匹配请求访问的域名 Host,支持通配符 - Host=**.somehost.org,**.anotherhost.orgMethod 限定请求 HTTP 请求方式(GET/POST 等) - Method=GET,POSTPath(常用) 匹配请求访问路径,支持通配符、路径占位符 - Path=/red/{segment},/blue/**Query 请求必须包含指定 URL 参数,可指定参数值 - Query=name,Jack或者- Query=nameRemoteAddr 匹配客户端请求 IP 地址段 - RemoteAddr=192.168.1.1/24Weight 权重路由,用于灰度发布、流量分发 无
网关过滤器
-
可以对进入网关的请求与微服务返回的响应做处理
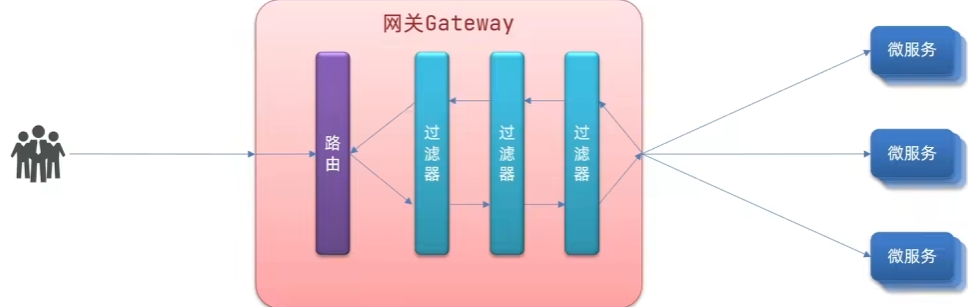
-
过滤器工厂GateWayFilterFactory
名称 说明 AddRequestHeader 给当前请求添加一个请求头 RemoveRequestHeader 移除请求中的一个请求头 AddResponseHeader 给响应结果中添加一个响应头 RemoveResponseHeader 从响应结果中移除一个响应头 RequestRateLimiter 限制请求的流量 …… -
添加方法
局部生效:在application.yml文件中对应服务下添加
spring:cloud:gateway:routes: # 网关路由配置- id: user-serviceuri: lb://userservicepredicates:- Path=/user/**filters: # 过滤器- AddRequestHeader=Truth, xxxxxx(添加的内容) # 添加请求头全局生效:default-filters
spring:cloud:gateway:routes: # 网关路由配置- id: user-serviceuri: lb://userservicepredicates:- Path=/user/**default-filters: # 全局过滤器 注意:与routes平级!- AddRequestHeader=Truth, xxxxxx(添加的内容) # 添加请求头 -
自定义全局过滤器 — GlobalFilter
类似default-filters,同样可以过滤所有请求,不过与之不同的是,GlobalFilter可以自定义处理逻辑
-
实现
定义一个GlobalFliter接口的实现类
public interface GlobalFilter {/*** 处理当前请求, 有必要的话通过{@link GatewayFilterChain}将请求交给下一个过滤器处理** @param exchange 请求上下文, 里面可以获取Request、Response等信息* @param chain 用来把请求委托给下一个过滤器* @return {@code Mono<Void>} 返回标示当前过滤器业务结束*/Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain);}@Component@Order(value = -1)//指定当前过滤器的优先级 越小优先级越高 范围:-21亿 ~ 21亿public class AuthorizeFilter implements GlobalFilter {@Overridepublic Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {//1.获取请求参数ServerHttpRequest request = exchange.getRequest();MultiValueMap<String, String> queryParams = request.getQueryParams();//2.获取参数中的 authorization参数String auth = queryParams.getFirst("authorization");//3.判断参数值是否为adminif("admin".equals(auth)){return chain.filter(exchange);//放行:调用下一个exchange的方法}//4.是则放行,不是则拦截//设置状态码并拦截exchange.getResponse().setStatusCode(HttpStatus.UNAUTHORIZED);return exchange.getResponse().setComplete();}}
-
-
请求路由后,会将上述三种过滤器合并到一个过滤器链(集合)当中,排序后依次执行每个过滤器
- 在配置文件中添加的两个filter都为GateFilter类,可以加入同一个集合。而GlobalFilter会先转换为GateFilter再加入集合
- 排序规则:
- GlobalFilter可以自定义Order的值,而另外两种Filter由Spring指定Order的值,默认是按照声明顺序从1开始递增
- 当Order值相同时优先级如下:defaultfilter > 路由过滤器 > GlobalFilter
网关的跨域cors配置
-
跨域问题:在某一服务的前端界面访问另一服务的接口,会被浏览器拦截
-
解决方法:CORS(跨域资源共享),后端告诉浏览器:允许某个前端域名访问我的接口,浏览器就会放行请求。
-
实现
spring:cloud:gateway:globalcors: # 全局的跨域处理add-to-simple-url-handler-mapping: true # 解决options请求被拦截问题corsConfigurations:'[/**]':allowedOrigins: # 允许哪些网站的跨域请求- "http://localhost:8090"- "http://www.leyou.com"allowedMethods: # 允许的跨域ajax的请求方式- "GET"- "POST"- "DELETE"- "PUT"- "OPTIONS"allowedHeaders: "*" # 允许在请求中携带的头信息allowCredentials: true # 是否允许携带cookiemaxAge: 360000 # 这次跨域检测的有效期
-
Docker
Docker简介
-
微服务项目中大型项目组件较多,运行环境较为复杂,部署时会碰到一些问题
- 依赖关系复杂,容易出现兼容性问题
- 开发、测试、生产环境有差异
Docker可以将所要的函数库、依赖、配置进行打包,并放到隔离容器中运行,避免互相干扰
-
Linux操作系统中,有许多不同的发行版本。不同的发行版本对应不同的系统应用,系统应用封装内核指令为函数,方便调用。不同的系统应用所封装成的函数有差异,所以Ubuntu上的软件无法在Centos上正常运行
-
Docker如何解决上述问题?
Docker将用户程序和所需调用的系统(如:Ubuntu)一起打包,在运行时调用容器中的系统函数,直接通过打包好的系统与内核进行交互
-
初始Docker
-
镜像和容器
-
镜像(Image):Docker将应用程序及其所需依赖、函数库、环境、配置等文件打包在一起,称为镜像
镜像的呈现形式就是磁盘中的文件
-
容器(Container):镜像中的应用程序运行后形成的进程就是容器,只是Docker会给容器做隔离,对外不可见
为了防止镜像产生污染,镜像是只读的,只能用于创建容器和供容器读取数据。若容器想要产生数据,需从镜像拷贝一份文件到自己的独立文件系统中,写到拷贝文件中
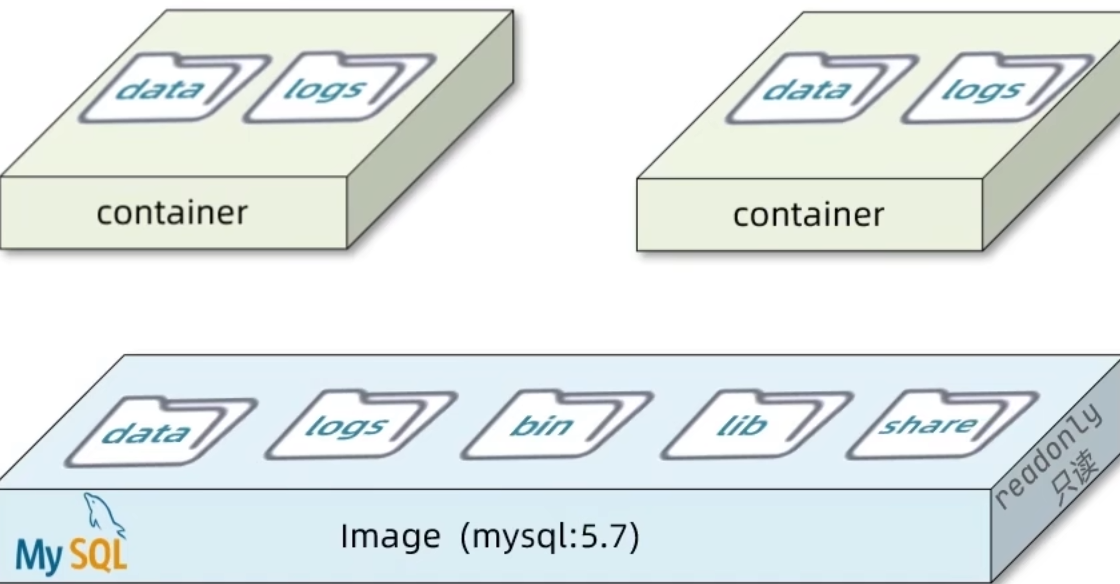
-
-
Docker Hub
镜像托管平台,类似GitHub,用于管理镜像,共享镜像资源
-
Docker架构
CS架构,由两部分组成
- 服务端(Server):Docker守护进程,负责处理Docke指令,管理镜像、容器等
- 客户端(Client):通过命令或RestAPI向Docker服务端发送指令。可以在本地或远程向服务端发送指令
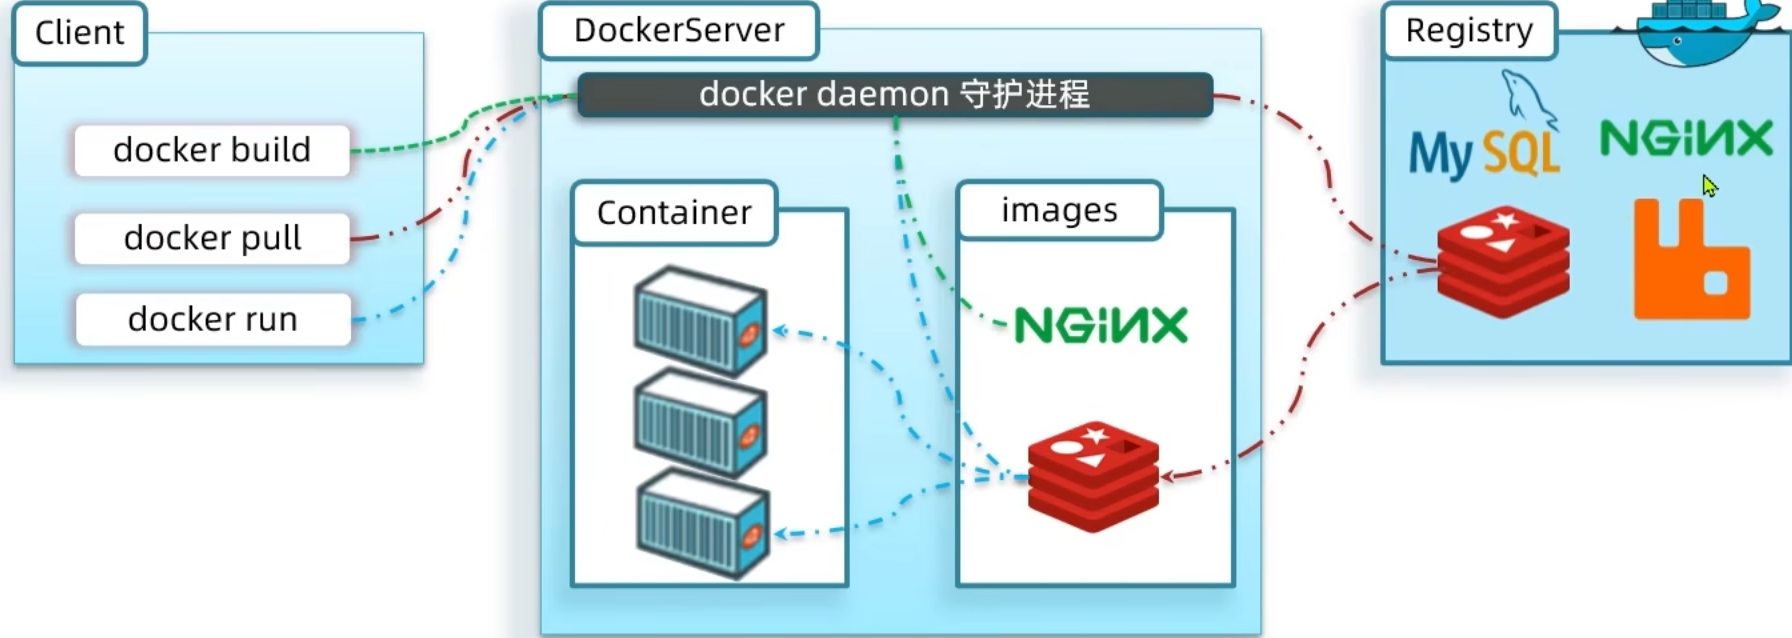
Docker的基本操作
为方便学习,此处在Windows上安装docker,并使用wsl的cli用linux命令对docker进行操作
-
镜像相关命令
镜像名称一般由两部分组成:[repository]:[tag]
若tag没有指定,默认为最新版本的镜像
-
查看镜像
Terminal window docker images -
删除镜像
Terminal window docker rmi -
构建镜像
Terminal window docker build -
将镜像推送到服务器
Terminal window docker push -
从服务器拉取镜像
Terminal window docker pull -
保存镜像为压缩包
Terminal window docker save -
加载压缩包为镜像
Terminal window docker load
Terminal window docker help #查看docker中的所有命令docker images #查看images命令的详细用法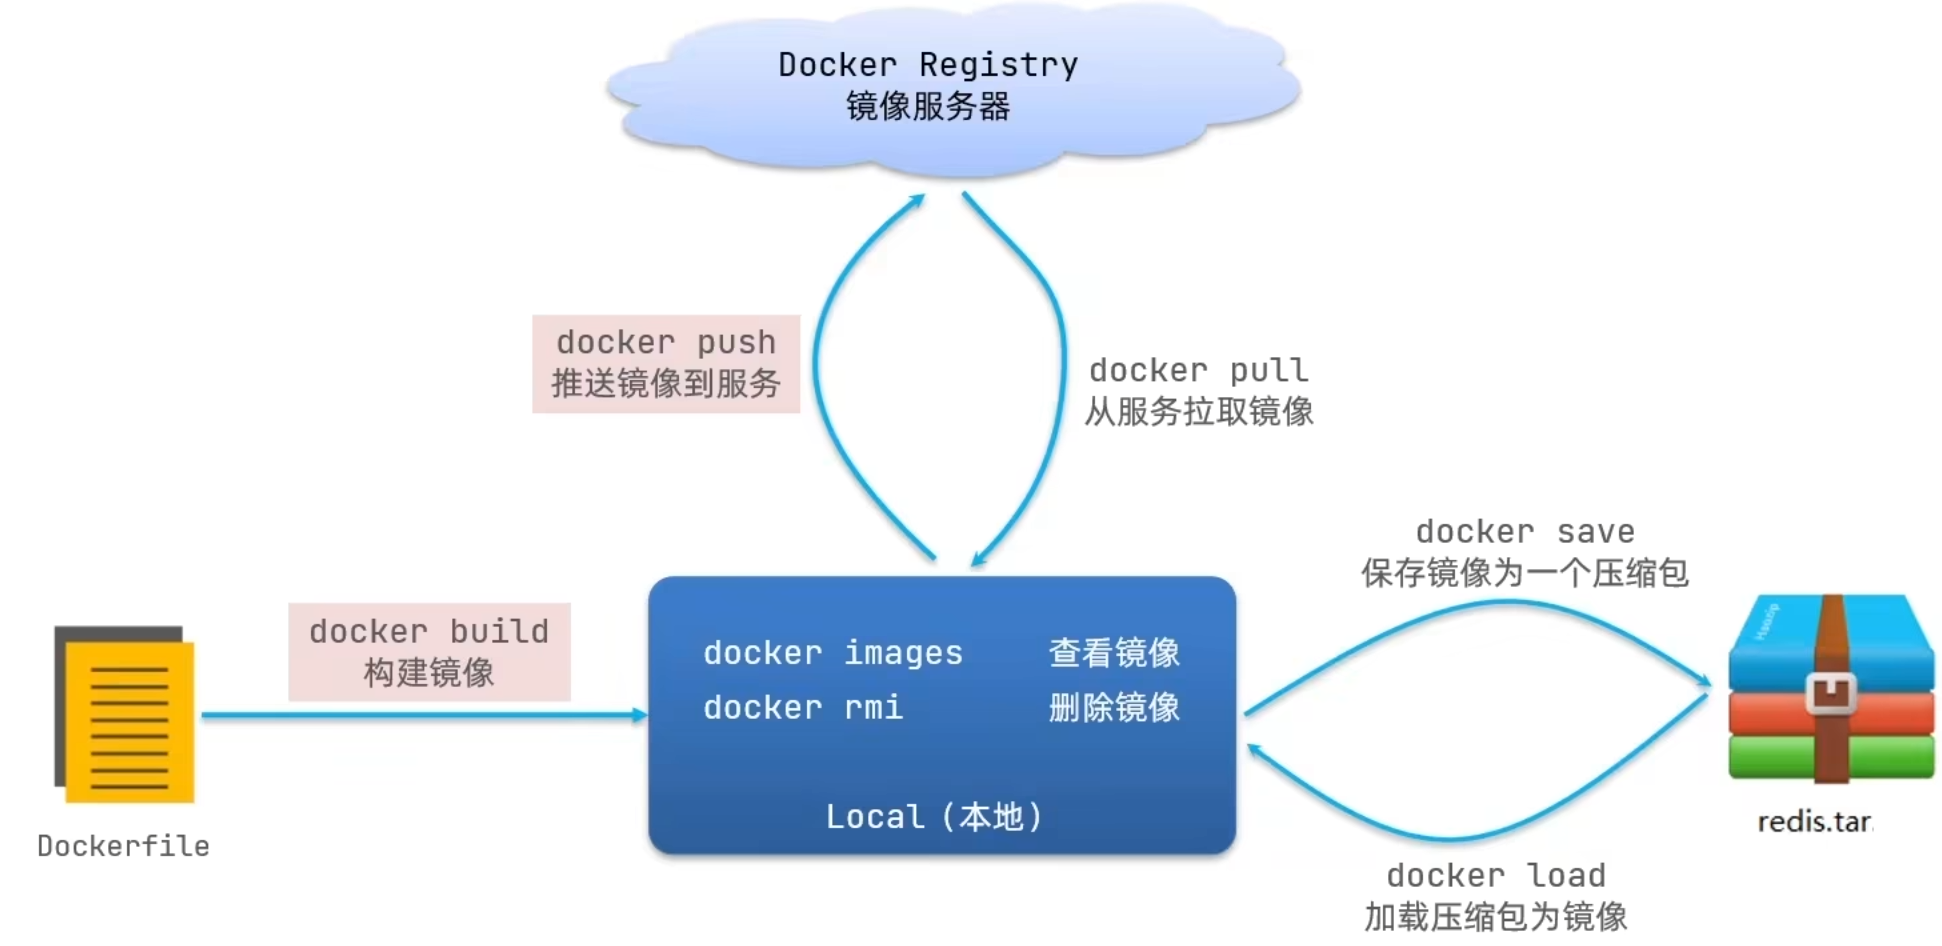
-
-
容器相关命令
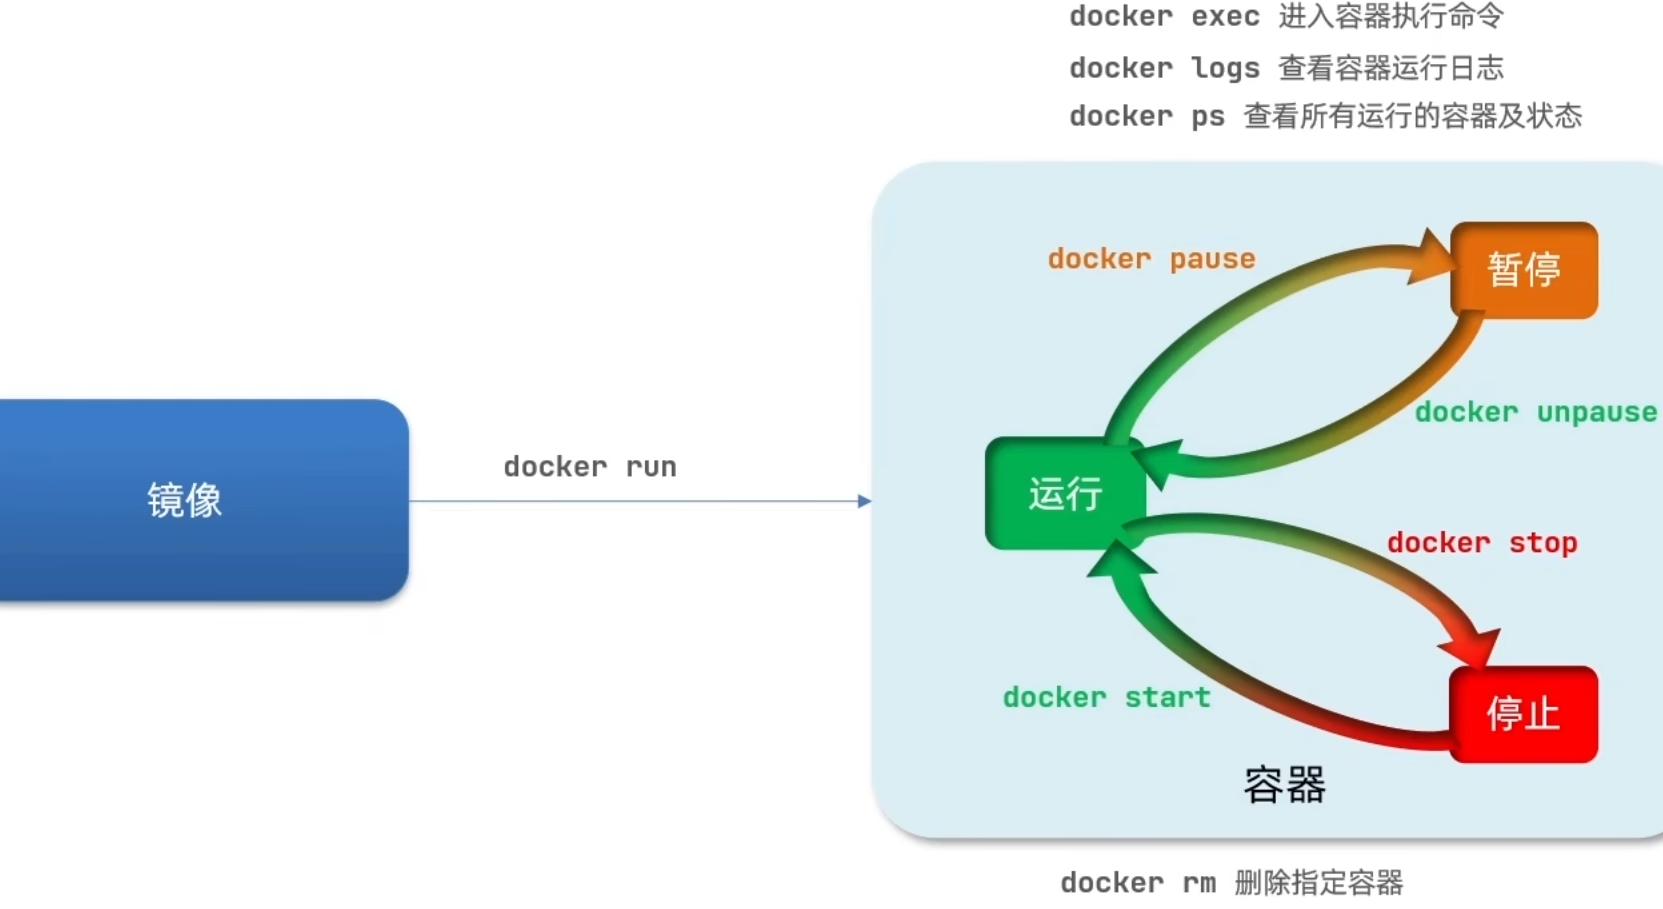
-
运行容器
Terminal window docker run -
运行到暂停
Terminal window docker pause -
暂停到运行
Terminal window docker unpause -
运行到停止
Terminal window docker stop -
停止到运行
Terminal window docker start -
查看容器状态
Terminal window docker ps # 默认查看运行中容器 -a查看所有容器 -
查看日志
Terminal window docker logs -
进入容器执行命令
Terminal window docker exec -
删除容器
Terminal window docker rm
-
-
案例:在docker上运行Nginx容器
Terminal window docker run --name containername -p 80:80 -d nginx-p :将宿主机端口与容器端口映射,冒号左侧是宿主机端口,右侧是容器端口 容器端口一般取决于应用程序的运行端口
-d :后台运行
Terminal window docker exec -it containername bash-it :给当前进入的容器创建一个标准输入输出的终端,允许我们与容器交互
bash:进入容器后执行命令的终端
数据卷
-
上述操作存在一定问题(容器与数据耦合)
- 不便于修改,需要使用
docker exec进入容器内部进行修改 - 数据不可复用,在容器内的修改对外不可见。所有修改对新建的容器是不可复用的
- 升级维护困难,删若需要升级容器,则需要删除容器重新部署,这样一来数据就都丢失了
- 不便于修改,需要使用
-
数据卷(volume)
是一个虚拟目录,指向宿主机文件系统中的某个目录
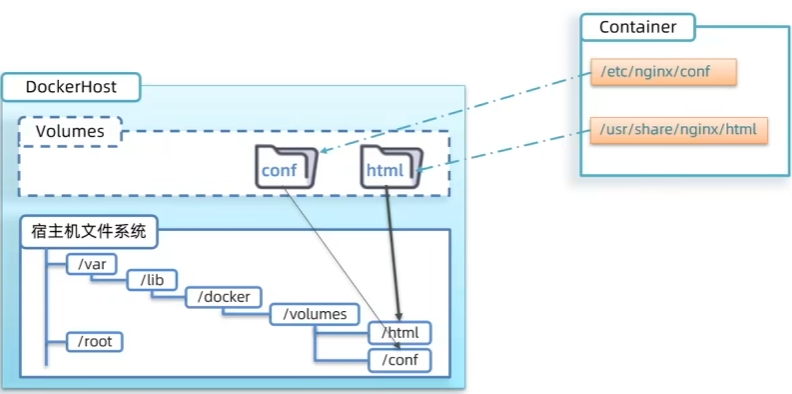
如此一来就实现了容器与数据的解耦,将容器中的数据抽离到宿主机上。
Linux系统上默认会挂在到宿主机的:
/var/lib/docker/volumes/html/_dataWindows系统上默认会挂在到宿主机的:
\\wsl.localhost\docker-desktop\mnt\docker-desktop-disk\data\docker\volumes\html\_data -
操作数据卷的命令
Terminal window docker volume [command][command]有以下几个常用命令
- create 创建一个volume
- inspect 显示一个或多个volume信息
- ls 列出所有volume
- prune 删除未使用volume
- rm 删除一个或多个指定的volume
-
数据卷的挂载
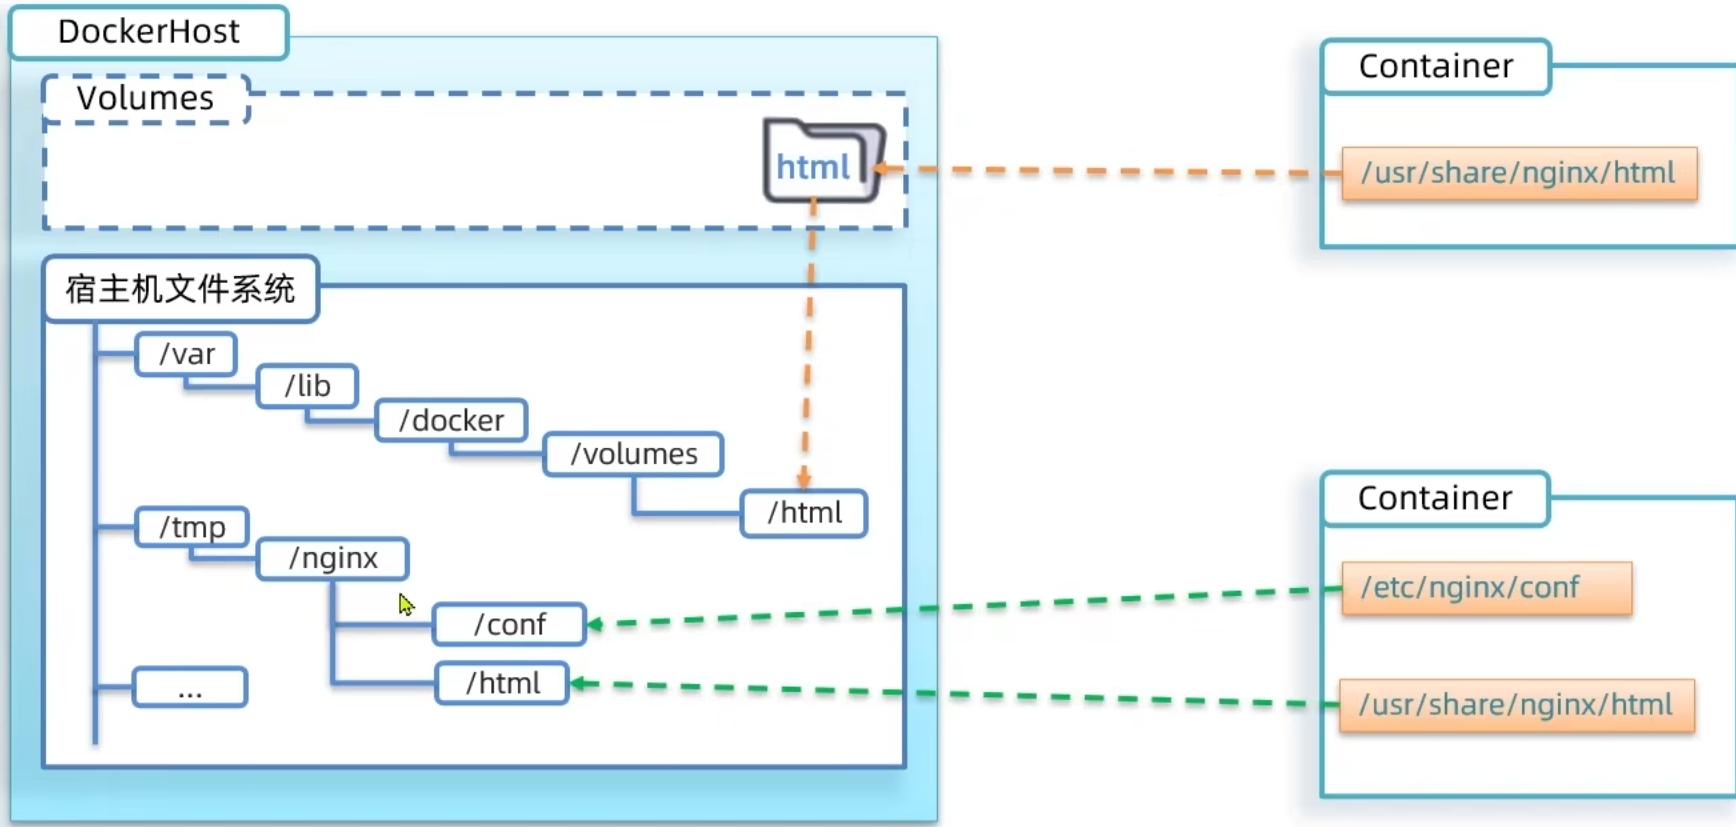
在创建容器时,我们可以通过**-v参数来挂载一个数据卷到某个容器目录**
Terminal window docker run --name mn -p 80:80 -v html:/usr/share/nginx/html -d nginx-v后冒号前面的表示volume的名称,后面的是容器中的数据路径
除此之外,-v还可以直接将容器内目录挂在到宿主机的目录上
- -v [宿主机目录]:[容器内目录]
- -v [宿主机文件]:[容器内文件]
两种挂载方式的区别示意图
Dockerfile自定义镜像
-
镜像结构(以MySQL为例)
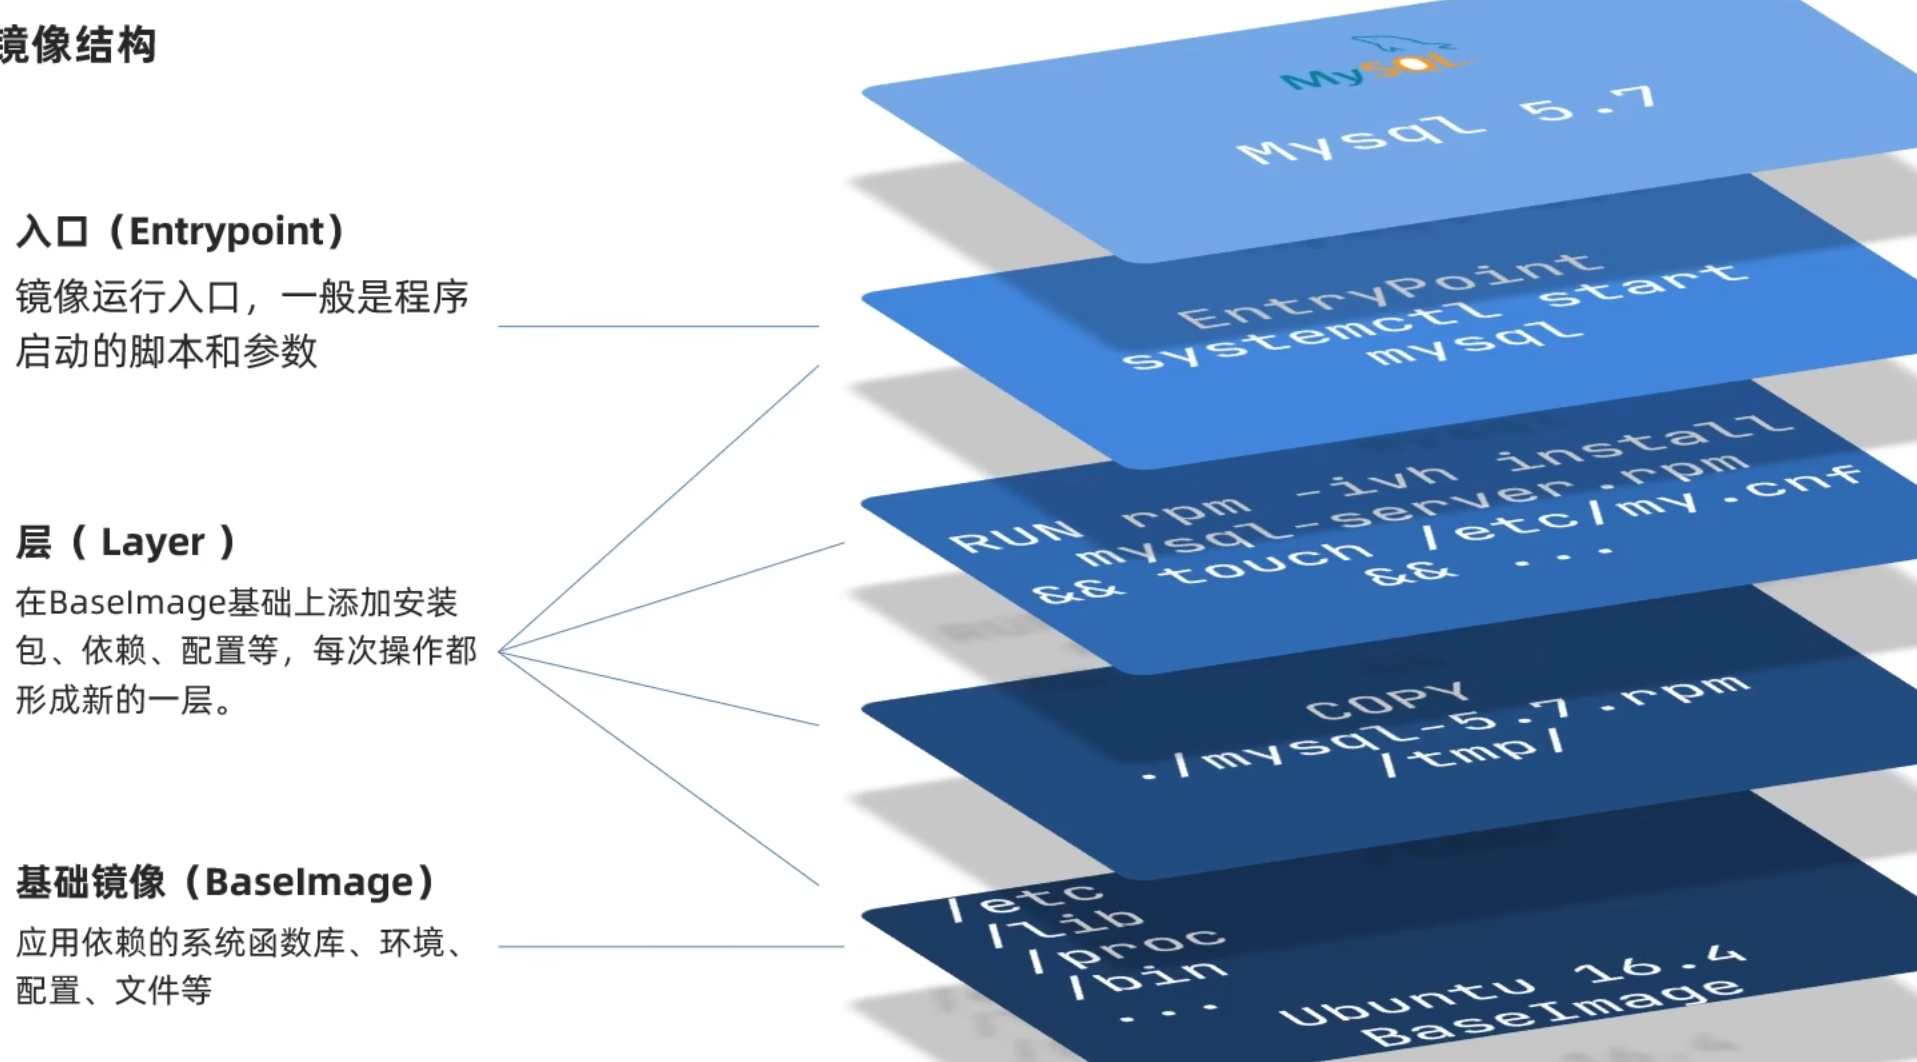
BaseImage和EntryPoint是必须的,剩余的Layer视具体情况而定
-
Dockerfile
一个文本文件,其中包含各种指令,用指令来说明要执行什么操作来构建镜像,每一层指令都会形成一层layer
指令 说明 示例 FROM 指定基础镜像 FROM centos<6> ENV 设置环境变量,可在后面指令使用 ENV key value COPY 拷贝本地文件到镜像的指定目录 COPY ./mysql-5.7.rpm /tmp RUN 执行 Linux 的 shell 命令,一般是安装过程的命令 RUN yum install gcc EXPOSE 指定容器运行时监听的端口,是给镜像使用者看的 EXPOSE 8080 ENTRYPOINT 镜像中应用的启动命令,容器运行时调用 ENTRYPOINT java -jar xx.jar
Docker Compose
-
简介
Docker Compose可以基于Compose文件,帮助我们快速部署分布式应用,而无需我们手动一个个创建和运行容器
Compose:一个文本文件,通过指令定义集群中的每个容器如何运行
可以说,Compose就是多个docker run指令的集合,或者说Docker Compose就是将镜像启动成容器的脚本
-
示例
dockercompose
version: "3.8"services:mysql:image: mysql:5.7.25environment:MYSQL_ROOT_PASSWORD: 123volumes:- /tmp/mysql/data:/var/lib/mysql- /tmp/mysql/conf/hmy.cnf:/etc/mysql/conf.d/hmy.cnfweb:build: .ports:- 8090:8090对应的docker命令
Terminal window # MySQL容器docker run \--name mysql \-e MYSQL_ROOT_PASSWORD=123 \-p 3306:3306 \-v /tmp/mysql/conf/hmy.cnf:/etc/mysql/conf.d/hmy.cnf \-v /tmp/mysql/data:/var/lib/mysql \-d \mysql:5.7.25# 构建镜像docker build -t web:1.0 .# 运行容器docker run --name web -p 8090:8090 -d web:1.0二者对比
docker run 参数 等价 compose 配置 作用说明 --name mysql服务名 mysql:给容器自定义名称 -e MYSQL_ROOT_PASSWORD=123environment:设置环境变量 -p 8090:8090ports: - 8090:8090端口映射 宿主机:容器 -v 宿主机路径:容器路径volumes:数据卷挂载(配置 + 数据持久化) -d默认后台运行 守护进程,后台启动容器 末尾 mysql:5.7.25image: mysql:5.7.25指定镜像
-
-
作用
快速地构建和部署微服务集群
镜像仓库
-
镜像仓库有公有和私有两种形式
-
公有
如Docker官方的Docker Hub。国内如:网易云镜像服务、阿里云镜像服务
-
私有
企业内部,个人用户,都可以搭建私有仓库
-
-
私有仓库的搭建
可以基于Docker官方提供的DockerRegistry实现
使用DockerCompose部署带有图形化界面的DockerRegistry
-
配置Docker信任地址
私服采用http协议,默认不被Docker信任,要先做一个配置
Windows版的Docker可以直接在图形化界面进行修改
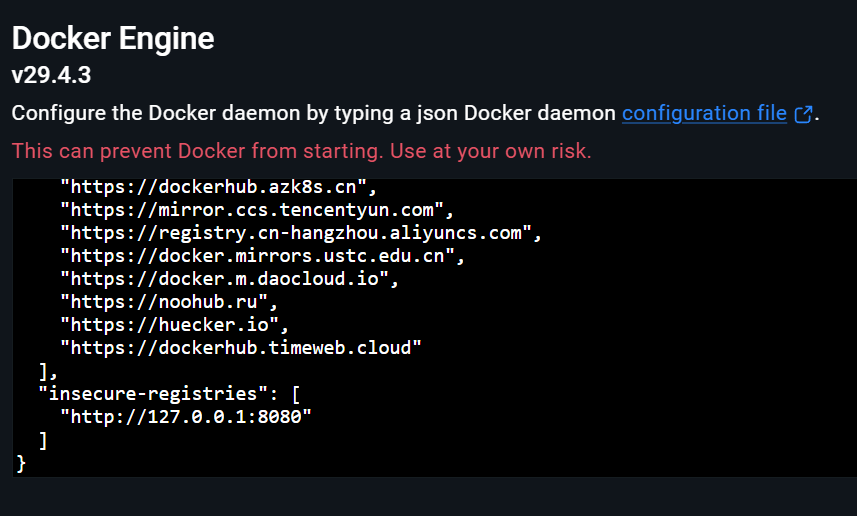
-
运行Compose文件
version: '3.0'services:registry:image: registryvolumes:- ./registry-data:/var/lib/registryui:image: joxit/docker-registry-ui:staticports:- 8080:80environment:- REGISTRY_TITLE=仓库名- REGISTRY_URL=http://registry:5000depends_on:- registryTerminal window docker-compose up -d #docker-compose是文件名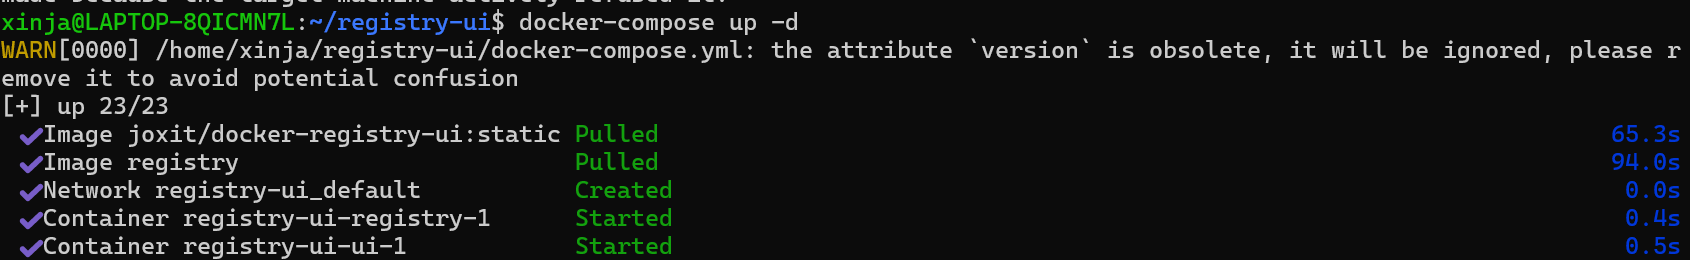
image-20260731143035269 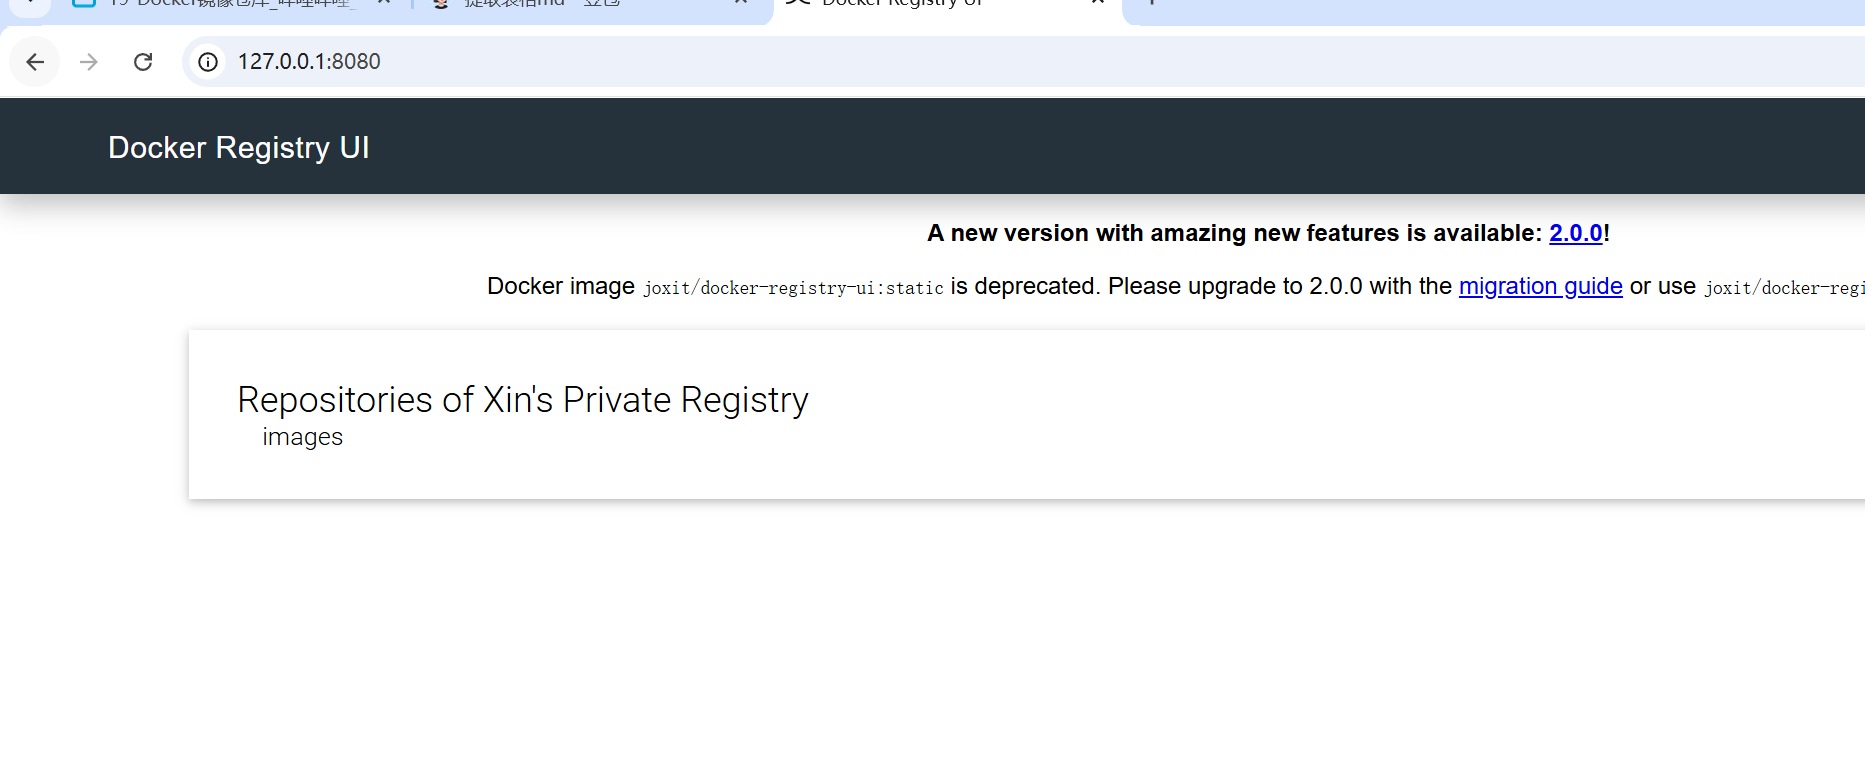
-
-
镜像的推送和拉取
-
重新tag本地镜像,名称前缀为私有仓库地址:127.0.0.1<8080>/
Terminal window docker tag nginx:latest 127.0.0.1:8080/nginx:1.0 -
推送镜像
Terminal window docker push 127.0.0.1:8080/nginx:1.0 -
拉取镜像
Terminal window docker pull 127.0.0.1:8080/nginx1.0
-
ES
ElasticSearch
初识ES
-
强大的开源搜索引擎,可以从海量数据中搜索出需要的内容
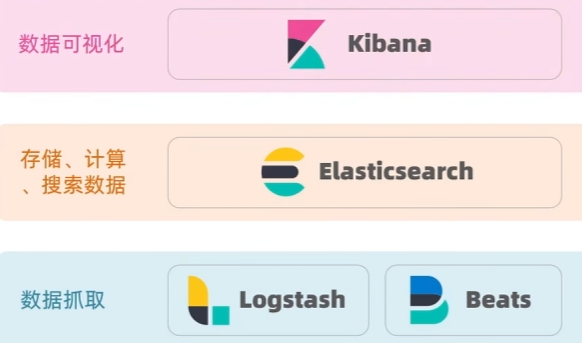
elasticsearch结合kibana、Logstash、Beats,也就是elastic stack(ELK)。广泛应用在日志数据分析、实时监控等领域 — ELK可以将运行状况可视化
-
ES底层基于Lucene开发
-
Lucene:Java语言的搜索引擎库,Apache公司的顶级项目
-
优点
易扩展
高性能(基于倒排索引)
-
缺点
只限于Java语言
学习不易
不支持水平扩展
-
-
ES优点
- 支持分布式、可水平扩展
- 提供Restful接口,可被任何语言调用
-
-
正向索引和倒排索引
-
正向索引
传统数据库采用正向索引,在搜索时若采用模糊搜索只能对数据进行逐条扫描
-
倒排索引
- 文档:每条数据就是一个文档
- 词条:文档按照语意分成的词语
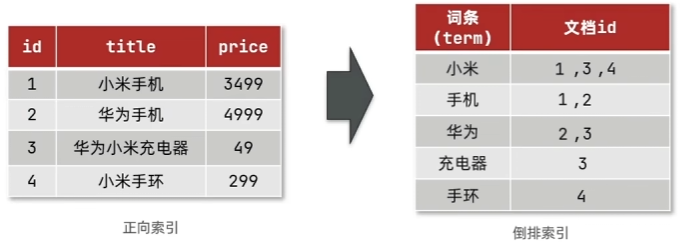
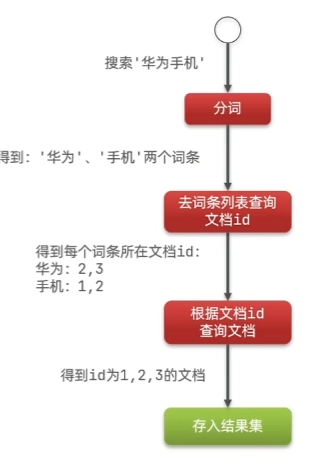
正向索引查找时,先找到数据内容,若数据内容中有匹配的词则将数据加入结果集
倒排索引查找时,先根据词语找对应词条,再将对应所包含的数据加入结果集
-
-
ES中的概念
-
文档
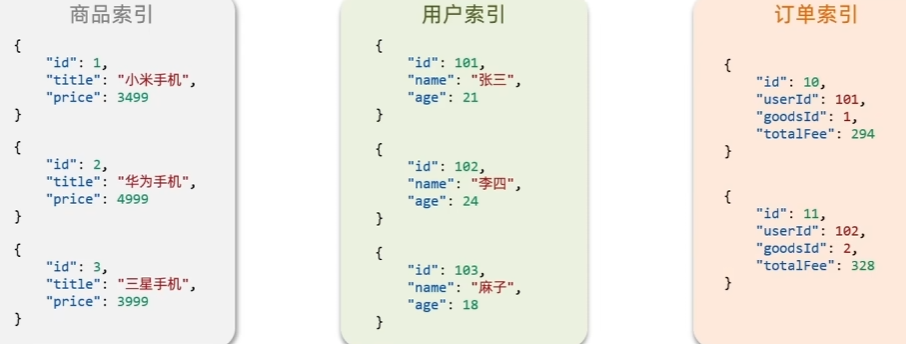
ES是面对文档存储的,文档可以是数据库中的一条商品数据、订单信息等。ES会将数据转为JSON存储
-
索引(index):相同类型的文档的集合
-
映射(mapping)
索引中文档字段约束信息,类似表的结构约束
MySQL Elasticsearch 说明 Table Index 索引 (index),就是文档的集合,类似数据库的表 (table) Row Document 文档(Document),就是一条条的数据,类似数据库中的行(Row),文档都是 JSON 格式 Column Field 字段(Field),就是 JSON 文档中的字段,类似数据库中的列(Column) Schema Mapping Mapping(映射)是索引中文档的约束,例如字段类型约束。类似数据库的表结构(Schema) SQL DSL DSL 是 elasticsearch 提供的 JSON 风格的请求语句,用来操作 elasticsearch,实现 CRUD -
-
架构
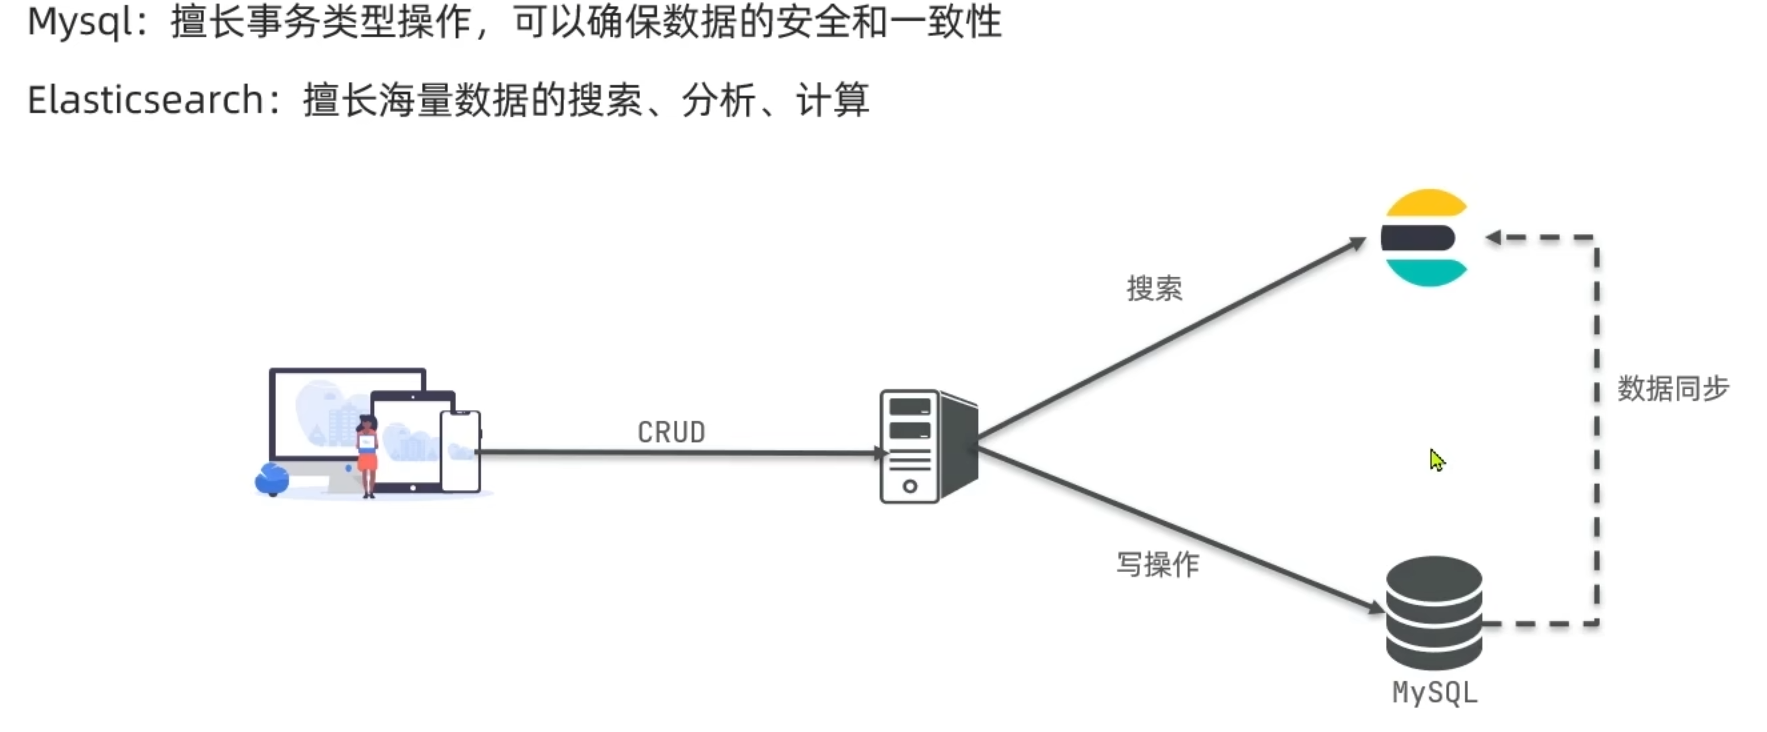
Docker中ES的部署
-
创建网络
因为我们还需要部署kibana容器用于DSL语句的编写,因此需要让ES和kibana容器互联,先创建一个网络
Terminal window docker network create es-net -
拉取ES镜像和kibana镜像
采用7.12.1版本镜像
Terminal window docker pull docker.elastic.co/elasticsearch/elasticsearch:7.12.1Terminal window docker pull docker.elastic.co/kibana/kibana:7.12.1 -
运行docker命令,部署单点es
Terminal window docker run -d \--name es \-e "ES_JAVA_OPTS=-Xms512m -Xmx512m" \-e "discovery.type=single-node" \-v es-data:/usr/share/elasticsearch/data \-v es-plugins:/usr/share/elasticsearch/plugins \--privileged \--network es-net \-p 9200:9200 \-p 9300:9300 \docker.elastic.co/elasticsearch/elasticsearch:7.12.19200为ES的暴露端口
9300为ES 集群节点之间内部通信端口
-
部署kibana并连接上es
Terminal window docker run -d \--name kibana \-e ELASTICSEARCH_HOSTS=http://es:9200 \--network=es-net \-p 5601:5601 \docker.elastic.co/kibana/kibana:7.12.1 -
部署好后
ES端口:9200
kibana端口:5601
IK分词器
-
es创建倒排索引需要进行分词。但默认的分词规则对中文处理不太友好
-
docker中安装IK分词器
-
下载IK
https://release.infinilabs.com/analysis-ik/stable/ #去这个网址下载IK7.12.1版本 -
查询插件安装位置
Terminal window docker volume inspect es-plugins -
将IK插件解压并放入得到的插件安装位置
-
重启ES容器
-
测试
回到kibana的devtool界面,选择分词器是选择以下两种中的一种
ik_smart:最少切分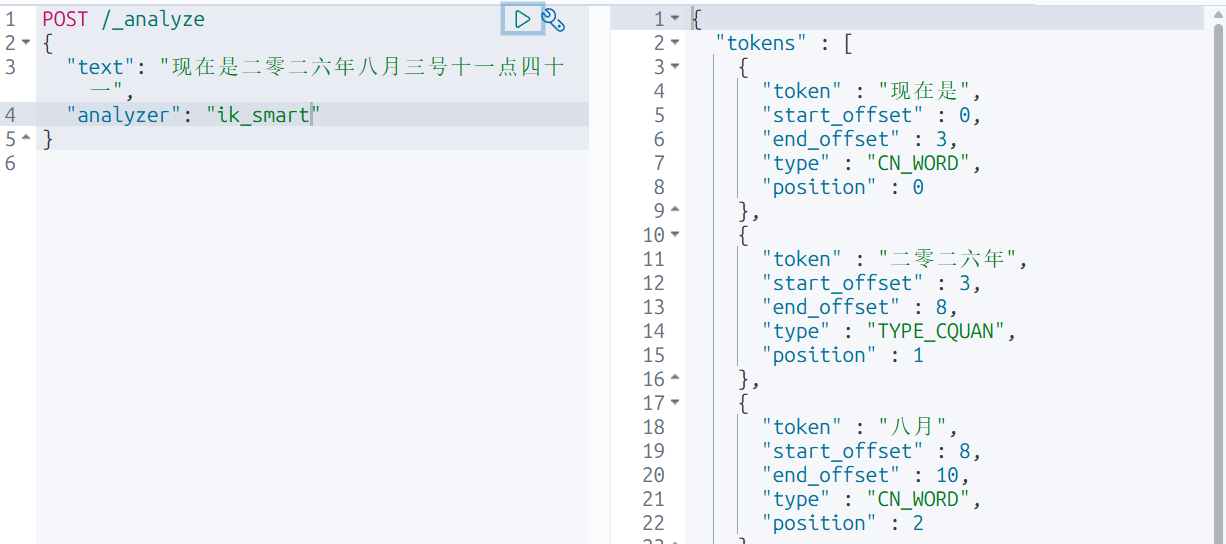
ik_max_word:最细切分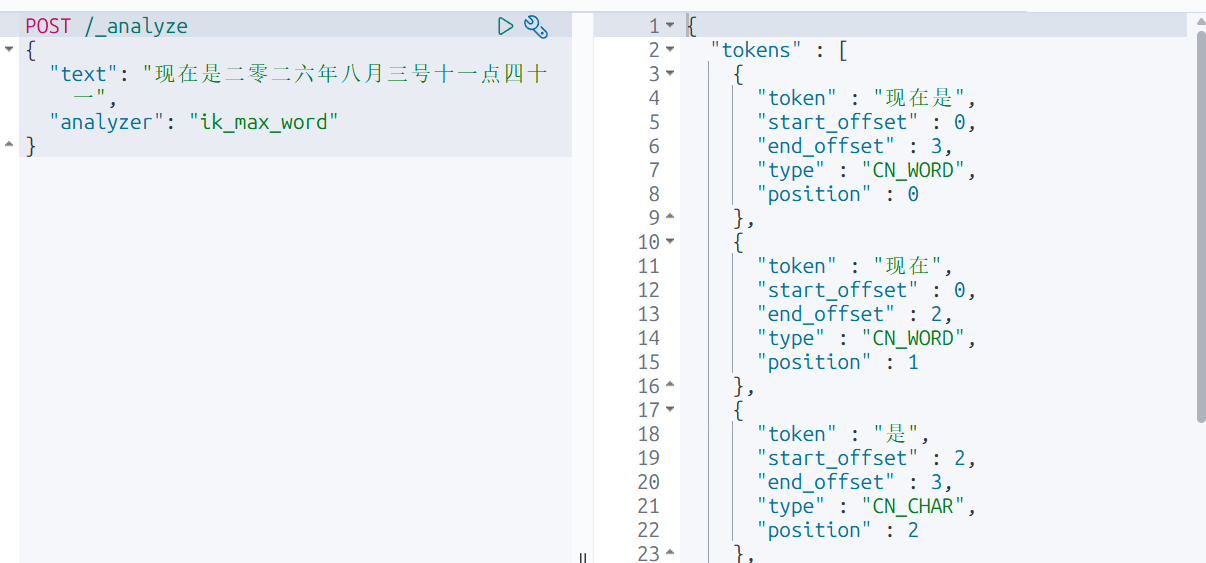
-
-
IK分词器的拓展和停用
IK分词器支持词库的拓展和某些词的停用,只需修改IK分词器目录中config目录下的IkAnalyzer.cfg.xml文件
-
拓展
<?xml version="1.0" encoding="UTF-8"?><!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd"><properties><comment>IK Analyzer 扩展配置</comment><!--用户可以在这里配置自己的扩展字典 *** 添加扩展字典--><entry key="ext_dict">ext.dic</entry></properties> -
停用某些词
<entry key="ext_stopwords">stopword.dic</entry>
加入上述两个配置后,在同目录下创建ext_dic文件和stopword.dic两个对应文件即可进行拓展和停用
配置完后需重启ES
-
索引库操作
ES中的索引类似数据库中的表,mapping映射类似于数据库中的建表语句
-
mapping属性
对索引库中文档的约束,常见的mapping属性包括
- type:字段数据类型,常见的简单类型有
- 字符串:text(可分词文本)、keyword(精确值,例如:品牌、国家、ip地址)
- 数值:long、integer、short、byte、double、float
- 布尔:boolean
- 日期:date
- 对象:object
- index:是否创建倒排索引,默认为true
- analyzer:使用哪种分词器
- properties:该字段的子字段
- type:字段数据类型,常见的简单类型有
-
创建索引库
ES中通过Restful请求操作索引库、文档。请求内容用DSL语句表示。创建索引库和mapping的DSL如下
PUT /索引库名称{"mappings": {"properties": {"字段名":{"type": "text","analyzer": "ik_smart"},"字段名2":{"type": "keyword","index": "false"},"字段名3":{"properties": {"子字段": {"type": "keyword"}}}// ...略}}} -
索引库的删改查
-
查看索引库
GET /索引库名 -
删除索引库
DELETE /索引库 -
修改索引库
索引库一经创建,原有字段是无法修改的。但是可以添加新的字段
PUT /索引库名/_mapping{"properties":{"新字段名":{"type": "integer"}}}
-
文档操作
-
增
文档id需要自己添加,类似于主键
POST /索引库名/_doc/文档id{"字段1":"值1","字段2":"值2","字段3":{"子属性1":"值3","子属性2":"值4"}//.....} -
删
DELETE /索引库名/_doc/文档id -
改
-
方式一:全量修改,会删除旧文档,新增新文档
若索引库中没有这个文档,则会新增
PUT /索引库名/_doc/文档id{"字段1":"值1","字段2":"值2","字段3":{"子属性1":"值3","子属性2":"值4"}//.....} -
方式二:增量修改,修改指定字段值
POST /索引库名/_doc/文档id{"doc":{"字段名":"新值",}}
-
-
查
GET /索引库名/_doc/文档id
Java中的集成 — RestClient
-
初始化JavaRestClient
-
引入es的RestHighLevelClient依赖
<dependency><groupId>org.elasticsearch.client</groupId><artifactId>elasticsearch-rest-high-level-client</artifactId><version>7.12.1</version></dependency> -
因为SpringBoot默认的ES不是7.12.1,所以我们需要去SpringBoot的父工程中手动修改
-
初始化RestHighLevelClient
private RestHighLevelClient restHighLevelClient;@BeforeEachpublic void init(){restHighLevelClient = new RestHighLevelClient(RestClient.builder(HttpHost.create("http://localhost:9200")));}@AfterEachpublic void close() throws IOException {restHighLevelClient.close();}
-
-
操作索引库
-
创建索引库
@Testvoid createIndex() throws IOException {//创建Request对象CreateIndexRequest createIndexRequest = new CreateIndexRequest("hotel");//准备请求参数,DSL语句createIndexRequest.source("DSL语句", XContentType.JSON);//发送请求restHighLevelClient.indices().create(createIndexRequest, RequestOptions.DEFAULT);}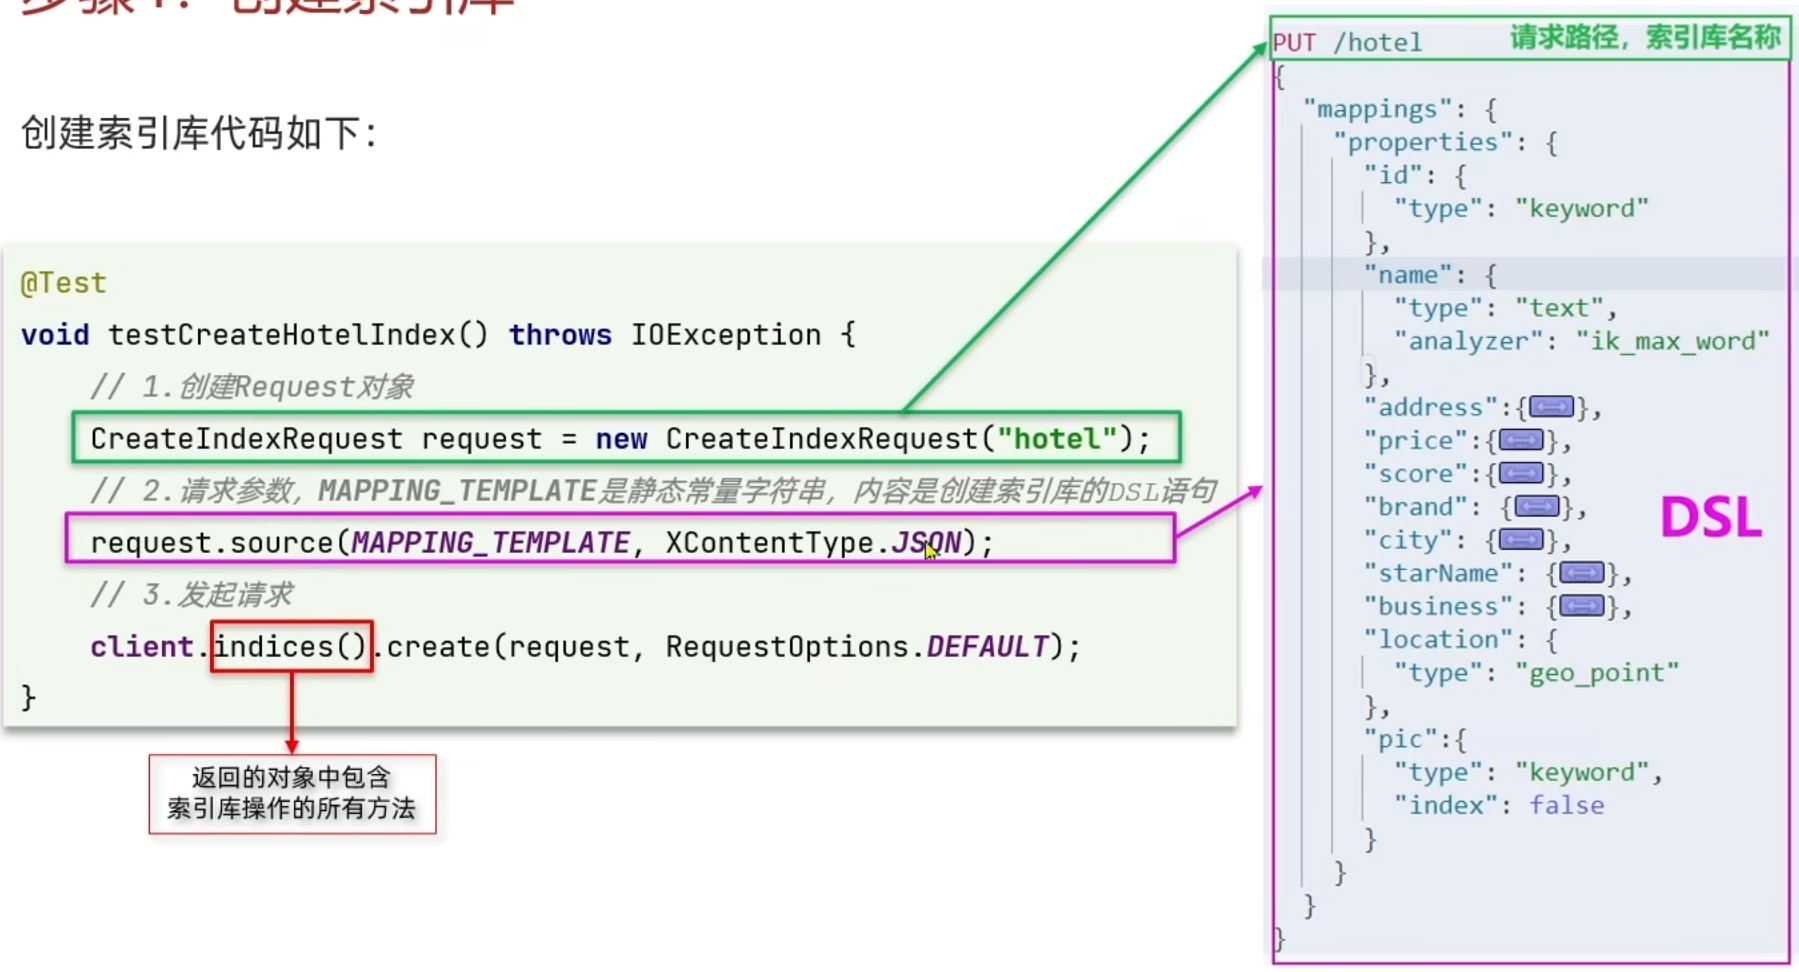
-
删索引库
@Testvoid deleteIndex() throws IOException {//创建Request对象DeleteIndexRequest deleteIndexRequest = new DeleteIndexRequest("hotel");//发起请求restHighLevelClient.indices().delete(deleteIndexRequest, RequestOptions.DEFAULT);} -
判断索引库是否存在
@Testvoid Indexexists() throws IOException {//创建Request对象GetIndexRequest getIndexRequest = new GetIndexRequest("hotel");//发起请求restHighLevelClient.indices().exists(getIndexRequest, RequestOptions.DEFAULT);}
-
-
RestClient操作文档
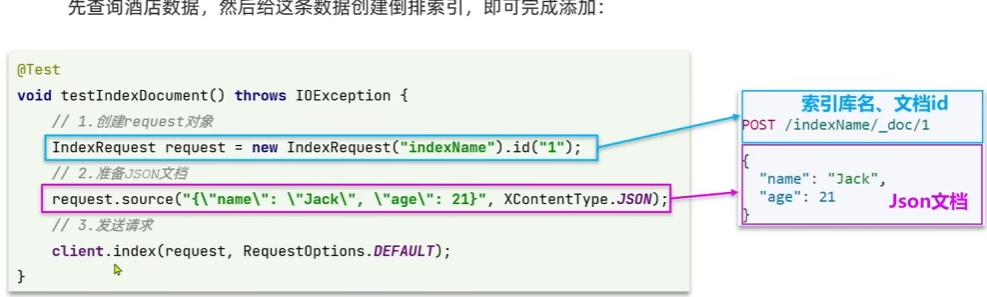
image-20260804112116405 -
新增文档
@Testvoid addDoc() throws IOException {//根据id查询酒店数据Hotel hotel = hotelService.getById(61083L);//转换为文档类型HotelDoc hotelDoc = new HotelDoc(hotel);//准备Request对象IndexRequest indexRequest = new IndexRequest("hotel").id(hotelDoc.getId().toString());//将hotelDoc转为JSON并放入Request中indexRequest.source(JSONUtil.toJsonStr(hotelDoc), XContentType.JSON);//发送请求restHighLevelClient.index(indexRequest,RequestOptions.DEFAULT);} -
查询文档
@Testvoid getDoc() throws IOException {//创建Request对象GetRequest getRequest = new GetRequest("hotel","61083");//发送请求,得到结果GetResponse res = restHighLevelClient.get(getRequest, RequestOptions.DEFAULT);//解析结果String json = res.getSourceAsString();System.out.println(json);} -
修改文档
-
全量更新:与新增一致
-
局部更新
@Testvoid updateDoc() throws IOException {//创建Request对象UpdateRequest updateRequest = new UpdateRequest("hotel","61083");//准备参数,每两个参数为一对key valueupdateRequest.doc("price" ,"970","starName" ,"四钻");restHighLevelClient.update(updateRequest,RequestOptions.DEFAULT);}
-
-
删除文档
@Testvoid deleteDoc() throws IOException {//创建Request对象DeleteRequest deleteRequest = new DeleteRequest("hotel","61083");//发送请求restHighLevelClient.delete(deleteRequest,RequestOptions.DEFAULT);}
-
-
批量导入数据
- 用MP查询酒店数据
- 将查询到的酒店数据(Hotel)转换为HotelDoc
- 利用JavaRestClient中的Bulk批处理,实现新增文档
DSL查询语法
-
常见查询分类
- 查询所有:查询出所有数据,一般测试用
- 全文检索(full text)查询:利用分词器对用户输入内容分词,然后去倒排索引中匹配
- 精确查询:根据精确词条值查询,一般查找keyword、数值、日期、boolean等类型字段
- 地理(geo)查询:根据经纬度查询
- 复合(compound)查询:可以将上述各种查询条件合并起来
-
DSL Query基本语法
GET /索引库名/_search{"query":{"查询类型":{"查询条件":"条件值"}}}-
查询所有
GET /索引库名/_search{"query":{"match_all":{}}} -
全文检索搜索:进行分词,再去倒排索引库检索,常用于网页搜索栏
GET /索引库名/_search{"query":{"match":{"字段名":"字段值"}}}GET /索引库名/_search{"query":{"multi_match":{ //与match相似,只不过允许同时查询多个字段"query":"字段值","fields":["FIELD1","FIELD2"]}}} -
精确查询
-
term:根据词条精确查询
GET /索引库名/_search{"query":{"term":{"字段名":{"value":"字段值"}}}} -
range:根据值的范围查询
GET /索引库名/_search{"query":{"range":{"字段名":{"gte":最小值,"lte":最大值}}}}
-
-
地理查询
-
geo_bounding_box <查询geo_point值落在某个矩形范围内的数据>
GET /索引库名/_search{"query":{"geo_bounding_box":{"字段名":{"top_left":{"lat":"lon":}"bottom_right":{"lat":"lon":}}}}} -
geo_distance:查询到指定中心点小于某个距离值的所有数据
GET /索引库名/_search{"query":{"geo_distance":{"distance":半径大小如:"15km","字段名": 中心点的坐标如:"31.21,121.5"}}}
-
-
复合查询
-
相关性算分
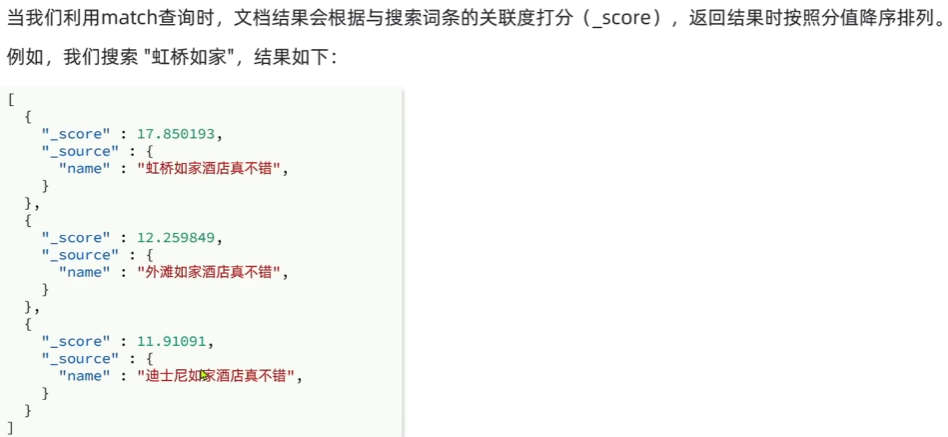
-
function score query:可以修改文档的相关性算分,人工影响排序
GET /索引库名/_search{"query":{"function_score":{"query":{"match":{"字段名":"字段值"}},"functions":["filter":{"term":{"字段名":"字段值"}},"weight":权重值],"boost_mode":"multiply"}}}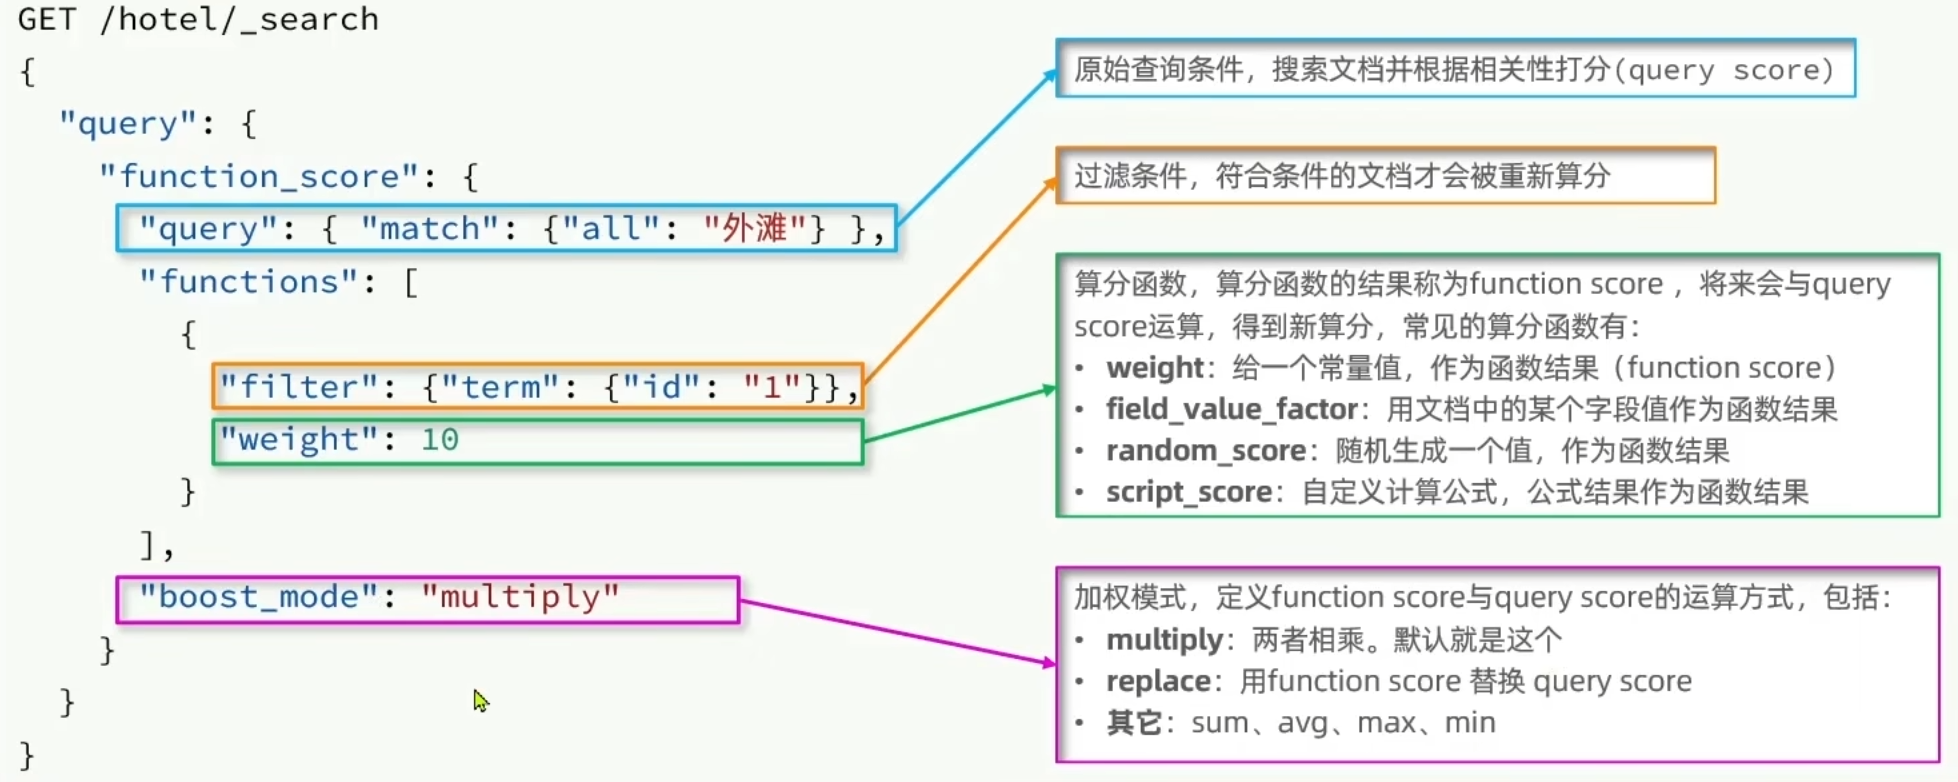
-
boolean query:布尔查询是一个或多个查询子句的组合。子查询组合方式有
- must:与
- should:或
- must_not:非
- filter:与,但是不参与算分
GET /hotel/_search{"query": {"bool": {"must": [{"term": {"city": "上海"}}],"should": [{"term": {"brand": "皇冠假日"}},{"term": {"brand": "华美达"}}],"must_not": [{"range": {"price": {"lte": 500}}}],"filter": [{"range": {"score": {"gte": 45}}}]}}}
-
-
搜索结果处理
-
排序
ES默认根据相关度算法来排序。可排序的字段类型有:keyword、数值、地理坐标、日期类型等
-
示例
GET /索引库名/_search{"query":{"match_all":{}},"sort":[{"字段名":"asc/desc"}]}GET /索引库名/_search{"query":{"match_all":{}},"sort":[{"_geo_distance":{"字段名":"纬度,经度","order":"asc/desc","unit":"m/km"}}]}
-
-
分页
ES默认分页只返回10条,可以通过from、size指定分页参数
-
示例
GET /hotel/_search{"query": {"match_all": {}},"from": 990,//分页开始的位置"size": 10,//单页数据数量"sort": [{"price": "asc"}]} -
深度分页问题
ES做了集群后数据会分开存储,这样数据就分散了,如:想要进行分页查询1000就需要先从每个分片上查询前1000条数据,再对数据进行汇总排序,最后取出前1000条
若搜索页数过深,或者结果集越大,对内存和CPU的消耗就越高。因此ES限定结果集查询上限是10000
-
深度分页解决方案
-
search after
分页时需要排序,原理是从上一次的排序值开始,查询下一页数据
-
scroll:将排序数据形参快照保存在内存
-
-
-
高亮
将搜索关键词突出显示
-
原理
将搜索结果中的关键词用标签标记出来
在页面中给标签添加CSS样式
-
示例
GET /hotel/_search{"query": {"match": {"字段名": "TEXT"}},"highlight": {"fields": { // 指定要高亮的字段"字段名": {"pre_tags": "<em>", // 用来标记高亮字段的前置标签"post_tags": "</em>" // 用来标记高亮字段的后置标签"require_field_match":"false" //开启后搜索字段和高亮字段不一致也会高亮}}}}
-
Java中集成查询语句
-
快速入门
@Testvoid MatchAll() throws IOException {//1.准备查询Request对象SearchRequest searchRequest = new SearchRequest("hotel");//2.加入DSLsearchRequest.source().query(QueryBuilders.matchAllQuery());//3.发送请求SearchResponse searchResponse = restHighLevelClient.search(searchRequest,RequestOptions.DEFAULT);//解析响应结果SearchHits searchHits = searchResponse.getHits();System.out.println(searchHits.getTotalHits().value);SearchHit[] hits = searchHits.getHits();for (SearchHit hit : hits) {String json = hit.getSourceAsString();HotelDoc hotelDoc = JSONUtil.toBean(json, HotelDoc.class);System.out.println(hotelDoc);}}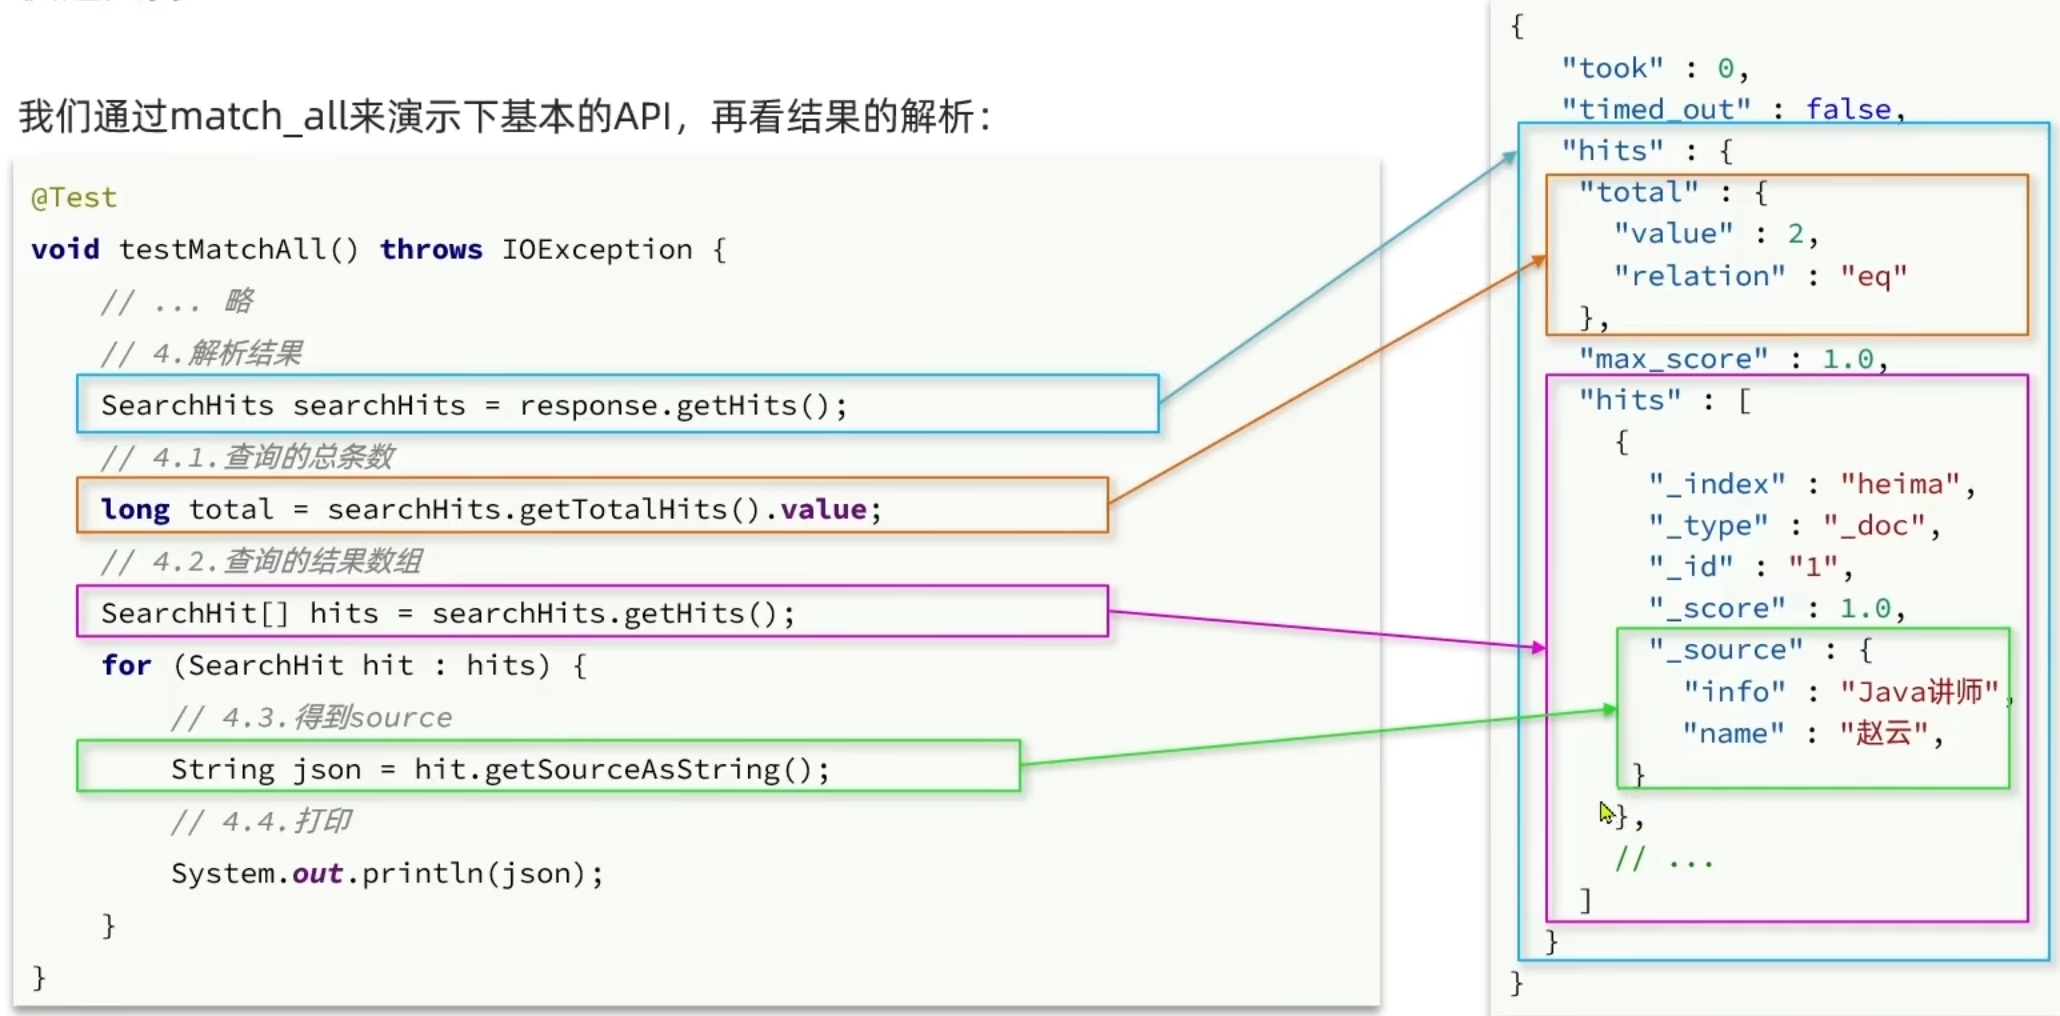
-
全文检索查询
match与multi_match的API基本一致。差别就是查询条件,也就是query部分
@Testvoid Match() throws IOException {//创建Request对象SearchRequest searchRequest = new SearchRequest("hotel");//单字段查询searchRequest.source().query(QueryBuilders.matchQuery("all","如家"));//多字段查询searchRequest.source().query(QueryBuilders.multiMatchQuery("name","如家","address","上海"));//发送请求 + 解析结果略} -
精确查询
@Testvoid termAndrange() throws IOException {//创建Request对象SearchRequest searchRequest = new SearchRequest("hotel");//term精确查询searchRequest.source().query(QueryBuilders.termQuery("city","上海"));//range范围查询searchRequest.source().query(QueryBuilders.rangeQuery("price").gte(1000).lte(3000));//发送请求 + 解析结果略} -
布尔查询
由于布尔查询在此处本质就是复合查询,也就是一个布尔查询里面可以放好几个基本查询条件,所以先创建布尔对象再向里面放查询条件,代码更清晰
@Testvoid booleanSearch() throws IOException {//创建Request对象SearchRequest searchRequest = new SearchRequest("hotel");//创建布尔查询对象BoolQueryBuilder boolQueryBuilder = QueryBuilders.boolQuery();//添加查询条件boolQueryBuilder.must(QueryBuilders.termQuery("city","杭州"));//....//布尔查询searchRequest.source().query(boolQueryBuilder);//发送请求 + 解析结果略} -
排序和分页
@Testvoid testSortAndPage() throws IOException {//1.准备查询Request对象SearchRequest searchRequest = new SearchRequest("hotel");//2.加入DSLsearchRequest.source().query(QueryBuilders.matchAllQuery()).sort("price", SortOrder.DESC) //排序.from(0) //分页.size(20);//3.发送请求SearchResponse searchResponse = restHighLevelClient.search(searchRequest,RequestOptions.DEFAULT);//解析响应结果handleResponse(searchResponse);} -
高亮
@Testvoid highlight() throws IOException {SearchRequest searchRequest = new SearchRequest("hotel");searchRequest.source().query(QueryBuilders.matchQuery("all","如家")).highlighter(new HighlightBuilder().field("name").requireFieldMatch(false));//发送请求SearchResponse searchResponse = restHighLevelClient.search(searchRequest,RequestOptions.DEFAULT);//解析响应结果SearchHit[] hits = searchResponse.getHits().getHits();for (SearchHit hit : hits) {Map<String, HighlightField> highlightFields = hit.getHighlightFields();if(!CollectionUtil.isEmpty(highlightFields)) {//获取高亮字段结果HighlightField highlightField = highlightFields.get("name");if(highlightField != null) {//从高亮字段里面取出名字String name = highlightField.getFragments()[0].string();System.out.println(name);}}}}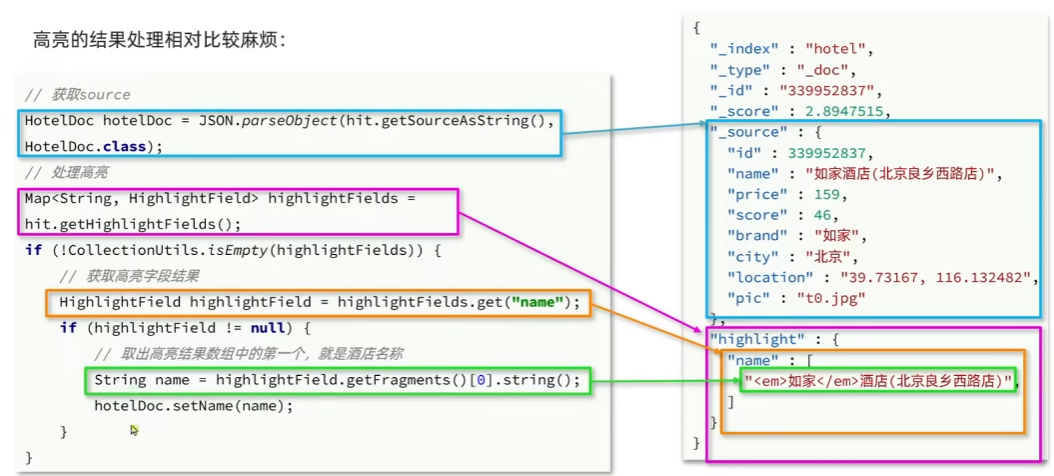
image-20260804164048169
数据聚合
-
聚合:可以实现对文档数据的统计、分析、运算。聚合常见的有三类
- 桶(Bucket)聚合:用于对文档做分组
- TermAggregation:按照文档字段值分组
- Date Histogram:按照日期阶梯分组,如一周一组、一月一组
- 度量(Metric)聚合:用以计算一些值:最小值、最大值、平均值
- Avg:平均值
- Max:最大值
- Min:最小值
- Stats:同时求上述三种值
- 管道(pipeline)聚合:其他聚合的结果为基础做聚合
- 桶(Bucket)聚合:用于对文档做分组
-
Bucket聚合
GET /hotel/_search{"query":{"range":{"price":{"lte":200 // 先查询再聚合,就会对查询结果进行聚合,可以限定聚合范围}}}"size": 0, // 设置size为0,结果中不包含文档,只包含聚合结果"aggs": { // 定义聚合"brandAgg": { //给聚合起个名字"terms": { // 聚合的类型,按照品牌值聚合,所以选择term"field": "brand", // 参与聚合的字段"order":{"_count":"asc" //按照_count升序排列}"size": 20 // 希望获取的聚合结果数量}}}} -
Metric聚合
GET /hotel/_search{"size": 0,"aggs": {"brandAgg": {"terms": {"field": "brand","size": 20},"aggs": { // 是brands聚合的子聚合,也就是分组后对每组分别计算"score_stats": { // 聚合名称"stats": { // 聚合类型,这里stats可以计算min、max、avg等"field": "score" // 聚合字段,这里是score}}}}}} -
Client中的集成
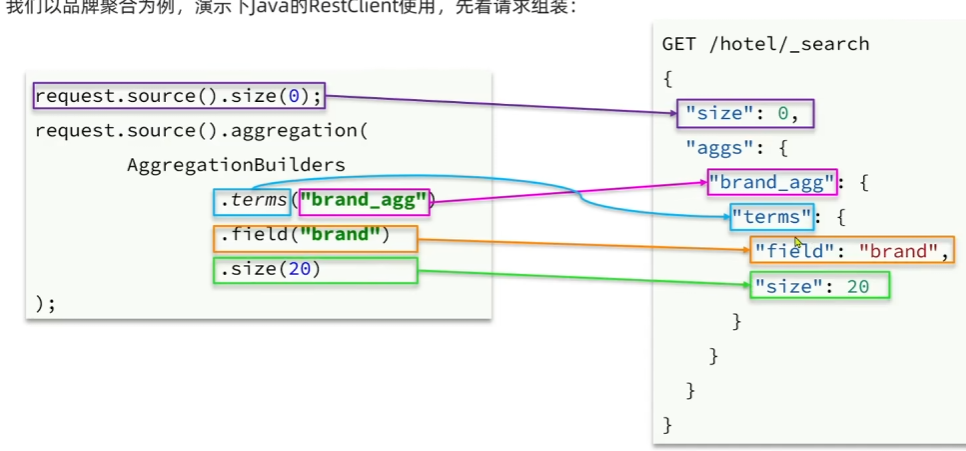
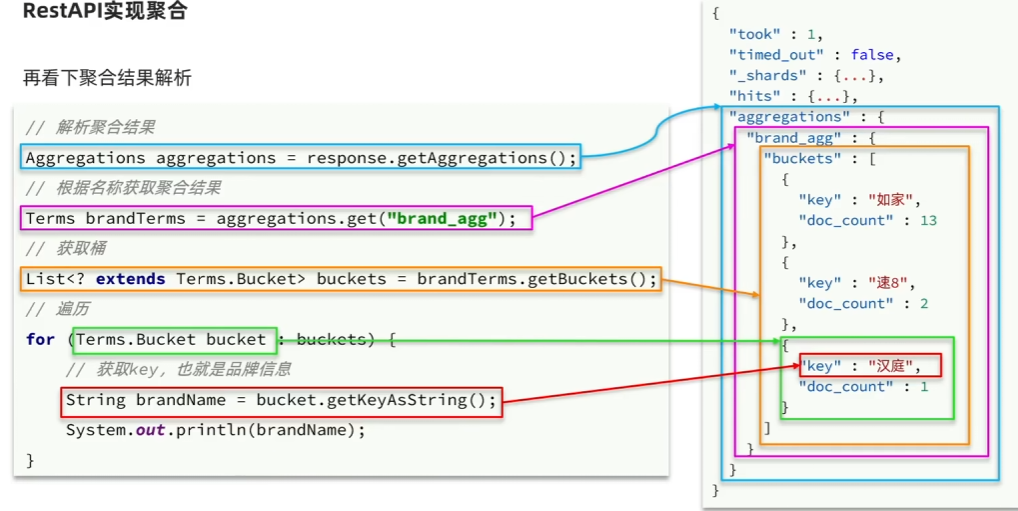
微服务保护
雪崩问题
-
微服务之间互相依赖,假设服务A依赖于服务B、C、D(即:服务A是服务B、C、D的消费者),而服务D宕机了,那么就会导致服务A请求服务D的那一部分Http请求阻塞,当服务D的请求越来越多,到最后会将服务A中的资源全部占用,服务A也会故障。以此类推,由于微服务中各个服务之间依赖错综复杂,会引发连锁反应导致雪崩
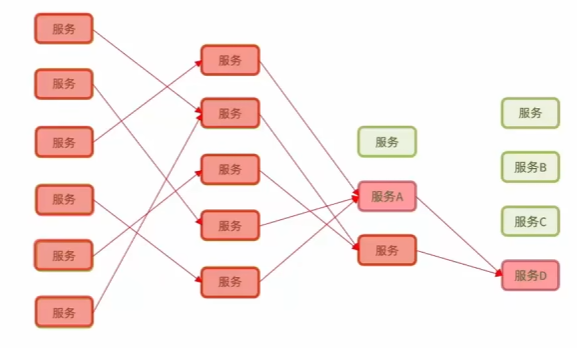
简单而言:微服务链路中的某个服务出现了故障,会导致整个微服务链路瘫痪,这就是雪崩
-
解决方式
-
超时等待
设定超时时间,请求超过一定时间没有响应就返回错误信息,不会无休止等待
-
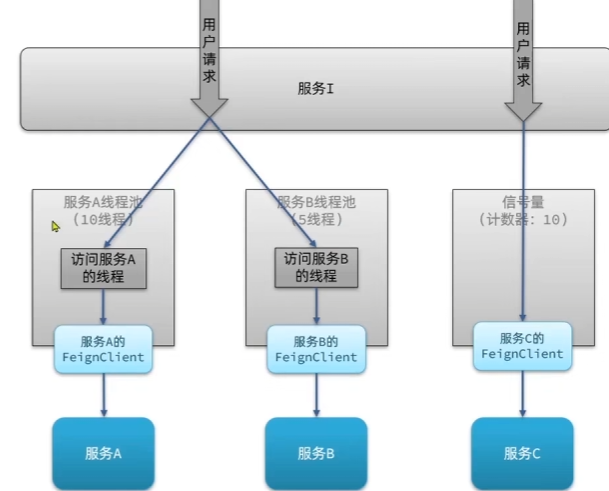
舱壁模式
设定每个业务能使用的线程数,避免耗尽整个tomcat的资源,因此也被称为线程隔离
- 线程池隔离:每个业务创建一个线程池,线程池内线程数量固定。以此达到线程隔离的效果
- 优:隔离效果较好,支持主动超时,支持异步调用
- 缺:每个服务都要创建线程池,CPU负担较高
- 信号量隔离:不创建新的线程池,只使用Tomcat自带的线程池,不过对每个服务可以使用的线程数做了约束
- 优:对CPU友好
- 缺:隔离效果相对没那么好,不支持主动超时和异步调用
- 线程池隔离:每个业务创建一个线程池,线程池内线程数量固定。以此达到线程隔离的效果
-
熔断降级
由断路器统计业务执行的异常比例,如果超出阈值就会熔断该业务,拦截访问该业务的一切请求
-
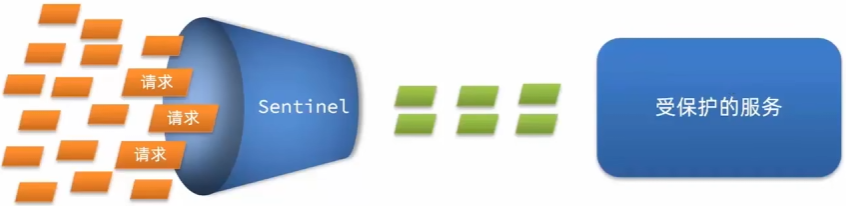
流量控制
限制业务访问的QPS,避免服务因流量突增而出现故障 — 流量控制是预防
-
Sentinel
-
alibaba开源项目,可以用于解决雪崩问题,可以实现舱壁模式、熔断降级、流量控制
-
微服务整合Sentinel
-
安装Sentinel并启动,默认端口8080
-
在项目中引入Sentinel依赖
<!--sentinel--><dependency><groupId>com.alibaba.cloud</groupId><artifactId>spring-cloud-starter-alibaba-sentinel</artifactId></dependency> -
配置控制台地址
spring:cloud:sentinel:transport:dashboard: localhost:8080 -
访问微服务任意端点,触发sentinel监控
-
-
簇点链路
项目内的调用链路(Controller Service Mapper),链路中被监控的每一个接口就是一个资源。默认情况下Sentinel会监控SpringMVC中的每一个端点(如Controller中的每个请求路径),因此SpringMVC中的每个端点就是调用链路中的一个资源
-
各种雪崩解决方法的实现
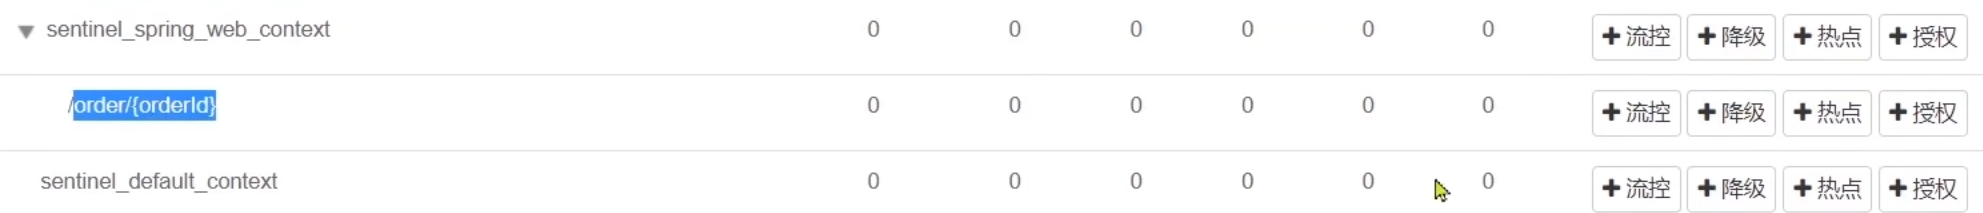
对于每一个被监控的端点,在Sentinel的控制台都提供了雪崩的解决策略
流量控制
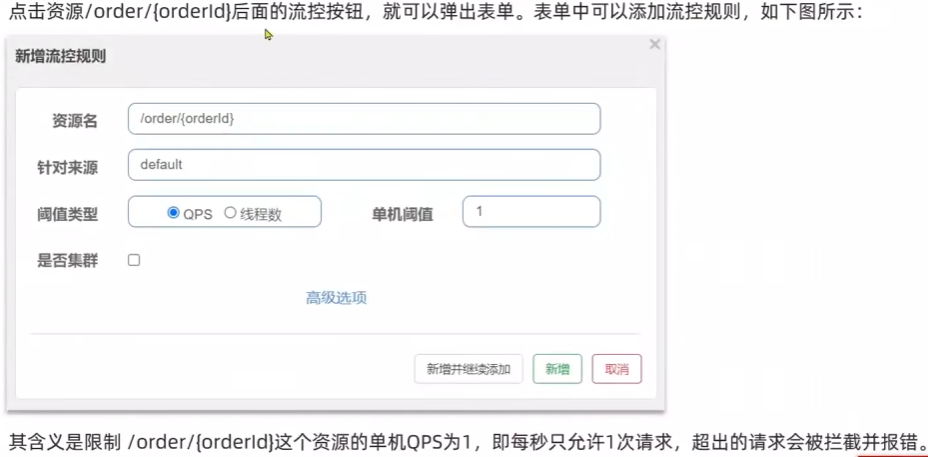
default表示所有的请求来源都会进行流量控制
在添加限流规则时,点击高级选项,可以选择三种流控模式:
-
直接:统计当前资源的请求,触发阈值时对当前资源直接限流,也是默认的模式
-
关联:统计与当前资源相关的另一个资源,触发阈值时,对当前资源限流
如:A要调用B,对B监控,当B触发阈值,对A限流
适用场景:两个有竞争关系的资源,一个优先级高一个优先级低,优先级高的QPS过高时对优先级低的做限流
-
链路:统计从指定链路访问到本资源的请求,触发阈值时,对指定链路限流
如:A、B要调用C,对AC监控而不对BC监控
高级模式中还有三种流控效果
-
快速失败:达到阈值后,新的请求会被立即拒绝并抛出 FlowException 异常。是默认的处理方式。
-
warm up:预热模式,对超出阈值的请求同样是拒绝并抛出异常。但这种模式阈值会动态变化,从一个较小值逐渐增加到最大阈值。
应对服务冷启动的一种方案。请求阈值初始值是 threshold /coldFactor,持续指定时长后,逐渐提高到 threshold 值。而 coldFactor 的默认值是 3。
-
排队等待:让所有的请求按照先后次序排队执行,两个请求的间隔不能小于指定时长
可以用于流量的整流。当突然有很多请求打进来的时候,会将所有请求放入队列中,按照指定的时间间隔执行,如:时间间隔200ms,最大预期等待时间为2000ms,有20个请求打进来。那么前十个请求就会进入队列以200ms/个的速度依次执行;后十个请求直接拒绝抛异常
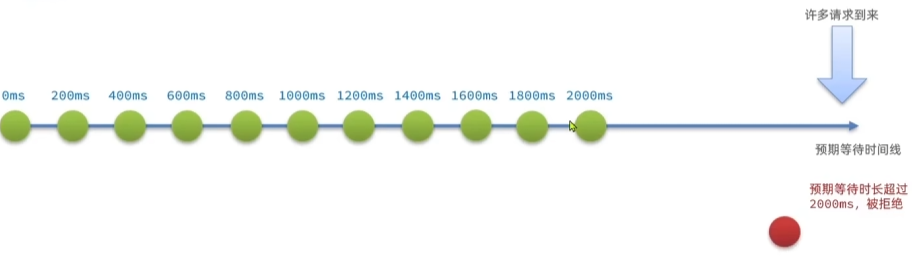
除了上述限流外,还有一种较为特殊的限流 — 热点参数限流,不同于上述限流监控所有的请求,热点参数限流只对参数值相同的请求进行监控
隔离和降级
-
不论是隔离还是熔断,都是在微服务发起远程调用时进行的,所以想要实现隔离和熔断首先要用Feign整合Sentinel
- 修改对应服务中的application.yml文件,开启Feign的Sentinel功能
feign:sentinel:enabled: true # 开启Feign的Sentinel功能-
给FeignClient编写失败后的降级逻辑
-
FallbackClass,无法对远程调用的异常做处理
-
FallbackFactory,可以对远程调用的异常做处理(在此编写对服务降级的逻辑)
@Slf4jpublic class UserClientFallbackFactory implements FallbackFactory<UserClient> {@Overridepublic UserClient create(Throwable throwable) {// 创建UserClient接口实现类,实现其中的方法,编写失败降级的处理逻辑return new UserClient() {@Overridepublic User findById(Long id) {// 记录异常信息log.error("查询用户失败", throwable);// 根据业务需求返回默认的数据,这里是空用户return new User();}};}}
-
-
编写完成后@Configuration+@Bean将FallBackFactory注册到IOC容器中
-
在@FeignClient中指定参数
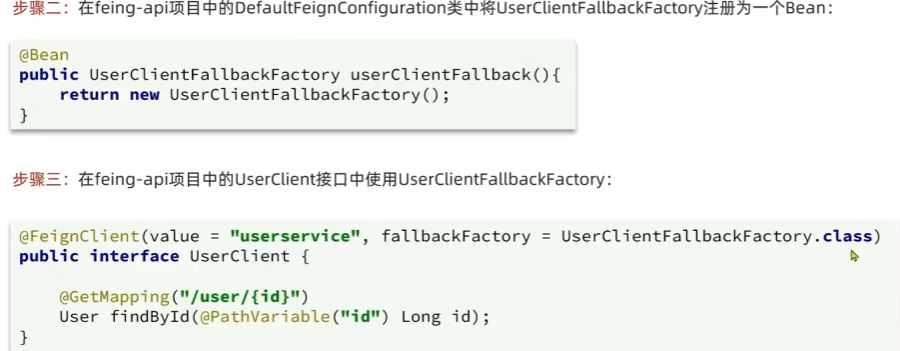
-
线程隔离
Sentinel使用的是信号量隔离
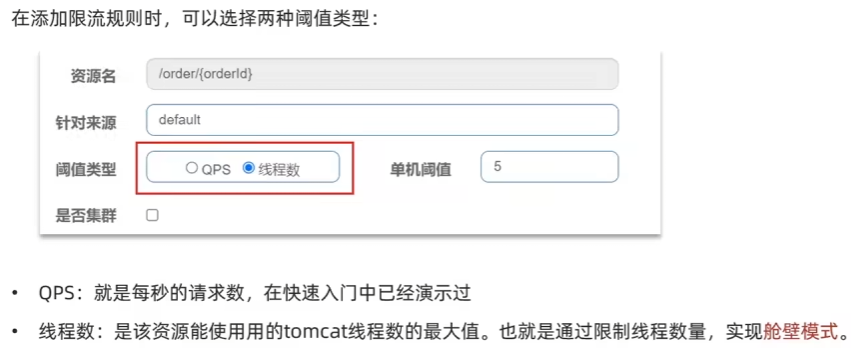
-
熔断降级
-
断路器工作的三个状态
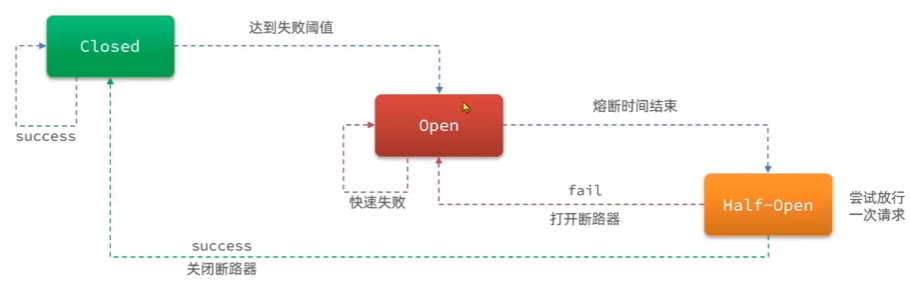
-
断路器熔断策略:慢调用、异常比例、异常数
-
慢调用:业务响应时间(RT)大于指定时长的请求认定为慢调用。指定时间内,如果请求数量超过设定的最小数量且慢调用比例大于设定阈值,则触发熔断
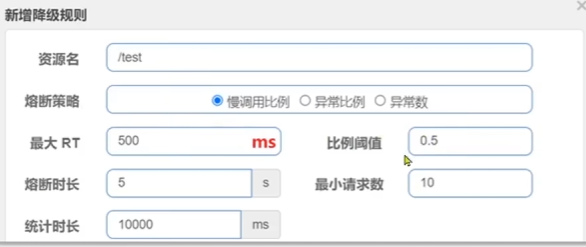
-
异常比例或异常数:统计指定时间内的调用,若调用次数超过指定请求数且出现异常的比例达到设定的比例阈值(或超过指定异常数),则触发熔断
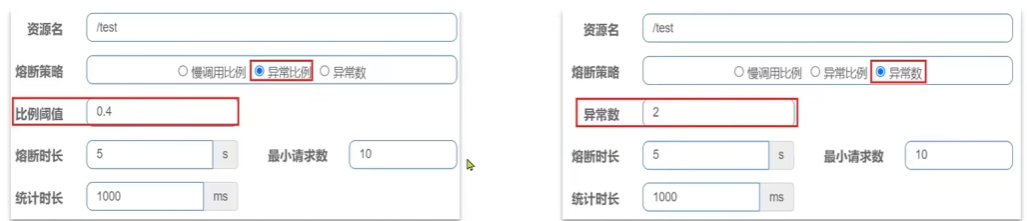
-
-
授权规则及持久化
-
授权规则
可以对调用方的来源来做控制,有白名单、黑名单两种方式
-
适用场景
网关也可以对请求进行拦截和放行,但若是直到微服务的服务器地址就可以绕过网关直接攻击微服务的服务器,对此可以使用Sentinel的授权规则对来源做控制 — 看看请求有没有通过网关,若没有则不放行
-
实现
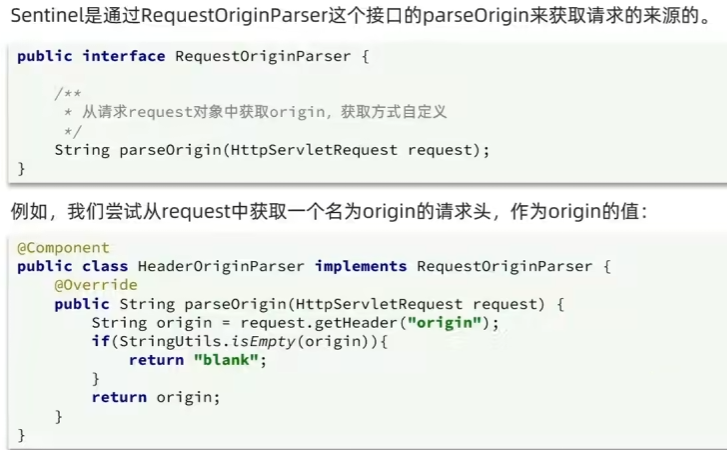
如上图,oringin请求头是不存在的,但是我们可以将经过网关的所有请求都拦截并带上oringin头,如此一来就可以对来源进行过滤
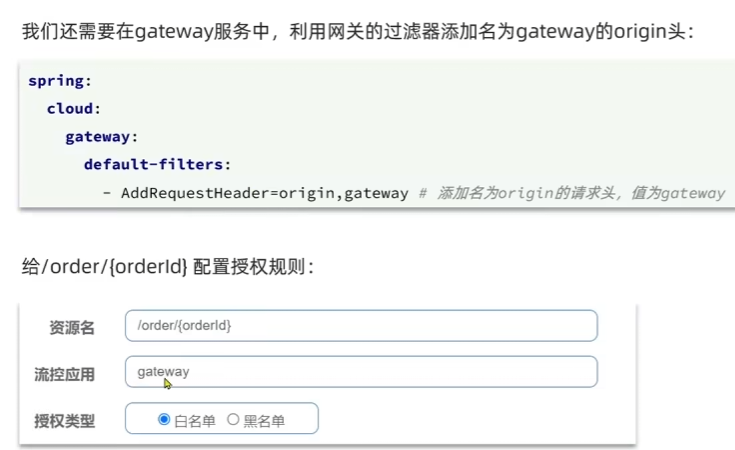
-
-
规则持久化
Sentinel默认将授权规则保存在内存里。
-
规则管理模式
-
原始模式:默认模式,规则保存在内存里
-
pull模式:控制台将规则推送到Sentinel客户端,客户端会将配置规则保存在本地文件或数据库中,以后定时读取,更新本地规则
-
push模式
控制台将规则推送到远程配置中心,例如Nacos。Sentinel客户端监听Nacos,一旦发现有更新,立即获取变更的规则进行更新
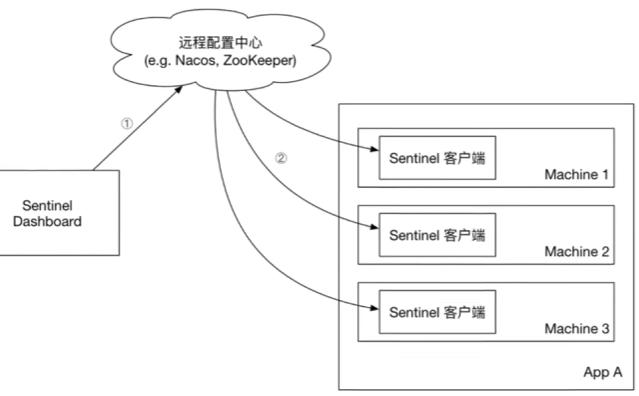
- push模式的实现:视频
-
-
分布式事务
在单体项目中只有一个数据库,可以直接保证事务的ACID。但在微服务中,每个服务对应着一个数据库,一套流程需要调用多个数据库,此时还想保证ACID就要使用分布式事务
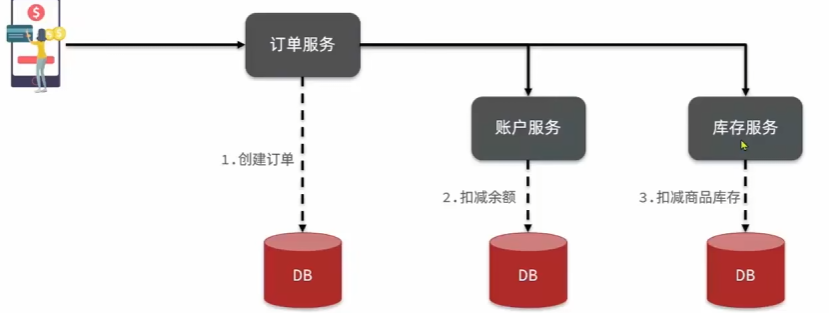
理论基础
-
CAP定理
分布式系统的三个指标
-
Consistency(一致性)
用户访问分布式系统中的任意节点,得到的数据必须一致
-
Availability(可用性)
用户访问集群中的任意健康节点,必须能得到响应。
-
Partition tolerance(分区容错性)
Partition(分区):因为网络故障或其它原因导致分布式系统中的部分节点和其他节点失去连接,形成独立分区
Tolerance(容错):在集群中出现分区时,整个系统也要持续对外提供服务
分布式系统无法同时满足这三个指标
-
在分布式系统中,分区是一定会出现的,因为我们无法保证网络永远良好。所以我们一定要保证分区容错性(P)。那么剩下的就是一致性(C)和可用性(A)了
- 若要保证一致性(C),即出现分区后,保证用户拿到的数据是一致的。那么我们就要将发送到独立分区的请求阻塞,在该节点重新与其他节点连接并同步数据后再提供服务。如此一来就牺牲了可用性(A)
- 若要保证可用性(A),即出现分区后,保证用户仍可以正常访问该节点。但是这样一来用户拿到的数据与其他数据库中就不同步了,牺牲了一致性(C)
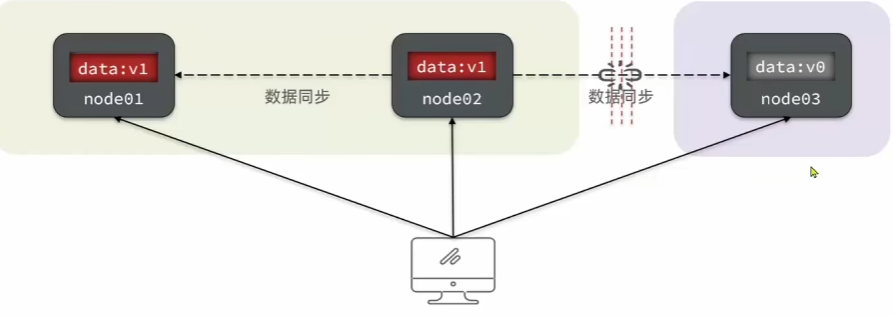
由上述分析可知,在分布式系统中,CP和AP只能选择一个
-
-
BASE理论
对CAP的一种解决思路,包含三个思想
- Basically Available (基本可用):分布式系统出现故障时,允许损失部分可用性,保证核心可用
- Soft State(软状态):在一定时间内,允许出现中间状态,比如临时的不一致状态
- Eventually Consistent(最终一致性):虽然无法保证强一致性,但在软状态结束后,最终达到数据一致
-
分布式事务当中最大的问题就是各个子事务的一致性问题,结合上面两个理论,可以有以下两种模式
- AP模式:各子事务分别执行和提交,允许出现结果不一致**(软状态)**,然后采用弥补措施恢复数据,实现最终一致
- CP模式:各个子事务执行后互相等待,同时提交、同时回滚,达成强一致。但在事务等待过程中,处于弱可用状态
Seata
-
Seata框架
框架中有三个重要的角色
-
TC(Transaction Coordinator)- 事务协调者
维护全局和分支事务的状态,协调全局事务提交或回滚。
-
TM(Transaction Manager) - 事务管理器
定义全局事务的范围、开始全局事务、提交或回滚全局事务。
-
RM(Resource Manager) - 资源管理器
管理分支事务处理的资源,与 TC 交谈以注册分支事务和报告分支事务的状态,并驱动分支事务提交或回滚。
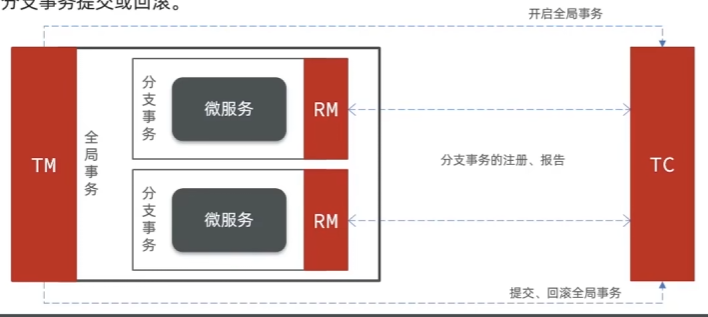
TM框定了全局事务范围(当前业务流程需要操作的各个服务被框定在内),当有请求进来后会向TC发送开启全局事务的消息,在处理完成后向TC发送提交还是回滚全局事务的请求
RM负责管理各个分支事务,并与TC交流,在TC那注册分支事务,并且在全部事务都完成后报告TC自身事务的完成情况
TC负责维护全局事务和分支事务的状态。RM在TC这注册分支事务便于TC管理,在全局事务完成后,TM向TC询问,TC查询RM得知各分支事务的完成情况再决定是提交还是回滚
-
-
Seata提供了四种不同的分布式事务解决方案
-
XA模式:强一致性分阶事务模式,牺牲了一定可用性,无业务侵入
XA规范描述了全局的TM和局部的RM之间的接口,几乎所有的主流数据库都对XA规范提供了支持
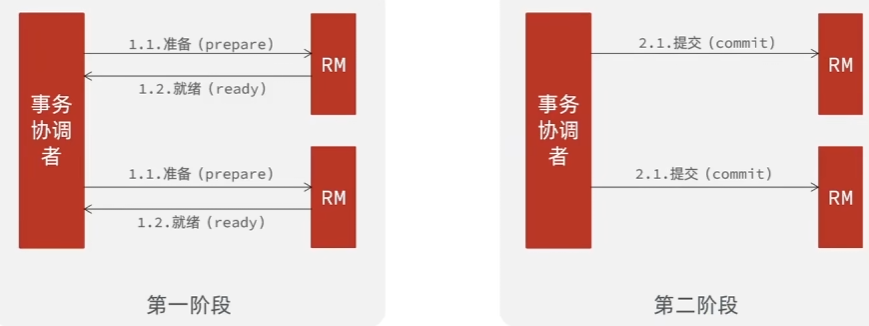
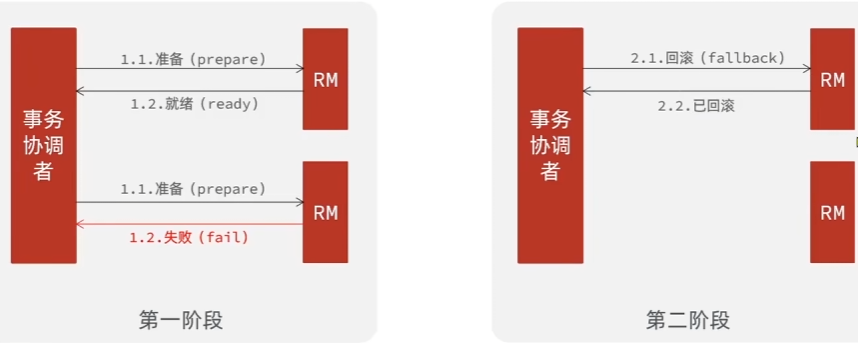
在Seata中做了一些调整,但大体类似
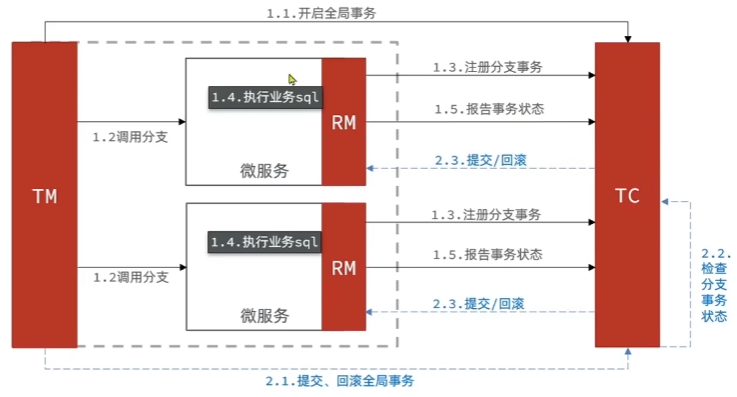
XA模式虽然实现了强一致性,但是资源锁定时间过长
-
TCC模式:最终一致的分阶段事务模式,有业务侵入
TCC与AT模式非常相似,每阶段都是独立事务,不同的是TCC通过人工编码实现数据恢复。需要实现三个方法
-
Try:资源的检测和预留;
-
Confirm:完成资源操作业务;要求 Try 成功 Confirm 一定要能成功。
-
Cancel:预留资源释放,可以理解为 try 的反向操作。
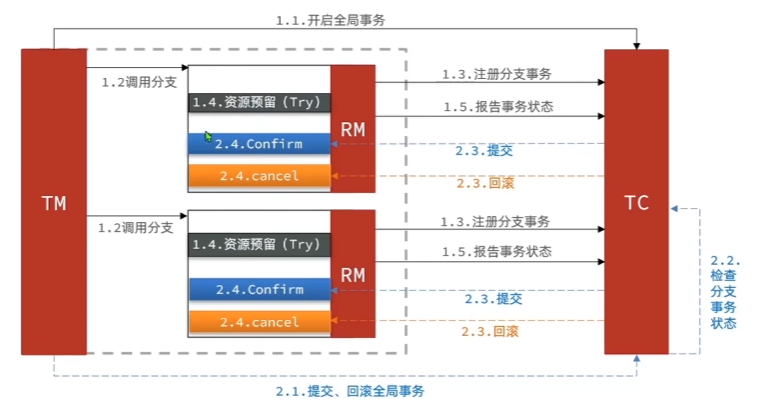
-
示例
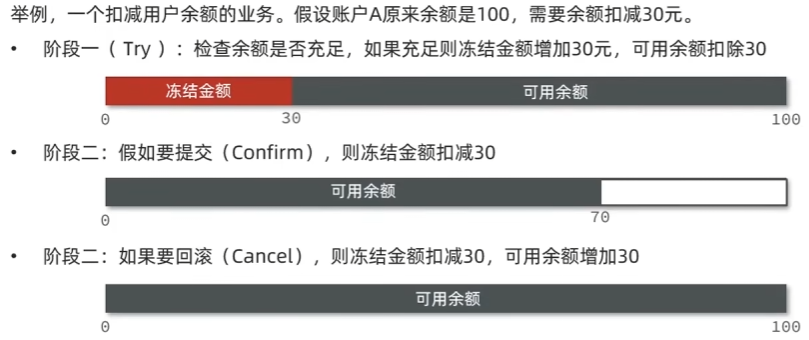
TCC通过代码对数据资源进行逻辑上的操作,不用使用锁,效率高
但是TCC模式并不适用于所有业务,如:新增业务(没有资源可以预留)
除此之外TCC还有空回滚和业务悬挂问题,详见:视频
-
具体实现
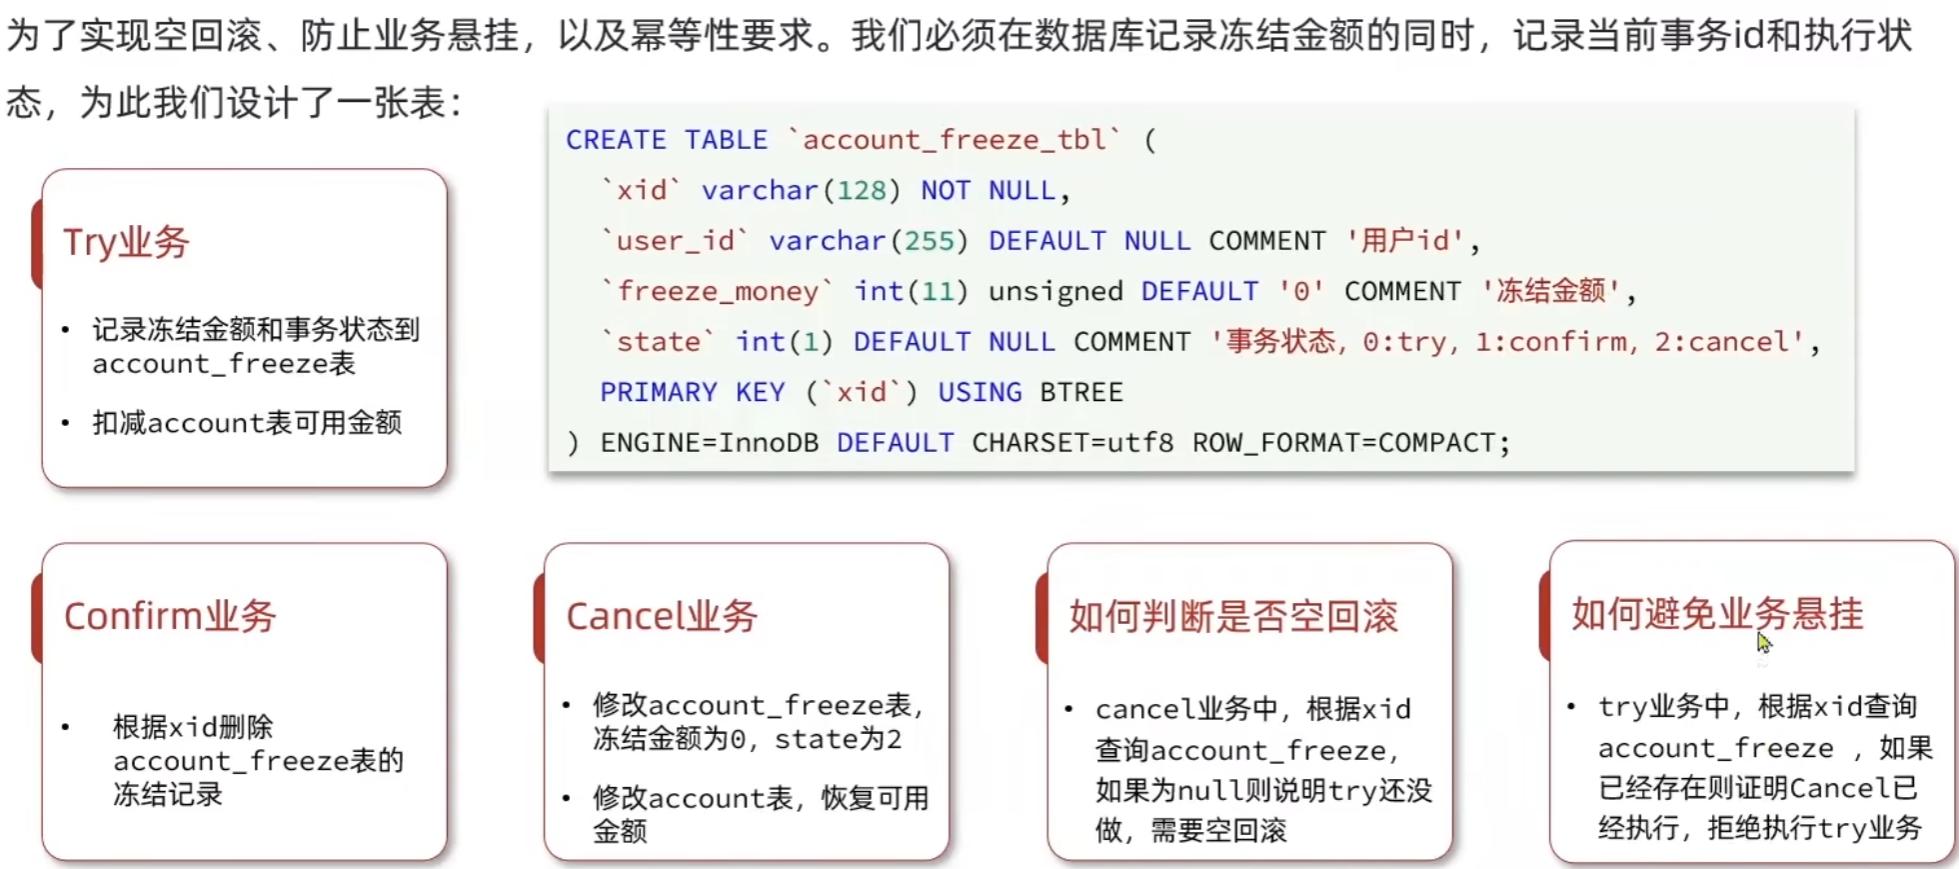
在数据库中设计一张freeze表,用于存储冻结的资源,这样子各个事务之间所冻结的资源相互隔离,就不用锁去保证隔离性了。此外,还需要通过一些逻辑判断去避免空回滚和业务悬挂
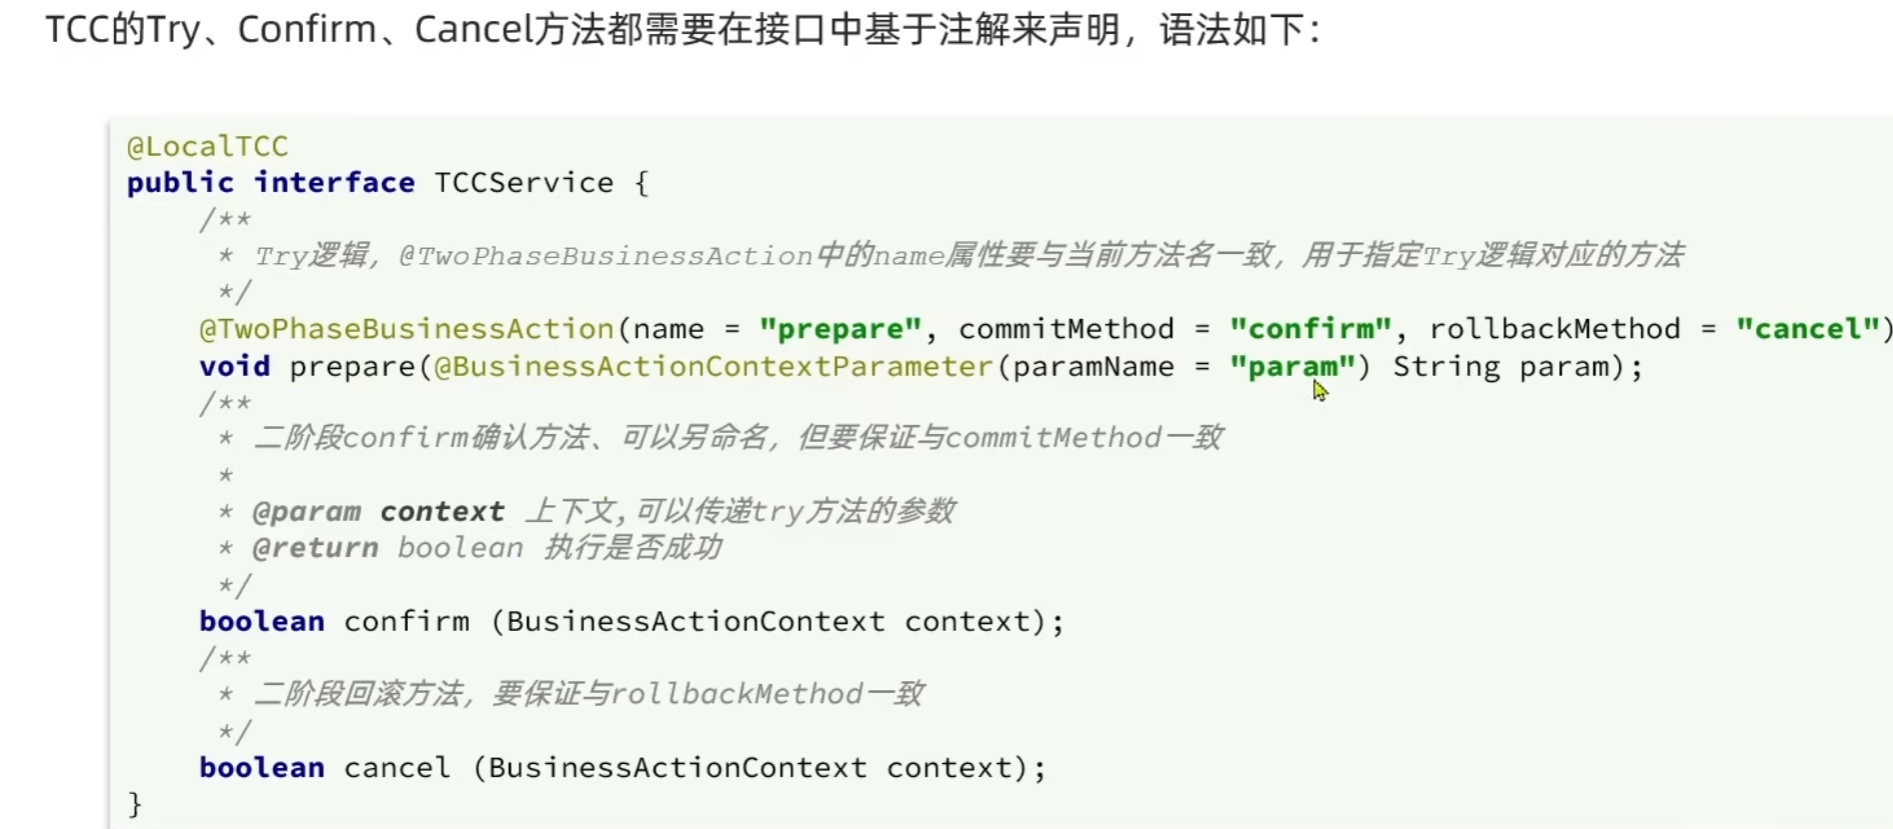
-
-
AT模式:最终一致的分阶段事务模式,无业务侵入,默认模式
同样是分阶段提交事务的模型,但是弥补了XA中资源锁定周期过长的缺陷
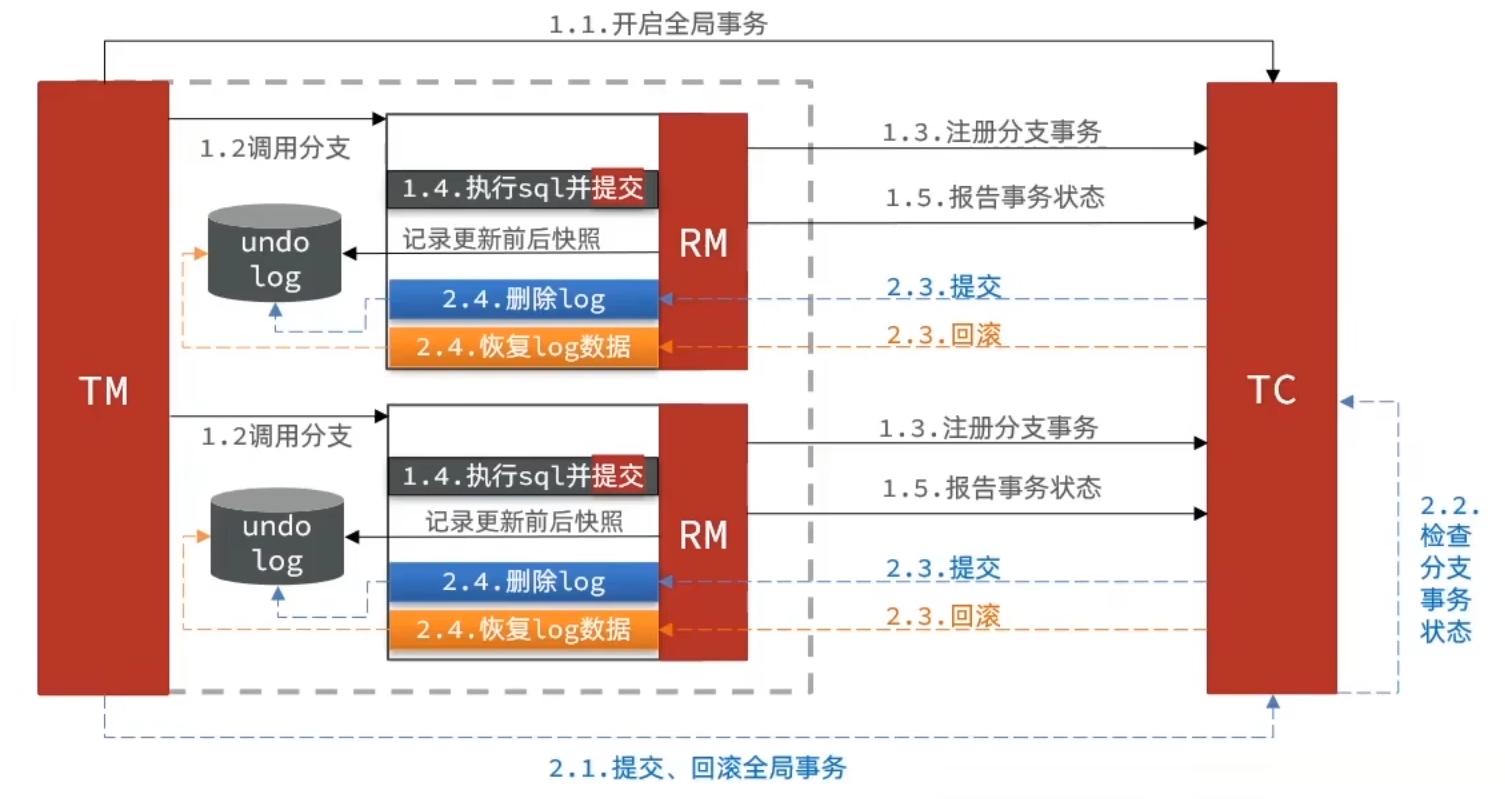
RM执行完SQL后立马提交,不锁定资源。但是使用了快照去实现事务的回滚
但是由于各个分支事务一执行完SQL就提交,在高并发模式下AT模式会出现脏写
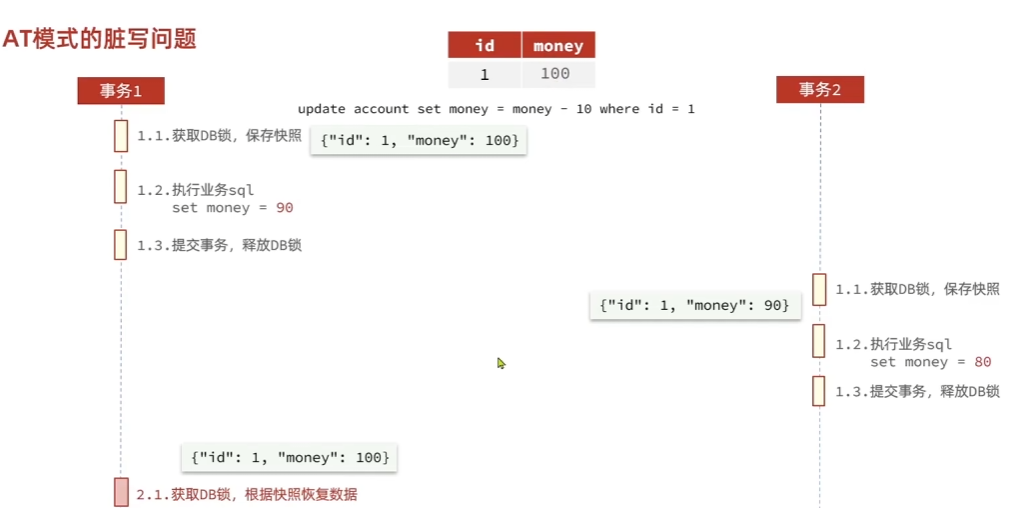
为此,AT模式引入了全局锁(记录当前行正在被哪个事务所操作,在全局锁释放前都只有这个事务可以操作当前行)
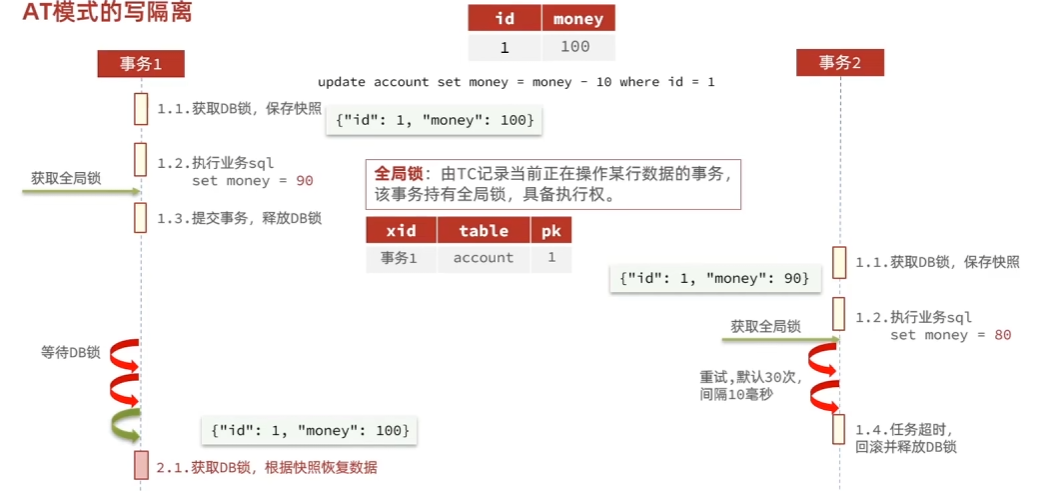
相较于XA模式的DB锁,AT模式的行锁粒度更细,所以性能更好。
-
SAGA模式:长事务模式,有业务侵入
SAGA也分为两个阶段
- 一阶段:直接提交本地事务
- 二阶段:成功则什么都不做,失败则通过编写补偿业务来回滚
-
-
四种状态对比
对比项 XA AT TCC SAGA 一致性 强一致 弱一致 弱一致 最终一致 隔离性 完全隔离 基于全局锁隔离 基于资源预留隔离 无隔离 代码侵入 无 无 有,要编写三个接口 有,要编写状态机和补偿业务 性能 差 好 非常好 非常好 场景 对一致性、隔离性有高要求的业务 基于关系型数据库的大多数分布式事务场景都可以 对性能要求较高的事务。有非关系型数据库要参与的事务。 业务流程长、业务流程多。参与者包含其它公司或遗留系统服务,无法提供 TCC 模式要求的三个接口 -
TC的部署
-
微服务集成Seata
-
Seata的集群
面试篇
1.SpringCloud中常见的组件有哪些
- SpringCloud包含的组件很多,有很多功能是重复的。其中最常用的组件包括
- 注册中心组件:Eureka、Nacos等
- 负载均衡组件:Ribbon
- 远程调用组件:OpenFeign
- 网关组件:Zuul、GateWay
- 服务保护组件:Hystrix、Sentinel
- 服务配置管理组件:SpringCloudConfig、Nacos
2.Nacos服务注册表结构是怎么样的
-
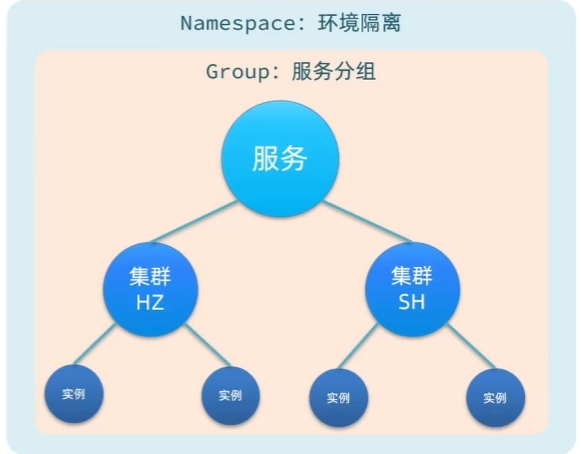
Nacos服务注册结构
-
底层实现
这种嵌套的逻辑结构,在底层通过Map的嵌套实现
/*** Map<Namespce,Map<group::servicename,Service>>*此处的group::servicename为分组名+服务名,Group和Service还是一对多的关系,只不过此处使用分组名+服务名构成唯一主键与服务一一对应*Map<String,Map<String,Service>>;//其中Service为//Map<ClusterName,Cluster>Map<String,Cluster>;//其中Cluster为//Set<Instance> 实例的集合Set<Instance> -
表述
Nacos采用了数据的分级存储模型,最外层是Namespace,用来隔离环境。然后是Group,用来对服务分组。接下来就是服务(Service)了,一个服务包含多个实例,但是可能处于不同机房,因此Service下有多个集群(Cluster),Cluster下是不同的实例(Instance)。
对应到Java代码中,Nacos采用了一个多层的Map来表示。结构为
Map<String, Map<String, Service>>,其中最外层Map的key就是namespaceId,值是一个Map。内层Map的key是group拼接serviceName,值是Service对象。 Service对象内部又是一个Map,key是集群名称,值是Cluster对象。而Cluster对象内部维护了Instance的集合。
3.Nacos如何应对高并发注册压力
Nacos内部接收到注册请求时,数据写入是最耗时的操作。所以Nacos拿到请求后不会立即写入数据,而是先将服务注册的任务放入一个阻塞队列并立即向客户端发送注册完成的响应。后续再开启线程池读取阻塞队列中的任务,异步地实现实例的更新,从而提高并发写的能力
4.Nacos如何应对并发读写冲突
读写冲突:一条线程在读实例列表,与此同时另一条线程正在新增 / 删除 / 修改实例;
二者操作同一份数组,就会产生并发读写冲突。
-
写冲突:在进行注册表更新的时候,Nacos会对服务名进行加锁。一个服务会有多个实例,在对服务名进行加锁后,属于同一服务的多个实例就只能串行执行了。以此解决写冲突 Tip:由于是对服务名加锁,所以不同服务之间互不影响
-
读写冲突:实例集合选用 Copy‑on‑Write 容器,Nacos属于读多写少(客户端不停读取可用实例,只有注册、下线、心跳变更时写入),所以在写入时,会将实例列表拷贝一份。也就是说,写入时所操作的集群列表与读取时操作的集群列表不是同一个列表,如此一来就不会发生读写冲突了
-
关于拷贝
使用的是浅拷贝,但是拷贝过程中会将旧的实例列表和要添加的实例列表进行合并得到一个新的拷贝列表。这个新的拷贝列表中存在着旧实例列表中不存在的实例,所以写入时操作这个新的拷贝列表,读取旧实例列表是感知不到的
等到写入操作完成后,再用拷贝列表去覆盖旧实例列表
-
5.Nacos如何实现服务健康检测
-
客户端
客户端注册服务是会先判断该服务是不是临时服务(长期服务由Nacos主动监测),若是则创建一个心跳对象,心跳对象中包含心跳的执行周期以及微服务实例的一些信息。后根据心跳执行周期设置定时任务,向Nacos服务端暴露给客户端的端口发送心跳消息
-
服务端
服务端收到请求后,从请求中解析出集群、ip、端口等一系列信息。根据这些信息从注册列表中找到对应的实例,更新这个实例的状态信息
Tip:处理心跳会比较耗时,所以会将信息放入阻塞队列,异步处理
除此之外,服务端还有一个类专门用于检查每个服务实例的心脏状态,若稍久没有发送心跳则标记为不健康,若过久没有发送心跳则将服务踢除
6.Nacos的服务拉取和订阅机制
消费者消费提供者的服务时,需要从Nacos获取实例列表,随后再做一个负载均衡。但是由于向Nacos服务器发送请求耗时过长,所以出现了服务拉取和订阅机制。这两个机制本身都是为了使得本地缓存的实例列表和Nacos服务端的列表同步,如此一来就可以直接在本地查询,查询速度更快
Tip:查询到数据不仅会写入本地缓存供更快的查询,还会写入磁盘实现持久化
-
服务拉取
默认每隔30s,客户端主动发起Http请求,从Nacos服务端拉取全量实例列表,并对本地缓存的实力列表作更新,同时存入磁盘进行数据持久化保存
Tip:若在缓存中查不到会到Nacos服务端拉取
-
订阅机制
默认开启订阅机制,当创建实例时会创建一个UDP端口,专门用于监听(开启线程池等待阻塞队列中的消息)服务端有关实例变更的消息。当收到变更消息后,会对本地缓存的实例列表进行变更并落盘持久化
7.Sentinel与Hystix的线程隔离有何区别
-
Sentinel默认采用信号量隔离,而Hystix默认采用线程池隔离
详见:雪崩问题
8.Sentinel的限流和Gateway的限流有什么区别
-
常见限流算法有三种:滑动窗口、令牌桶、漏桶。
-
GateWay采用基于Redis实现的令牌桶算法
虽然GateWay也支持基于Redis的漏桶算法,但是需要引入第三方组件,会对Redis带来一定的压力。并且GateWay的限流方式较为单一,且Sentinel支持图形化界面操作,功能丰富且方便
-
Sentinel
默认采用滑动窗口算法
排队等待模式基于漏桶算法
热点参数限流基于令牌桶算法
-
-
限流:对应用服务器的请求做限制,避免因过多请求而导致服务器过载甚至宕机
- 常见限流算法
- 计数器算法:包括窗口计数器算法、滑动窗口计数器算法
- 令牌桶算法(Token Bucket)
- 漏桶算法(Leaky Bucket)
- 常见限流算法
-
计数器算法
-
固定窗口计数器算法
将时间划分为多个窗口,窗口时间跨度称为Interval,本例为1000ms
每个窗口维护一个计数器,每有一次请求就将计数器+1,限流就是计数器的阈值,本例为3
如果计数器超过了限流阈值,则将超出阈值的请求都丢弃
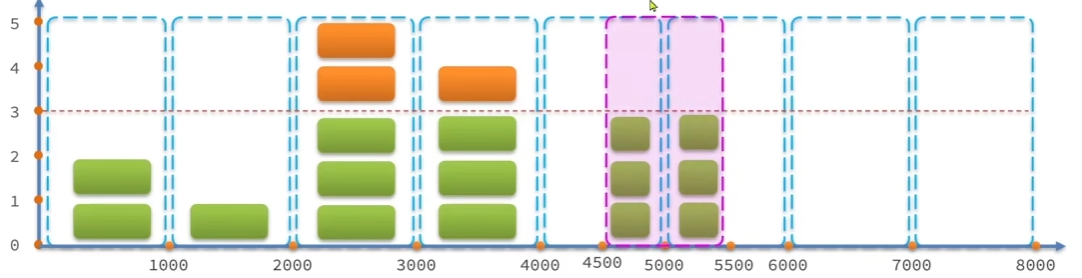
如图紫色区域所示,固定窗口存在的问题:时间的划分并不固定,在一秒内的请求数量可能会超过阈值,但是分布在了不同的区间内。所以限流效果不佳
-
滑动窗口算法
窗口时间跨度Interval为1s;区间数量n=2,则每个小区间时间跨度为500ms
限流阈值依然为3,时间窗口(1s)内请求超过阈值时,超出的请求被限流
窗口会根据当前请求所在时间(currentTime)移动,窗口范围是从(cuurentTime-Interval)之后的第一个时区开始,到currentTime结束
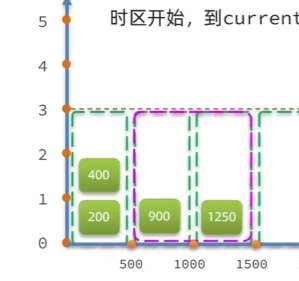
窗口会随着请求时间的变化而滑动,窗口划分地越细,滑动“灵敏度”更高,限流效果越好。
-
-
令牌桶算法
以固定速率生成令牌,存入令牌桶中,如果令牌桶满了,多余令牌丢弃
请求进入后,必须先尝试从桶中获取令牌,获取令牌的请求才会被处理
若令牌桶中没有令牌,则请求等待或被丢弃
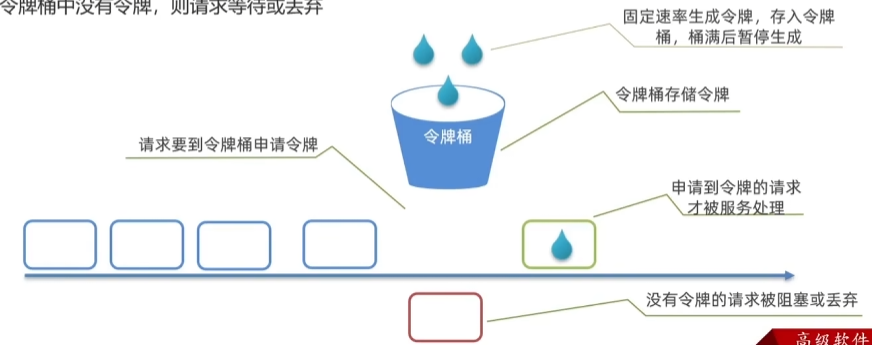
-
注意:此处“以固定速率生成令牌”,并不代表着令牌桶的容量就是那么多。
假设每秒生成3个令牌,服务器满载能力是每秒处理7个请求。那么就可以设置桶的容量为6,这样一来,如果出现第一秒没有请求,第二秒突然有6个甚至更多的请求这种请求波动的情况,也可以应付的过来
-
在实现令牌桶算法时,并不需要真正地模拟桶和令牌的发放。而是计算请求之间的时间差:如令牌生成速率为5个/s,第一个请求和第二个请求隔了0.2s,0.2*5=1,说明第二个请求可以被发放到一个令牌
-
-
漏桶算法
将每个请求视为“水滴”放入“漏桶”进行存储
“漏桶”以固定的速率向外“漏”出请求来执行,如果“漏桶”空了就停止漏水
如果“漏桶”满了则多余的请求会被丢弃
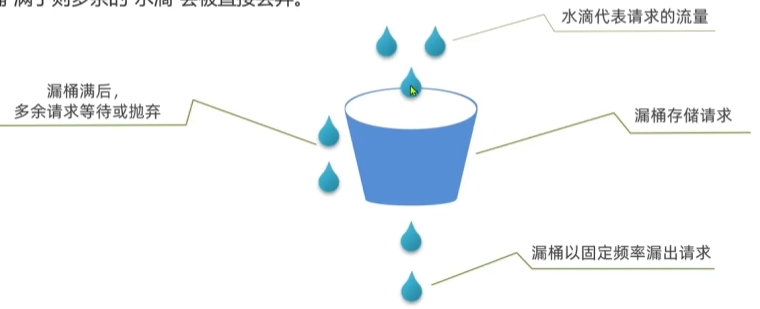
漏桶类似阻塞队列,Sentinel中的排队等待模式就使用了漏桶算法
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!